改裝 2080 Ti 22G · part 24
44GB VRAM 跑 177B:兩張 2080 Ti 用 Strata 單人寫程式 98.7 tok/s
❯ cat --toc
- 前言
- 從單卡改成雙卡:gpu 寫兩張,啟動也寫兩張
- 一個人用:寫程式 98.7 tok/s,比單卡快約 15%
- 為什麼兩張卡只快 15%:兩張卡是接力,不是一起算
- 好幾個人同時用:每人掉到 20 幾,四個人合計 94–117
- 怎麼選:一個人用,Strata 就很夠;一家人共用留 27B
- 進階:batch-mtp、兩個單卡服務、試過沒用的和還沒測的
- batch-mtp 開與關:1/2/4 路完整數字
- 混合負載:別人進來時掉多少、走了多久回來
- 兩張卡各開一個單卡服務:1/2/4/8 人合計都在 72–75
- n-gram 表放 RAM 還是讓它從 SSD 讀:差不到 1.4%
- 舊版試過、沒用的加速方法
- 還沒測的路
- 版本與環境
- 還沒做的
TL;DR
兩張改裝 2080 Ti 22G 加 128GB 記憶體,用 Strata(61b3fb5d)跑 177B 的 Qwen3.8-Flash-Next IQ3_S:一個人寫程式 98.7 tok/s、中文 64.9,比同版單卡的 85.6 快約 15%。單卡改雙卡只動兩處:設定檔 gpu 寫 [0, 1],啟動也帶 --gpu 0,1。只快 15% 是因為兩張卡分層接力,同一個字一張算完另一張才接手。四個人同時用,每人掉到 26–32,合計 94–117。小 VRAM 跑大模型、一個人用,Strata 很好用:中文 64.9,跟同一組卡上 27B 的 63.0 差不多;多人共用時 27B 四人合計 420,所以家裡共用的主力還是 27B。
前言
#23 用一張改裝 2080 Ti 跑 177B 的 Qwen3.8-Flash-Next(以下簡稱 fn),寫程式 70.3 tok/s,證明一張卡就跑得動。接下來想知道兩件事:兩張卡能跑多快?還有,fn 能不能接手 ai-lab 前兩張卡上的 27B,給全家一起用?
那兩張卡平常跑 Qwen3.8-27B,那一席叫 Hina(#22),家人用的網頁聊天也接在它上面。27B 速度快,但能力就停在那裡。fn 比 27B 聰明,問題是好幾個人同時用的時候撐不撐得住,我沒有數字。
簡單講:一個人用,兩張 2080 Ti 跑 177B 快要 100 tok/s(每秒生出約 100 個 token,一個 token 大約一個中文字或半個英文單字),很好用;一家人同時用才會掉到 20 幾,所以家裡共用的主力還是 27B。下面是怎麼把單卡設定改成雙卡、一個人用和好幾個人用各是多少,還有為什麼多一張卡只快 15%。
從單卡改成雙卡:gpu 寫兩張,啟動也寫兩張
這篇用的是 Strata 新版 61b3fb5d。#23 那時是 6f32ec07,我另外 clone 一份新版、編 CUDA 12 的 sm_75 執行檔,模型、pack、MTP 草稿層都直接沿用 #23 下載好的,沒有重抓。
雙卡的設定檔跟單卡幾乎一樣,差在下面這幾行:
{
  "args": [
    "--pack", "/mnt/nvme1t/strata/data/packs/iq3_s",
    "--native", ".../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf", ".../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-profile", "/mnt/nvme1t/strata/src/data/expert-profile.bin",
    "--expert-cache", "auto", "--prefill", "auto",
    "--spec", "4", "--spec-min-p", "0.5",
    "--mtp", "/mnt/nvme1t/strata/data/mtp/rt",
    "--max-context", "32768", "--kv", "int8",
    "--ple-io", "ram"
  ],
  "gpu": [0, 1],
  "layer_split": "auto",
  "env": { "STRATA_BF16_TC": "1" },
  "parallel": 1
}
"gpu": [0, 1]:寫兩張卡。單卡那份我用CUDA_VISIBLE_DEVICES鎖住 GPU2 的 UUID,雙卡這份拿掉了,直接用這個列表指定。"layer_split": "auto":設定檔有兩張以上的卡,Strata 的 server 就會幫引擎加--layer-split,auto是預設,可以不寫。我這台它自己切在第 24 層。--max-context 32768:量測用 32K。單卡 Shio 平常開 128K 加--kv-resident 32768,雙卡沒用這組量。
啟動時命令列的 --gpu 也要寫兩張:
cd /mnt/nvme1t/strata-upstream
.venv/bin/python serve/server.py --engine strata \
  --config /mnt/nvme1t/strata-upstream/dual-solo.json \
  --host 127.0.0.1 --port 8097 --gpu 0,1
這裡我踩過一次:照單卡的習慣寫 --gpu 0,它會蓋掉設定檔的 [0, 1],引擎只開在 GPU0 上,而且照樣跑得起來、照樣回答。那次量到 76.4、81.8 tok/s,看起來像「雙卡沒變快」,其實只用到一張卡。
所以啟動完先看一眼兩張卡的用量:
nvidia-smi --query-gpu=index,memory.used --format=csv,noheader
真的雙卡時兩張都是 21.6–21.7 GiB 上下。只用一張的那次是 21616 MiB 對 4 MiB。
一個人用:寫程式 98.7 tok/s,比單卡快約 15%
同一版 Strata、同一組題目,單卡(GPU2)和雙卡(GPU0+1)比。看第一列:
| 單卡 GPU2 | 雙卡 GPU0+1 | 雙卡多出 | |
|---|---|---|---|
| 寫程式(tok/s) | 85.6 | 98.7 | +15% |
| 中文(tok/s) | 57.0 | 64.9 | +14% |
| 英文(tok/s) | 沒量 | 62.6 | |
| 16K token 的 prompt,第一個字 | 沒量 | 10.4 秒(讀取 1,545 tok/s) |
量法:真實的 chat 請求、串流、不開思考(reasoning_effort=none),每題三發取中位數,每發最多 650 token(寫程式那題會被截斷,兩邊同條件)。速度取 Strata 自己的生成速度。兩邊都是 32K context、int8 KV、--spec 4、STRATA_BF16_TC=1;單卡那組沒開 --kv-resident。
#23 寫的單卡 70.3 是舊版 6f32ec07。同一張卡升到新版,寫程式變 85.6(+22%)、中文 52.9 變 57.0(+8%)。所以這篇單卡、雙卡都用新版比,不拿 70.3 比。
我的單卡 Shio 平常的設定(128K、--kv-resident 32768、--ple-io direct)在新版量到寫程式 89.2、中文 57.8。雙卡對它也只多約 11%。
為什麼兩張卡只快 15%:兩張卡是接力,不是一起算
先回想 #23 講的分工:模型生每一個字,要從第 1 層一路算到第 48 層。每一層有兩種工作:一種是每個字都要算的固定部分(attention 這些),放在顯卡上;另一種是從幾百個 expert(專家,模型裡的小模組,每個字只會用到其中幾個)裡挑幾個來算。IQ3_S 的模型主檔就有 54.8GB,大部分是 expert,一張 22GB 的顯卡放不下,所以只有常用的放顯卡,其餘的放在 RAM、由 CPU 算。
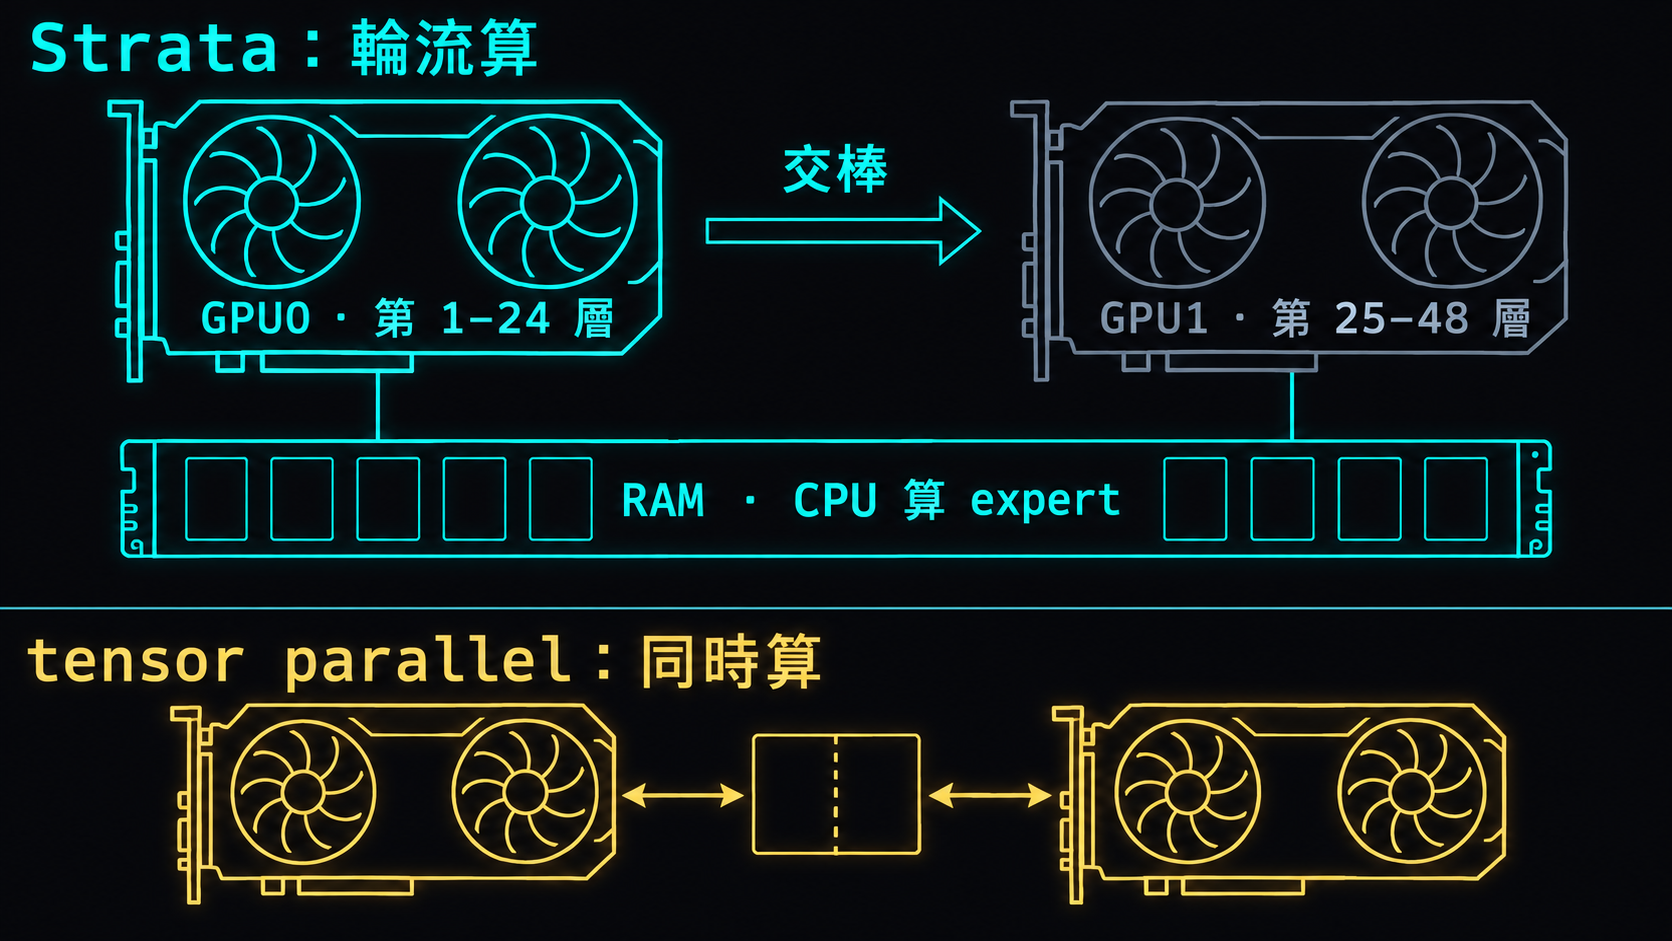
兩張卡時,Strata 的做法叫 layer split(分層):GPU0 負責第 1 到 24 層,GPU1 負責第 25 到 48 層。生一個字的過程是這樣:
- GPU0 把前 24 層算完(CPU 同時幫忙算不在顯卡上的 expert)。
- GPU0 把算到一半的結果交給 GPU1,交的東西很小,一個字約 50KB。
- GPU1 接著算後 24 層,再加上輸出和猜字的那一層(MTP 草稿層:先猜接下來幾個字,主模型一次驗完,猜對就省時間)。
- 這個字生完,下一個字又從 GPU0 開始。
所以一個人用、一個字一個字生成的時候,同一時間只有一張卡在算,另一張在等。這像接力賽:兩個人跑完全程,不會比一個人快一倍,因為同一時間只有一個人在跑。
換成時間來看比較清楚。接力時,生一個字的時間是「GPU0 那段 + GPU1 那段」,跟一張卡自己算完 48 層差不多。兩張卡一起算同一層時,每一層兩張卡各算一半,顯卡上那段的時間大約砍半。不過不管哪一種,都要等 CPU 把 RAM 裡的 expert 算完,這段時間兩種做法都一樣。
那多一張卡快在哪?兩張卡的 VRAM 加起來,可以多放一些常用的 expert,CPU 要算的就少一點,所以有快 15%。但 177B 大部分的 expert 還是放不進顯卡,還是 CPU 在算,這部分多一張卡幫不上。
另一種做法叫 tensor parallel:每一層都切成兩半,兩張卡同時各算一半,算完互相交換結果。這樣兩張卡一直都在工作,我的 27B 在 fastllm 上就是這樣跑兩張卡的。Strata 的 CUDA 版沒有這個模式。作者在 issue #156 的說法是:生字的速度主要卡在 expert,所以不打算做。就算做了,切成兩半的也只有顯卡上的固定部分,CPU 在 RAM 裡算 expert 的那段還是一樣慢。
好幾個人同時用:每人掉到 20 幾,四個人合計 94–117
要讓好幾個人同時用,設定檔改 "parallel": 4,args 再加 --batch-mtp(讓同時在跑的每一路也用 MTP 猜字)。下面是同時送出同一種寫程式題,看「每人」那欄:
| 同時幾個人 | 每人(tok/s) | 合計(tok/s) |
|---|---|---|
| 1 | 97.2 | 88.4 |
| 2 | 47.6 | 87.7 |
| 4 | 25.9 | 95.2 |
(每人是那一路扣掉等第一個字之後的生成速度;合計是全部輸出 token 除以最慢那一路完成的時間,包含等第一個字,所以一個人時合計比每人低。)
合計從一個人到四個人都在 88–95 之間,總速度差不多,人越多,每個人分到的就越少。四個人時 GPU1 的 VRAM 用到 21,996–21,998 MiB(上限 22,001),八個人塞不下,沒開。
關掉 --batch-mtp、其他不變,四個人的合計是 116.9,每人 32.1。但這是先跑過一個人、兩個人之後的數字;重新啟動後直接量四個人,合計是 93.6。所以關掉的那組要看暖機狀態,94 到 117 之間都有可能,細節在進階那節。
實際用起來比較像這樣:一個人在等長回答,速度約 90;另外三個人陸續進來,他那一路掉到 22–23;別人都走了以後,5–10 秒內回到 87–94。
怎麼選:一個人用,Strata 就很夠;一家人共用留 27B
一個人用的時候,Strata 跑這顆 177B 很好用,而且不用很多 VRAM:177B 的模型,顯卡上只要兩張 22GB(單卡版只要一張),其餘放在 128GB 的 RAM。#17 用 llama.cpp 跑同一顆模型,三張卡吃滿、128K context 是 23.14 tok/s;現在兩張卡寫程式 98.7,一張卡的 Shio 也有 89.2(量化和 context 都跟 #17 不同,只能看大概)。中文 64.9,跟 27B 的 63.0 差不多。
差別在好幾個人同時用。同一組卡(GPU0+1)上的 27B,同一組題目,看第二列:
| fn 雙卡(Strata) | 27B(fastllm) | |
|---|---|---|
| 一個人寫程式(tok/s) | 98.7 | 237.3 |
| 四個人同時,合計(tok/s) | 94–117 | 420 |
| 一個人中文(tok/s) | 64.9 | 63.0 |
27B 是 10-05 用同一組題目、同樣的量法量的,當時跑在 fastllm、兩張卡 tensor parallel、max_batch=4。
四個人同時用,27B 的合計是 fn 的四倍左右。一個人寫程式 27B 也快兩倍多,但 fn 的 98.7 已經夠快,中文那列兩邊差不多。
所以我的選法是:
- 自己一個人、想要聰明一點的模型:fn 雙卡,寫程式 98.7。這兩張卡要讓出來,27B 那段時間就停了。
- 一家人一起用:留 27B。fn 在四個人時每人只剩 26–32,家人等字會等很久。
- 兩張卡各開一個單卡 fn:不要。合計反而比雙卡分層低,原因在進階那節。
最後 Hina 維持 27B。fn 照舊放在第三張卡,當 Shio 單卡席,跟 ComfyUI 輪班(#23 那套切換)。
進階:batch-mtp、兩個單卡服務、試過沒用的和還沒測的
不讀這節不影響使用。這裡是多路同時跑的完整數字、兩個單卡服務同跑為什麼不划算、--ple-io 兩種放法、舊版試過沒用的加速方法,還有幾條沒測的路。
batch-mtp 開與關:1/2/4 路完整數字
同一題寫程式、每路 650 token、三輪同時送出。「每路」是每輪各路生成速度的中位數,再取三輪中位數;「合計」是每輪總輸出除以最慢完成的時間,再取三輪中位數。
| 路數 | MTP 開每路 | MTP 開合計(逐輪) | MTP 關每路 | MTP 關合計(逐輪) |
|---|---|---|---|---|
| 1 | 97.20 | 88.38(78.04/88.46/88.38) | 94.90 | 86.28(78.69/86.28/86.79) |
| 2 | 47.60 | 87.65(87.77/87.51/87.65) | 45.25 | 83.91(83.91/84.03/83.54) |
| 4 | 25.94 | 95.18(96.26/94.64/95.18) | 32.11 | 116.86(116.86/117.10/116.40) |
兩路時開 batch-mtp 合計高 4.5%;四路時關掉的高 22.8%。這兩組不只差一個旗標:關掉時 Strata 用分層預設的 pipeline groups(兩段各自處理不同的請求),開的時候用單一組的 batch MTP,兩條路徑本來就不同,這個差距不能全算在草稿上。batch MTP 的接受率看引擎 log:兩路 92.1–93.0%、四路 92.4–92.9%(/metrics 的 batch 草稿欄是 0,那欄不記 batch 的草稿)。
四路關 MTP 的 116.86 要打折看。我另外做了兩組都是重新啟動後直接量四路:
| 組態(都是冷啟動直接量 4 路) | 合計三輪 | 中位 |
|---|---|---|
| 預設 groups、batch MTP 關 | 90.15 / 93.60 / 97.84 | 93.60 |
明確寫 --batch-groups 2、batch MTP 關 | 94.26 / 94.06 / 96.30 | 94.26 |
兩組的 log 都是「2 groups of 2」,跟 116.86 那組一樣。差別在 116.86 那組先跑過一路、兩路才量四路。所以 116.86 是暖機後的數字,冷的時候是 94 左右;明確寫 --batch-groups 2 本身沒有讓它變慢。
舊版 6f32ec07 跑多路差很多:開 parallel: 4 之後,就算只有一個請求也只剩 23.9,四路合計 90.4。新版開 parallel: 4 加 --batch-mtp,一個請求還有 97.2。
混合負載:別人進來時掉多少、走了多久回來
一路長回答先跑,第 2/3/4 路在第 10/15/20 秒加入,約在第 35/40/45 秒先後結束。下表是第一路每 5 秒的生成速度,batch MTP 開:
| 秒 | 其他幾路在跑 | 第 1 輪 | 第 2 輪 | 第 3 輪 |
|---|---|---|---|---|
| 5 | 0 | 82.0 | 74.2 | 82.2 |
| 10 | 1 | 95.0 | 86.0 | 91.2 |
| 15 | 2 | 38.6 | 38.4 | 37.8 |
| 20 | 3 | 30.4 | 28.2 | 29.8 |
| 25 | 3 | 23.2 | 22.2 | 22.0 |
| 30 | 3 | 27.4 | 27.0 | 27.0 |
| 35 | 2 | 31.0 | 30.6 | 29.8 |
| 40 | 1 | 39.8 | 39.8 | 41.8 |
| 45 | 0 | 74.2 | 78.0 | 73.0 |
| 50 | 0 | 89.0 | 91.8 | 87.4 |
| 55 | 0 | 93.8 | 83.0 | 92.4 |
| 60 | 0 | 94.4 | 88.8 | 93.6 |
| 65 | 0 | 81.0 | 88.8 | 91.8 |
四路同跑時第一路最低 22–23,約是單路 98.7 的 22–24%;其他路走掉後 5–10 秒回到 87–94。
兩張卡各開一個單卡服務:1/2/4/8 人合計都在 72–75
既然分層接力只快 15%,另一個想法是兩張卡各跑一個單卡 fn(GPU0 一個、GPU1 一個),前面用 LiteLLM 分流。每張卡一次只接一個人(parallel: 1),ComfyUI 照跑,最接近實際要用的擺法:
| 同時幾個人 | 每人生成(tok/s) | 合計(tok/s,三輪) | 第一個字 |
|---|---|---|---|
| 1 | 82.03 | 77.99 / 75.00 / 74.67 | 約 2 秒 |
| 2(各打一個服務) | 41.45 | 74.21 / 72.08 / 76.90 | 約 2 秒 |
| 4 | 42.38 | 73.90 / 72.65 / 75.91 | 一半約 2 秒、一半約 20 秒 |
| 8 | 41.27 | 72.28 / 72.10 / 72.07 | 分四批:約 2/20/38/56 秒 |
兩個人各打一個服務,合計沒有加倍,反而從 75 掉到 74;每人從 82 掉到 41。兩張卡是分開的,掉成一半表示卡在兩個服務共用的東西上。那時 CPU 約 50%、NVMe 幾乎沒在讀(每秒 0.1–0.2 MiB);我沒有把 CPU 綁核、也沒量記憶體頻寬,所以只能說卡在主機這端,不能說是哪一樣。
四個人時每人 42.38 看起來比雙卡分層的 25.9 高,但一半的人要先排隊等 20 秒。用合計比,兩個單卡服務在 1/2/4 人比雙卡分層慢 15.1%/15.3%/36.8%(四人是對暖機後的 116.86;對冷啟動的 93.60 慢 21.0%)。
我也試了每個服務開 parallel: 2 和 parallel: 4,都更差:
| 每個服務的設定 | 1 人合計 | 2 人合計 | 4 人合計 | 8 人合計 |
|---|---|---|---|---|
parallel: 1 | 75.00 | 74.21 | 73.90 | 72.10 |
parallel: 2 + batch MTP | 59.91 | 59.63 | 62.58 | 61.31 |
parallel: 2、batch MTP 關 | 60.16 | 60.30 | 51.37 | 沒量 |
parallel: 4 + batch MTP | 57.88 | 57.11 | 58.73 | 沒量 |
parallel: 4、batch MTP 關 | 57.93 | 57.93 | 48.07 | 沒量 |
(都是三輪中位。parallel 2 和 4 那幾組因為 RAM 不夠,ComfyUI 是停著的,跟第一列的條件不完全一樣。)
parallel: 4 時兩個服務閒著就只剩約 3.9 GiB 可用 RAM,四個人跑起來最低剩 2.3 GiB,八個人就沒開了。兩個服務各自吃掉約 40 GiB 的 RSS,這種擺法在 128GB 的機器上很擠。
另外有一個坑:兩個服務同時冷啟動,會卡在 Linux 整理 huge page。 兩個都在 900 秒內起不來,Strata 的 server 報:
EngineDied: the engine did not report READY within 900 s
不是 OOM。那時兩個 process 各約 40–42 GiB RSS、各吃滿一個 CPU 核,可用 RAM 最低約 36 GiB。改成依序啟動之後,第二個還是卡住,用 perf 看它的呼叫堆疊是 cudaHostRegister → pin_user_pages → do_huge_pmd_anonymous_page → compact_zone:在把 expert 用的那塊 RAM 釘住的時候,核心一直在整理 huge page。
暫時把 THP 的 defrag 改成 never,46 秒內就起來了,起來之後再改回原本的 madvise:
echo never | sudo tee /sys/kernel/mm/transparent_hugepage/defrag
# 等第二個服務 /v1/models 回 200
echo madvise | sudo tee /sys/kernel/mm/transparent_hugepage/defrag
這是啟動條件,不是常態設定;後面的速度都是改回 madvise 之後量的。
n-gram 表放 RAM 還是讓它從 SSD 讀:差不到 1.4%
fn 有一張 28.8GB 的 n-gram 表。--ple-io ram 整張讀進 RAM,direct 是 Strata 預設、從 SSD 直接讀。雙卡各量三發中位:
| ram | direct | 差異 | |
|---|---|---|---|
| 一個人寫程式(tok/s) | 98.7 | 97.4 | −1.32% |
| 一個人中文(tok/s) | 64.9 | 64.8 | −0.15% |
| 16K prompt 讀取(tok/s) | 1,544.74 | 1,538.14 | −0.43% |
| 16K 第一個字(秒) | 10.381 | 10.424 | 慢 0.41% |
| 四路 batch MTP,每路(tok/s) | 25.94 | 26.19 | +0.96% |
| 四路 batch MTP,合計(tok/s) | 95.18 | 96.15 | +1.02% |
每一項都沒差超過 3%,所以我把單卡 Shio 的設定改成 direct,在 GPU2 驗了一次:寫程式 82.9/89.2/89.7(中位 89.2)、中文 57.8。
照理說改用 direct 應該會省下那 29GB 的 RAM,但這輪看可用 RAM 沒有明顯變多(單路寫程式時 ram 69,932、direct 69,925 MiB),可能是作業系統的檔案快取還留著那張表。所以我不敢說它真的省了 29GB。
舊版試過、沒用的加速方法
下面是 10-05 舊版 6f32ec07 在 GPU0+1 上試的,各三發中位,基準是預設的分層(那時有開 --remote-expert-opt):
| 試法 | 寫程式 | 中文 | 英文 | 16K 第一個字 |
|---|---|---|---|---|
| 預設分層 | 92.3 | 58.9 | 60.1 | 12.6 秒 |
加 --ple-io ram | 92.0 | 58.7 | 59.9 | 12.6 秒 |
再加 STRATA_BF16_TC=1 | 91.4 | 60.0 | 60.0 | 10.6 秒 |
--peer-device 1(GPU1 不分層,走 NVLink 幫 GPU0 算 expert) | 82.3 | 55.8 | 54.9 | 13.1 秒 |
--expert-cache-device1 auto(GPU1 當 helper 放 expert) | 48.4 | 38.3 | 34.7 | 13.2 秒 |
明確切在第 24 層 + STRATA_STAGE_TRIM=1 | 89.1 | 60.5 | 59.0 | 10.5 秒 |
STRATA_BF16_TC=1只讓長 prompt 變快(16K 第一個字 12.6→10.6 秒),生成速度沒變。這篇的雙卡有開。- NVLink(
--peer-device)慢約 11%。兩張卡在同一層各算一部分 expert,但 GPU0 還是要獨自算 dense 的部分、每層都要等 GPU1 交回來;而且原始碼裡這條路傳資料經過的是 pinned 的主機記憶體,有 NVLink 不等於每次都直接卡對卡。 - helper 慢 47%。
- 三張卡分層(10-04 量的):寫程式 81.1、中文 54.5,比兩張卡的 92.1、60.1 還慢。
還沒測的路
Strata 現有的程式裡,讓兩張卡同時算還有兩條現成的路,我都還沒在這台量:
--pipeline-windows 2:一個人用時,GPU0 先猜著算下一段、GPU1 驗目前這段,猜錯就退回。需要 MTP 和分層,跟--batch的多路互斥,每張卡要多放第二份驗證用的緩衝和 GDN snapshot,前者約 160 MiB。上游有人用另一對 2080 Ti(IQ3_XXS)回報 +11.1%(#1349),另一份回報(#1143)跑下來沒有錯誤也沒有卡住。我的兩張卡 VRAM 本來就快滿,多出來的那塊可能擠掉 expert 快取。要測的話我會做 0/2/0 的 A/B/A,暖機後單路至少 +8% 才採用。- batch groups 保留 batch MTP:現在多路分組(兩段各跑不同請求)和 batch MTP 不能同開,原始碼裡有明確擋掉。要兩個都要得改程式。
更大的改法:
- 完整的 expert parallel:兩張卡各放一半的 expert、同一層同時算。上游只有 SYCL(Intel Arc)版的 PR #1798,還沒合併,沒有 CUDA 版。
- 自己做 tensor parallel:粗估每個字要做 96 次跨卡同步(48 層、每層兩次),傳的資料不大,延遲才是重點。我估單路 −20% 到 +5%,不值得開工。
版本與環境
- Strata:
61b3fb5d(0.1.42 開發樹,2026-10-10),在獨立目錄/mnt/nvme1t/strata-upstream用 CUDA 12 編 sm_75;舊版6f32ec07(引擎 0.1.39)留在原目錄沒動 - 模型:ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF,IQ3_S,跟 #23 同一份檔
- 雙卡設定:GPU0+1、分層 auto(切在第 24 層)、32K context、int8 KV、
--spec 4、--spec-min-p 0.5、STRATA_BF16_TC=1、--ple-io ram;新版沒開--remote-expert-opt(上游文件寫它跟 batch MTP 不相容),舊版 10-05 有開,所以舊雙卡 91.4 到新雙卡 98.7 的差距不能全算在版本頭上 - 單卡對照:GPU2,32K、無
--kv-resident;Shio 平常的設定是 128K、--kv-resident 32768、--ple-io direct - 27B:10-05 的 Hina,fastllm、
qwen38-27b-ud、兩張卡 tensor parallel、max_batch=4(之後 8082 換過模型,那組數字是當時的) - 量測:OpenAI 相容 chat 請求、串流、
reasoning_effort=none、每發最多 650 token(16K 題 250)、每題三發不同 nonce 取中位 - 機器:ai-lab,EPYC,128GB RAM,三張 RTX 2080 Ti 22G
- 雙卡量測要停 Hina:分層那輪停 42 分鐘,兩個單卡服務那輪停 90 分鐘,兩輪都在 ai-lab 本機掛了 dead-man 計時器,到點自動把 Hina 和 ComfyUI 帶回來
還沒做的
--pipeline-windows 2的 A/B/A。- fn 和 27B 的能力比較。10-05 跑過一組 5 題的題目,27B 48/60、fn 40/60,樣本太小,跟我實際派工的感覺相反,這篇不拿它下結論。
- 雙卡的看圖、工具呼叫、128K 長 context 都沒在新版量。
同系列:
常見問題
- 兩張 2080 Ti 22G 跑 Qwen3.8-Flash-Next 有多快?
- 用 Strata 61b3fb5d、IQ3_S、32K context,一個人用時寫程式 98.7 tok/s、中文 64.9、英文 62.6;16K token 的 prompt 第一個字 10.4 秒,prompt 讀取 1,545 tok/s。兩張卡各用掉約 21.6 GiB。
- 從單卡改成雙卡要改什麼?
- 設定檔的 gpu 寫成 [0, 1],啟動 serve/server.py 時也要帶 --gpu 0,1。只在命令列寫 --gpu 0 會蓋掉設定檔,實際只用到第一張卡。啟動後看 nvidia-smi,兩張卡都吃到 21 GiB 以上才是真的雙卡。
- 為什麼雙卡只比單卡快 15%?
- Strata 的多卡是分層接力:GPU0 算前 24 層,算完把結果交給 GPU1 算後 24 層,同一個字的時間裡兩張卡輪流工作,沒有一起算同一層。多出來的 VRAM 能多放一些常用的 expert,所以有變快,但大部分 expert 還是 CPU 在 RAM 裡算。Strata 作者在 issue #156 說生字的速度主要卡在 expert,所以目前沒打算做 tensor parallel。
- Strata 雙卡給好幾個人同時用,速度怎樣?
- 開 parallel 4 和 --batch-mtp:一個人 97.2 tok/s,兩個人各 47.6,四個人各 25.9,合計一直在 88–95 之間。關掉 --batch-mtp 時四人合計 93.6(剛啟動)到 116.9(先跑過一兩路之後)。同一組卡上的 Qwen3.8-27B 四人合計 420。
- 兩張卡各開一個單卡服務,會比雙卡分層快嗎?
- 不會。兩個單卡服務同時跑,1/2/4/8 個人的合計是 75.0、74.2、73.9、72.1 tok/s,比雙卡分層慢 15–37%。兩邊加起來沒有變兩倍,CPU 和記憶體是兩個服務共用的。兩個服務同時冷啟動還會卡在 Linux 整理 huge page,超過 900 秒都起不來。
- n-gram 表要放 RAM(--ple-io ram)還是讓它從 SSD 讀(direct)?
- 雙卡實測差不到 1.4%:寫程式 98.7 對 97.4、中文 64.9 對 64.8、16K prompt 讀取 1,545 對 1,538,四人合計 95.2 對 96.2。我的單卡 Shio 現在用 direct。
接著讀
- 2026-10-06一張改裝 2080 Ti 跑 177B:Strata 讓 Qwen3.8-Flash-Next 寫程式 70 tok/s
一張改裝 2080 Ti 22G 加 128GB 記憶體,用 Strata 跑 177B 的 Qwen3.8-Flash-Next IQ3_S:寫程式 70.3 tok/s。旁邊兩張卡的 27B 照跑,互相只慢 1.3% 和 7.7%;要生圖時 12.4 秒切回 ComfyUI。附安裝、啟動與切換腳本。
- 2026-09-282080 Ti 沒有 FP4 也能跑 NVFP4:自己轉 Qwen3.8-27B,寫程式快 31%
2080 Ti 沒有 FP4 硬體,FastLLM 在 kernel 裡解包 NVFP4 照樣變快:自己把 Qwen3.8-27B BF16 轉成 NVFP4,寫程式 151.7 tok/s(FP8 116.1),四條請求同時跑合計 297,140 題 131/128。附轉換腳本與三顆 NVFP4 的比較。
- 2026-09-28雙 2080 Ti FastLLM 升級:寫程式快 16%、兩人同時用,長請求不再擋人
兩張改裝 2080 Ti 22G 的 FastLLM + DFlash2 換成自編的上游最新版:寫程式 116.1 tok/s(同組題目原本 100.3),兩個請求同時跑,長請求讀 prompt 時短請求 1.1 秒開始回。附編譯步驟、啟動指令和兩個上游 PR。
- 2026-09-21特化的啟動器 FastLLM + DFlash2,居然可以在魔改的 2080 Ti 雙卡跑出 100+ tok/s!
兩張改裝 2080 Ti 22G 用 FastLLM 跑 Qwen3.8-27B FP8,掛上 DFlash2 草稿模型:寫程式 153.8 tok/s、數學 134.9,散文 53.1。262K context、看圖、prefix cache 都在。附完整啟動指令和四個會卡住你的設定。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。