改裝 2080 Ti 22G · part 27
[Benchmark] 三張改裝 2080 Ti 解鎖 FP16 tensor core:矩陣乘從 50.6 到 69.9 TFLOPS,只有走 FP16 的工作會變快
❯ cat --toc
TL;DR
turing-unlock 是開機時載入的 Linux kernel 模組,解開 GeForce Turing 的 FP16 輸入、FP32 累加 tensor core 半速限制,不刷 VBIOS。家裡三張改裝 2080 Ti 22G 裝上後,8192³ 矩陣乘 50.6 → 69.9 TFLOPS(功耗上限 200W)。實際工作只有走 FP16 tensor core 的會變快:影片生成每步約快兩成;LLM 走 int8 幾乎沒差;生圖原本轉 FP32 算,改 FP16 後 z-image 一張 54.2 → 16.9 秒。
前言
先講兩個名詞。FP16、FP32 是一個數字用幾個位元存:16 位元省空間、算得快,32 位元比較準。顯示卡裡有兩種算東西的單元:一般的 CUDA core 什麼都能算;tensor core 是專門做矩陣乘(AI 模型裡最大宗的計算)的加速器,快很多,但只吃特定格式。
GeForce 版的 Turing 卡有一個刻意的限制:tensor core 做 FP16 輸入、FP32 累加的矩陣乘時,只給一半速度。同一顆晶片的專業卡(Quadro、TITAN RTX)沒有這個限制。很多矩陣乘要用 FP32 累加,因為一長串 FP16 加總,誤差會累積,數字也容易超出 FP16 能表示的範圍。
10 月底 nlzy/turing-unlock 出來了,它是 Zagitta 的 gpu-unlock 的 Turing 版。作者在 README 量到 2080 Ti 22G(250W)8192³ 從 52.8 變 77.9 TFLOPS,issue 區也有人回報雙卡 +84%。家裡那台 EPYC 主機剛好插了三張同型號的改裝 2080 Ti 22G(PCI ID 10de:1e07,跟作者測的那張一樣),不用花錢就能試。
下面是怎麼裝、量到多少,以及哪些工作真的變快。結論先講:解鎖只對「走 FP16 tensor core」的工作有用,我家原本只有影片生成符合,另外兩類工作要另外處理才吃得到。
裝起來:一個 kernel 模組加一個開機參數
這一節是照著做的步驟。白話講就三件事:裝一個小程式、告訴電腦開機時先啟動它、重開機。它一定要在顯示卡驅動之前跑,等驅動接手顯示卡就改不了了。只想看結果,可以直接跳到下一節。
它是 kernel 模組(作業系統核心的外掛),不是修改版驅動。原理是先改寫兩個控制速度的設定值,再讓卡走正常的開機流程。所以它要放進 initramfs(開機最早期載入的那包檔案)。
git clone https://github.com/nlzy/turing-unlock
cd turing-unlock
make install          # 會抓兩個釘版本的 NVIDIA 檔、驗 SHA-256,再打包安裝
裝完它什麼都不做,要在 kernel 參數加一行才會動。Ubuntu 改 /etc/default/grub:
sudo cp /etc/default/grub /etc/default/grub.bak
# GRUB_CMDLINE_LINUX_DEFAULT 裡加上 turing_unlock.targets=all
sudo update-grub
sudo reboot
重開之後看 kernel log,每張卡要有一行 FEAT UNLOCKED:
journalctl -k -b | grep turing_unlock
# turing_unlock: TU102 FEAT UNLOCKED
# pci 0000:xx:00.0: turing_unlock: unlocked
Ubuntu 26.04 要多一步。 我第一次重開後沒解鎖,log 報 EBUSY,卡已經被佔用。原因是 26.04 的 update-initramfs 其實是 dracut,套件放的是 initramfs-tools 的設定,dracut 不認,模組就沒進開機映像檔,nvidia 先搶到卡。補法:
sudo install -Dm644 packaging/boot/dracut.conf /etc/dracut.conf.d/turing-unlock.conf
sudo dracut -f
lsinitramfs /boot/initrd.img-$(uname -r) | grep turing    # 要看到 turing_unlock
sudo reboot
它每次開機才生效,不會寫進顯示卡。要退回原狀,把 grub 參數拿掉重開就好。我的環境是 kernel 7.0.0-38、驅動 580.173.02,三張都解成功;兩張卡之間的 NVLink 解鎖前後都是 25.781 GB/s。
矩陣乘從 50.6 到 69.9 TFLOPS,功耗是天花板
用 PyTorch 跑 FP16 輸入、FP32 累加的矩陣乘,取中位數。TFLOPS 是每秒做幾兆次浮點運算,越大越快;8192³ 是兩個 8192×8192 的矩陣相乘,夠大才量得到卡的上限。家裡三張卡的功耗上限平常設 200W。
| 8192³ 矩陣乘(TFLOPS) | 解鎖前 | 解鎖後 |
|---|---|---|
| 第一張卡(跑 LLM) | 47.0 | 56.6 |
| 第三張卡(跑生圖、影片) | 50.6 | 69.9 |
誤差跟解鎖前差不多(最大誤差 0.128 對 0.129),算出來的東西沒變。第二張卡量的時候上面還掛著服務、VRAM 被吃滿,就沒跑。
提升幅度比作者的 +48% 小,因為我的功耗上限只有 200W,作者是 250W。只跑一發量不出來,要讓卡連續跑兩分鐘:200W 時兩張卡的時脈被壓到 870 / 1068 MHz,很明顯是撞功耗牆。我把上限拉到 220W 再跑一次:
| 持續 120 秒(TFLOPS) | 200W | 220W |
|---|---|---|
| 第一張卡 | 51.5 | 59.8 |
| 第三張卡 | 64.1 | 71.6 |
最高溫多 3~4 °C(第三張 75 → 78 °C),風扇多幾個百分點。最後只把第三張拉到 220W,原因在下一節。
哪些工作會變快:只有走 FP16 tensor core 的
解鎖的只有「FP16 輸入、FP32 累加」這一條路。程式實際走哪條路,要看它用什麼精度算:
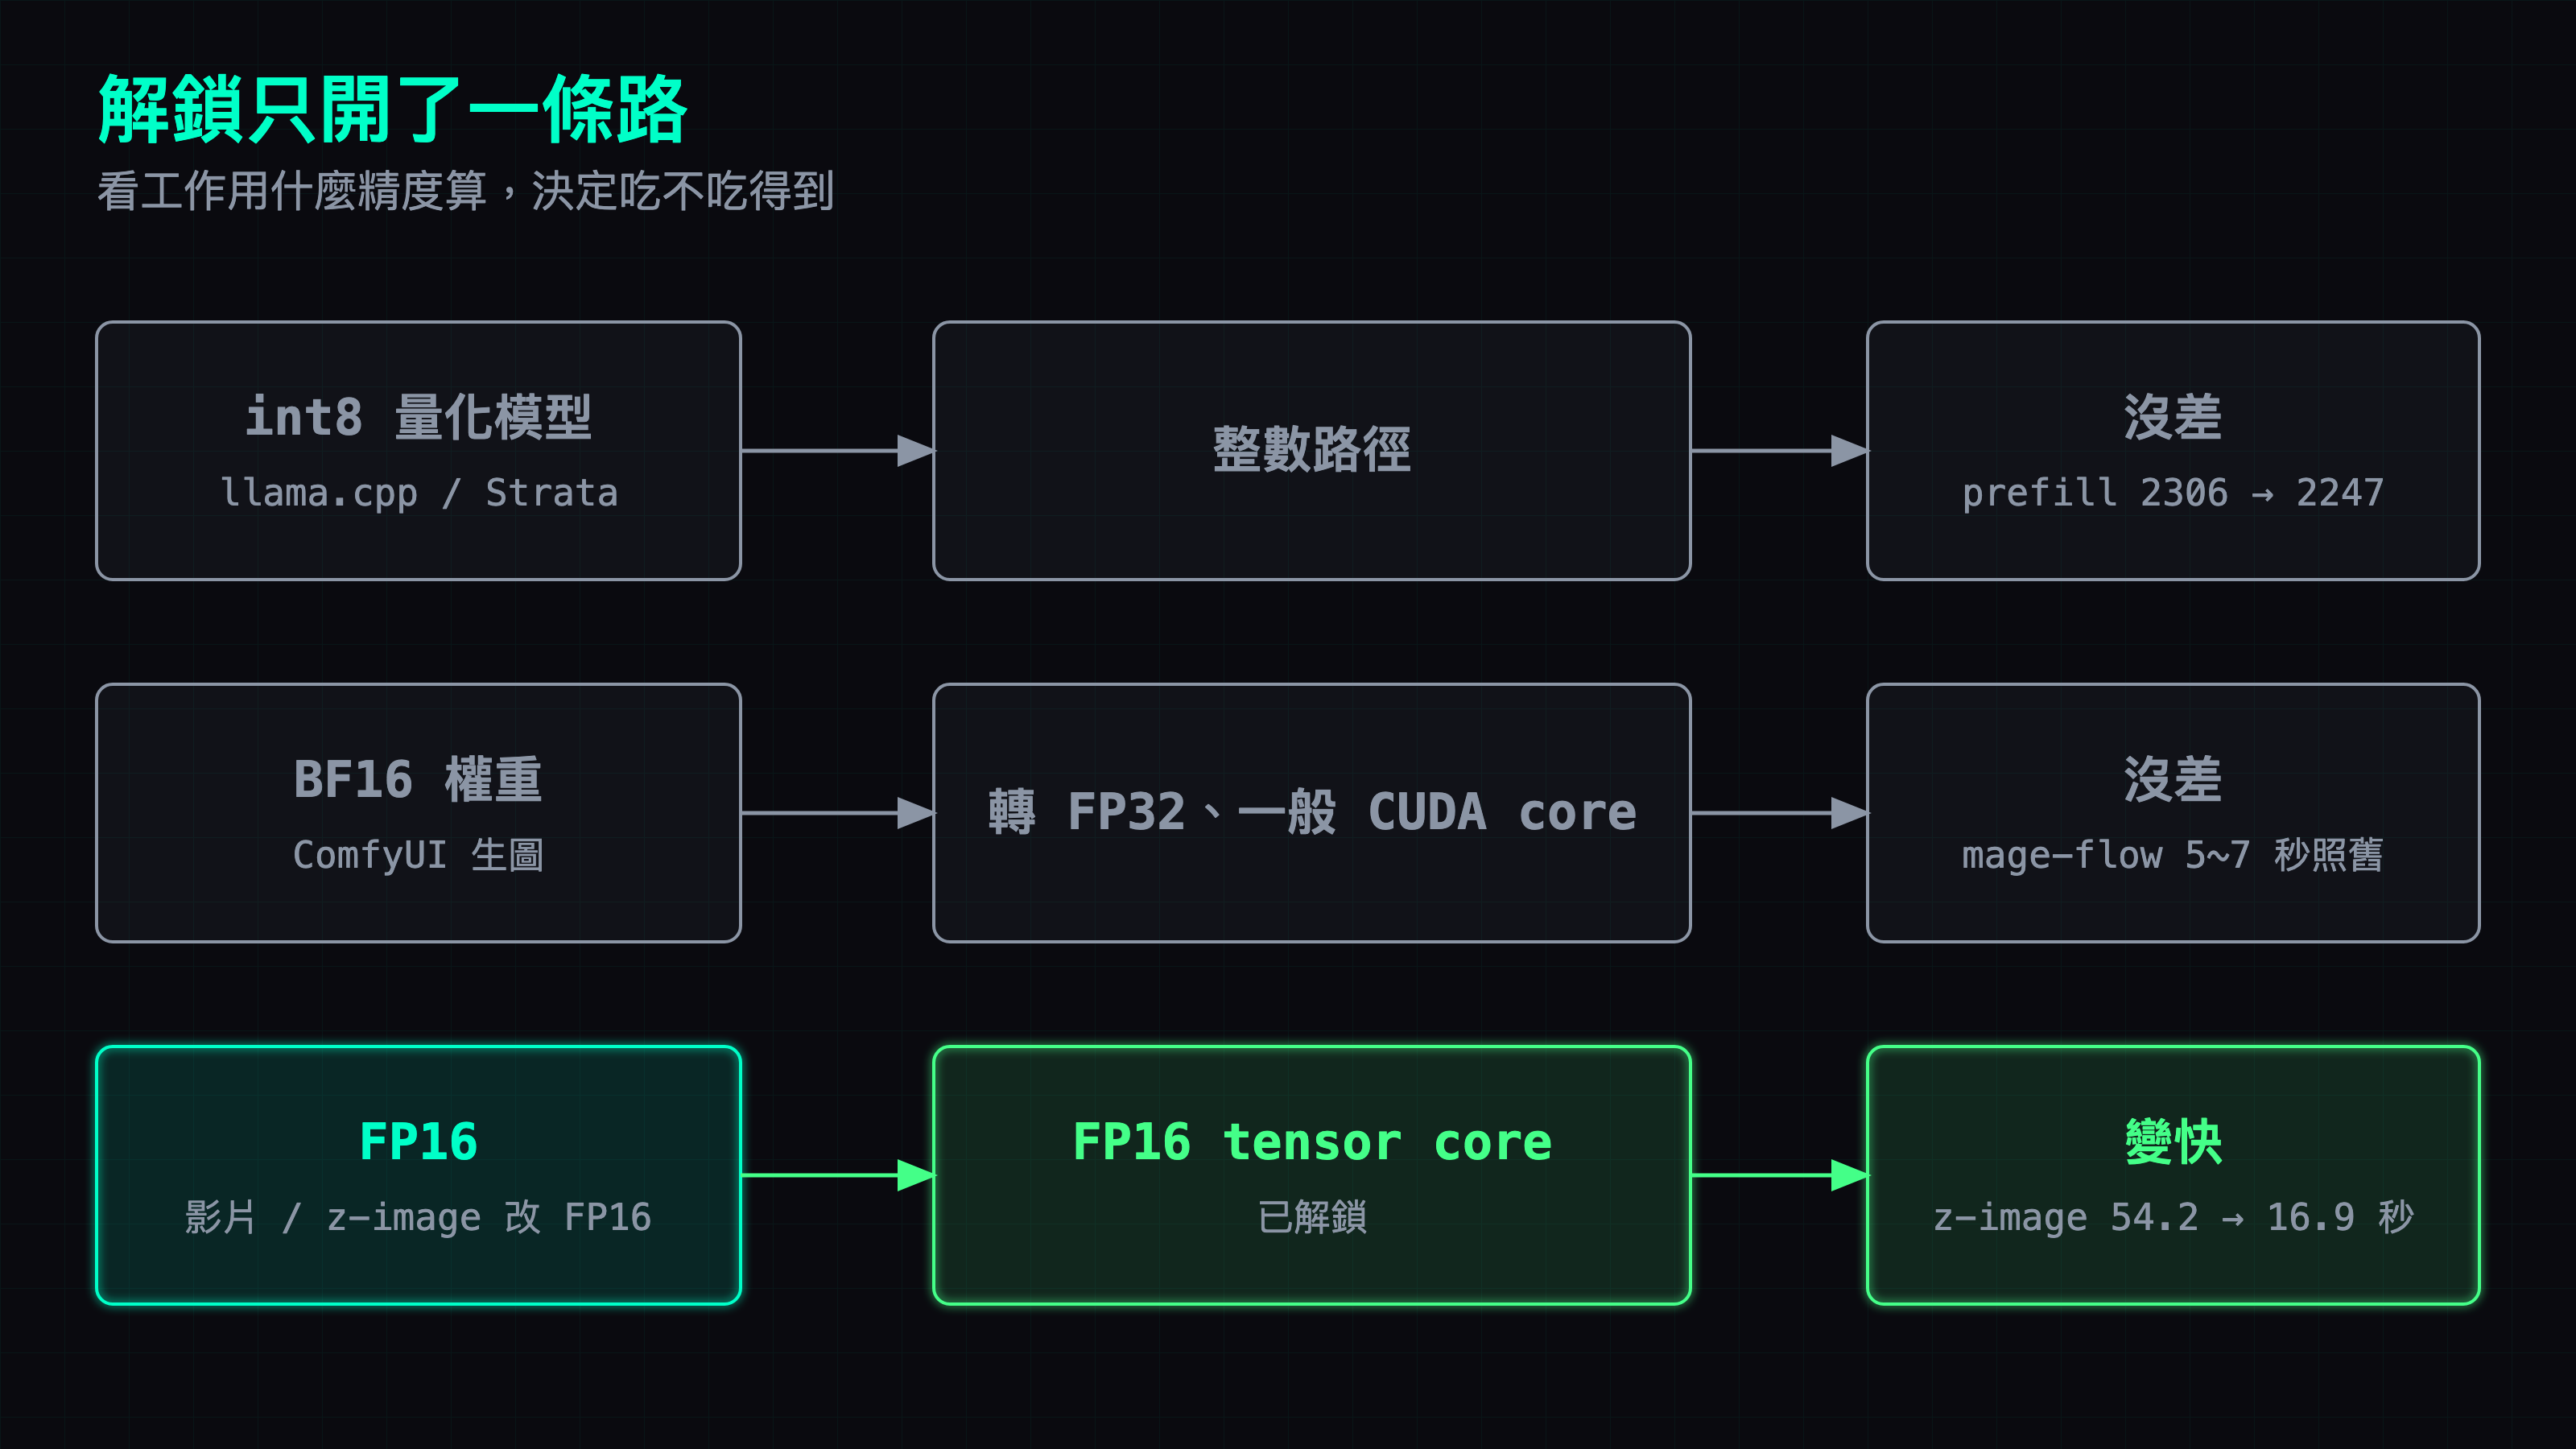
我家三張卡上平常跑三類工作,剛好一類一條路。
LLM 對話模型:幾乎沒差。 第一張卡跑 llama.cpp 的 Q3_K 量化模型,第二張跑 Strata 引擎的 IQ3_S。llama.cpp 跑這類量化模型時,矩陣乘多半直接用整數(int8)算,不經 FP16 tensor core,prefill 幾乎沒變也對得上這點。5128 token 的 prefill(讀 prompt 的速度):
| prefill(tok/s) | 解鎖前 | 解鎖後 200W | 解鎖後 220W |
|---|---|---|---|
| llama.cpp Q3_K | 2306 | 2256 | 2247 |
| Strata IQ3_S | 1238 | 1281 | 1304 |
吐字速度(decode)卡在記憶體頻寬,算力增加也不會比較快,95.8 → 95 tok/s。LLM 這兩張卡不加功耗,留在 200W。
影片生成:每步約快兩成。 第三張卡上的 LTX 影片模型本來就用 FP16 算,直接吃到解鎖。704×400、8 步兩段的生成,解鎖加 220W 每步 4.794.85 秒,整支 6466 秒。解鎖前同樣 8 步兩段的紀錄是每步 6.08 秒、整支 91.6 秒。這筆對照是解鎖前留下的舊紀錄,當時沒記解析度,所以「快兩成」只能當參考,不是嚴格的對照實驗。這也是第三張卡值得多給 20W 的原因。
生圖:原本完全沒變。 解鎖後 mage-flow 一張還是 5~7 秒,z-image 一張還是 60 秒上下。這兩個數字是從送出請求到拿到圖的整段時間,跟下一節 ComfyUI 自己計的秒數量法不同。ComfyUI 的 log 寫得很清楚:
model weight dtype torch.bfloat16, manual cast: torch.float32
Turing 沒有 BF16 硬體,ComfyUI 把這兩個模型轉成 FP32 算,走一般 CUDA core。這個坑我在 #10 就踩過一次,當時是另一台機器慢 3.4 倍。
讓生圖吃到解鎖:z-image 改 FP16,54.2 秒變 16.9 秒
所以要讓生圖變快,得先讓它改走 FP16。ComfyUI 有個啟動參數 --fp16-unet,強迫主模型用 FP16 算。我另外開一個帶這個參數的 ComfyUI,跟原本的 FP32 版本比,1024×1024、同 prompt、同 5 個 seed,暖機後取中位數:
| 每張秒數 | FP32(原本) | FP16 |
|---|---|---|
| z-image 8 步 | 54.2 | 16.9 |
| mage-flow 4 步 | 2.6 | 2.6(沒生效) |
z-image 的 log 變成 torch.float16, manual cast: None,真的用 FP16 算了,一張快 3.2 倍。同 seed 的圖跟 FP32 版每個像素平均差 3.7(滿分 255),放在一起看分不出來:
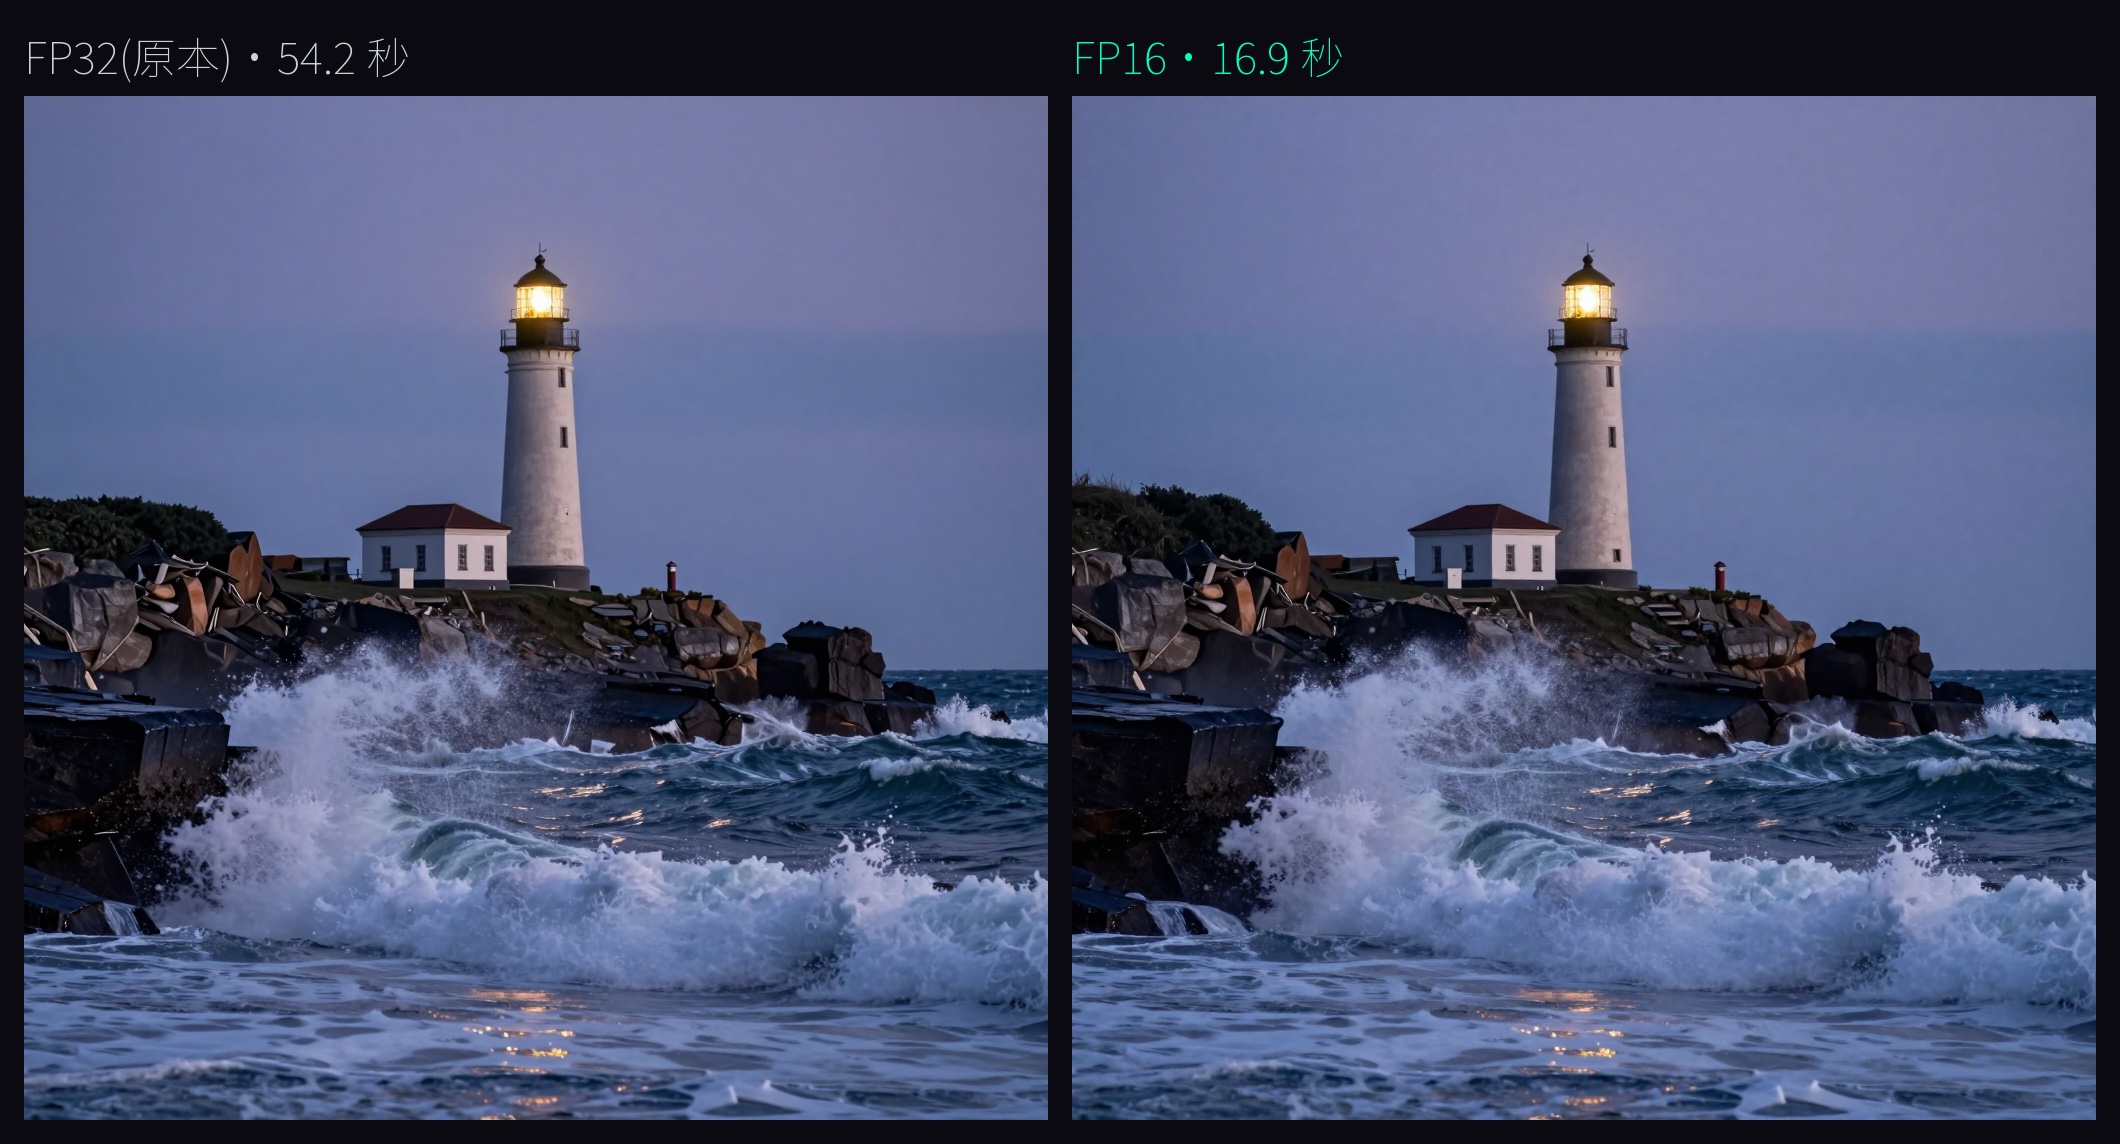
這 3.2 倍是「FP32 一般核心 → 解鎖後的 FP16 tensor core」整段的差距,我沒有在鎖定狀態下量 FP16,所以不能全算在解鎖頭上。
mage-flow 加了參數 log 仍是 manual cast: torch.float32,ComfyUI 判斷這個模型不支援 FP16,自己退回 FP32。我硬改讓它用 FP16 算,一張 1.0 秒,但 6 張全黑,中間的數值已經是 NaN。mage-flow 是 INT8 混合量化的模型,FP16 撐不住,維持原樣。
這個參數會影響同一個 ComfyUI 上的所有模型,所以上線前我把平常會用到的六個生圖、影片流程都用 FP16 跑過一輪。結果沒有黑圖。只有 z-image 和它的高畫質版真的改跑 FP16,其他四個跑出來的圖跟原本一個像素都不差。線上那台 ComfyUI 現在已經加上 --fp16-unet。平常從送出到拿到圖,z-image 一張從 60 秒上下變成 25~30 秒,mage-flow 還是 7 秒左右。
進階:除錯紀錄與原始數據
不讀這節不影響使用。這裡是給要重現的人和 AI 看的細節。
dracut 那一步怎麼查出來的
第一次重開,journalctl -k -b | grep turing_unlock 只看到模組報卡已被佔用。turing-unlock 的套件會依發行版放三種設定:
- mkinitcpio:
/etc/mkinitcpio.conf.d/zz-turing-unlock.conf - initramfs-tools:
/usr/share/initramfs-tools/modules.d/turing-unlock.conf - dracut:
/usr/lib/dracut/dracut.conf.d/turing-unlock.conf
deb 套件只帶了 initramfs-tools 那份。跑 dpkg -S $(which update-initramfs) 一看,這支指令屬於 dracut 套件,Ubuntu 26.04 換成 dracut 了,所以那份設定沒人讀。lsinitramfs 列開機映像檔,grep nvidia.ko 有、grep turing 沒有,確認模組沒進去。手動放 dracut 設定(內容是 force_drivers+=" turing_unlock ")、dracut -f 之後,grep turing 有了,重開就解鎖。
解鎖成功的 kernel log 原文
turing_unlock: booter geometry ok: image=59136 sig=16 patch_loc=0x8700
turing_unlock: unlock result: ss0=0x88888888 ss1=0x8 readout=0x0 (want ss0=0x88888888 ss1=0x8 readout=0)
turing_unlock: TU102 FEAT UNLOCKED
模組是 out-of-tree 而且沒簽章,會多兩行 taints kernel 的警告,開了 Secure Boot 的機器要另外處理簽章。
矩陣乘原始數字
PyTorch 2.6.0+cu124,CUDA 12.4,FP16 輸入、FP32 累加,中位數 / 最大值:
解鎖前
GPU0 4096^3 median 45.2 max 48.0 | 8192^3 median 47.0 max 47.5 maxerr 0.1280
GPU2 4096^3 median 43.8 max 51.9 | 8192^3 median 50.6 max 51.1 maxerr 0.1274
解鎖後(200W)
GPU0 4096^3 median 64.1 max 78.1 | 8192^3 median 56.6 max 57.0 maxerr 0.1293
GPU2 4096^3 median 72.9 max 79.3 | 8192^3 median 69.9 max 70.4 maxerr 0.1275
連續跑 120 秒,每 10 秒記一筆 TFLOPS,文中的數字取最後三筆平均:
GPU2 200W [66.2, 65.9, 66.5, 65.8, 65.6, 64.9, 64.8, 64.8, 64.8, 64.4, 64.2, 63.8] → 64.1
GPU2 220W [75.5, 75.0, 74.4, 73.0, 72.8, 72.5, 72.4, 72.3, 72.0, 72.0, 71.5, 71.3] → 71.6
GPU0 200W [57.1, 56.9, 55.7, 55.3, 54.7, 53.9, 53.4, 52.5, 52.4, 51.8, 51.4, 51.3] → 51.5
GPU0 220W [64.7, 64.3, 63.3, 62.1, 61.3, 60.6, 60.1, 59.8, 60.2, 60.1, 60.0, 59.3] → 59.8
每一筆都往下掉,是溫度上升、時脈跟著降。單發 GEMM 量的是剛起跑的速度,真實工作要看持續值。
功耗上限怎麼設
開機時用一個 systemd 服務設定,解鎖不會改功耗上限:
ExecStart=-/usr/bin/nvidia-smi -pm 1
ExecStart=/usr/bin/nvidia-smi -pl 200
ExecStart=/usr/bin/nvidia-smi -i 2 -pl 220
影片 A/B 的快取坑
ComfyUI 遇到一模一樣的請求會直接回快取,0.05 秒就「生完」一支影片。A/B 要在 prompt 裡塞一個每次不同的亂數(我用 ref {random}),同時固定 seed,才會真的重算。解鎖後三發:
run0 66.8s avg_power=180W avg_clock=1584MHz max_temp=72
run1 66.2s avg_power=183W avg_clock=1568MHz max_temp=75
run2 64.2s avg_power=187W avg_clock=1573MHz max_temp=76
每步 4.79~4.85 s/it
影片生成平均只吃 180W 上下,沒有一直頂在功耗上限,拉到 220W 主要是讓它衝尖峰時不會掉速。
FP16 生圖實驗的細節
- 正式 ComfyUI 的 UNETLoader 沒有 FP16 選項(只有 default 和 fp8),所以用同一份程式、同樣的啟動參數加
--fp16-unet,另開一個 port 跑,跑完關掉。 - 上線前六個流程全跑過:mage-flow、z-image、z-image 高畫質版、flux Q8、LTX 文生影片、LTX 圖生影片各跑 2 次。log 裡 z-image 兩種從
torch.bfloat16, manual cast: torch.float32變成torch.float16, manual cast: None;其他四個的 dtype 行不變,跟線上那台同 seed 比 MAE 是 0。取樣後的 latent 全部沒有 NaN 或 Inf。 - 計時取 ComfyUI 自己的 execution_start → execution_success,含取樣、VAE 解碼、存 PNG。
- z-image FP16 五張:16.74、16.72、16.97、16.95、16.87 秒;FP32 五張 54.20~54.29 秒。
- 全黑判準用像素統計,不靠肉眼:mage-flow 強制 FP16 的 6 張 RGB 平均 0、標準差 0,全黑像素比例 100%。
- sm_75 上 sage-attention 會因為 shared memory 不夠(67584 > 65536)退回 PyTorch attention,解鎖前就這樣,跟這次無關。
常見問題
- turing-unlock 是什麼?會刷 VBIOS 嗎?
- 是 nlzy 把 Zagitta 的 gpu-unlock 改成 Turing 版的 Linux kernel 模組。它在 nvidia 驅動載入前改寫兩個控制速度的設定值,解開 GeForce 卡 FP16 輸入、FP32 累加 tensor core 的半速限制。不刷 VBIOS、不改驅動,每次開機才生效,拿掉 kernel 參數重開就回原狀。
- 2080 Ti 解鎖之後快多少?
- 8192³ 的 FP16 輸入、FP32 累加矩陣乘,功耗上限 200W 時,一張 50.6 → 69.9 TFLOPS,另一張 47.0 → 56.6。把功耗上限拉到 220W,持續 120 秒的平均從 64.1 升到 71.6。誤差跟解鎖前差不多。
- 解鎖後跑 LLM 會變快嗎?
- 我家兩張跑對話模型的卡幾乎沒差。5128 token 的 prefill,llama.cpp 的 Q3_K 模型 2306 → 2256 tok/s(200W)、2247(220W);Strata 引擎的 IQ3_S 1238 → 1281(200W)、1304(220W)。吐字速度卡在記憶體頻寬,本來就不會變。
- 解鎖後 ComfyUI 生圖為什麼沒變快?
- 因為 Turing 沒有 BF16 硬體,ComfyUI 把我用的 mage-flow 和 z-image 轉成 FP32 算,走一般 CUDA core,不經 tensor core。log 會寫 model weight dtype torch.bfloat16, manual cast: torch.float32。要讓 z-image 吃到解鎖,得加 --fp16-unet 改成 FP16,1024² 8 步從 54.2 秒變 16.9 秒。
- Ubuntu 26.04 裝 turing-unlock 之後沒解鎖,log 說 EBUSY 怎麼辦?
- Ubuntu 26.04 的 update-initramfs 其實是 dracut,deb 套件放的 initramfs-tools 設定不會生效,模組沒進開機映像檔,nvidia 先搶到卡。把套件裡的 packaging/boot/dracut.conf 裝到 /etc/dracut.conf.d/,跑 dracut -f,用 lsinitramfs 確認有 turing_unlock 再重開。
接著讀
- 2026-09-14[Benchmark] 2080 Ti 也吃得下 Sol-H3 兩段式:1344×768 有聲影片 165 秒
把 DGX Spark 上的 MiniMax-H3 + LTX-2.5 兩段式產線搬到一張 2018 年的改裝 2080 Ti 22G。五個非改不可的地方,其中兩個失敗時完全無聲、一個會把錯誤印在日誌裡然後自己降級。附完整 workflow 與解析度對照。
- 2026-08-06[趣味競賽 進階 #11] 什麼?2080 Ti 居然跑得動 MiniMax-H3,還生得出 1080p 有聲影片
四個檔案在磁碟上 38 GiB,而卡只有 22 GiB。一張 2018 年的改裝 2080 Ti 22G(sm_75)照樣跑出 15 秒 1080p 有聲片。完整配置、實測速度與畫質,最後才是一路怎麼試出來的。
- 2026-07-18[趣味競賽 進階 #10] 同一張 2080 Ti,一台生圖慢 3.4 倍——兇手是啟動 log 裡一行 dtype fallback
兩台機器裝的是同一張改裝 2080 Ti 22G,一台生 Z-Image 暖機 median 46.08s,另一台一樣的卡只要 ~9.5s。當天記錄上的結論很硬:46s 就是這張卡的天花板——GPU 全程 100%、模型常駐、卡也對。但我記得另一台一樣的卡跑過 10 秒(那筆沒進知識庫),一查發現數據沒騙人、只是漏了一塊。真兇不是矽晶片,是 ComfyUI 啟動 log 裡一行精度 fallback:Turing 沒有 bf16 tensor core,ComfyUI 為了保精度把權重留在 fp32,算得慢 3.4 倍。這篇是把兇手從『100% GPU 看起來就是天花板』這個舒服答案裡挖出來的偵探故事——外加兩個誠實提醒:這個旗標不省 VRAM、對影片模型也完全沒用。
- 2026-10-16[Benchmark] LFM2.5 24B-A2B 一張 2080 Ti 吐字 184.8 tok/s:全場最快,取樣參數一定要照官方
Liquid AI 的 LFM2.5 24B-A2B 大部分層是卷積、每個字只算約 2B。一張改裝 2080 Ti 22G 跑官方 QAD Q4_0:吐字 184.8 tok/s,兩張卡 Q8_0 的 140 題 128,跟原本兩張卡的 27B 一樣。代價是一定會先想、temperature 0 會一直想下去,agent 修 bug 只過 1/5。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。