改裝 2080 Ti 22G · part 25
[Benchmark] 一張 2080 Ti 接手兩張卡的 27B:MiniCPM-V 4.7 35B 吐字 111.5 tok/s,還會看圖
❯ cat --toc
- 前言
- 一張卡吐字 111.5 tok/s,純文字 262k 只用 20.8G
- 140 題 127,原本兩張卡的 27B 是 128
- 數學比 27B 強,推理和長文多跳比較弱
- 會看圖:繁中收據全對,只夾一個簡體字
- 怎麼跑:編 b11588、下 15.5G 那包、請求裡關思考
- 編譯:自己編 sm_75
- 下載
- 啟動:純文字開滿 262k
- 關思考:在請求裡帶 `enable_thinking`
- 會卡住你的三件事
- 換上家裡那一席:看圖、兩人同時用、KV 改 q8_0
- 進階:投機解碼掃描、MTP、長文三跳、長短混跑與量測方法
- 掛了草稿反而變慢,VRAM 明明還剩一大截?
- MTP 寫在 config 裡,權重裡一個都沒有
- 長文三跳:找得到,少走最後一步
- 長 prompt 卡住別人的短問題:自己移植 chunked prefill
- Q4_K_M:一張卡塞不下
- Blender 腳本:裸考 2/5,給速查表加錯誤回饋 5/5
- 量測方法
- 踩到的坑
- 版本與環境
- 還沒做的
TL;DR
MiniCPM-V 4.7 35B-A3B 是會看圖的 MoE 模型,35B 參數每個字只算 3B。一張改裝 2080 Ti 22G 跑官方的混合 q3(15.5G):吐字 111.5 tok/s,純文字開滿 262,144 context 用 20.8G。140 題 127,原本家裡兩張卡的 27B 是 128;數學比 27B 強,推理和長文多跳比較弱。家裡的聊天席已經從兩張卡的 27B 換成一張卡的它,空出來的那張卡給了 Strata。官方的投機解碼草稿在這顆上反而變慢,日常不開。
前言
我那台機器有三張改裝 2080 Ti。家裡人用的聊天服務一直跑 Qwen3.8-27B(#22),占著前兩張卡;第三張給 ComfyUI 生圖,#23 的 Strata 只能跟它輪班。#24 的結論是 Strata 一個人用很好,但我沒有一張卡能固定給它。
這個月 OpenBMB 發了 MiniCPM-V 4.7 35B-A3B,第一顆 MoE 版的 MiniCPM-V:35B 總參數、每個字只用到 3B,還會看圖。如果它一張卡就能做 27B 兩張卡的事,家裡的聊天服務就能少用一張卡。
簡單講:一張卡跑得動、會看圖、262k 開得滿,140 題跟 27B 只差一題。所以我把家裡的聊天席換成它,空出來的卡給 Strata。下面是怎麼跑起來、量到的速度和分數、換上去時用的設定。投機解碼為什麼變慢、長文三跳少走的那一步、長短請求混跑的解法,收在後面的進階區。
一張卡吐字 111.5 tok/s,純文字 262k 只用 20.8G
它是 MoE(混合專家)模型。35B 的參數大部分拆成很多個「專家」,每生一個字,每一層只挑其中幾個來算,加起來約 3B(官方說明寫約 3.5B)。語言部分是 Qwen 系的 MoE(config 寫 qwen3_5_moe),看圖的部分接 SigLIP2,圖片先經過一個叫 mmproj 的投影檔轉成模型讀得懂的東西。
對 2080 Ti 來說,好處有兩個:官方的混合量化 mix_q3gud_im 只有 15.5G,一張 22G 的卡塞得下還有剩;每個字要讀的權重只有 3B,所以吐字快。
下面的表會用到幾個詞。tok/s 是每秒吐出幾個 token,一個 token 大約一個中文字。q3、Q4_K_M、Q8_0 是量化格式,把權重壓小的程度,數字越小檔案越小、通常也掉一點品質。「讀 prompt」是模型先把你丟進去的文字讀完的速度,「吐字」是它開始回答之後的速度。
同一台機器,一張卡跑混合 q3、兩張卡跑 Q8_0。看「吐字」那列:
| 單卡 mix_q3gud_im 15.5G | 雙卡 Q8_0 | |
|---|---|---|
| 讀 prompt:512 / 8K / 32K(tok/s) | 1938 / 1896 / 1597 | 2213 / 3450 / 3050 |
| 吐字(tok/s) | 111.5 | 96.5 |
| 吐字 @32K 深度(tok/s) | 96.0 | 84.6 |
| 16.5 萬 token 撈針,讀完要 | 154 秒 | 82 秒 |
單卡吐字反而比雙卡快:混合 q3 的權重小,每個字要讀的資料少。雙卡強在讀 prompt,8K 以上快約 1.8 倍,撈針測試單卡 154 秒、雙卡 82 秒,兩邊都答對。
context 開到 262,144(官方上限),單卡純文字載入用掉 20.8G。要同時看圖,KV cache 得改成 q8_0,後面「換上家裡那一席」那節有實際設定。
這些速度是當晚的組態量的:llama.cpp b11588,另一張卡同時在跑別的測試,會吃掉一部分 CPU。
140 題 127,原本兩張卡的 27B 是 128
題目 140 題:GSM8K 50、MATH-500 30、MuSR 20、HumanEval+ 40,組成跟 #19 一樣。關思考,4 路並行,576 秒跑完。看最後一列:
| 雙卡 Q8_0 | 單卡混合 q3 + LoRA | |
|---|---|---|
| GSM8K | 49/50 | 49/50 |
| MATH-500 | 30/30 | 30/30 |
| MuSR | 14/20 | 14/20 |
| HumanEval+ | 34/40 | 36/40 |
| 合計 | 127/140 | 129/140 |
原本家裡的 27B 同一套題目,不思考是 128。
第二欄是後來真的要上線的組合:單卡混合 q3,再掛一個社群做的 去拒答 LoRA(rank 1、106MB)。我沒在單卡上跑不掛 LoRA 的 140 題,所以這兩欄差的兩題,分不出是量化、還是 LoRA 造成的。掛上 LoRA 之後看圖沒有壞,同一張收據一樣全對。
數學比 27B 強,推理和長文多跳比較弱
140 題分不太出差別,所以我再跑了一套難題(開思考、temperature 0),雙卡 Q8_0。看「差距」那欄:
| MiniCPM-V 4.7 | 原本的 27B | 差距 | |
|---|---|---|---|
| 數學 AIME | 25/30 | 21/30 | +4 |
| 推理 GPQA | 14/30 | 25/30 | −11 |
| 指令 IFEval | 24/30 | 27/30 | −3 |
| 程式 LiveCodeBench | 12/20 | 14/20 | −2 |
另外兩項:
- 長文三跳查找(11.6 萬 token 的文件裡,照線索連查三次找答案):不思考 0/10、思考 2/10。27B 只跑了 5 題,5 題全對。錯法很一致,進階區有拆。
- agent 修 bug(用 Pi 在真的 repo 裡修 bug,Docker 裡的隱藏測試判分):5/5,每題 15–23 秒。這項是單卡混合 q3 跑的。
會看圖:繁中收據全對,只夾一個簡體字
看圖用單卡混合 q3,掛 mmproj-model-f16.gguf、16K context。我丟了兩張圖:
- 一張繁中收據,要它照原文列出品項、價錢和合計:6 個品項加合計 260,全對。
- 一張「古裝女子在超商吃東西」的生成圖,要它用繁中描述、說出哪裡不合常理:不合理的地方抓到了,整段只夾了一個簡體的「处」。
只有兩張,這只能說它看得懂繁中、不會整段跑成簡體,不是看圖能力的評測。
怎麼跑:編 b11588、下 15.5G 那包、請求裡關思考
這節是給要自己架起來的人:編譯程式、下載模型、啟動服務、送請求,四步,每步都是可以直接複製的指令。不打算自己架的話,跳到下一節看家裡那一席的設定就好。
你需要:
- 一張改裝 2080 Ti 22G。
- 夠新的 llama.cpp。 llama.cpp 在 PR #29416(10-10 合併,b11551 起)才支援 MiniCPM-V 4.7,更早的版本載不起來。我用的是 b11588。
- 權重
MiniCPM-V-4_7-35B-A3B-mix_q3gud_im.gguf(15.5G);要看圖再加mmproj-model-f16.gguf。
編譯:自己編 sm_75
2080 Ti 是 Turing(sm_75),我自己從原始碼編:
git clone --depth 1 --branch b11588 https://github.com/ggml-org/llama.cpp llama.cpp-b11588
cd llama.cpp-b11588
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=75 -DLLAMA_CURL=OFF -DCMAKE_BUILD_TYPE=Release
cmake --build build -j 40 --target llama-server llama-mtmd-cli llama-bench
-j 照你的 CPU 核心數改。
下載
mkdir -p ~/models/minicpm-v47 && cd ~/models/minicpm-v47
B=https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3B-gguf/resolve/main
curl -L -C - --retry 5 -o MiniCPM-V-4_7-35B-A3B-mix_q3gud_im.gguf $B/MiniCPM-V-4_7-35B-A3B-mix_q3gud_im.gguf
curl -L -C - --retry 5 -o mmproj-model-f16.gguf $B/mmproj-model-f16.gguf
-C - 可以續傳,斷了重跑同一行就好。
啟動:純文字開滿 262k
這是量到 20.8G、撈針答對的那一行:
CUDA_VISIBLE_DEVICES=GPU-<你那張卡的 UUID> \
./build/bin/llama-server \
  -m ~/models/minicpm-v47/MiniCPM-V-4_7-35B-A3B-mix_q3gud_im.gguf \
  -ngl 99 -fa on -c 262144 -np 1 -t 24 --jinja --fit off \
  --host 0.0.0.0 --port 8080
- 我的機器有好幾張卡,用
CUDA_VISIBLE_DEVICES指定那張卡的 UUID(nvidia-smi -L看得到)。只有一張卡就不用。 --fit off:關掉自動調整,照你給的 context 載入。舊文件寫的--no-fit,b11588 不認。-t 24是我的 CPU 執行緒數,照你的機器改。
關思考:在請求裡帶 enable_thinking
這顆預設會先思考。要關,在每個請求帶 chat_template_kwargs:
curl -s localhost:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "messages": [{"role": "user", "content": "用 Python 寫一個判斷質數的函式"}],
  "chat_template_kwargs": {"enable_thinking": false},
  "max_tokens": 512
}'
看圖一樣走 API,把圖轉成 base64 放進 image_url:
import base64, json, urllib.request

b = base64.b64encode(open("receipt.png", "rb").read()).decode()
body = {
    "messages": [{"role": "user", "content": [
        {"type": "image_url", "image_url": {"url": "data:image/png;base64," + b}},
        {"type": "text", "text": "這張收據上每一項的品名和價錢是什麼?合計多少?請照收據原文列出。"},
    ]}],
    "temperature": 0.2, "max_tokens": 800,
    "chat_template_kwargs": {"enable_thinking": False},
}
req = urllib.request.Request("http://localhost:8080/v1/chat/completions",
                             json.dumps(body).encode(), {"Content-Type": "application/json"})
print(json.load(urllib.request.urlopen(req, timeout=600))["choices"][0]["message"]["content"])
會卡住你的三件事
llama-mtmd-cli不吃--chat-template-kwargs。 想在命令列用 mtmd-cli 看圖又關思考,做不到,要開 server 打 API。- 別選 Q4_K_M。 它一張卡塞不下,要把 4 層的專家丟到 CPU(
-ncmoe 4),VRAM 只剩 0.8G,吐字掉到 89。混合 q3 整包在顯卡上,111.5。 - llama.cpp 版本不夠新就載不起來。 要有 PR #29416(b11551 起)。
換上家裡那一席:看圖、兩人同時用、KV 改 q8_0
家裡的聊天席現在跑的就是它。實際設定長這樣:
CUDA_VISIBLE_DEVICES=GPU-<你那張卡的 UUID> LLAMA_PREFILL_CHUNK=64 \
./build/bin/llama-server \
  -m MiniCPM-V-4.7-35B-A3B-LoRA1.0-mix-Q3_K.gguf \
  --mmproj mmproj-model-f16.gguf \
  -ngl 99 -fa on -t 24 --jinja --fit off \
  --kv-unified -np 2 -c 131072 -ctk q8_0 -ctv q8_0 \
  -b 2048 -ub 512 --metrics --slots
- 權重:上面那個 LoRA 我先用高精度合進權重,再照官方混合 q3 的格式重新量化,檔案一樣 15.5G。合進去之後執行時就不用再掛 LoRA。合併後的這一版我沒有重跑 140 題,129 是執行時掛 LoRA 量的。
-ctk q8_0 -ctv q8_0:KV cache 是模型記住前文用的暫存,對話越長占越多;這裡把它存成 q8_0,大小約減半。預設 f16 的時候,純文字 262k 就用到 20.8G,再掛 1.07G 的 mmproj 會 OOM;改 q8_0 之後,看圖加 262,144 context 一共 20.4G。家裡那一席我開 131,072,留點空間。--kv-unified -np 2:兩個人可以同時用。--kv-unified時-c是兩條請求共用的總量,不是每條的上限。LLAMA_PREFILL_CHUNK=64:這不是官方的參數,是我自己移植的修補,讓長 prompt 不會卡住別人的短問題。原版 llama.cpp 沒有,拿掉這個環境變數就是原本的行為。細節在進階區。
要給更多人同時用,我在第三張卡上把位置開到 8 個量過(-np 8 -c 262144,權重用官方原版混合 q3、不掛 LoRA,其他同上,20.4G):
| 同時幾個人 | 每人(tok/s) | 合計(tok/s) |
|---|---|---|
| 1 | 107.5 | 103.6 |
| 2 | 80.9 | 154.9 |
| 4 | 50.6 | 189.5 |
| 8 | 30.2 | 224.1 |
上線後在家裡那張卡上重新量了一次單人:吐字 99–104、讀 prompt 約 2,000 tok/s、32K 深度 77。功耗上限一樣是 200W。
這一席換掉以後,前兩張卡的 27B 停了,第二張卡改成固定給 Strata,第三張照舊給 ComfyUI。三張卡各做一件事,不用再輪班。
進階:投機解碼掃描、MTP、長文三跳、長短混跑與量測方法
不讀這節不影響使用。這裡是投機解碼為什麼變慢、MTP 為什麼用不了、長文三跳錯在哪、長 prompt 卡住短問題的解法,以及量法、環境和踩到的坑,寫給想追細節的人和 AI。
掛了草稿反而變慢,VRAM 明明還剩一大截?
官方另外放了一個 DSpark 草稿模型,給投機解碼用(小模型先猜幾個字,主模型一次驗完,猜中的就省下來)。照官方預設 n-max 7 開,中文從 110 掉到 43 tok/s。
第一個直覺是 VRAM:草稿模型多占了記憶體,擠到 KV cache。量下去,掛著草稿整張卡只用 18G,22G 還有剩,這條排除。
接著掃參數。單卡混合 q3、temperature 0,中文、寫程式、英文三種題目:
| 設定 | 中文 | 寫程式 | 英文 |
|---|---|---|---|
| 官方預設 n-max 7 | 110 → 43 tok/s | ||
| n-max 2 | −25%(接受率 28%) | +20%(接受率 76%) | +4% |
n-max 2 加 --spec-draft-p-min 0.75 | 99 → 61 tok/s |
(n-max 7 那組是另外一輪量的,不開草稿的基準是 110;p-min 0.75 那組的基準是 99。)
n-max 開到 3、4 比 2 更慢。中文的接受率只有 15–28%,猜的大部分被主模型退回。
最關鍵的是第三列。加了 --spec-draft-p-min 0.75,草稿只在很有把握時才送出:整段中文只送了 45 個草稿,接受率 96%,結果還是只有 61 tok/s,比不開的 99 慢。猜中率這麼高還變慢,問題就不在猜得準不準,在草稿每一步都要跑的固定成本。p-min 0.5 也一樣比不設更慢。
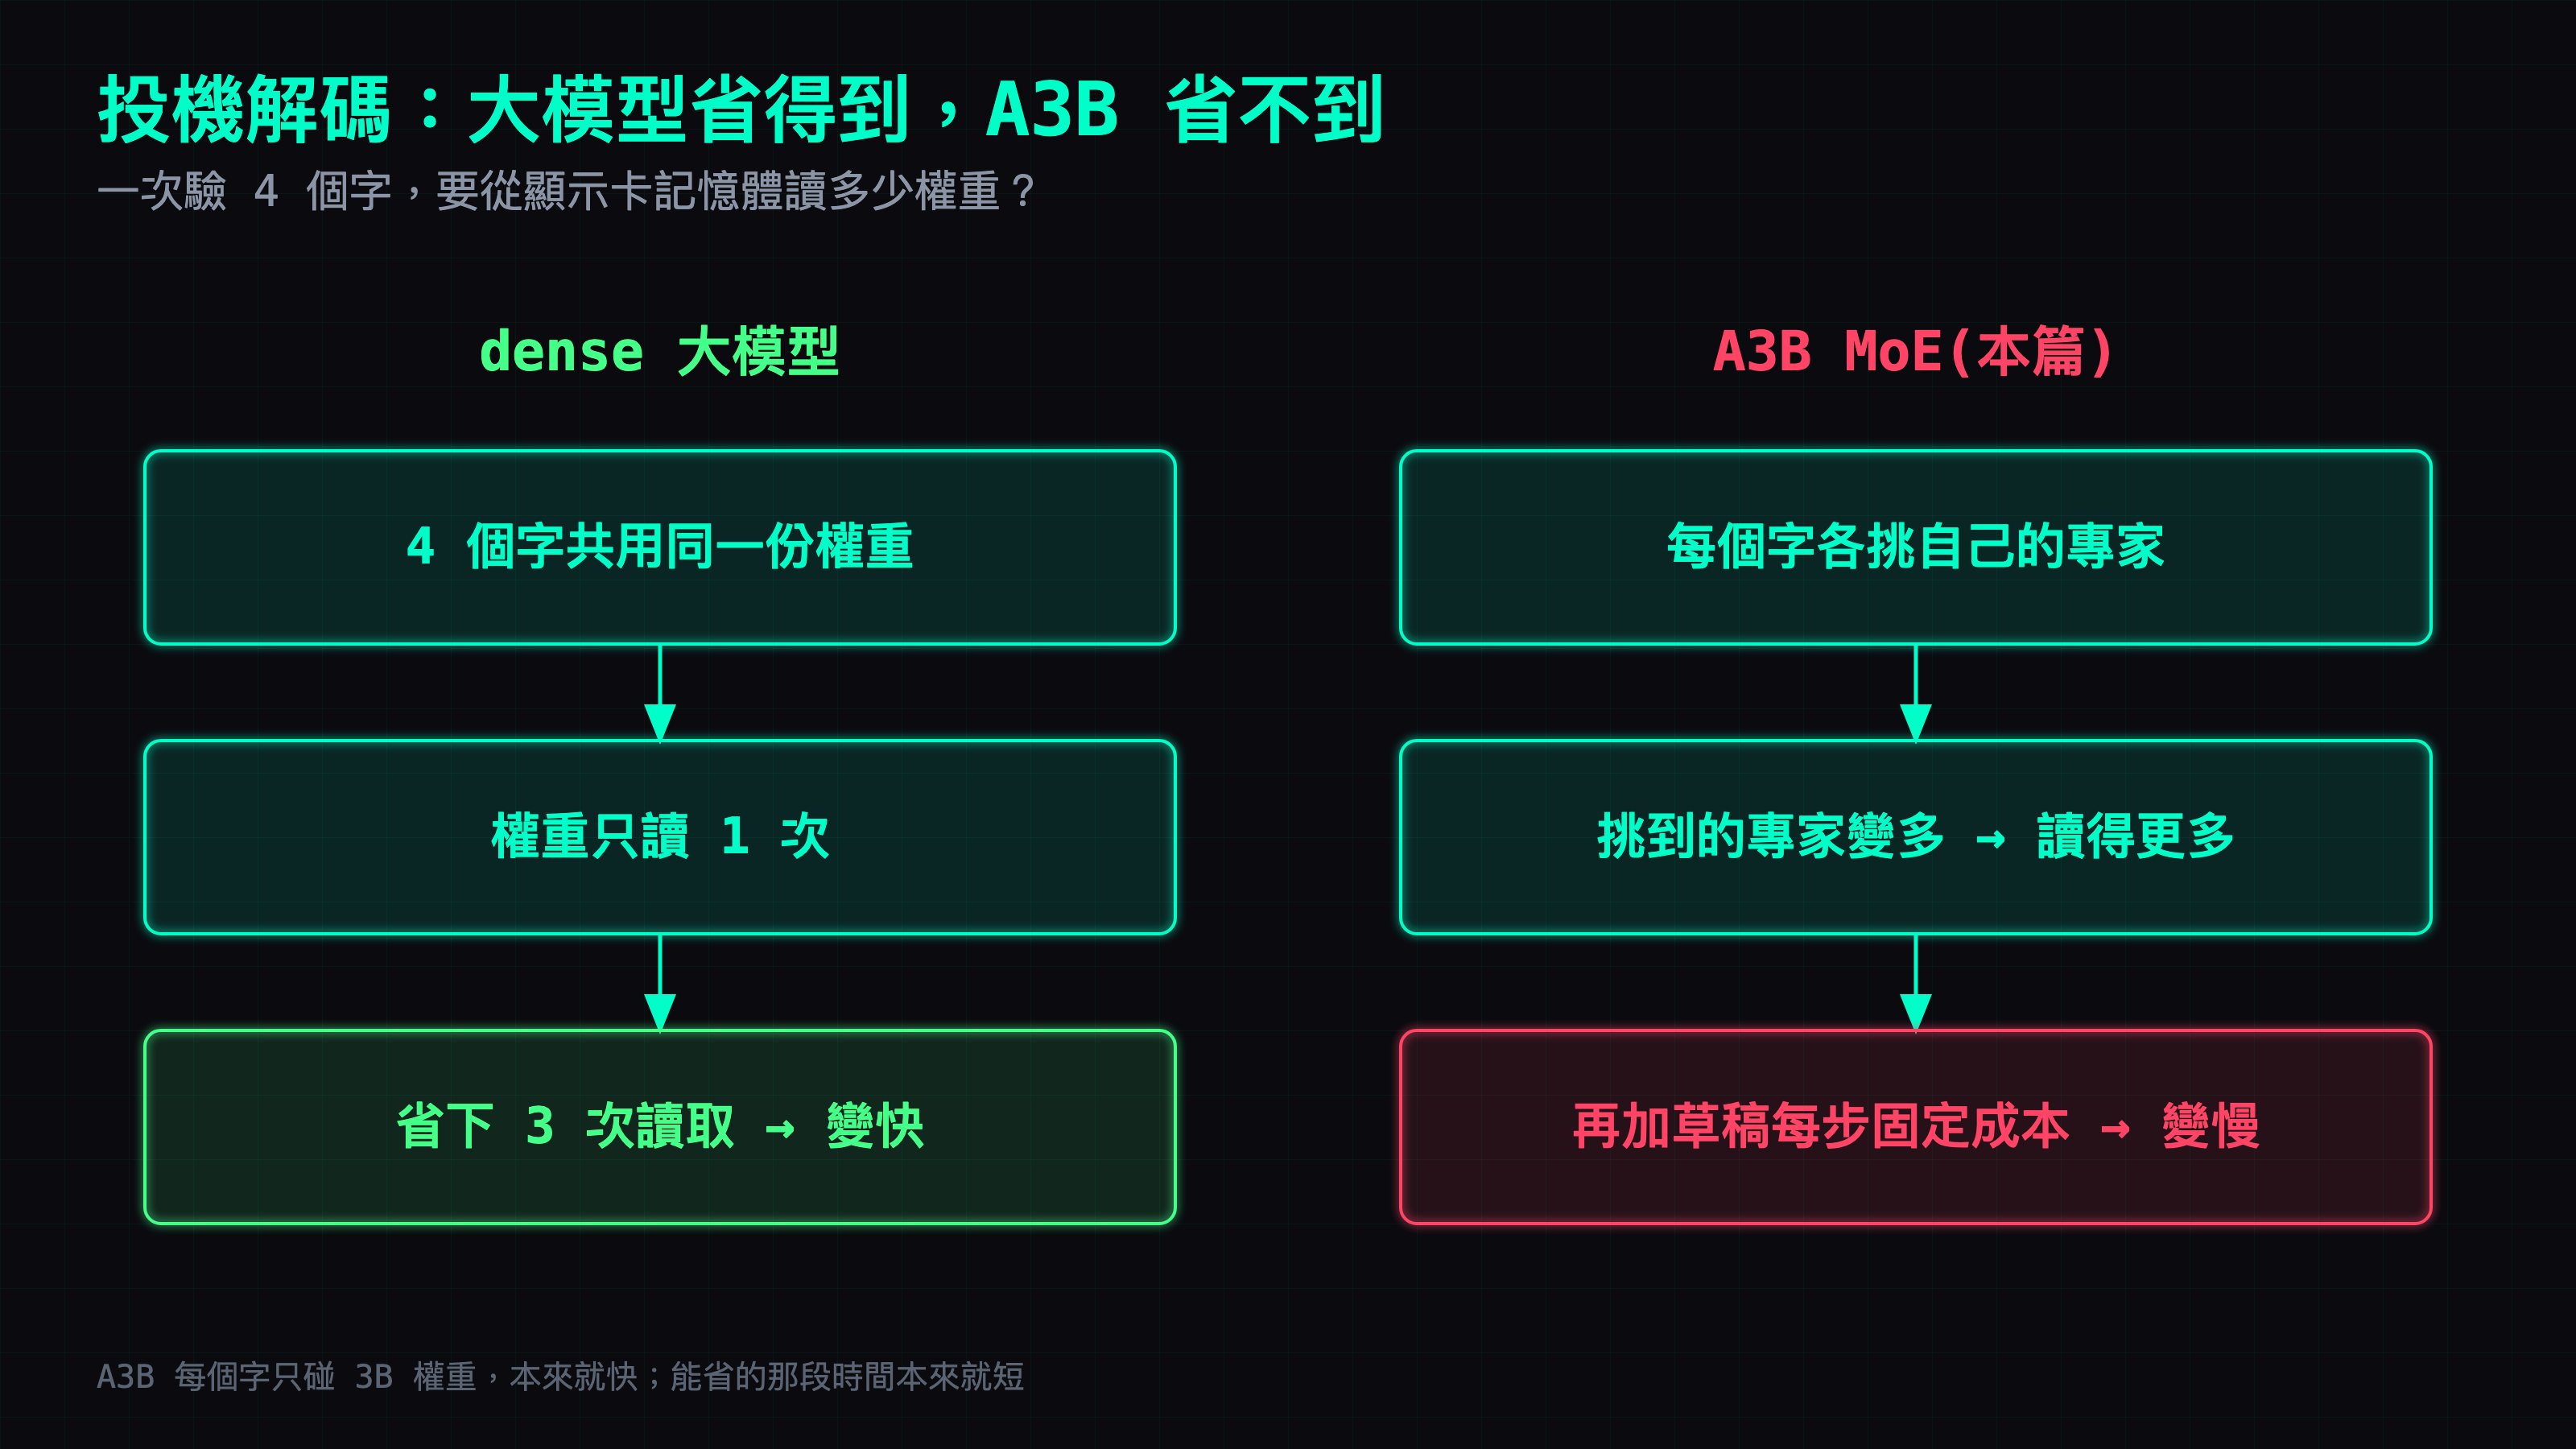
我的解讀是三件事疊在一起:
- 每步本來就便宜。 每個字只碰 3B 的權重,一張卡就有 111.5 tok/s。投機解碼省的是「讀權重」那段時間,這段本來就短。
- MoE 一次驗多個字,省得比較少。 dense 模型一次驗 n 個字,權重只讀一次,這是投機解碼划算的地方。MoE 的 n 個字各自挑自己的專家,挑到的專家不會完全重疊,要讀的資料比只驗 1 個字多,能省下的讀取跟著變少。
- 中文猜不準。 接受率 15–28%,大部分的驗證白做。
#19 在 Bonsai 2 上看過同一件事:投機解碼要划算,前提是吐字被記憶體頻寬卡住。
啟動時加這幾個旗標就是 n-max 2 那組,只有幾乎全是寫程式、英文的工作才值得開:
-md ~/models/minicpm-v47/dspark-MiniCPM-V-4_7-35B-A3B-F16.gguf \
  --spec-type draft-dspark --spec-draft-n-max 2 -ngld 99
b11588 收的旗標是 --spec-draft-p-min。有些文件(包括 llama.cpp 自己的 docs/speculative.md)還寫 --spec-draft-conf-min,照打會直接載入失敗:
error: invalid argument: --spec-draft-conf-min
MTP 寫在 config 裡,權重裡一個都沒有
Qwen 系的模型常內建 MTP(模型自己的草稿層,不用外掛小模型),llama.cpp 也支援 qwen35moe 的 MTP。這顆的 config.json 寫著 mtp_num_hidden_layers: 1,看起來有。
去翻 Hugging Face 上的權重索引,MTP 的張量是 0 個。config 有寫、權重沒放,所以這條路目前走不通,只剩外掛的 DSpark。
長文三跳:找得到,少走最後一步
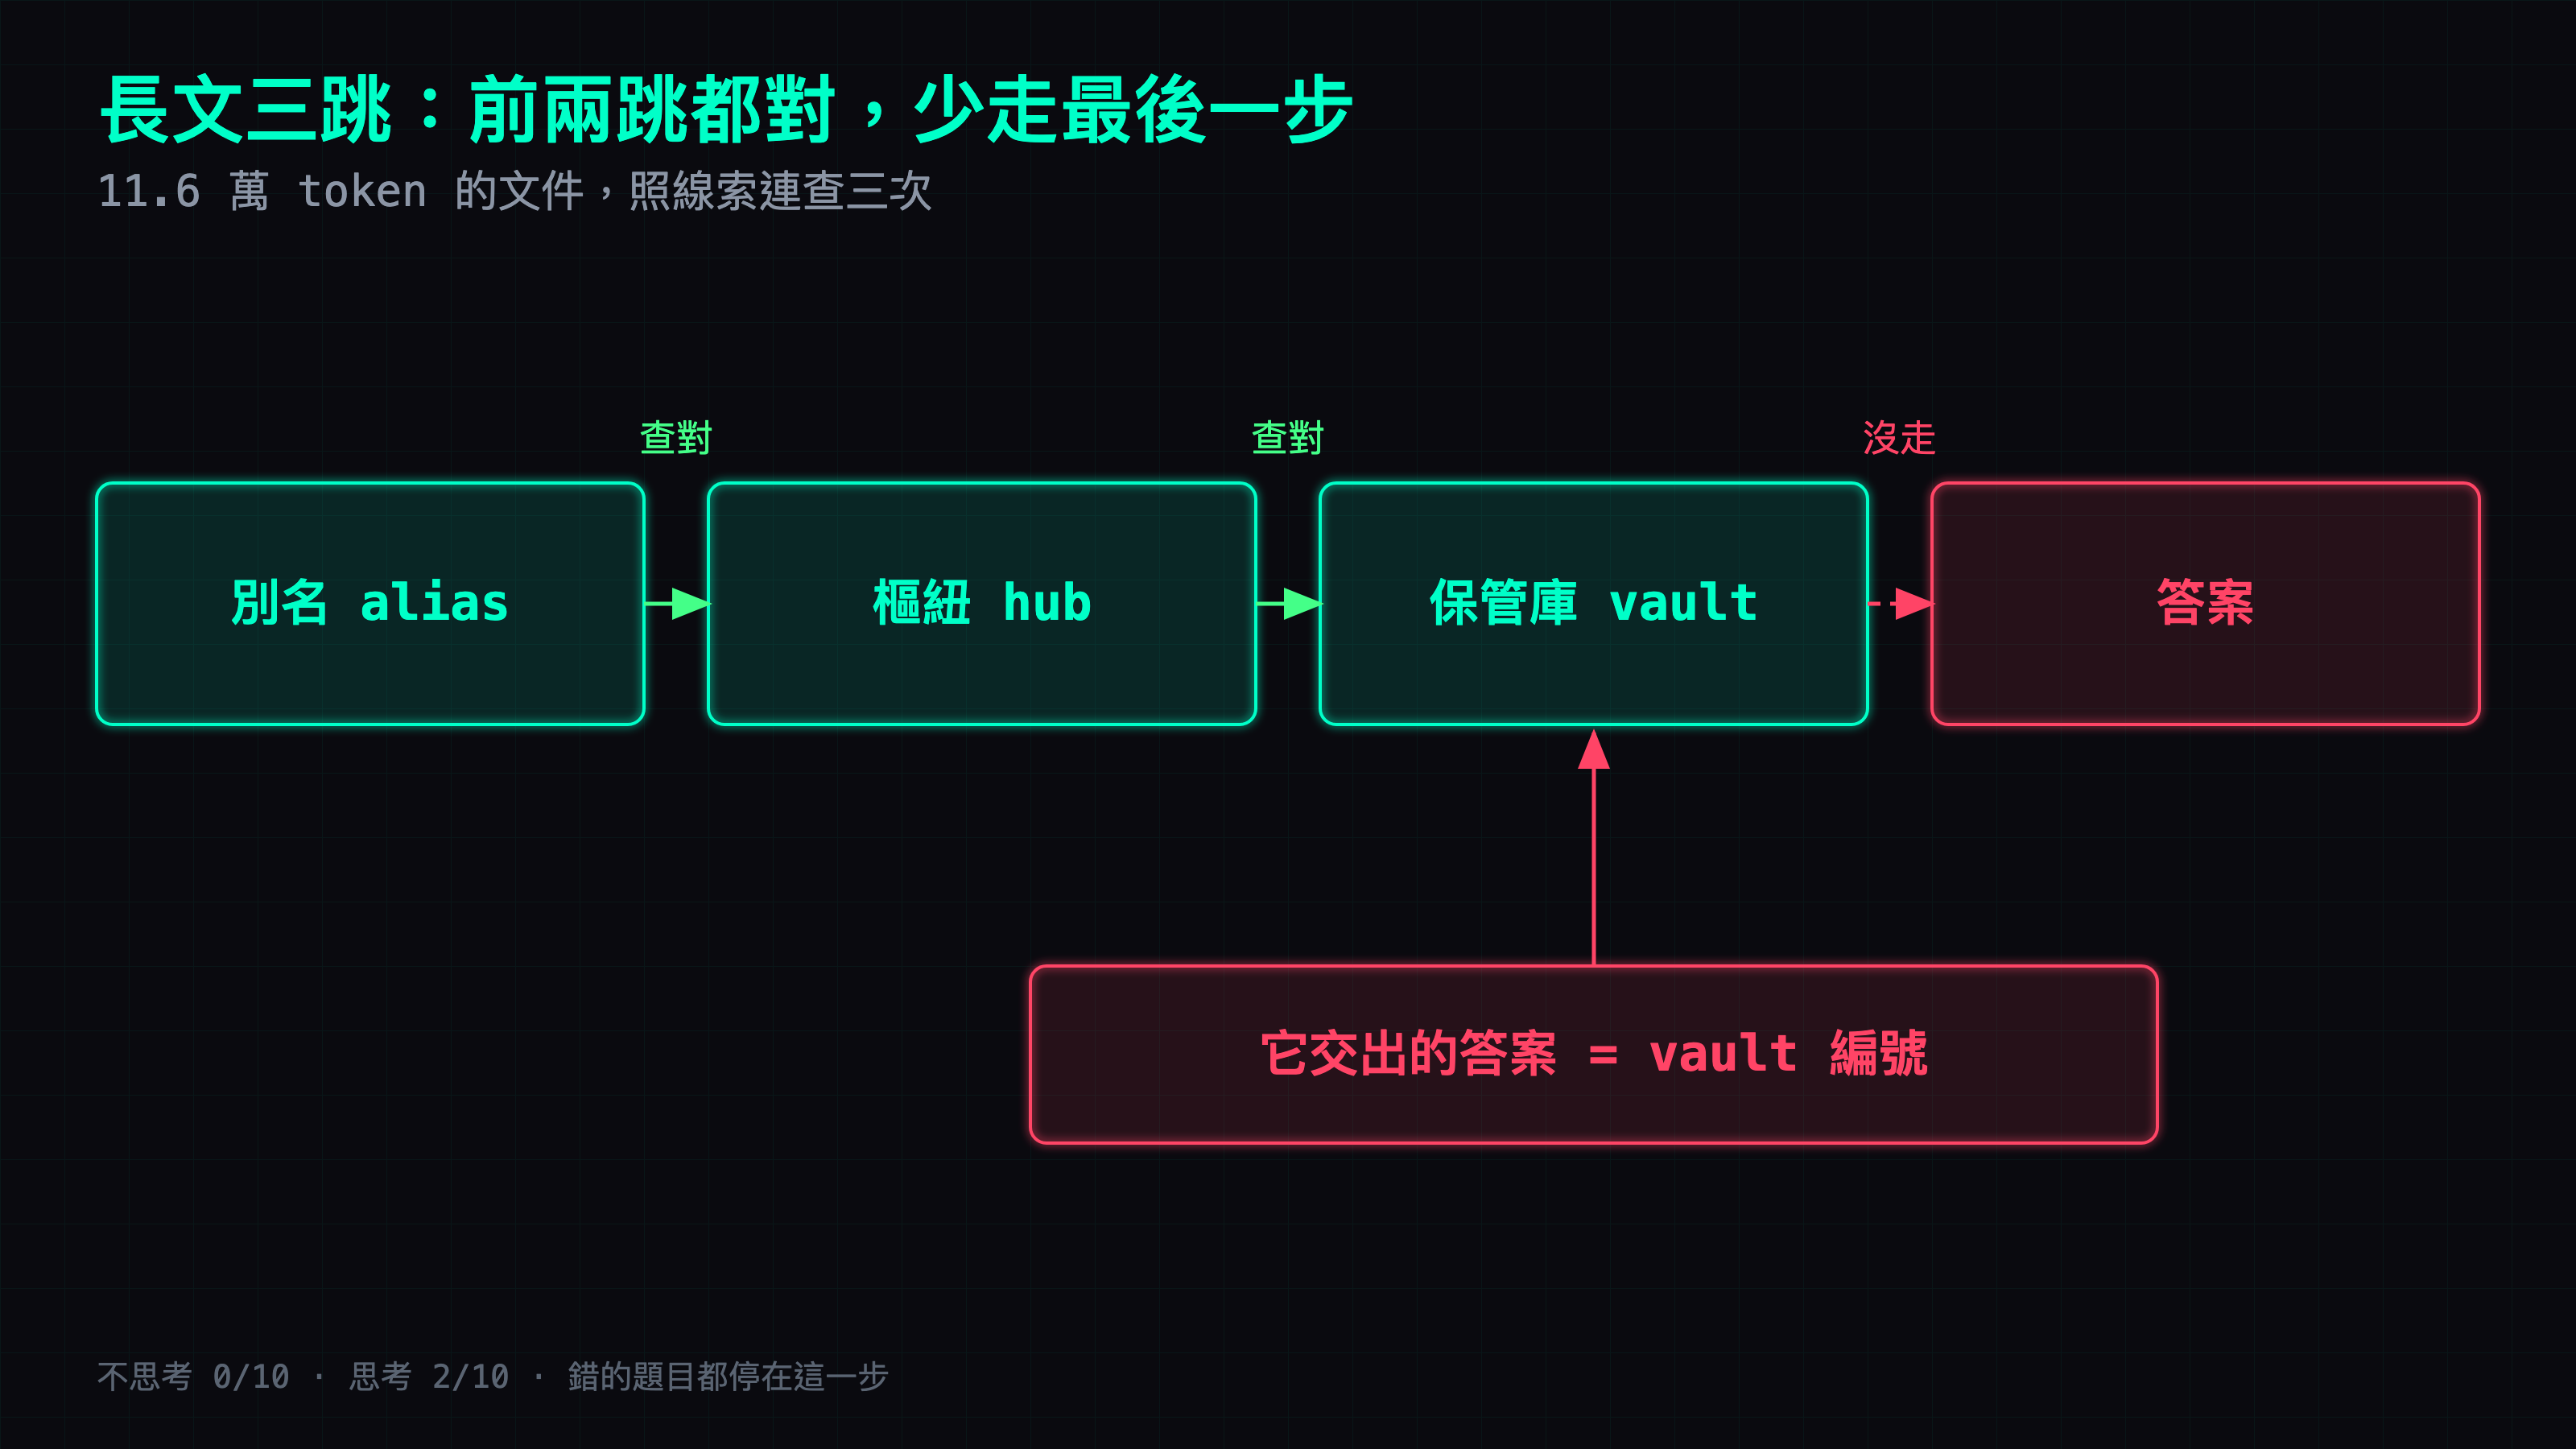
三跳查找的題目長這樣:11.6 萬 token 的文件裡,先由別名(alias)查到樞紐(hub),再由樞紐查到保管庫(vault),最後由保管庫查到答案。中間任何一跳錯,答案就錯。
雙卡 Q8_0,不思考 0/10、思考 2/10。錯的那幾題錯法一樣:前兩跳都對,找到 vault 之後就把 vault 的編號當答案交出來,沒有再走最後一跳。
GPQA 少 11 題也是類似的情況:要多推幾步的題目,它比 27B 弱。
長 prompt 卡住別人的短問題:自己移植 chunked prefill
換上家裡那一席之前,我測了一個家裡真的會發生的情況:有人丟一份很長的文件進來,同時另一個人問一句短的。
原版 llama.cpp 會先把那份長 prompt 整段讀完,才輪到短問題。9 萬 token 的長請求加 3 條短請求,短的要等 27.5–37.5 秒才開始回。
解法是把長 prompt 切成小塊讀,每讀一塊就讓其他請求插進來。llama.cpp 有一個做這件事的 PR #10718,到現在還沒合併,改的也是舊版的程式路徑。我把它的做法手動移植到 b11588 的 server-context.cpp(兩處),用環境變數 LLAMA_PREFILL_CHUNK 控制塊的大小,設 0 就是原本的行為。
| 每塊大小 | 短請求等多久 | 長請求本身 |
|---|---|---|
| 不切 | 27.5–37.5 秒 | 63.6 秒 |
| 512 | 7–8.8 秒 | |
| 256 | 5–6.2 秒 | |
| 64 | 3.2–3.8 秒 | 65.5 秒(+3%) |
切到 64,短問題從半分鐘變 3 秒多,長請求自己只慢 3%,答案全對。32 跟 64 差不到 1 秒,所以用 64。
再量了三種情況:
- 8 個位置、兩條 6 萬 token 長請求加兩條短請求:短的從 35.7–37.4 秒變 4.4–4.5 秒。兩條長的改成平分速度,都約 100 秒完成;不切的時候先到的那條 49.5 秒。
- 帶圖的短請求插在 9 萬 token 長請求中間:7.1 秒變 3.0 秒,答案對。看圖那段程式我沒動,也跟著變快。
- 4 條、8 條同時跑,每條帶不同的標籤,回答裡沒有互相串到別條的內容。
Q4_K_M:一張卡塞不下
我原本想用 Q4_K_M 當單卡的主力。一張卡放不下,要用 -ncmoe 4 把 4 層的專家丟到 CPU 算,載入後 VRAM 只剩 0.8G,吐字 89 tok/s。官方的混合 q3 整包在顯卡上、吐字 111.5,還剩空間開 262k,所以單卡選混合 q3。
Blender 腳本:裸考 2/5,給速查表加錯誤回饋 5/5
我平常也叫本地模型寫 Blender 的 Python 腳本,所以出了 5 題 bpy(展攤、書櫃、預演運鏡、材質、椅子)。
- 裸 prompt:掛 LoRA 的 MiniCPM 2/5,原本的 27B 4/5。兩邊都錯在 Track To constraint 的列舉值,MiniCPM 另外錯在椅子和材質那兩題的 API 寫法。
- 給一份 bpy 速查表、腳本報錯就把錯誤訊息丟回去讓它重寫(最多 2 次):兩邊都 5/5。只給速查表沒有用,有用的是錯誤回饋重試。
我實際工作就是帶速查表和重試,所以這項在我的用法下打平。
量測方法
速度:llama-bench,-ngl 99 -fa 1 -t 24,prompt 512、8192、32768 三種長度,吐字 128 token,每組跑兩次;@32K 那欄是加 -d 32768 在 32K 深度量吐字。
context 上限與撈針:llama-server 用 -c 262144 -np 1 --fit off 載入,灌一段約 context 85% 長的隨機英文單字,在 60% 的位置埋一句密碼,temperature 0、關思考,問它密碼是什麼。單卡跟雙卡都是同一份 165,107 token 的 prompt。
投機解碼:單卡混合 q3,-c 16384 -np 1,中文、寫程式、英文三題,temperature 0;VRAM 在 server 載入 45 秒後讀 nvidia-smi。
140 題:-np 4 --kv-unified 四路並行,關思考。HumanEval+ 用 evalplus 判分。雙卡 Q8_0 576 秒,單卡混合 q3 加 LoRA 772 秒。
難題組:雙卡 Q8_0,開思考、temperature 0。數學 AIME、推理 GPQA、指令 IFEval、程式 LiveCodeBench、長文三跳。
agent:單卡混合 q3,Pi 在真的 repo 裡修 bug,Docker 裡跑隱藏測試判分,temperature 0。
多人同時用:第三張卡,官方原版混合 q3 加看圖、q8_0 KV、-np 8 -c 262144 --kv-unified、LLAMA_PREFILL_CHUNK=64,同時送 1/2/4/8 條。
幾件要知道的:
- 每項只跑一次、temperature 固定,沒有重複抽樣的信賴區間。
- 原本 27B 的分數是之前在別的日期量的,條件不完全一樣。
- 量速度那晚,另一張卡同時在跑別的測試,會吃 CPU;絕對的 tok/s 只代表那晚的組態。
- 上線後第一次在家裡那張卡上量多路,量到讀 prompt 674、吐字 41。那時同一台機器的 Strata 正在重新載入、還有外部請求打進來,數字不能用;重新量時先記下
/metrics的請求總數和/slots,確認沒有別人在用,才得到上面的 99–104。
踩到的坑
- 版本:沒有 PR #29416 的 llama.cpp(b11551 之前)不支援 MiniCPM-V 4.7。
llama-mtmd-cli不吃--chat-template-kwargs:命令列看圖沒辦法關思考,改走 server API。--no-fit在 b11588 不認,要寫--fit off。--spec-draft-conf-min在 b11588 不認,要寫--spec-draft-p-min:有些文件還是舊名,錯誤訊息貼在上面投機解碼那節。- 看圖加 262k 用 f16 KV 會 OOM:改
-ctk q8_0 -ctv q8_0。
版本與環境
- llama.cpp:b11588,自編 sm_75(
-DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=75 -DLLAMA_CURL=OFF);家裡那一席用的是同版加上 chunked prefill 移植的副本 - 模型:openbmb/MiniCPM-V-4.7-35B-A3B-gguf 的
mix_q3gud_im(單卡)、Q8_0(雙卡)、Q4_K_M(只量了速度);看圖用mmproj-model-f16.gguf;投機解碼用dspark-MiniCPM-V-4_7-35B-A3B-F16.gguf;LoRA 來自 AtomicChat/MiniCPM-V-4.7-35B-A3B-Uncensored-GGUF - 機器:EPYC,128GB RAM,三張 RTX 2080 Ti 22G。單卡測試在第三張,雙卡測試用前兩張(那段時間 27B 先停掉),上線後在第一張
還沒做的
- 單卡混合 q3 不掛 LoRA 的 140 題和難題組,能力分數只有雙卡 Q8_0 和單卡加 LoRA 兩組。
- 合併 LoRA 後重新量化的那一版,沒有重跑 140 題。
- 看圖只丟了兩張圖。
- 拒答率我沒有自己量。
同系列:#24 44GB VRAM 跑 177B:兩張 2080 Ti 用 Strata 單人寫程式 98.7 tok/s · #23 一張改裝 2080 Ti 跑 177B:Strata 讓 Qwen3.8-Flash-Next 寫程式 70 tok/s · #22 2080 Ti 沒有 FP4 也能跑 NVFP4:自己轉 Qwen3.8-27B · #19 Qwen3.8 27B 壓到 5.9GB 跑在一張 2080 Ti
常見問題
- 一張 2080 Ti 22G 跑得動 MiniCPM-V 4.7 35B-A3B 嗎?
- 跑得動。用官方的混合量化 mix_q3gud_im(15.5G),一張改裝 2080 Ti 22G 吐字 111.5 tok/s,32K 深度還有 96.0。純文字開滿 262,144 context 用 20.8G,16.5 萬 token 的撈針測試 154 秒讀完、答對。
- MiniCPM-V 4.7 要哪一版 llama.cpp?
- 要包含 PR #29416 的版本。這個 PR 在 2026-10-10 合併,b11551 起就有;我用的是 b11588。2080 Ti 自己編的時候給 -DCMAKE_CUDA_ARCHITECTURES=75。
- MiniCPM-V 4.7 怎麼關掉思考?
- 走 llama-server 的 API,在請求裡帶 chat_template_kwargs,把 enable_thinking 設成 false。llama-mtmd-cli 不吃 --chat-template-kwargs,所以要關思考看圖,也是開 server 再打 API。
- MiniCPM-V 4.7 的官方 DSpark 投機解碼草稿要開嗎?
- 一般不要。官方預設 n-max 7,中文從 110 掉到 43 tok/s。改 n-max 2 之後寫程式快 20%、英文快 4%,中文還是慢 25%。原因不是 VRAM:掛著草稿只用到 22G 裡的 18G。每個字只算 3B 本來就便宜,草稿每一步的固定成本把省下的時間吃光了。
- MiniCPM-V 4.7 的能力跟 Qwen3.8 27B 比怎樣?
- 140 題(不思考)127,原本家裡兩張卡的 27B 是 128。難題分項落差很大:AIME 數學 25/30 對 21,多對 4 題;GPQA 推理 14/30 對 25,少 11 題。11.6 萬 token 的三跳長文查找只對 2/10。這幾組是用兩張卡跑 Q8_0 量的;單卡混合 q3 掛上一個 LoRA 跑同一套 140 題是 129。
- 看圖和 262k context 能在一張 2080 Ti 上同時開嗎?
- KV cache 用預設的 f16 時不行:純文字 262k 已經 20.8G,再掛 1.07G 的 mmproj 就 OOM。KV 改成 q8_0(-ctk q8_0 -ctv q8_0)之後,看圖加 262,144 context 共用 20.4G,放得下。
接著讀
- 2026-08-28[Benchmark] 1770 億參數塞進三張二手 2080 Ti:改檔案快 3.5 倍,寫散文一點都沒快
Qwen3.8-Flash-Next(176.94B)跑在三張改裝 2080 Ti 上:128K context 拿到 23.14 tok/s,開 ngram 投機解碼後改檔案衝到 77.56。附三種量化在相同條件下的對照。
- 2026-10-16[Benchmark] LFM2.5 24B-A2B 一張 2080 Ti 吐字 184.8 tok/s:全場最快,取樣參數一定要照官方
Liquid AI 的 LFM2.5 24B-A2B 大部分層是卷積、每個字只算約 2B。一張改裝 2080 Ti 22G 跑官方 QAD Q4_0:吐字 184.8 tok/s,兩張卡 Q8_0 的 140 題 128,跟原本兩張卡的 27B 一樣。代價是一定會先想、temperature 0 會一直想下去,agent 修 bug 只過 1/5。
- 2026-08-21[Benchmark] 換一個檔案、改一個數字,2080 Ti 上的 27B 免費快 15%
Qwen3.8-27B 在 2080 Ti 的免費加速實測:修復版 chat template 讓 KV 快取命中 94.5%,MTP 草稿深度 2 開到 4 讓 decode 從 41.6 到 47.6 tok/s。附完整驗證方法。
- 2026-10-1444GB VRAM 跑 177B:兩張 2080 Ti 用 Strata 單人寫程式 98.7 tok/s
兩張改裝 2080 Ti 22G 用 Strata 跑 177B 的 Qwen3.8-Flash-Next IQ3_S:一個人寫程式 98.7 tok/s,比同版單卡快約 15%。四個人同時用每人掉到 26–32、合計 94–117;同一組卡上的 27B 四人合計 420。附單卡改雙卡的設定。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。