改裝 2080 Ti 22G · part 28
[Benchmark] 改裝 2080 Ti 跑 Idol 一張圖變 3D:官方加速會報錯,改一行從 84.8 秒變 72.7 秒
❯ cat --toc
- 前言
- 一張圖進去,出來一個能轉的 `.ply`
- 安裝:兩個受限模型,其中一個可以繞開
- FLUX.2-dev 的坑:README 是 200,不代表你有權限
- 換成公開的 FLUX.2-klein-4B VAE
- 跑一張:2080 Ti 要加 `--no_optimize`,每張 84.8 秒
- 官方加速為什麼在 2080 Ti 報錯?改一行變 72.7 秒
- 速度:2080 Ti 72.7 秒,RTX 5090 14.9 秒
- VRAM:PyTorch 量到 6894 MiB,整張卡多吃約 11 GB
- 成品:正面照著做,背面是模型猜的
- 參數:25 步快一倍,100 萬顆看不出更清楚
- 進階:官方加速拆開量、kernel 確認和量測條件
- 官方加速是三招合在一起
- sm_75 實際用的是 mem-efficient SDPA
- 拆開量:省下的時間主要來自 compile
- 5090 上官方加速省 12% 的時間
- bf16 在 2080 Ti 是模擬的,但能跑
- 同 seed 同機位元一致,跨機就不同
- 兩種 VRAM 數字
- 共卡測試的限制
- 量測條件
- 環繞影片怎麼算出來的
TL;DR
Idol 把一張圖變成可以轉著看的 3D Gaussian splat,Apache-2.0。官方速度表沒有 Turing,改裝 2080 Ti 22G 照預設跑會報錯,因為官方加速指定的 cuDNN attention 只支援 sm80 以上。加 --no_optimize 每張 84.8 秒;改 pipeline.py 一行讓 Turing 跳過 cuDNN,72.7 秒。RTX 5090 是 14.9 秒(官方 14.1)。受限的 FLUX.2-dev VAE 可以換成公開的 klein-4B。背面補得完整,但沒拍到的地方是模型猜的。
前言
手上有一張圖,想讓它變成可以轉著看的 3D 物件。自己建模太花時間,那能不能丟一張圖就拿到?
speridlabs 開源的 Idol 做的就是這件事:一張圖進去,它去背、裁切,生出最多 1,048,576 顆 Gaussian,連照片沒拍到的那幾面也一起補。Gaussian splat 不是一般 3D 模型那種三角形網格,是幾十萬顆半透明、有顏色的小橢球疊出來的物體,從哪個角度看都行。授權是 Apache-2.0。
官方 README 有一張各顯卡的速度表,RTX 5090 一張 14.1 秒、RTX 3080 46.2 秒、L4 54.6 秒,最舊就到 Ampere,沒有 Turing。這系列的主角是改裝 2080 Ti 22G,上一篇 #27 才剛在折騰它的 tensor core。所以這篇要回答的是:2080 Ti 跑得動嗎?要多久?能不能再快一點?
答案先講:跑得動,但照預設跑會報錯。加一個旗標每張 84.8 秒,改一行程式 72.7 秒。
一張圖進去,出來一個能轉的 .ply
先看成品。這是三張圖各自生出來的 Gaussian splat,繞一圈給你看:古風美女、蠑螈玩偶,還有一張 2080 Ti 顯卡。
每張圖跑完會拿到三個檔:
<name>.ply:標準 3DGS 格式,支援標準 3DGS PLY 的 viewer 都能開。預設 262,144 顆的檔案約 17.8 MB。<name>_input.png:模型實際看到的圖,已經去背、裁好。<name>_camera.json:模型猜的輸入相機角度。
安裝:兩個受限模型,其中一個可以繞開
這節做三件事:把程式抓下來、裝好 Python 環境、登入 Hugging Face(放模型的網站)拿下載權限。不熟命令列的話,把這節的指令整段貼給 Claude 或 ChatGPT,請它在你電腦上照著跑就好。
Idol 本體不用申請,但它要借兩個別人的編碼器,兩個都是受限模型(gated model,要在 Hugging Face 頁面按同意條款才能下載):
- facebook/dinov3-vith16plus-pretrain-lvd1689m:看圖抓特徵用的。
- black-forest-labs/FLUX.2-dev:Idol 只用它的 VAE。
先把 SDK 裝起來。我用 uv 開獨立環境,PyTorch 是 2.11.0+cu128:
git clone https://github.com/speridlabs/idol-sdk
cd idol-sdk
uv venv --python 3.11 .venv
source .venv/bin/activate
uv pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128
uv pip install -e .          # 用 pip 也行:pip install -e .
hf auth login                # 貼你的 Hugging Face token
FLUX.2-dev 的坑:README 是 200,不代表你有權限
我第一次檢查權限是打 FLUX.2-dev 的 README,回 200,以為過了。結果 README 本身不受限,誰打都是 200。要打 vae/ 裡的檔才看得出來:
TOKEN=$(cat ~/.cache/huggingface/token)
URL=https://huggingface.co/black-forest-labs/FLUX.2-dev/resolve/main

curl -sIL -o /dev/null -w '%{http_code}\n' -H "Authorization: Bearer $TOKEN" $URL/README.md        # 200,沒參考價值
curl -sIL -o /dev/null -w '%{http_code}\n' -H "Authorization: Bearer $TOKEN" $URL/vae/config.json  # 沒同意條款 = 403
到頁面按同意、等核准,再用有權限的帳號登入就解了。不想同意 FLUX.2-dev 的條款,也有路可以繞。
換成公開的 FLUX.2-klein-4B VAE
FLUX.2-klein-4B 的 vae/ 是公開的,用的是同一個 class(AutoencoderKLFlux2),設定也符合 SDK 要的結構:latent 32 通道、block_out_channels 是 [128, 256, 512, 512]、patch [2, 2]。
SDK 從權重資料夾的 config.json 讀 VAE 要去哪個 repo 抓,所以把權重下載到本機,改那一行:
hf download speridlabs/idol --local-dir idol-weights
# idol-weights/config.json 的 image_encoders.flux2_vae
-    "flux2_vae": "black-forest-labs/FLUX.2-dev"
+    "flux2_vae": "black-forest-labs/FLUX.2-klein-4B"
之後跑的時候加 --weights idol-weights,第一次會自動抓 klein 的 vae/。
klein 版的檔案幾乎正好是 dev 版的一半:dev 版 336,213,556 bytes,klein 版 168,120,878 bytes。dev 是 FP32、klein 是 bf16,而官方表本來就寫 VAE 是「FP32 checkpoint,載入時轉 bf16」,所以載進顯卡之後精度一樣。至於是不是同一組權重,我後來去 dev 頁面按了同意,把兩份都下載下來逐個張量比對:dev 的 251 個張量轉成 bf16 之後,跟 klein 每一個位元都一樣,兩份 config 也只差 diffusers 版本號。所以換 klein 跑出來的結果跟官方用 dev 完全相同。
跑一張:2080 Ti 要加 --no_optimize,每張 84.8 秒
指令照官方 README:
python -m idol.sample --image ancient-beauty.png --mode synthetic --weights idol-weights --no_optimize
python -m idol.sample --image photos/ --mode real --weights idol-weights --no_optimize --out outputs
--mode 要選對:電腦算圖、AI 生的圖用 synthetic(預設),實拍照片用 real。兩個模式差在裁切時物體佔畫面多大,synthetic 約 1/1.2、real 約 1/1.7,照片四周留比較多空間。
在 2080 Ti 上不加 --no_optimize,第一張圖跑幾秒就掛:
UserWarning: cuDNN MHA only supports gpu architectures in the range [sm80, sm121]. Attempting to run on a sm 7.5 gpu.
...
torch._dynamo.exc.TorchRuntimeError: RuntimeError when making fake tensor call
  ... scaled_dot_product_attention ... got RuntimeError('No available kernel. Aborting execution.')
加了 --no_optimize 就順了。50 步、262,144 顆,44 張圖的中位數 84.8 秒,最快 84.5、最慢 85.1,很穩。
官方加速為什麼在 2080 Ti 報錯?改一行變 72.7 秒
錯誤訊息其實講完了:cuDNN(NVIDIA 的深度學習加速函式庫)的 attention 只支援 sm80 到 sm121,2080 Ti 是 sm75。sm 後面的數字是 NVIDIA 標顯卡世代的編號,80 是 RTX 30 系列那代,75 是 2080 Ti 這代。問題是誰叫它用 cuDNN 的?
翻 idol/pipeline.py,官方加速打開時,取樣那段會無條件把 attention 切成 sdpa_cudnn。Turing 沒有這個 kernel,就報錯。可是 --no_optimize 是整包關掉,連 torch.compile 這種跟 cuDNN 無關、Turing 也吃得到的加速一起丟了。
所以只改那一行:compute capability 8.0 以上才切 cuDNN,其他卡維持原本的 sdpa,讓 PyTorch 自己挑 kernel。compile、併 batch、TF32 那幾行都不動。
diff --git a/idol/pipeline.py b/idol/pipeline.py
index 677789c..5489a4b 100644
--- a/idol/pipeline.py
+++ b/idol/pipeline.py
@@ -134,7 +134,8 @@ class IdolPipeline:
             yield
             return
         backend, tf32 = layers.ATTN_BACKEND, torch.backends.cuda.matmul.allow_tf32
-        layers.ATTN_BACKEND = 'sdpa_cudnn'
+        if torch.cuda.get_device_capability(self.device) >= (8, 0):
+            layers.ATTN_BACKEND = 'sdpa_cudnn'
         torch.backends.cuda.matmul.allow_tf32 = True
         try:
             yield
改完拿掉 --no_optimize 照跑。10 張的中位數 72.7 秒,省 14%。
要注意第一張:官方加速會先編譯,打了 patch 的第一張是 84.8 秒(這台機器已有先前留下的編譯快取,全新環境第一次編譯會更久),跟不加速一樣,第二張起才是 72.7。只跑一張圖的話,改不改都差不多;一次丟一整個資料夾才賺得到。
速度:2080 Ti 72.7 秒,RTX 5090 14.9 秒
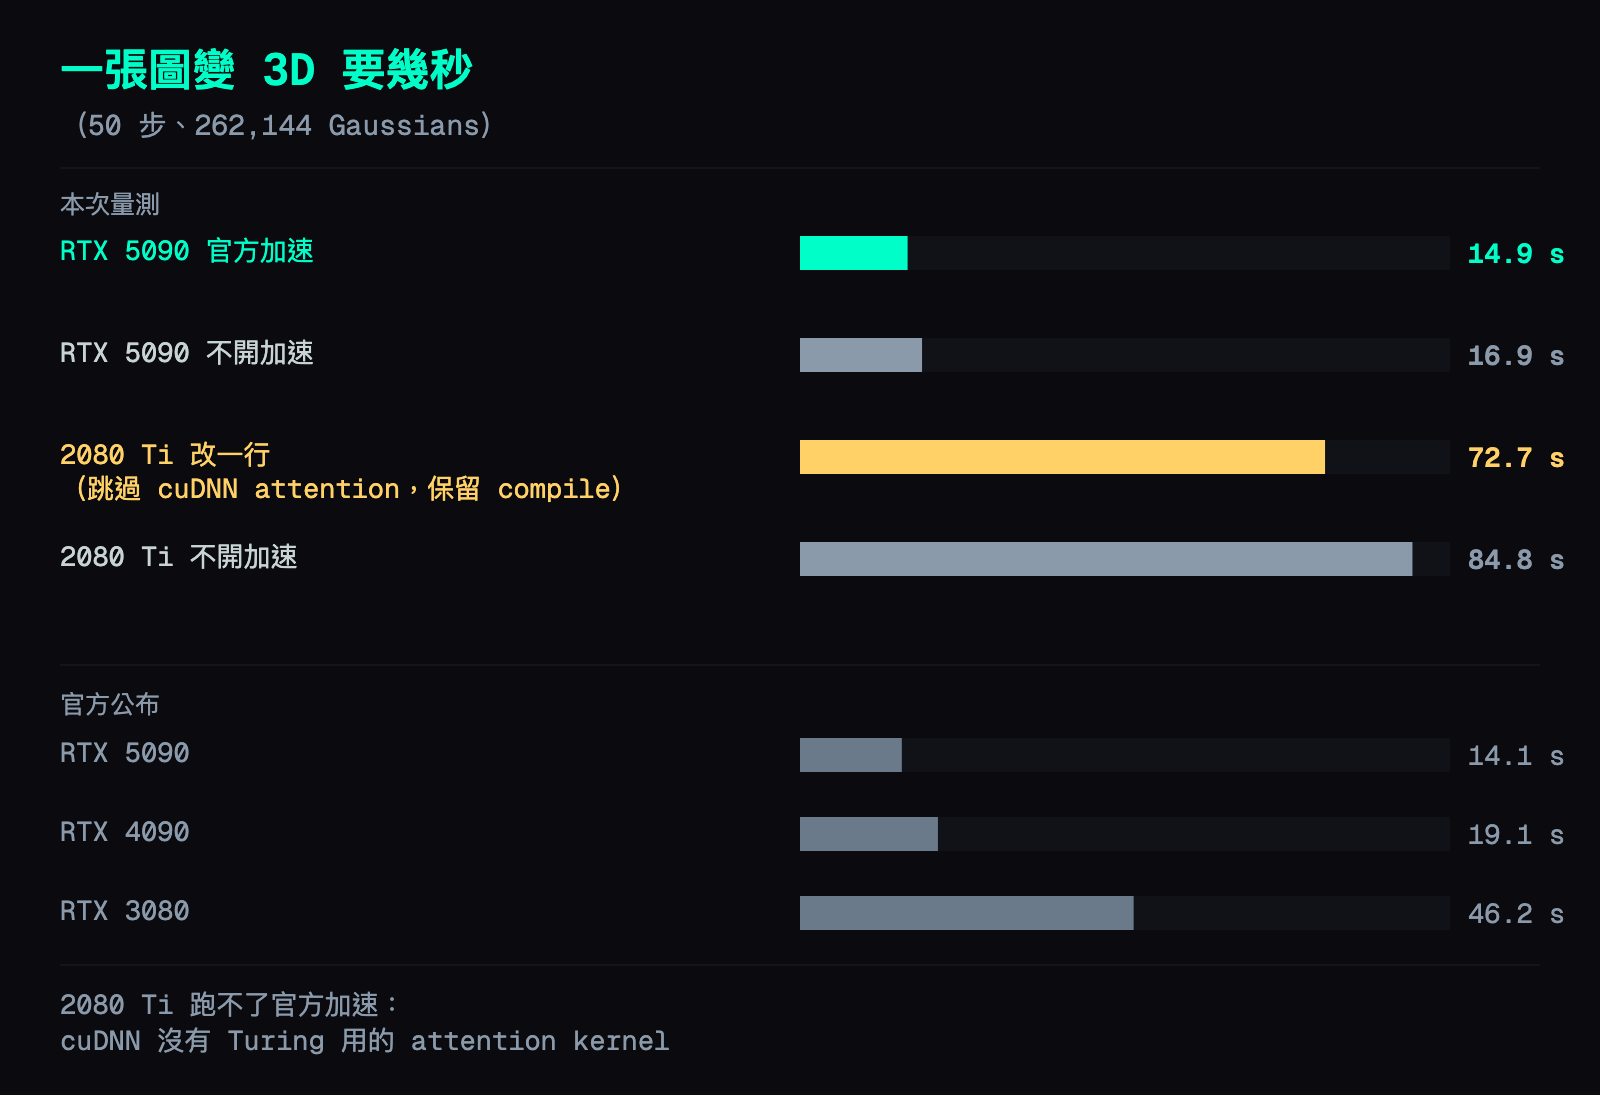
同樣 50 步、262,144 顆。看前兩列就是這篇改一行的效果,後三列是對照:
| 每張秒數(中位數) | 秒 | 張數 |
|---|---|---|
改裝 2080 Ti 22G,--no_optimize | 84.8 | 44 |
| 改裝 2080 Ti 22G,改一行 | 72.7 | 10 |
| RTX 5090,官方加速 | 14.9 | 8 |
RTX 5090,--no_optimize | 16.9 | 3 |
| 官方公布的 RTX 5090 | 14.1 | 8 |
5090 那台是 Windows 上的 WSL2,VAE 一樣換成 klein,比官方慢 5.5%。兩邊都關掉加速、跑同樣三張圖,5090 是 16.9 秒、2080 Ti 是 84.1 秒,差 4.99 倍。
拿官方表的 RTX 3080(46.2 秒)來比,2080 Ti 還是慢不少。
VRAM:PyTorch 量到 6894 MiB,整張卡多吃約 11 GB
改裝的 22 GB 卡跑這個很寬鬆。兩個數字量的東西不一樣:
- PyTorch 自己記的峰值 6894 MiB(約 7.2 GB),跟官方寫的 7.2 GB 一致。
- nvidia-smi 看整張卡,從載模型前到跑完的增量 10,644 MiB(約 11.2 GB),差的部分可能包含 CUDA context 和 PyTorch 預留的空間。
100 萬顆 Gaussian 的峰值一樣是 6894 MiB。DINOv3 改用 --dinov3_dtype fp32 峰值變成 8596 MiB,多約 1.8 GB,速度沒有明顯差別(各只跑一張)。
我測的時候這張卡上還掛著配音服務和 ComfyUI,開跑前已經佔掉 6604 MiB,Idol 照樣塞得下。原廠 11 GB 的 2080 Ti 我沒測,光看 10,644 MiB 這個增量,已經很接近原廠卡的總容量,會很緊。
成品:正面照著做,背面是模型猜的
每張對照圖左邊是模型看到的輸入(已去背),右邊是同一個 splat 的四個角度。古風美女和 2080 Ti 是我自己生的圖,蠑螈和草莓是官方範例。
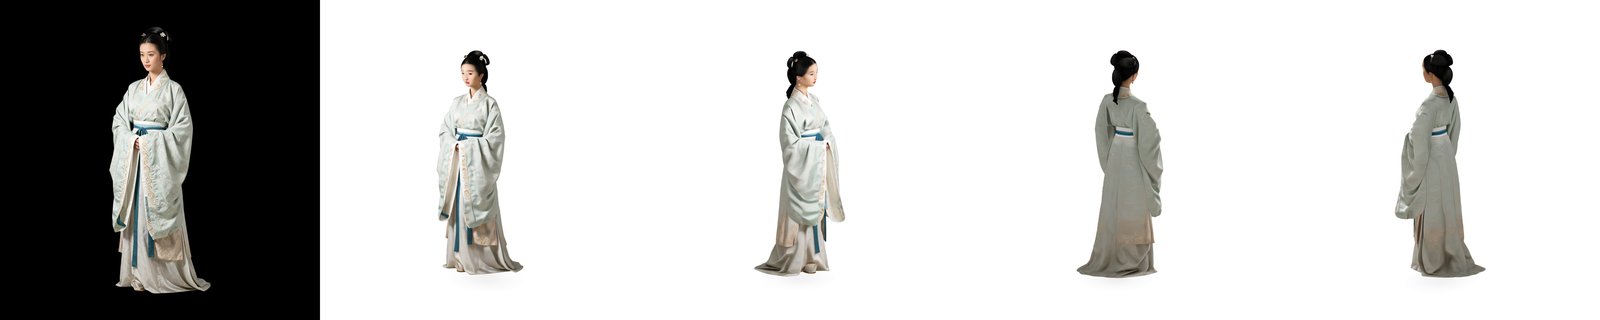
古風美女:背面的衣袍跟髮髻形體完整,沒有破洞,也沒看到飄在外圍的雜點。臉跟刺繡比原圖柔化很多,近看會覺得糊。
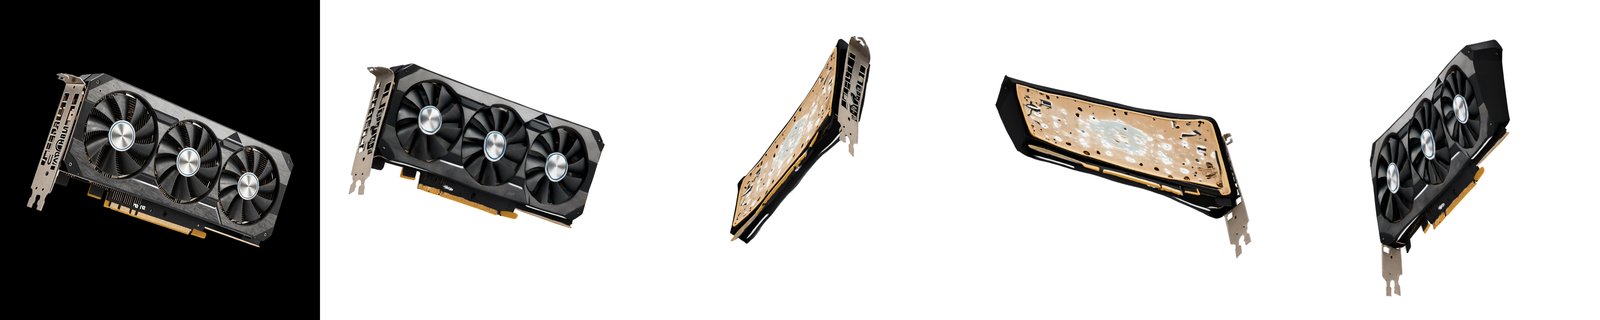
2080 Ti 這張最好笑。正面三風扇、擋板、金手指都清楚,轉到背面,變成一整塊帶白斑的金色顆粒板。它沒看過這張卡的背面,就自己編了一塊(背板:我不是長這樣)。
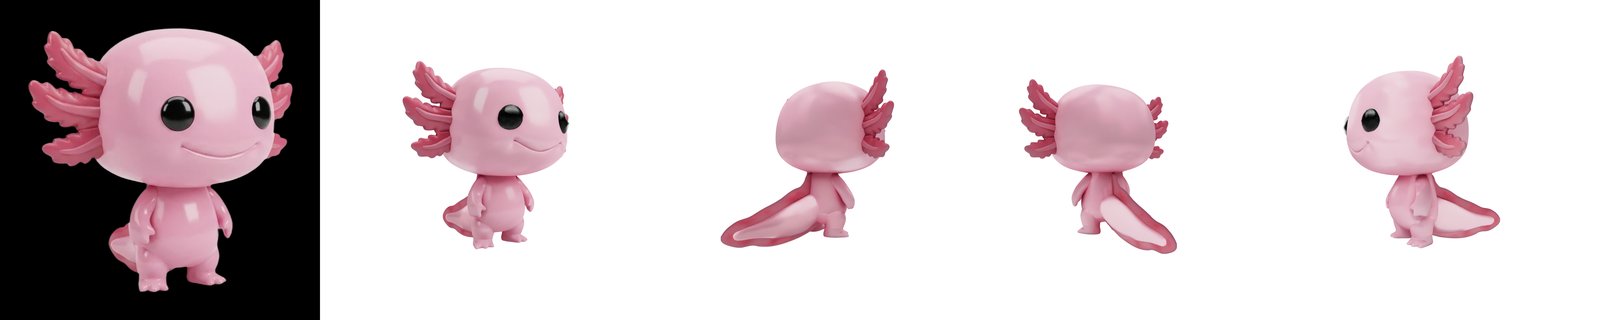
蠑螈玩偶:外鰓和黑眼睛都留住了,側面跟背面補出一條原圖沒拍清楚的長尾巴。
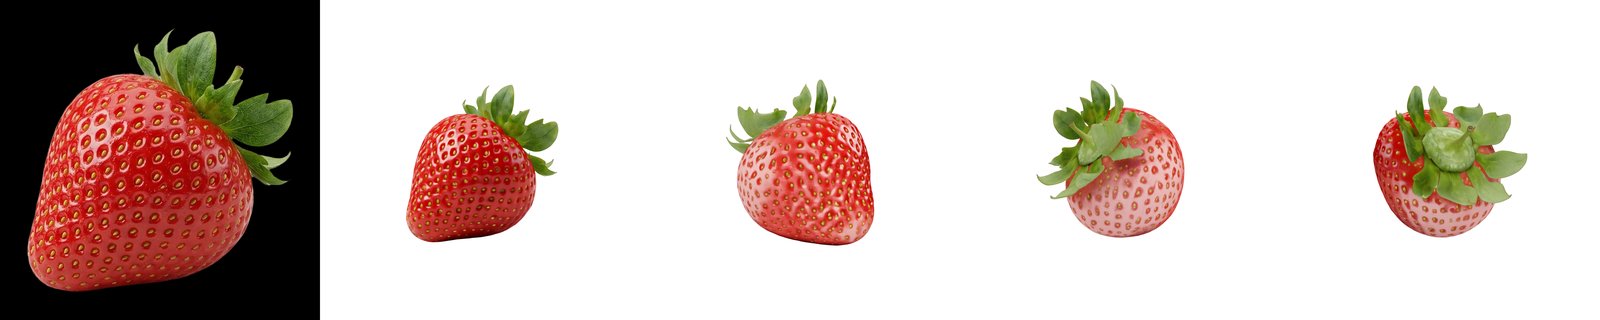
草莓:四面都認得出種子和葉冠,背面顏色偏淡,葉子的位置也是模型推的。
在 2080 Ti 上跑的官方範例裡,大部分跟上面差不多,也有幾張翻車:麵包變扁、足球員背後多出一片黑色長條、大理石標誌的底座後面掛著一大片黑色、城堡底座的草地缺一大塊白的。
參數:25 步快一倍,100 萬顆看不出更清楚
官方 README 列了幾個旗標,我量了兩個。這表看 25 步那一列:時間砍半,是最值得調的一個。
| 每張秒數 | 2080 Ti 改一行 | 2080 Ti --no_optimize | RTX 5090 |
|---|---|---|---|
| 預設(50 步、262,144 顆) | 72.7 | 84.8 | 14.9 |
--steps 25 | 38.2 | 44.0 | 7.6 |
--num_gaussians 1048576 | 沒量 | 87.6 | 15.5 |
25 步:形狀還在,古風美女的後袍一樣完整,只是袖子和下擺的形狀跟 50 步不太一樣;2080 Ti 那張背面的白斑更明顯。想先快速看效果,用 25 步篩圖,挑中的再跑 50 步。
100 萬顆:時間只多一點,但在四視角對照圖上,跟 262,144 顆看不出差別,臉和刺繡一樣糊。我猜細節卡在模型本身,不是點不夠,但沒排除渲染解析度的影響。
--seed:同一張圖、同一個 seed,在同一台機器上兩次輸出的 .ply 每個位元都一樣(我測的是這次的版本和設定)。想抽不同結果就換 seed。
進階:官方加速拆開量、kernel 確認和量測條件
不讀這節不影響使用。這裡是給要重現的人和 AI 看的細節。
官方加速是三招合在一起
--no_optimize 關掉的是同一個開關底下的三件事:
- torch.compile:SDK 的
compile_for_sampling。這條路同時會把位置編碼(RePo)切成real_valued=True,所以量到的是整個compile_for_sampling的效果,不能全算成編譯器的功勞。 - 併 batch:classifier-free guidance 每步要跑有條件、無條件兩次,這招把兩次併成一個 batch 一起算(
sampler.py裡的torch.cat([sample, sample]))。 - cuDNN attention + TF32:就是在 2080 Ti 上報錯的那條。TF32 在 Turing 沒有硬體支援,開了也沒作用。
官方寫取樣大約快 1.7 倍,指的是取樣那段,不是整張圖跑完的時間。
sm_75 實際用的是 mem-efficient SDPA
改完那一行之後,attention 交給 PyTorch 的 scaled_dot_product_attention 自己選。四個後端的開關都是開的,但開關只代表「允許」,實際用哪個要看 profiler。我只 profile 取樣那段(不含編碼器和解碼器),compile 跟不 compile 各一次:
compiled:
  aten::_scaled_dot_product_efficient_attention   56
  fmha_cutlassF_f16_aligned_64x64_rf_sm75(PyTorchMemEffAttention::AttentionKernel<cutlass::half_t, cutlass::arch::Sm75, true, 64, 64, 64, true, true>::Params)   56
eager:
  aten::_scaled_dot_product_efficient_attention   56
  fmha_cutlassF_f16_aligned_64x64_rf_sm75(...)   56
兩種都是 CUTLASS 的 sm75 FP16 kernel,也就是 mem-efficient attention,不是最慢的 math 路徑,也不是 Flash 或 cuDNN。我沒裝 flash-attn,所以 SDK 用的是 PyTorch 內建的 SDPA。
拆開量:省下的時間主要來自 compile
為了知道 72.7 秒是哪一招省的,我把 compile 和併 batch 分開開:
| 組別 | compile | 併 batch | 張數 | 中位數 秒 | 範圍 |
|---|---|---|---|---|---|
--no_optimize(前一輪) | 關 | 關 | 44 | 84.807 | 84.471–85.135 |
| 改一行(compile + 併 batch) | 開 | 開 | 10 | 72.664 | 72.152–72.700 |
| 只開 compile | 開 | 關 | 3 | 72.494 | 72.494–72.524 |
| 只開併 batch | 關 | 開 | 3 | 84.483 | 84.133–84.563 |
| 改一行,25 步 | 開 | 開 | 3 | 38.154 | 38.072–38.191 |
三組共用三張輸入(兩張官方範例加 2080 Ti 那張)時,中位數分別是 72.490、72.494、84.483 秒。compile-only 跟完整版只差 0.01%,併 batch 單獨開省 0.38%,在雜訊範圍內。
要保守看的地方:--no_optimize 那組是前一輪量的,不是跟這輪交錯跑;只開 compile 和只開併 batch 各只有三張;卡上有其他服務在跑。
各組第一張(含編譯):完整版 84.757 秒、只開 compile 86.021 秒、25 步 40.066 秒。
5090 上官方加速省 12% 的時間
官方寫取樣約快 1.7 倍,我在 5090 上量整張圖跑完是 16.858 → 14.880 秒,耗時少 11.7%,等於快 1.13 倍。第一張含編譯是 25.755 秒。5090 那邊我沒有把三招拆開量,所以說不出差距來自哪一招。
5090 各組(官方加速那組排除第一張,其他三組的三張都算進中位數,含第一張):
| 組別 | 張數 | 中位數 秒 | 範圍 |
|---|---|---|---|
| 官方加速,排除第一張 | 8 | 14.880 | 14.721–14.932 |
--no_optimize | 3 | 16.858 | 16.843–17.927 |
| 100 萬顆 | 3 | 15.469 | 15.469–18.427 |
| 25 步 | 3 | 7.643 | 7.639–10.789 |
bf16 在 2080 Ti 是模擬的,但能跑
Turing 沒有 BF16 硬體(#27 生圖那段踩過同一件事)。torch.cuda.is_bf16_supported(including_emulation=False) 回 False,含模擬回 True。DINOv3 和 VAE 預設用 bf16,在 2080 Ti 上照樣跑完,只是那代表能跑,不代表有加速。
DINOv3 換 fp32 各跑一張:bf16 83.913 秒、fp32 83.674 秒,峰值 6894 → 8596 MiB。每種只有一張,分不出誰快。四視角並排看也沒有變清楚。
同 seed 同機位元一致,跨機就不同
用 .ply 整份檔案的 SHA256 比:
- 2080 Ti,同一張古風美女、seed 42、獨立 process 重跑兩次:一致(
3287ee96...)。 - 5090,同設定重跑兩次:一致(
9c402fd5...)。 - 2080 Ti 對 5090:不一致。
- 2080 Ti 打 patch 前後:不一致。同 index 的位置平均差 0.0154(古風美女)、0.0298(顯卡),四視角並排看不出差別。
- DINOv3 bf16 對 fp32:同 index 位置平均差 0.0337。
位置差是按 index 直接相減、沒做點雲對齊,點的順序可能會變,只能當參考,不能當幾何誤差。不同 GPU、不同加速路徑的浮點結果本來就不保證位元一樣,雜湊不同不代表品質不同。
兩種 VRAM 數字
| 2080 Ti | 5090 | |
|---|---|---|
PyTorch max_memory_allocated 峰值 | 6894 MiB | 5104 MiB |
| nvidia-smi 整卡增量峰值 | 10,644 MiB | 7,837 MiB |
PyTorch 的數字是每張圖開始前 reset_peak_memory_stats,記這張圖的最大配置量。nvidia-smi 的是整張卡的用量減掉這個 process 載模型前的基準,含模型、CUDA context 和 allocator 預留。兩個定義不同,不能相減當模型大小。nvidia-smi 2080 Ti 每 0.5 秒取樣、5090 每 0.1 秒,太短的尖峰可能漏掉。兩張卡的 PyTorch 峰值為什麼差約 1,791 MiB,我沒查。
共卡測試的限制
2080 Ti 那張卡同時掛著配音服務和 ComfyUI,這次沒有把它們停掉。第一輪開跑前卡上已佔 6604 MiB,跑 patch 那輪開跑前佔 9036 MiB,中間 ComfyUI 的快取也會變。所以 2080 Ti 的秒數是「有鄰居」的數字,乾淨的卡可能會快一點,我沒量。nvidia-smi 增量是用各自的基準扣的,鄰居佔多少不會算進去,但鄰居瞬間的變動會。
5090 那台桌面程式佔約 1781 MiB,GPU 使用率 0%,沒有其他運算負載。
量測條件
- 計時:
torch.cuda.synchronize()包住整個 pipeline 呼叫,含去背、裁切、兩個編碼器、取樣、解碼;不含載模型、寫.ply和渲染。 - 固定 seed 42、
cfg_strength3.0、rescale_t3.0、DINOv3 bf16,除了特別標的組都是 50 步、262,144 顆。 - 「warm」是排除每個 process 的第一張。官方 94 張範例在時間內跑了 49 張,另加我自己的兩張;
--no_optimize的 44 張是官方範例那一批排掉每個 process 第一張之後的數字。 - 官方的 8 張中位數用的是哪 8 張圖沒公布,我 5090 那 8 張是從官方範例的公仔、食物、家具裡挑的,不保證同一批。
- 2080 Ti:驅動 580.173.02、Python 3.11.15、torch 2.11.0+cu128、diffusers 0.42.1、transformers 5.22.1、gsplat 1.5.3。
- RTX 5090:WSL2(Ubuntu 26.04)、Windows 驅動 610.88、Python 3.12.16、torch 2.11.0+cu128,diffusers 和 transformers 版本同上。
- idol-sdk commit
4702a7f00850e34b6e83a2170cc123c3e9570744,Idol 權重 revision2731c2291fc65a797c5cb627a5e5526fc1490902,FLUX.2-klein-4B revisione7b7dc27f91deacad38e78976d1f2b499d76a294。
環繞影片怎麼算出來的
SDK 不輸出環繞影片,環繞影片和四視角圖是我另外寫腳本用 gsplat 1.5.3 渲染的:讀 .ply 的位置、旋轉、縮放、不透明度和顏色,相機用 _camera.json 預測的角度和距離,繞一圈 144 格、24 fps、720×720,白底。
兩個坑。第一次用 gsplat 會現場編 CUDA extension(2080 Ti 上 154.77 秒),要找得到 ninja,不然報:
RuntimeError: Ninja is required to load C++ extensions (pip install ninja to get it)
ninja 有裝在 venv 裡也要把 .venv/bin 放進 PATH。第二個是 rasterization(..., packed=True) 配白底參數會報下面這個錯,改 packed=False 就好:
    assert backgrounds.shape == image_dims + (channels,), backgrounds.shape
AssertionError: torch.Size([1, 3])
常見問題
- Idol 是什麼?
- speridlabs 開源的單張圖轉 3D 模型,Apache-2.0。給它一張圖,它會去背、裁切,生出最多 1,048,576 顆 Gaussian,連照片沒拍到的面也補出來,輸出標準 3DGS 的 .ply 檔。官方寫 VRAM 峰值 7.2 GB,總參數約 1.80B。
- 改裝 2080 Ti 22G 跑得動 Idol 嗎?一張要多久?
- 跑得動。50 步、262,144 顆的預設設定,加 --no_optimize 每張 84.8 秒(44 張的中位數);在 pipeline.py 改一行讓 Turing 不走 cuDNN attention,保留官方的 torch.compile,變 72.7 秒(10 張的中位數)。同設定 RTX 5090 是 14.9 秒,官方寫 14.1 秒。
- 2080 Ti 跑 Idol 報 No available kernel. Aborting execution. 怎麼辦?
- 那是官方加速在取樣時把 attention 指定成 cuDNN,而 cuDNN attention 只支援 sm80 到 sm121,2080 Ti 是 sm75。最省事是加 --no_optimize;想快一點就改 idol/pipeline.py 那一行,只在 compute capability 8.0 以上才切 sdpa_cudnn,Turing 會自己走 PyTorch 的 mem-efficient attention。
- 沒有 FLUX.2-dev 的權限,Idol 還能跑嗎?
- 可以。Idol 只用到 FLUX.2 的 VAE,把權重資料夾 config.json 裡 image_encoders.flux2_vae 從 black-forest-labs/FLUX.2-dev 改成公開的 black-forest-labs/FLUX.2-klein-4B 就好。klein 用的是同一個 class,設定也符合 SDK 要的結構,dev 版檔案是 FP32,klein 是 bf16,SDK 載入時本來就轉 bf16。我後來同意條款把 dev 版下載下來比對,轉成 bf16 之後 251 個張量跟 klein 逐位元相同,所以換 klein 跑出來的結果跟官方完全一樣。
- Idol 要多少 VRAM?
- 2080 Ti 上 PyTorch 量到的峰值是 6894 MiB(約 7.2 GB),跟官方寫的 7.2 GB 一致;用 nvidia-smi 看整張卡的增量是 10,644 MiB(約 11.2 GB),差的部分可能包含 CUDA context 和 PyTorch 預留的空間。DINOv3 改用 fp32 峰值多約 1.8 GB。改裝的 22 GB 卡很寬鬆。
- 步數和 Gaussian 數量值得調嗎?
- 25 步差不多快一倍,2080 Ti 從 84.8 秒變 44.0 秒,形狀還在,只是袖子下擺這類細節跟 50 步不太一樣。100 萬顆 Gaussian 在 2080 Ti 是 87.6 秒,只慢一點,但在四視角對照圖上看不出比 262,144 顆清楚。
接著讀
- 2026-10-28[Benchmark] 三張改裝 2080 Ti 解鎖 FP16 tensor core:矩陣乘從 50.6 到 69.9 TFLOPS,只有走 FP16 的工作會變快
turing-unlock 是一個 Linux kernel 模組,開機時解開 GeForce Turing 的 FP16 輸入、FP32 累加半速限制。家裡三張改裝 2080 Ti 22G 裝上後,8192³ 矩陣乘 50.6 → 69.9 TFLOPS;影片生成每步約快兩成,LLM 走 int8 沒差,生圖要先改 FP16 才吃得到。
- 2026-09-14[Benchmark] 2080 Ti 也吃得下 Sol-H3 兩段式:1344×768 有聲影片 165 秒
把 DGX Spark 上的 MiniMax-H3 + LTX-2.5 兩段式產線搬到一張 2018 年的改裝 2080 Ti 22G。五個非改不可的地方,其中兩個失敗時完全無聲、一個會把錯誤印在日誌裡然後自己降級。附完整 workflow 與解析度對照。
- 2026-08-20[趣味競賽 進階 #12] 為什麼你的 4-bit 模型在 2080 Ti 上快不起來?——拆開 .so 才發現這代卡只有兩種齒輪
為什麼 GGUF 量化後檔案變小,tok/s 卻沒變快?拆開 CUDA 後端 .so 才看懂:Turing(sm_75)的整數 tensor core 只有 s4×s4 跟 s8×s8 兩種同寬組合,4-bit 權重配 fp16 activation 這格在任何架構都不存在。GGUF、AWQ、Marlin 全靠反量化撐過去。
- 2026-08-06[趣味競賽 進階 #11] 什麼?2080 Ti 居然跑得動 MiniMax-H3,還生得出 1080p 有聲影片
四個檔案在磁碟上 38 GiB,而卡只有 22 GiB。一張 2018 年的改裝 2080 Ti 22G(sm_75)照樣跑出 15 秒 1080p 有聲片。完整配置、實測速度與畫質,最後才是一路怎麼試出來的。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。