改裝 2080 Ti 22G · part 30
[Benchmark] llama.cpp 升級要自己帶上 chunked prefill 補丁:2080 Ti 混跑短題 5.4 秒
❯ cat --toc
TL;DR
家裡那張改裝 2080 Ti 22G 跑 MiniCPM-V 4.7,llama.cpp 從 b11588 升到 b12595,單看吐字每條快 3–10%。但新版沒有我自己加的 chunked prefill 補丁,有人丟長文件的同時,別人的短問題要等 16.8 秒(舊版 7.3 秒)。把 35 行補丁移植到新版重編,短題回到 5.4 秒,每條吐字比舊版快 5–12%,已經上線。
前言
家裡的聊天服務和新聞產線都打同一張 2080 Ti,上面跑的是 MiniCPM-V 4.7 35B-A3B(#25)。那時候用的 llama.cpp 是 b11588(llama.cpp 用 b 加數字當版本號,數字越大越新),我另外手動移植了 chunked prefill:把很長的 prompt 切成小段讀,每讀一段就讓別人的短問題插進來,長 prompt 才不會卡住別人。
一個多月後 llama.cpp 已經到 b12595。我想知道兩件事:換上去能快多少,以及那個補丁還要不要。
新版本身確實比較快,但我的補丁沒跟過去,而且啟動時一聲不吭。下面是量出來的數字、怎麼發現的,還有把補丁帶過去的做法。
新版每條快 3–10%,但混跑短題從 7.3 秒變 16.8 秒
先講幾個詞。token 是模型計算的單位,一個中文字大約一個 token;tok/s 就是每秒吐幾個 token。模型回答一個問題分兩段:prefill 是先把你丟進去的文字整段讀完,decode 是開始一個字一個字吐答案。TTFT 是從送出到看到第一個字的時間。
llama-server 可以同時服務好幾條請求(這裡開 4 路)。只看吐字速度,新版每一格都比較快:
| 舊版 b11588 + 補丁 | 新版 b12595 | 變化 | |
|---|---|---|---|
| 中文 1 路(tok/s) | 102.89 | 105.65 | +2.7% |
| 中文 4 路,每條(tok/s) | 48.12 | 52.25 | +8.6% |
| 程式 1 路(tok/s) | 102.21 | 105.71 | +3.4% |
| 程式 4 路,每條(tok/s) | 47.97 | 52.69 | +9.8% |
| 8K prompt 讀取(tok/s) | 2080 | 2359 | +13% |
140 題能力測試新版 129/140,跟舊版一樣;收據 OCR 全對。到這裡看起來直接換就好。
接著跑家裡真的會發生的情況:有人貼一份很長的文件,同一時間另一個人問一句短的。做法是先送一條 3 萬 token 的長題,0.15 秒後再送三條短題:
| 舊版 b11588 + 補丁 | 新版 b12595 | |
|---|---|---|
| 短題等第一個字(秒) | 1.10, 1.10, 1.10 | 2.02, 15.50, 2.02 |
| 短題整題完成(秒) | 7.29–7.30 | 16.75–16.99 |
| 長題完成(秒) | 22.55 | 17.99 |
長題自己快了 4.5 秒,三條短題全部多等快 10 秒,其中一條 15.5 秒才看到第一個字。
原因:補丁沒跟著升級,新版也不報錯
新版那一組的啟動命令裡,LLAMA_PREFILL_CHUNK=64 照樣設著。這個環境變數是我自己補丁裡讀的,上游的 llama.cpp 根本不認它,所以不會報錯,也不會有任何警告,就是靜靜地沒作用。
llama-server 是一輪一輪在算的:每一輪把一批 token 交給 GPU,這一批叫 batch,這裡最多 2048 個。上游現在的做法,是讓長題自己把整批塞滿,3 萬 token 要十幾輪才讀完,這段時間每一輪都沒有空位給短題,短題只能排隊。
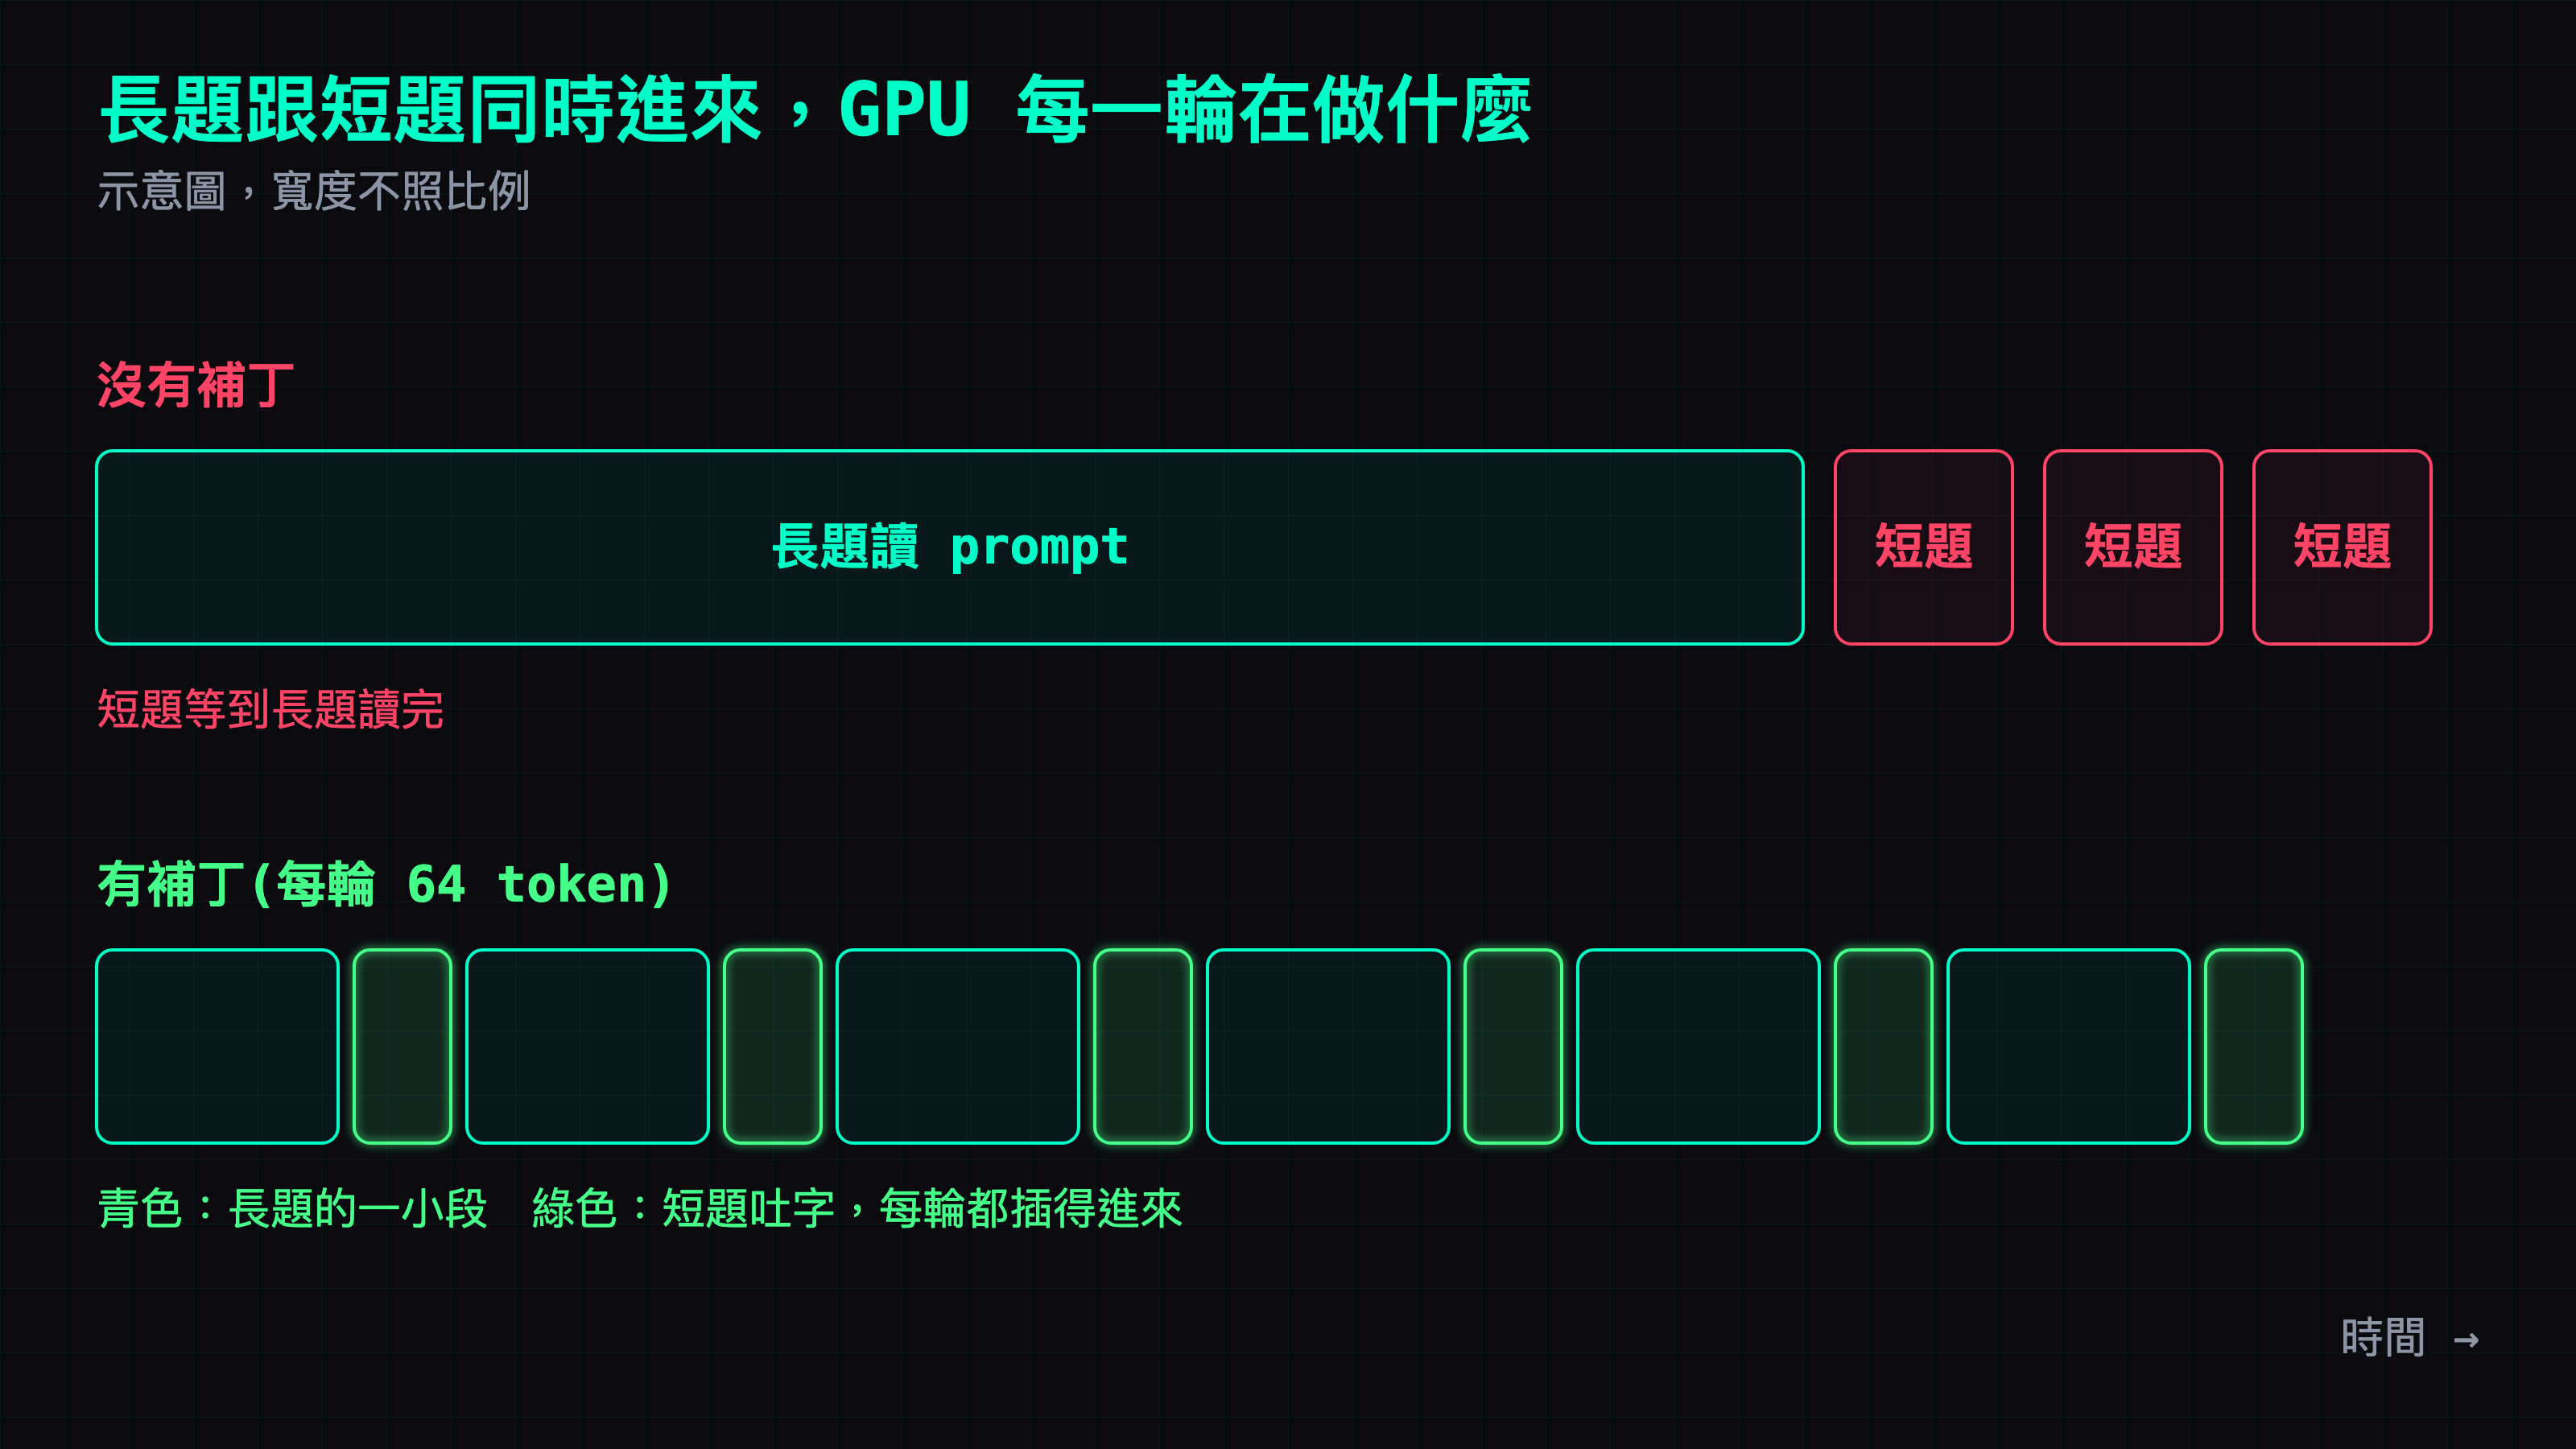
llama.cpp 的作者自己開過一個 chunked prefill 的 PR #10718(PR 是送去給專案合併的修改,還沒合併就不會出現在正式版),2024 年 12 月開的,到 2026-11 還是 OPEN。所以換新版,就要自己把補丁帶過去。
補丁帶過去:改一個檔、35 行
補丁只動 tools/server/server-context.cpp 兩個地方:
- 有別的請求正在吐字時,這一輪最多只收
LLAMA_PREFILL_CHUNK個新的 prompt token。 - 同時有好幾條請求在讀 prompt,就把這一輪的名額平分給它們,每條的上限是平分後的數字,最低 8 個。
diff --git a/tools/server/server-context.cpp b/tools/server/server-context.cpp
--- a/tools/server/server-context.cpp
+++ b/tools/server/server-context.cpp
@@ -3941,6 +3941,19 @@ private:
         int32_t n_batch  = llama_n_batch(ctx_tgt);
         int32_t n_ubatch = llama_n_ubatch(ctx_tgt);

+        // [local port of ggml-org/llama.cpp#10718] chunked prefill: while some slots are generating,
+        // cap the prompt tokens admitted per iteration so long prefills do not stall them.
+        // LLAMA_PREFILL_CHUNK=<tokens> enables it (0/unset = upstream behaviour).
+        static const int32_t prefill_chunk = [] { const char * e = getenv("LLAMA_PREFILL_CHUNK"); return e ? atoi(e) : 0; }();
+        if (prefill_chunk > 0 && batch.size() > 0) {
+            n_batch = std::min<int32_t>(n_batch, (int32_t) batch.size() + prefill_chunk);
+        }
+        int32_t n_slots_pp = 0;
+        for (auto & s_ : slots) {
+            if (s_.state == SLOT_STATE_PROCESSING_PROMPT || s_.state == SLOT_STATE_STARTED) { n_slots_pp++; }
+        }
+        const int32_t n_chunk_pp = (prefill_chunk > 0 && n_slots_pp > 1) ? std::max<int32_t>(n_batch / n_slots_pp, 8) : INT32_MAX;
+
         auto & alora_scale       = batch.alora_scale;
         auto & alora_disabled_id = batch.alora_disabled_id;

@@ -4406,7 +4419,9 @@ private:
                     const int32_t n_decision_first = slot.task->type == SERVER_TASK_TYPE_DECISION ? slot.task->decision.pos_first() : -1;

                     // add prompt tokens for processing in the current batch
-                    while (slot.prompt.n_tokens() < slot.task->n_tokens() && batch.size() < n_batch) {
+                    int32_t n_cur_pp = 0;
+                    while (slot.prompt.n_tokens() < slot.task->n_tokens() && batch.size() < n_batch && n_cur_pp < n_chunk_pp) {
+                        n_cur_pp++;
                         // get next token to process
                         llama_token cur_tok = input_tokens[slot.prompt.n_tokens()];
                         if (cur_tok == LLAMA_TOKEN_NULL) {
存成 chunkpp.patch,在 llama.cpp 原始碼目錄套上去再編。我用的是 commit e46069c40(build 12595),版本差太多的話行號會跑掉,git apply 失敗就照上面兩段手動貼:
git checkout e46069c40
git apply chunkpp.patch
cmake -S . -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=75 -DCMAKE_BUILD_TYPE=Release
cmake --build build --target llama-server -j 12
75 是 2080 Ti 的架構代號,別張卡換成自己的。啟動時把環境變數帶上,不帶或設 0 就是上游原本的行為:
LLAMA_PREFILL_CHUNK=64 ./build/bin/llama-server -m <模型.gguf> -np 4 -c 131072 -b 2048 -ub 512 -fa on -ngl 99
64 是 #25 那時掃出來的值:512、256、64、32 裡,64 和 32 差不到一秒,長題只慢 3%。
移植後:短題 5.4 秒,每條比舊版快 5–12%
同一張卡、同一份模型、同一套測法,三版並排:
| 舊版 b11588 + 補丁 | 新版 b12595 | 新版 + 補丁 | |
|---|---|---|---|
| 中文 1 路(tok/s) | 102.89 | 105.65 | 108.48 |
| 中文 4 路,每條(tok/s) | 48.12 | 52.25 | 53.77 |
| 程式 1 路(tok/s) | 102.21 | 105.71 | 107.20 |
| 程式 4 路,每條(tok/s) | 47.97 | 52.69 | 53.18 |
| 8K prompt 讀取(tok/s) | 2080 | 2359 | 2390 |
| 混跑短題完成(秒) | 7.29–7.30 | 16.75–16.99 | 5.21–5.41 |
| 混跑短題等第一個字(秒) | 1.10 | 2.02–15.50 | 0.70–0.88 |
| 混跑長題完成(秒) | 22.55 | 17.99 | 19.53–19.77 |
跟舊版比,中文 4 路每條快 11.7%,程式 4 路快 10.9%,單路快 5% 左右。混跑的短題比舊版還快 2 秒。長題比沒補丁的新版慢 1.5–1.8 秒,換來三條短題各省 11 秒。
能力只抽測 40 題,答對 39(沒補丁的新版同 40 題也是 39),收據 OCR 全對。11 月 21 日起家裡那台就是跑這個版本。
升級前先跑這支:一條長題加三條短題
不管你有沒有用我的補丁,升級 llama.cpp 之前和之後各跑一次這支,就看得出有沒有長題卡短題。只用 Python 標準庫:
#!/usr/bin/env python3
"""Send one long prompt, then three short ones 0.15 s later, to a llama-server.
Prints how long each short request waits for its first token and to finish.
Usage: python3 mixed_latency.py http://127.0.0.1:8080 [long_words]
"""
import json, sys, time, uuid, urllib.request
from concurrent.futures import ThreadPoolExecutor

BASE = sys.argv[1].rstrip("/") if len(sys.argv) > 1 else "http://127.0.0.1:8080"
LONG_WORDS = int(sys.argv[2]) if len(sys.argv) > 2 else 20000  # roughly 1 token per word

def ask(text, max_tokens):
    body = {
        "messages": [{"role": "user", "content": f"[{uuid.uuid4().hex}] {text}"}],
        "max_tokens": max_tokens, "temperature": 0.7, "stream": True,
        "cache_prompt": False,
        "chat_template_kwargs": {"enable_thinking": False},
    }
    req = urllib.request.Request(BASE + "/v1/chat/completions",
                                 data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    t0, ttft = time.time(), None
    with urllib.request.urlopen(req, timeout=600) as r:
        for line in r:
            if not line.startswith(b"data: ") or line.strip() == b"data: [DONE]":
                continue
            choices = json.loads(line[6:]).get("choices") or [{}]
            if ttft is None and choices[0].get("delta", {}).get("content"):
                ttft = time.time() - t0
    return ttft, time.time() - t0

long_text = ("The quick brown fox jumps over the lazy dog. " * (LONG_WORDS // 9)
             + "\nSummarize the text above in one sentence.")
with ThreadPoolExecutor(4) as pool:
    long_job = pool.submit(ask, long_text, 128)
    time.sleep(0.15)
    shorts = [pool.submit(ask, "List three ways to save water.", 64) for _ in range(3)]
    for i, s in enumerate(shorts):
        ttft, total = s.result()
        print(f"short {i}: first token {ttft:.2f} s, done {total:.2f} s")
    print(f"long:    done {long_job.result()[1]:.2f} s")
-np 至少要開 4,不然短題本來就排不進去。我在家裡上線那台跑預設的 2 萬字長題:
short 0: first token 1.48 s, done 5.75 s
short 1: first token 1.48 s, done 5.75 s
short 2: first token 1.48 s, done 5.75 s
long:    done 13.25 s
短題等第一個字超過 10 秒,或整題完成時間跟長題差不多,就是被卡住了。chat_template_kwargs 是關掉 MiniCPM 和 Qwen 系的思考,別的模型不認的話刪掉那行就好。
進階
不讀這節不影響照做。這裡是測量條件、長題變慢的原因、草稿模型重測,還有幾件沒做完的事。
測量條件
- 機器:EPYC + 三張改裝 RTX 2080 Ti 22G,只用一張。另外兩張卡上的服務照常跑,測試前先把新聞產線改道,確認 60 秒內沒有別的請求才停服務。
- 舊版 b11588 就是 commit
7f51953。 - 模型:MiniCPM-V-4.7-35B-A3B 的 q3 混合量化加一個 LoRA 合併版(15.5G),掛著看圖的 mmproj。啟動參數跟上線一致:
-np 4 -c 131072 -ctk q8_0 -ctv q8_0 -b 2048 -ub 512 -fa on --kv-unified。 - 請求:
/v1/chat/completions,關思考,temperature 0.7 / top_p 0.95 / top_k 20,max_tokens 512(混跑短題 64、長題 128)。每條請求開頭加一個隨機字串,cache_prompt關掉,報告裡每條的cached_tokens都是 0,確定沒有吃到快取。 - 吐字速度 = (completion token 數 − 1) ÷ (最後一個字的時間 − 第一個字的時間)。單路 3 次、4 路 2 輪,表上是中位數。
- 新版 + 補丁那一組是同一天稍晚另外停機量的,對照的是早上那輪新版的數字,沒有再重跑舊版。
#25 寫的是吐字 111.5 tok/s,這篇舊版只有 102.89。那篇用 llama-bench 量單路,沒掛看圖的 mmproj;這篇照上線組態開 4 路、KV 用 q8_0、掛著看圖,走 API 量。
混跑的 7.3 秒也跟 #25 的 3.2–3.8 秒不同:#25 量的是 9 萬 token 長題下短題等第一個字,這篇量的是 3 萬 token 長題下短題吐完 64 個字的總時間。
長題為什麼變慢一點
補丁在別人吐字時,每輪只讓長題讀 64 個 token。長題讀完的時間被拉長,換到的是短題每輪都有機會吐字。沒補丁的新版長題 17.99 秒,加補丁 19.53–19.77 秒。舊版 22.55 秒,所以跟舊版比長題還是快的。
如果你的伺服器只有一個人在用,這個補丁沒有幫助,不設 LLAMA_PREFILL_CHUNK 就是原本的行為。全是長文件批次的情況,第二條規則會讓同時在讀的幾條平分名額,這種用法我沒量過。
官方的 DSpark 草稿,在新版還是不划算
MiniCPM-V 4.7 有官方的 speculative decoding 草稿模型(draft model),#25 量過是中文變慢。這次在新版重測(官方 Q8_0 草稿,424MB):
| 草稿 n-max | 中文 1 路 | 中文 2 路,每條 | 英文 1 路 | 程式 1 路 | VRAM 峰值 |
|---|---|---|---|---|---|
| 不掛 | 105.65 | 82.31 | 105.54 | 105.71 | 17.8 GiB |
| 2 | 100.61 | 63.20 | 121.62 | 120.32 | 20.7 GiB |
| 3 | 89.84 | 沒量 | 沒量 | 沒量 | 20.9 GiB |
| 預設 | 89.65 | 沒量 | 沒量 | 沒量 | 20.9 GiB |
n-max 2 時英文單路快 15%、程式快 14%,中文 2 路每條慢 23%,多吃 2.9 GiB VRAM。n-max 3 和預設值中文單路慢了 15%(比舊版也慢 13%),慢太多我就直接停了,後面沒量。家裡那台中文為主又是多路,不掛。新版的 --spec-draft-n-max 預設值變成 3(10 月是 7)。
新 binary 的完整性檢查沒跟上
這個服務啟動前有一支 verify.sh 會算 llama-server 的 SHA-256 比對。它寫死的是舊版的路徑,所以換了新 binary 不會被擋,但也等於新版沒有被檢查到。要繼續有這層保護,得替新版另外記一份 hash。
停機時間
新版試跑停了這個服務 17.75 分鐘,補丁版試跑停了 3.96 分鐘。正式切換是加一個 systemd drop-in 指到新 binary,退回只要刪掉那個 drop-in 再重啟。
還沒做的
- 補丁版的能力只跑了 140 題裡的前 40 題(都是 GSM8K),另外 100 題沒重跑。
- 混跑只測了一種情況(3 萬 token 長題 + 三條短題),每版 1–3 輪。
- 補丁只在 commit
e46069c40上編過,更新的 master 沒試。
同系列:#25 一張 2080 Ti 接手兩張卡的 27B:MiniCPM-V 4.7 35B 吐字 111.5 tok/s · #29 QEngine 在 5090 上跑 Qwen3.8 27B · #21 兩張 2080 Ti 的 concurrency 排程
常見問題
- llama.cpp 有內建 chunked prefill 嗎?
- 到 b12595(2026-11)還沒有。PR #10718 從 2024-12 開到現在仍是 OPEN。llama-server 會讓一條長 prompt 一口氣把 batch 塞滿,同時進來的短請求要等它讀完才輪得到。
- 升級 llama.cpp 後,自己加的補丁會怎樣?
- 會整個消失,而且不會報錯。我舊版補丁靠環境變數 LLAMA_PREFILL_CHUNK 開啟,新版不認這個變數,照樣設著也能正常啟動,只是混跑短題從 7.3 秒變成 16.8 秒。要用新版就得把補丁移植過去重編。
- 怎麼測自己的 llama-server 有沒有長題卡短題的問題?
- 先送一條幾萬 token 的長題,0.15 秒後再送三條短題,看短題等第一個字和整題完成各要幾秒。本文附一支只用 Python 標準庫的腳本,指到你的 llama-server 網址就能跑。
接著讀
- 2026-10-16[Benchmark] 一張 2080 Ti 接手兩張卡的 27B:MiniCPM-V 4.7 35B 吐字 111.5 tok/s,還會看圖
MiniCPM-V 4.7 35B-A3B 是會看圖的 MoE 模型,每個字只算 3B。一張改裝 2080 Ti 22G 跑官方混合 q3:吐字 111.5 tok/s、262k context 只用 20.8G,140 題 127,原本兩張卡的 27B 是 128。它現在是家裡的聊天主力,空出來的那張卡給了 Strata。
- 2026-11-17[Benchmark] RTX 5090 單卡用 QEngine 跑 Qwen3.8-27B:寫程式 359 tok/s,2080 Ti 編不出來
QEngine 是專為 Qwen3.8 寫的 CUDA 推論引擎,作者只在 Linux 加 3090 測過。我在 Windows 的 RTX 5090 用 WSL2 單卡跑 Qwen3.8-27B:寫程式 358.5、英文 225.1、中文 109.1 tok/s,同卡 llama.cpp 不開草稿 69、開草稿寫程式 155。附安裝步驟、VRAM 用量,還有 2080 Ti 為什麼編不過。
- 2026-10-28[Benchmark] 三張改裝 2080 Ti 解鎖 FP16 tensor core:矩陣乘從 50.6 到 69.9 TFLOPS,只有走 FP16 的工作會變快
turing-unlock 是一個 Linux kernel 模組,開機時解開 GeForce Turing 的 FP16 輸入、FP32 累加半速限制。家裡三張改裝 2080 Ti 22G 裝上後,8192³ 矩陣乘 50.6 → 69.9 TFLOPS;影片生成每步約快兩成,LLM 走 int8 沒差,生圖要先改 FP16 才吃得到。
- 2026-10-16[Benchmark] LFM2.5 24B-A2B 一張 2080 Ti 吐字 184.8 tok/s:全場最快,取樣參數一定要照官方
Liquid AI 的 LFM2.5 24B-A2B 大部分層是卷積、每個字只算約 2B。一張改裝 2080 Ti 22G 跑官方 QAD Q4_0:吐字 184.8 tok/s,兩張卡 Q8_0 的 140 題 128,跟原本兩張卡的 27B 一樣。代價是一定會先想、temperature 0 會一直想下去,agent 修 bug 只過 1/5。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。