改裝 2080 Ti 22G · part 29
[Benchmark] RTX 5090 單卡用 QEngine 跑 Qwen3.8-27B:寫程式 359 tok/s,2080 Ti 編不出來
❯ cat --toc
TL;DR
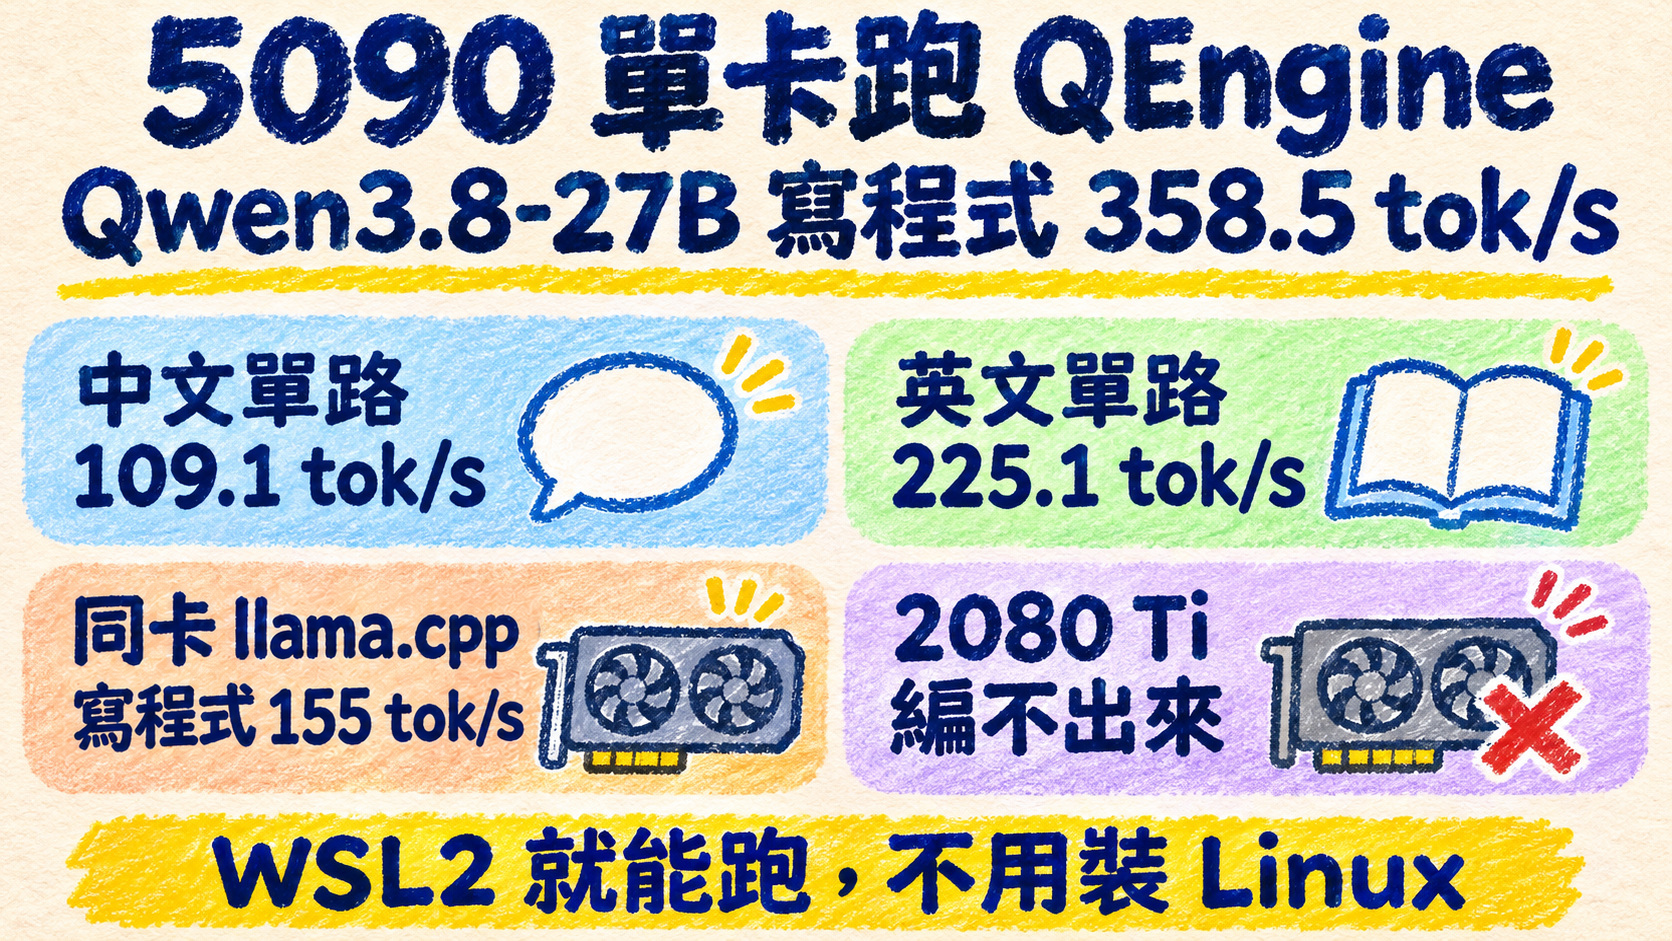
QEngine 是專為 Qwen3.8 寫的 CUDA 推論引擎,官方只支援 Linux。我在 Windows 的 RTX 5090 上用 WSL2 單卡跑 Qwen3.8-27B:寫程式 358.5 tok/s、英文 225.1、中文 109.1;同卡 llama.cpp 不開草稿是 69,開草稿寫程式 155。四個對話同時跑合計 592.8。速度差在草稿猜中幾個字:程式一步前進 4.22 個,中文 1.27 個。兩邊量化不同,不是同條件對照。2080 Ti 編不出來,缺 BF16 tensor core 指令。
前言
前陣子在 GitHub 看到一個叫 QEngine 的專案:一個人用 C++ 和 CUDA 寫的推論引擎,只跑 Qwen3.8 這一家模型。作者貼的數字很誇張,三張 RTX 3090 同時服務八個 agent,合計每秒吐超過一千個 token。
問題是那些數字都是三張 3090、Linux。README 寫得很白:只支援 Linux,Windows 和 WSL2 沒測過;27B 單卡是「實驗性質」。
我手上的東西剛好都在它沒測過的那一邊:一張裝在 Windows 上的 RTX 5090,還有這系列的主角,三張改裝 2080 Ti 22G。所以這篇回答兩件事:5090 單卡在 Windows 上跑不跑得起來、有多快;2080 Ti 能不能用。
答案先講。5090 用 WSL2 跑得起來,Qwen3.8-27B 寫程式每秒 358.5 個 token。2080 Ti 連編都編不過。
5090 單卡:寫程式 358.5、英文 225.1、中文 109.1 tok/s
模型是 Qwen3.8-27B,QEngine 用的是 RedHat 量化的 INT4 版。我出了三種題目各一題:中文故事、英文故事、用 Python 寫一個 LRU cache,每題固定輸出 512 個 token,關掉思考模式。每題先跑一次暖機不算,再跑三次取中間值。token 是模型一次吐出來的一小段字,tok/s 就是每秒吐幾段,數字越大越快。
對照組是同一張卡上的 llama.cpp,跑 Q4_K_M 量化,不開草稿加速和開 DFlash2 草稿各量一次。這張表看最右邊那一欄:
| 引擎 | 中文 | 英文 | 寫程式 |
|---|---|---|---|
| llama.cpp(Q4_K_M,無草稿) | 69.3 | 69.3 | 69.1 |
| llama.cpp(Q4_K_M,開 DFlash2 草稿) | 81.9 | 119.3 | 155.0 |
| QEngine 單一對話 | 109.1 | 225.1 | 358.5 |
| QEngine 四個對話合計 | 406.7 | 571.5 | 592.8 |
單位都是 tok/s。等第一個字出來的時間,QEngine 大約 50 毫秒,llama.cpp 大約 75 毫秒。
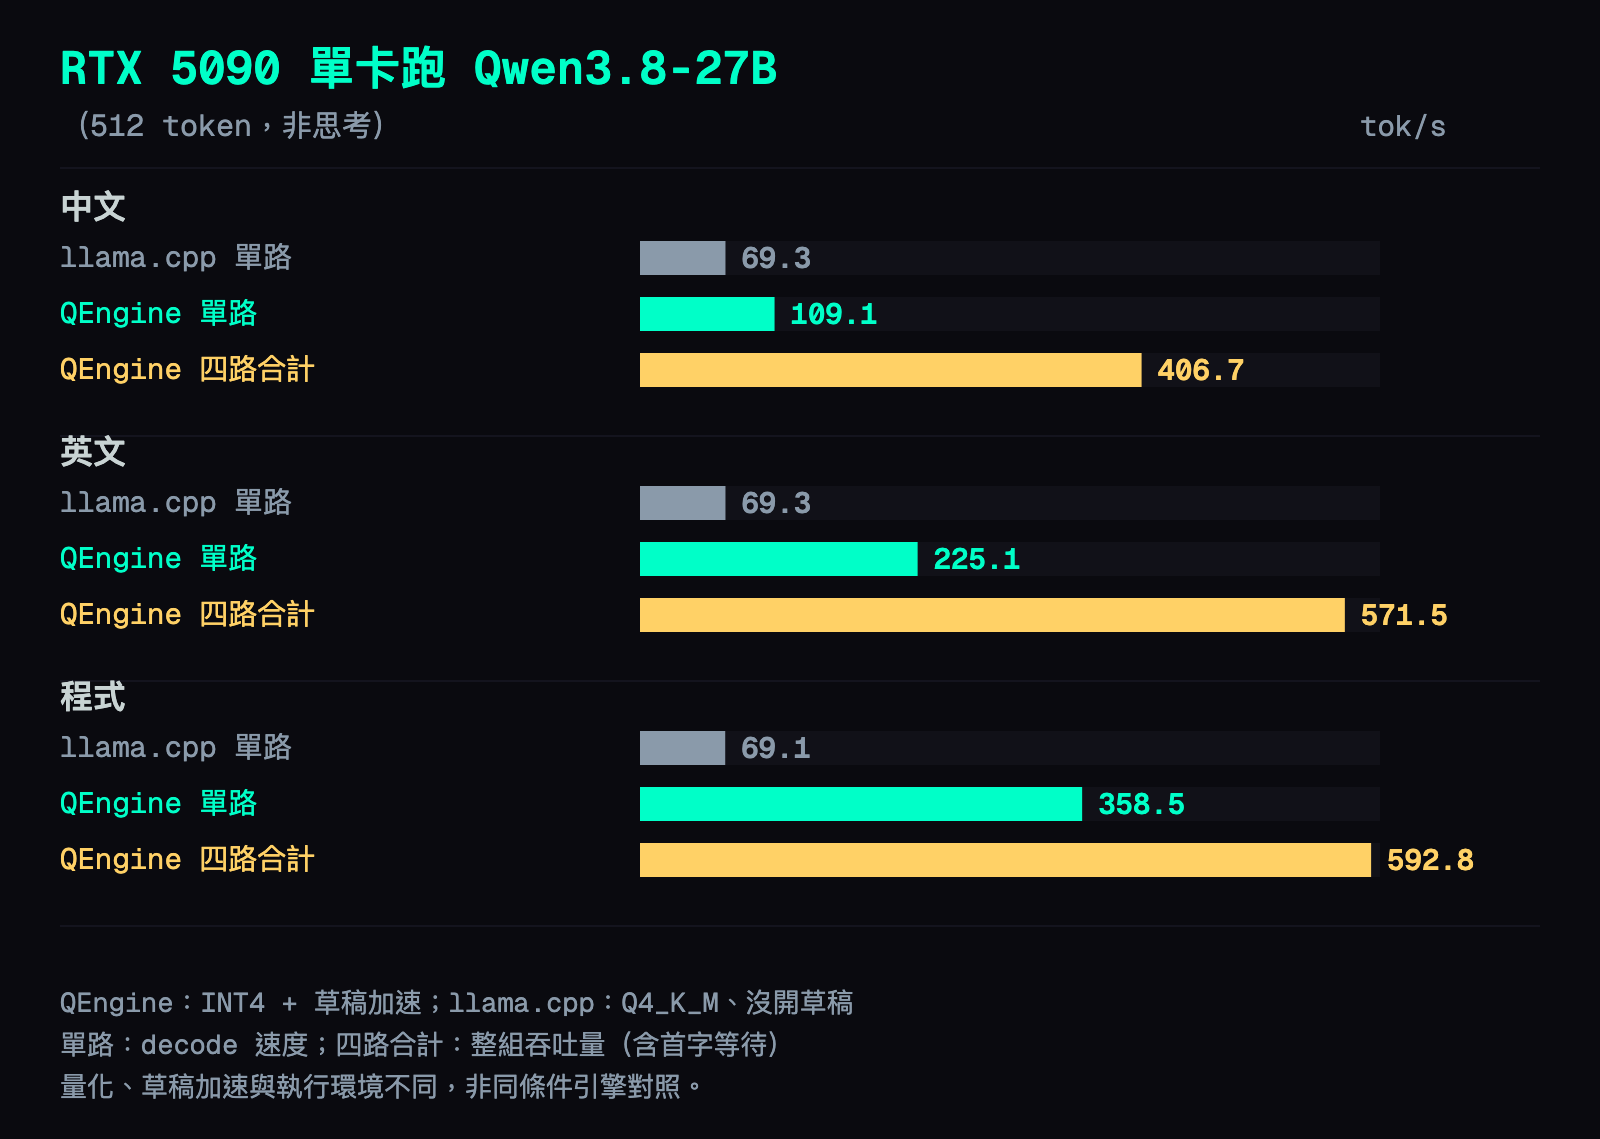
圖裡的 llama.cpp 是不開草稿的那一列。這不是公平的引擎對決,有三件事不一樣。第一,量化格式不同,一邊 INT4、一邊 Q4_K_M。第二,QEngine 在 WSL2 裡跑,llama.cpp 在 Windows 上直接跑。第三,草稿的設定不同:llama.cpp 預設一次猜 3 個,把它調成跟 QEngine 一樣的 7 個,寫程式是 168.5 tok/s。從這張表只能看出「同一張 5090,換這個引擎能跑多快」,看不出「引擎本身快多少」。
為什麼寫程式比中文快三倍?草稿一次猜中幾個字
llama.cpp 不開草稿那一列,三種題目都是 69。開了草稿的兩列就不一樣了,QEngine 從 109 一路拉到 359,llama.cpp 從 82 拉到 155。同一顆模型、同一張卡,為什麼題目一換速度差這麼多?
差在草稿加速(speculative decoding)。
想像你在打一篇文章,旁邊有個助手搶先把接下來幾個字打好。你看一眼:都對,整串收下,直接跳到後面繼續;第三個字就錯了,只收前兩個,從錯的地方自己接著打。助手猜得越準,你前進得越快。
模型吐字也是這樣。大模型就是那個打字的人:沒有助手的時候,它算一遍只吐得出一個 token。助手是一個很小、很快的模型,先把接下來幾個 token 猜出來;大模型一樣只算一遍,順便把這幾個檢查完,猜對的整串收下。大模型一秒能算幾遍差不多是固定的,所以速度快慢,全看每算一遍能收下幾個。
程式碼很好猜,括號後面接什麼、縮排幾格都有規矩,助手常常一猜就中一整串。照 QEngine 自己的紀錄,大模型每算一遍,寫程式平均收下 4.22 個 token,英文故事 2.62 個,中文故事只有 1.27 個。就算助手全猜錯,大模型自己也會吐出 1 個,所以寫程式等於每一遍多賺 3 個,中文那邊助手幾乎沒幫上忙。中文為什麼這麼難猜中,我沒有查。
逐題的數字和算法放在最後的進階那節。
四個對話同時跑,合計 592.8 tok/s
這次把單卡設成同時跑四個對話(QE_MAX_SEQS=4)。四個請求同時送進去,寫程式合計 592.8 tok/s,每一路 162.4;中文合計 406.7,每一路 104.4。
中文這邊很划算:四路同時跑,每一路只從 109.1 掉到 104.4,總量接近四倍。寫程式每一路從 358.5 掉到 162.4,總量只多 65%。作者的說明寫到,單卡上同時有三個以上的對話時,引擎猜字的方式會換一種。我的紀錄裡也看得到:單一對話時助手每一遍大約猜 7 個,四路時掉到平均 1 到 4 個左右。寫程式掉得多可能跟這個有關,但我沒另外測過,還不能確定。等第一個字的時間從 50 毫秒變成 125 毫秒左右。
在 Windows 的 5090 上裝起來:WSL2 加官方容器裡的執行檔
QEngine 沒有 Windows 版,GitHub 的 Releases 頁也沒有放執行檔,官方的裝法是 Docker 或自己從原始碼編。我的 5090 是 Windows 11,所以走 WSL2,裡面是 Ubuntu 26.04。你需要的東西:
- NVIDIA 驅動要支援 CUDA 13.1。我的是 621.14,沒有為了這次測試升級。
- WSL2 裡看得到顯卡(
nvidia-smi有東西)。 - 大約 16 GB 放權重。
如果你的 WSL2 已經有 Docker,照 README 的 Docker 指令跑應該最省事,這條路我沒試。我的 WSL2 沒裝 Docker,所以改成把官方 Docker image ghcr.io/bpx03/qengine:1.3.6 裡編好的 libqengine.so 和 CUDA 13.1 runtime 抽出來,配上 v1.3.6 的原始碼直接跑。不熟的話,把這一節整段貼給 Claude 或 ChatGPT,請它在你的 WSL2 裡照做就好。
抓原始碼和權重:
git clone --depth 1 --branch v1.3.6 https://github.com/bpx03/QEngine.git source
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python huggingface_hub
.venv/bin/hf download RedHatAI/Qwen3.8-27B-INT4 --local-dir source/models/Qwen3.8-27B-INT4
把容器裡的 app/build 放到 source/build,第一次載入會遇到這個錯:
OSError: libcudart.so.13: cannot open shared object file: No such file or directory
它找不到 CUDA 13 的 runtime。把容器裡那份 CUDA 函式庫和 WSL 自己的顯卡函式庫路徑都加進去就好:
export LD_LIBRARY_PATH="$PWD/prebuilt/usr/local/cuda-13.1/targets/x86_64-linux/lib:/usr/lib/wsl/lib:${LD_LIBRARY_PATH:-}"
然後照 README 的單卡指令啟動,我這裡把 context 設成 8192:
cd source
QE_DEVICES=0 QE_MAX_SEQS=1 server/run.sh 8080 --max-ctx 8192
啟動時它會警告「引擎是在兩張和三張卡上測的」,然後 13.2 秒載完。之後就是一般的 OpenAI 相容 API:
curl -s http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "messages": [{"role": "user", "content": "用一句話介紹你自己"}],
  "chat_template_kwargs": {"enable_thinking": false}
}'
那個 enable_thinking: false 要記得加。27B 預設開思考模式,我第一輪沒關,512 個 token 全部花在思考上,一個看得到的字都沒有。
中文回答沒有亂碼。帶 tools 的請求也正常,回來的是標準的 tool_calls,參數是可以解析的 JSON。
VRAM 會顯示 31.9 GB,因為它把剩下的都拿去放對話記憶
跑起來之後看 nvidia-smi,整張 5090 用到 31.9 GB,幾乎全滿。llama.cpp 不開草稿跑同一顆模型是 20.6 GB。
這不代表 27B 需要 32 GB。啟動 log 寫得很清楚:
KV pool: 380928 tokens shared by 1 sequence slots (max context 8192)
GPU0: weights 14.74 GB, cache+act 15.57 GB
權重只有 14.74 GB。剩下的是 QEngine 預設把顯卡上空著的記憶體全部拿去當 KV pool(放對話記憶的地方),在 5090 上是 38 萬個 token 的空間。作者的文件說 pool 大小可以用 QE_POOL_TOKENS 指定,別的程式來要 VRAM 時 pool 也會縮小讓出來。這兩件事我這次沒有測,如果你的卡還要同時跑別的東西,先自己驗一次。
2080 Ti 編不出來:缺的是 3000 系列才有的指令
5090 過了,回頭看這系列的主角。QEngine 的說明只列了 RTX 3000、4000、5000 系列,沒有提 2080 Ti。沒提是「不能」,還是「作者手上沒有、沒編那個版本」?
我在裝了三張 2080 Ti 的那台機器上開了一個獨立目錄,裝 CUDA 13.1 的編譯工具,把目標架構指定成 2080 Ti 的 sm_75:
cmake -S source -B build-sm75 -G "Unix Makefiles" \
  -DCMAKE_CUDA_ARCHITECTURES=75 \
  -DCMAKE_CXX_COMPILER=/usr/bin/g++-13 \
  -DCMAKE_CUDA_HOST_COMPILER=/usr/bin/g++-13 \
  -DCMAKE_CUDA_COMPILER="$D/cuda-13.1/bin/nvcc" \
  -DCMAKE_BUILD_TYPE=Release
cmake --build build-sm75 --target qengine --parallel 4
CUDA 13.1 的編譯器還收 sm_75,設定階段過了。真的開始編之後停在這裡:
ptxas .../dn_ab.ptx, line 213; error   : Feature '.bf16' requires .target sm_80 or higher
ptxas .../dn_ab.ptx, line 213; error   : Feature '.m16n8k16' requires .target sm_80 or higher
出錯的是 src/kernels/dn_ab.cu 第 13 行,一條直接寫成組合語言的 tensor core 矩陣乘法指令,資料格式是 BF16。這個格式的 tensor core 指令要 sm_80 以上才有(RTX 3000 系列是 sm_86),2080 Ti 的晶片上沒有這條指令。我數了一下,src 底下有 8 個檔案直接寫了這條 BF16 指令。
所以答案是「不能」。缺的是硬體指令,升驅動沒有用。要讓它在 2080 Ti 上跑,得把運算核心改寫成別的格式,等於重做引擎的一大塊。
這個系列裡 2080 Ti 跑 27B 的路還是原本那幾條:一張卡用 llama.cpp 30 tok/s,兩張卡用 FastLLM 加 DFlash2 寫程式 153.8 tok/s。
進階:量測條件、對照的限制、編譯紀錄
不讀這節不影響使用。這裡放完整的量測條件和中間遇到的事,方便你或你的 AI 對照自己的狀況。
量測條件
| 項目 | 設定 |
|---|---|
| 機器 | RTX 5090 32 GB,Windows 11 專業版 10.0.26300,NVIDIA 驅動 621.14 |
| WSL2 | Ubuntu 26.04.1 LTS,kernel 6.18.33.2-microsoft-standard-WSL2 |
| QEngine | 1.3.6,commit 444b2e4,libqengine.so 取自 ghcr.io/bpx03/qengine:1.3.6 |
| QEngine 權重 | RedHatAI/Qwen3.8-27B-INT4(W4A16),加作者調過的 MTP head 與 DFlash2 草稿模型(引擎自動下載) |
| QEngine 啟動 | QE_DEVICES=0 QE_MAX_SEQS=1(四路時 4),--max-ctx 8192,KV 預設 FP8,視覺預設關 |
| llama.cpp | 官方 Windows CUDA 13.5 版 b12445,Q4_K_M GGUF,-ngl 999 -c 8192 -np 1 --jinja --seed 42 --spec-type none |
| llama.cpp 開草稿 | 同上,改成 --spec-type draft-dflash2 --spec-draft-model,草稿模型是 z-lab/Qwen3.8-27B-DFlash2-GGUF 的 Q4_K_M;--spec-draft-n-max 預設 3,寫程式另外量一組 7 |
| 請求參數 | max_tokens=512, seed=42, temperature=0.7, top_p=0.8, presence_penalty=1.5, ignore_eos=true, stream=true,enable_thinking=false |
| 取樣差異 | QEngine top_k=20,llama.cpp top_k=40(各自預設,沒有覆寫) |
| 速度算法 | 512 / (整段串流時間 − 第一個字的時間),在發請求的那一端量,含 SSH port forwarding 的額外耗時 |
| VRAM | 每 0.5 秒左右取樣 nvidia-smi,是整張卡的峰值,含桌面佔用的約 1.9 GB |
三次量測的範圍很窄:QEngine 單路中文 108.59–109.17、英文 224.40–225.17、寫程式 357.31–361.23;llama.cpp 不開草稿三種題目都在 69.1–69.4 之間;開 DFlash2 草稿是中文 81.84–81.95、英文 119.07–119.42、寫程式 154.73–155.08,調成一次猜 7 個時寫程式 167.65–169.09。
草稿加速的逐題數字
QEngine 的紀錄會印出每個請求平均一步前進幾個 token(含大模型自己確定的那一個)。一步是大模型算一遍,「走了幾步」是吐完 512 個 token 總共算了幾遍:
| 題目 | 平均一步前進幾個 token | 走了幾步 | tok/s |
|---|---|---|---|
| 中文故事 | 1.27 | 403 | 109.1 |
| 英文故事 | 2.62 | 195 | 225.1 |
| 寫程式 | 4.22 | 121 | 358.5 |
把步數除以時間,三種題目都是每秒大約 85 步,所以每秒吐幾個 token,就是 85 乘上每一步前進幾個。
兩個負責猜的小模型
一個是另外載入的 DFlash2 草稿模型,一次猜 7 個 token;另一個是模型內建的 MTP head,一次猜 1 到 7 個。照作者的說明,單卡上同時跑的對話在兩個以內、記憶體也放得下時用 DFlash2,三個以上用 MTP head。我這次兩個都有載入,紀錄裡的數字跟這個說明對得上;兩者各自貢獻多少沒有拆開量。
除了草稿,引擎自己快在哪
把速度拆成兩半來看:每秒走幾步,和每一步前進幾個 token。
QEngine 三種題目都是每秒約 85 步,一步約 11.7 毫秒,照我的紀錄,這一步平均同時檢查將近 7 個草稿。llama.cpp 不開草稿時一步出一個 token,69 tok/s 就是一步約 14.5 毫秒。開了 DFlash2 之後,拿它的速度除以每一步平均前進的 token 數,是每秒 51 到 53 步,一步 19 到 20 毫秒。llama.cpp 要檢查草稿,每一步就變慢;QEngine 檢查將近 7 個,一步還比 llama.cpp 不檢查的時候短。兩邊量化格式和執行環境不同,這個差距不能全算在引擎頭上。
作者的文件和原始碼註解提到幾個做法。我沒有一項一項關掉來量,所以各自貢獻多少不知道。
- 運算核心照 Qwen3.8 的結構手寫,不呼叫通用的矩陣運算函式庫。
- INT4 權重在載入時排成 tensor core 能直接吃的格式,計算走 BF16 指令。2080 Ti 編不出來就是卡在這個指令。
- 每一步的主要運算錄成 CUDA graph 重放,省掉一個一個啟動 kernel 的時間。
- 算下一個 token 的機率時,先用 INT4 版本的輸出層把整個詞表篩一遍,只把排前面的候選拿去用 BF16 權重精算:貪婪解碼取前 16 名,取樣時取前 64 名。
- 如果剛吐出來的字跟前文重複,草稿就直接從前文抄。
- 內建的 MTP head 是作者用引擎自己的回答微調過的版本,第一次啟動時自動下載。
這組對照不能拿來說什麼
- 兩邊的草稿設定不一樣。llama.cpp 預設一次猜 3 個,中文每一步平均前進 1.55 個 token、英文 2.31 個、寫程式 3.06 個;調成 7 個時,寫程式每一步前進 3.48 個。
- llama.cpp 的
draft-mtp沒量到。這顆 Q4_K_M GGUF 沒有內嵌 MTP head,啟動時報context type MTP requested but model doesn't contain MTP layers;另外掛獨立 MTP 檔的做法沒試。 - context 只開 8192、輸出只有 512 個 token。長對話、長輸出的速度沒有量。
- 思考模式的速度沒有列。第一輪照預設開著思考跑完,QEngine 的 512 個 token 全是思考內容,拿那個數字當「寫故事的速度」不對,所以關掉思考整輪重跑。
- 每種題目只有一題。草稿猜中率跟內容關係很大,換一題數字會動。
四路的每一路數字
四個請求同時送出,每一路各量三次。合計的算法是 2048 / 整組完成時間,含等第一個字的時間。
| 中文 | 英文 | 寫程式 | |
|---|---|---|---|
| 合計 tok/s | 406.7 | 571.5 | 592.8 |
| 每一路 tok/s(12 個樣本的中間值) | 104.4 | 154.5 | 162.4 |
| 每一路範圍 | 102.19–110.01 | 144.80–156.39 | 151.87–174.53 |
| 等第一個字(毫秒) | 125.2 | 127.7 | 123.2 |
四路時 KV pool 是 352,256 個 token,四個對話共用。
作者自己公布的數字
QEngine 的 README 與 1.3.6 版說明裡,27B 有兩組作者自己量的數字,硬體和題目都跟我的不同,放在這裡只供參考,不能跟上面的表直接比:
- 三張 RTX 3090:單一對話故事 279、寫程式 516 tok/s;八個 agent、每個丟隨機的 500 token prompt,合計 1,129 tok/s。
- 一張 RTX 3090、短回覆(385 token、greedy):寫程式 212、故事 150、證明題 196 tok/s。
2080 Ti 編譯的完整經過
機器是三張 RTX 2080 Ti 22 GB,驅動 580.173.02,系統原本的 nvcc 是 12.4。我沒有動系統的 CUDA,另外在獨立目錄放了 NVIDIA 官方 13.1.0 的 nvcc、cudart、cccl、libnvvm 等編譯元件,不含驅動。
第一個錯跟顯卡無關,是 CUDA 13.1 的標頭檔和系統 glibc 2.43 打架:
/usr/include/x86_64-linux-gnu/bits/mathcalls.h(206): error: exception
specification is incompatible with that of previous function "rsqrt"
glibc 的宣告帶 noexcept,CUDA 的沒帶。在那份獨立的 CUDA 標頭 include/crt/math_functions.h 裡,把 rsqrt 和 rsqrtf 兩行補上 noexcept (true) 就過了。QEngine 的原始碼沒有改任何一行。
第二個錯就是上面那條 .bf16。NVIDIA 的 PTX 指令文件寫明 BF16 的 m16n8k16 矩陣指令要 sm_80 以上,跟編譯器的錯誤訊息一致。
因為沒有編出 libqengine.so,現有驅動(580,回報 CUDA 13.0)能不能初始化 QEngine,這次沒有驗到。
常見問題
- QEngine 能在 Windows 上跑嗎?
- 官方只支援 Linux,README 寫明 Windows 與 WSL2 沒測過。我在 Windows 11 的 WSL2(Ubuntu 26.04、NVIDIA 驅動 621.14)用 QEngine 1.3.6 把 Qwen3.8-27B 跑起來了,中文對答和工具呼叫格式都正常。原生 Windows 沒有執行檔可用,我沒有試。
- RTX 5090 單卡用 QEngine 跑 Qwen3.8-27B 有多快?
- 單一對話、輸出 512 token、關閉思考:寫程式 358.5 tok/s、英文故事 225.1、中文故事 109.1。四個對話同時跑,合計是 592.8、571.5、406.7 tok/s。同一張卡用 llama.cpp 跑 Q4_K_M,不開草稿加速是 69 tok/s,開 DFlash2 草稿是寫程式 155.0、英文 119.3、中文 81.9。兩邊量化格式和執行環境不同,所以不是同條件對照。
- QEngine 跑 27B 要多少 VRAM?
- 權重本身 14.74 GB。但它預設會把顯卡剩下的記憶體全部拿去當 KV pool,所以我在 5090 上量到整張卡峰值 31.9 GB。pool 大小可以用 QE_POOL_TOKENS 指定,作者也寫了別的程式要 VRAM 時它會讓出來,這兩點我沒有實測。
- QEngine 可以在 RTX 2080 Ti 上跑嗎?
- 1.3.6 不行。我用 CUDA 13.1 把架構指定成 sm_75 來編,編譯器卡在 src/kernels/dn_ab.cu,錯誤是 Feature '.bf16' requires .target sm_80 or higher。QEngine 的運算核心用了 BF16 的 tensor core 指令,那是 RTX 3000 系列才有的,升級驅動也補不回來。
- 為什麼同一顆模型,中文比寫程式慢這麼多?
- QEngine 的速度大半來自草稿加速:先猜接下來幾個 token,再讓大模型一次驗。我量到它每秒大約驗 85 次,不管哪種內容都差不多;差別在每次猜中幾個。寫程式平均一步前進 4.22 個 token,英文 2.62 個,中文只有 1.27 個,這個數字含大模型自己確定的那一個。
接著讀
- 2026-08-21[Benchmark] 換一個檔案、改一個數字,2080 Ti 上的 27B 免費快 15%
Qwen3.8-27B 在 2080 Ti 的免費加速實測:修復版 chat template 讓 KV 快取命中 94.5%,MTP 草稿深度 2 開到 4 讓 decode 從 41.6 到 47.6 tok/s。附完整驗證方法。
- 2026-10-16[Benchmark] 一張 2080 Ti 接手兩張卡的 27B:MiniCPM-V 4.7 35B 吐字 111.5 tok/s,還會看圖
MiniCPM-V 4.7 35B-A3B 是會看圖的 MoE 模型,每個字只算 3B。一張改裝 2080 Ti 22G 跑官方混合 q3:吐字 111.5 tok/s、262k context 只用 20.8G,140 題 127,原本兩張卡的 27B 是 128。它現在是家裡的聊天主力,空出來的那張卡給了 Strata。
- 2026-09-21什麼!?Qwen3.8 27B 居然被壓到 5.9GB,跑起來能力居然有無損模型的 98.2%
PrismML 的 Ternary Bonsai 2 把 Qwen3.8-27B 壓成三值權重,官方說 5.9GB 保留 FP16 的 98.2% 能力。我在一張改裝 2080 Ti 22G 上跑同一組權重的 7.2GB 版:140 題拿 130,兩張卡跑 Q8_0 是 131。附編譯、啟動指令,以及為什麼最小那包反而最慢。
- 2026-08-28[Benchmark] 1770 億參數塞進三張二手 2080 Ti:改檔案快 3.5 倍,寫散文一點都沒快
Qwen3.8-Flash-Next(176.94B)跑在三張改裝 2080 Ti 上:128K context 拿到 23.14 tok/s,開 ngram 投機解碼後改檔案衝到 77.56。附三種量化在相同條件下的對照。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。