改裝 2080 Ti 22G · part 23
一張改裝 2080 Ti 跑 177B:Strata 讓 Qwen3.8-Flash-Next 寫程式 70 tok/s
❯ cat --toc
- 前言
- 一張卡寫程式 70.3 tok/s,雙卡是 91.4
- Strata 怎麼把 177B 塞進一張卡
- 需要什麼:一張 2080 Ti 22G、128GB 記憶體、約 90GB 硬碟
- 安裝:跑一次 setup.py,自己編 sm_75
- 啟動與第一個請求
- 跟 27B 同時跑:Strata 慢 1.3%,27B 慢 7.7%
- 跟 ComfyUI 輪班:切回去 12.4 秒,切過來要 5 分鐘
- 進階:parallel、思考檔位與雙卡實驗
- parallel 設 2:單路掉到 44–60,兩路合計也只有 60
- 思考:Strata 預設 xhigh,改 low 分數更高、時間只要三成
- 16K prompt 的完整數字
- 雙卡試過、沒用的加速方法
- 版本與環境
- 還沒做的
TL;DR
一張改裝 2080 Ti 22G 加 128GB 記憶體,用 Strata 跑 177B 的 Qwen3.8-Flash-Next(IQ3_S):寫程式 70.3 tok/s、中文 52.9、英文 51.5。顯卡的 22GB VRAM 用掉 21.6GB,放 attention、共用層、KV cache 和最常用的 expert;全部 expert 在 128GB RAM 裡各有一份,沒放上顯卡的由 CPU 直接在 RAM 裡同時算,Strata 就緒後整台機器可用的 RAM 少約 37–48GB。旁邊兩張卡的 27B 照跑,同時送請求只慢 1.3% 和 7.7%;要生圖時 12.4 秒切回 ComfyUI,切過來要等 5 分鐘。
前言
我的 ai-lab 有三張改裝 2080 Ti。前兩張跑 Qwen3.8-27B(#22),速度能榨的差不多都榨了,但 27B 的能力就停在那裡;想要更聰明,就得換更大的模型。第三張卡給 ComfyUI 生圖生影片,但那是想到才用,很多天整張卡是閒著的。
更大的模型我跑過:#17 用 llama.cpp 跑同一顆 177B 的 Qwen3.8-Flash-Next,三張卡全吃滿,128K context 只有 23.14 tok/s。27B 和 ComfyUI 都得停,一台機器只剩它在跑,不能常駐。
Strata 號稱一張卡就能跑這顆 177B:MoE 的 expert 放 RAM,只把最常用的放顯卡。我把它裝在第三張卡上,寫程式跑出 70.3 tok/s,27B 照跑,要生影片時 12 秒切回 ComfyUI。這篇是怎麼裝、怎麼開、跟另外兩個服務怎麼共存。
一張卡寫程式 70.3 tok/s,雙卡是 91.4
同一台機器、同一組題目,單卡跟雙卡比。看第一列:
| 單卡(GPU2) | 雙卡(GPU0+1) | 單卡相對雙卡 | |
|---|---|---|---|
| 寫程式(tok/s) | 70.3 | 91.4 | −23% |
| 中文 / 英文(tok/s) | 52.9 / 51.5 | 60.0 / 60.0 | −12% / −14% |
| 16K token 的 prompt,第一個字 | 12.2 秒 | 10.6 秒 | 慢 15% |
| 顯卡用量 | 21.6 GB | 兩張 |
量法:真實的 chat 請求、串流、不開思考,三種題目各打三發取中位數,每發最多 650 token(寫程式那題會被截斷,兩邊同條件)。速度取 Strata 自己 /metrics 的生成速度。
少一張卡,寫程式掉 23%,中英文只掉 12–14%。大部分 expert 本來就在 CPU 上算,多一張卡只是多放一些常用的 expert 進顯卡;寫程式差最多,我猜是寫程式用到的 expert 比較集中,多放的那些剛好打中;這點我沒有量 expert 的使用分布。
跟 #17 的 llama.cpp 比:那時三張卡 128K 是 23.14、32K 是 26.16。這次只用一張卡,寫程式是 70.3。兩邊的量化不一樣(那篇是 UD-IQ4_XS,這篇是 IQ3_S),題目也不同,這個對照只說明「同一顆模型,從吃滿整台機器變成只佔一張卡」。#17 那個改檔案 77.56 tok/s 是 ngram 投機解碼在「輸出幾乎都在輸入裡」的情況,跟這裡從零寫程式不是同一件事。
Strata 怎麼把 177B 塞進一張卡
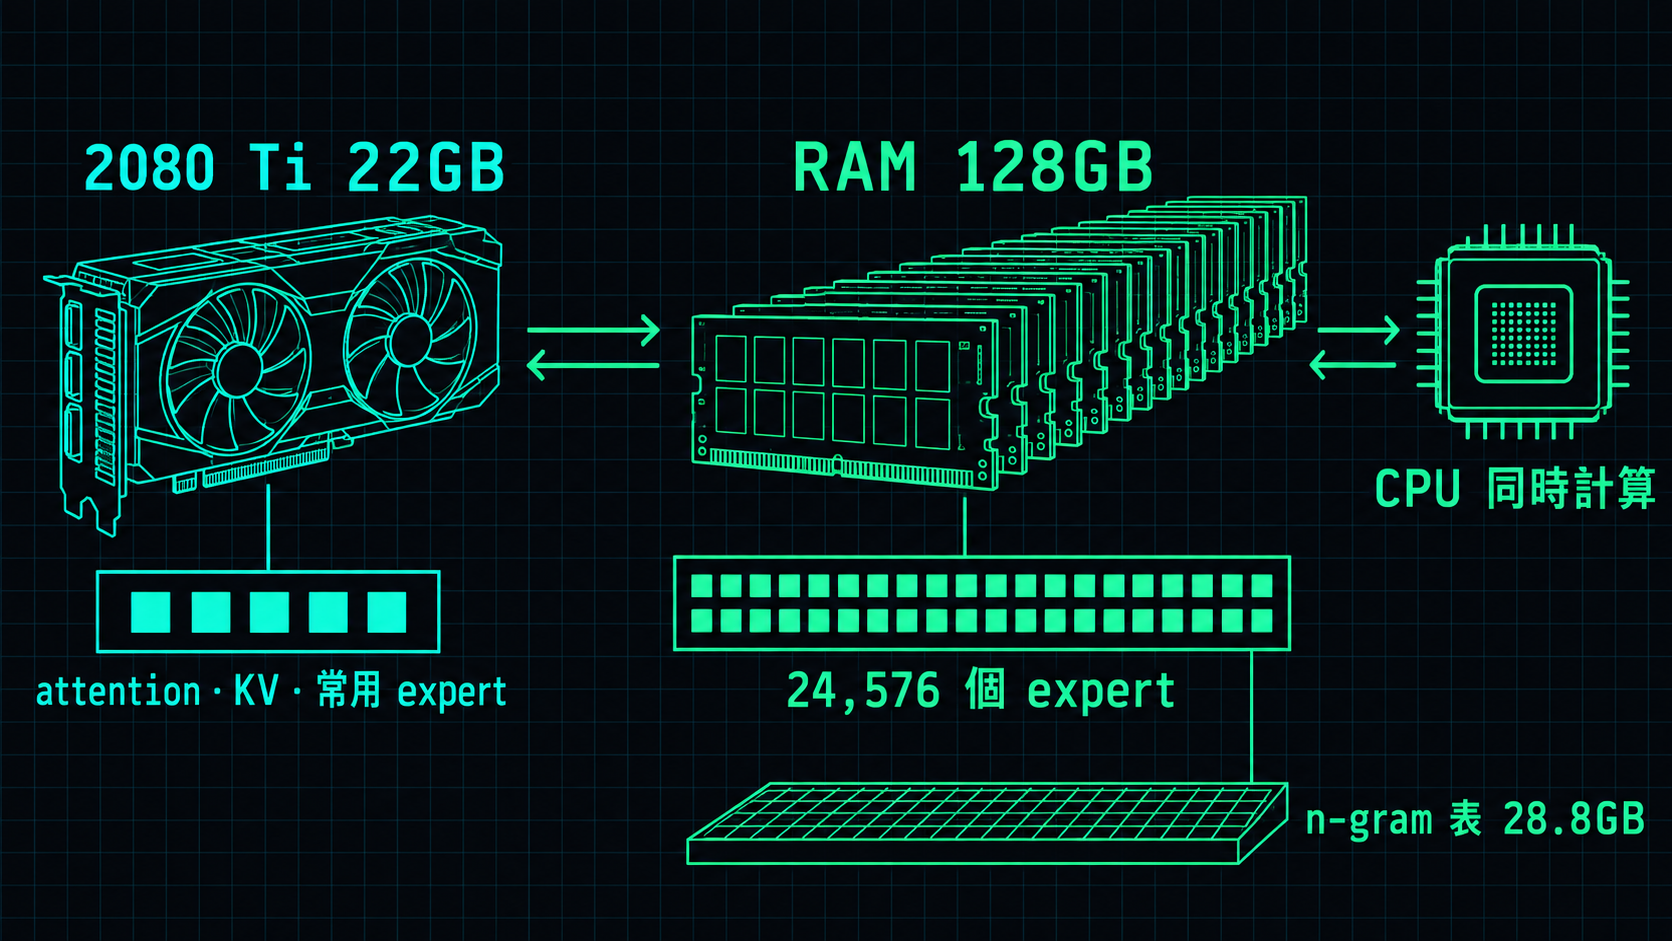
一般的模型每生一個字,要把全部參數算過一遍。Qwen3.8-Flash-Next 是 MoE(混合專家)模型,不一樣:177B 的參數大部分拆成 24,576 個小模組,叫做「專家」(48 層、每層 512 個)。每生一個字,每一層只挑 11 個專家來算,其他的那一輪完全不用。
所以不需要把整顆模型塞進顯卡,只要「這個字要用的那幾個專家」算得到就好。Strata 照「多常被用到」把東西分開放:
- 顯卡:每個字都一定會算到的部分,還有對話的暫存(KV cache;context 開到 128K 時只有最常讀的 32K 放顯卡,其餘在 RAM)。剩下的 VRAM 全部拿來放最常被挑中的專家,聊天過程中它會自己換。
- RAM:全部 24,576 個專家都有一份在這裡。這一層挑中的 11 個專家,在顯卡上的就由顯卡算,不在的由 CPU 直接在 RAM 裡算。兩邊算的是不同的專家,同時算,最後把結果加起來,不用先把專家搬上顯卡。
- n-gram 表:這顆模型另外有一張 28.8GB 的查表(#17 講過,每個字只查幾列)。Strata 預設把它放在 SSD 直接讀,我的設定用
--ple-io ram放進 RAM,實測跟放 SSD 速度沒差。
代價是 CPU 要分擔一部分運算,所以這套很吃 RAM,也吃 CPU。
另外它用模型自己的 MTP 層先猜幾個字,主模型 48 層一次驗。驗過才收,輸出跟不猜一樣。
需要什麼:一張 2080 Ti 22G、128GB 記憶體、約 90GB 硬碟
- 顯卡:一張 RTX 2080 Ti 22G(改裝版)。Strata 跑起來吃掉 21.6GB,幾乎全滿。
- RAM:IQ3_S 在 Strata 安裝程式裡標的是 62GB。我的機器 128GB,三輪切換實測,Strata 就緒前後的可用記憶體差了 47.6、37.0、39.5GiB(n-gram 表放 RAM 的情況;這是整台機器可用量的變化,不等於 Strata 自己用掉的量)。官方說 64GB 的電腦也行,但幾乎不能跑別的。
- 硬碟:ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF 的 IQ3_S(約 3.5 bit 的量化,Strata 的安裝程式說它在公開的評測上跟完整模型打平,是幾種量化規格裡品質最好、也最慢的),切成兩個檔,54.8GB + 28.8GB,共 83.6GB。我放在 NVMe 上。加上 setup 另外抓的 MTP 權重(6.5GB)和打包檔(1.5GB),整個目錄
du量起來約 86GB(GiB 計),抓 90GB 的空間比較保險。 - 軟體:Python 3.10 以上、g++、CUDA 12 的 nvcc(我用 12.4)。這三樣都有的話,整個安裝不用 sudo。
安裝:跑一次 setup.py,自己編 sm_75
2080 Ti 是 Turing(sm_75),我用 --build 從原始碼編,不下載預編好的執行檔。編出來的 binary 用 cuobjdump 看,58 個 sm_75 的段都在。
git clone https://github.com/Niko1221/Strata.git /mnt/nvme1t/strata/src
cd /mnt/nvme1t/strata/src
git checkout 6f32ec07          # 我裝的版本,引擎 0.1.39
python3 -m venv .venv

export XDG_CONFIG_HOME=/mnt/nvme1t/strata/config \
       PIP_CACHE_DIR=/mnt/nvme1t/strata/pip-cache \
       TMPDIR=/mnt/nvme1t/strata/tmp \
       HF_HOME=/mnt/nvme1t/strata/data/hf

.venv/bin/python setup.py --family qwen --model IQ3_S --gpu 0 \
  --cuda 12 --build --context 32768 --kv int8 --vision no \
  --data-dir /mnt/nvme1t/strata/data --port 8096 --host 127.0.0.1 \
  --no-browser --no-start --low-ram off --yes
幾個要注意的:
--gpu 0改成你要用的那張卡。 我機器上是第三張(GPU2),實際做法是用CUDA_VISIBLE_DEVICES指定那張卡的 UUID,Strata 裡面還是寫--gpu 0,後面啟動那節有。- 所有路徑都導到同一個資料夾。 那四個環境變數加
--data-dir,設定檔、pip 快取、模型、暫存全部在/mnt/nvme1t/strata底下,不會動到家目錄或系統。 --low-ram off:安裝程式會看當下可用的 RAM 決定要不要開省記憶體模式。我裝的時候 27B 和 ComfyUI 都還開著,可用量看起來不夠,所以手動關掉。- MTP 草稿層會另外從 Qwen 官方 repo 抓需要的那幾段權重,每個張量都會驗 SHA-256。
模型的兩個檔很大,我先用 curl -C - 下載到 data/models/IQ3_S/(可以續傳),跑完再跟 Hugging Face 上的 SHA-256 對過一次,setup 看到檔案完整就不會重抓。setup 最後印 All set. 就是裝好了。
啟動與第一個請求
我用的設定檔長這樣(只列 args 和會影響結果的欄位):
{
  "args": [
    "--pack", "/mnt/nvme1t/strata/data/packs/iq3_s",
    "--native", ".../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf", ".../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-cache", "auto", "--prefill", "auto",
    "--spec", "4", "--spec-min-p", "0.5",
    "--mtp", "/mnt/nvme1t/strata/data/mtp/rt",
    "--max-context", "131072", "--kv", "int8", "--kv-resident", "32768",
    "--ple-io", "ram"
  ],
  "gpu": [0],
  "env": { "STRATA_BF16_TC": "1", "CUDA_VISIBLE_DEVICES": "GPU-<你那張卡的 UUID>" },
  "parallel": 1,
  "aliases": ["shio"]
}
--max-context 131072加--kv-resident 32768:context 開到 128K,KV cache 只把最常讀的 32K 留在顯卡,其餘從 RAM 讀。STRATA_BF16_TC=1:讀長 prompt 比較快,雙卡實測 16K 的第一個字從 12.6 秒到 10.6 秒。parallel一定設 1,原因在進階那節。
啟動:
cd /mnt/nvme1t/strata/src
.venv/bin/python serve/server.py --engine strata \
  --config /mnt/nvme1t/strata/strata-iq3_s-gpu2.json \
  --host 0.0.0.0 --port 8096 --gpu 0
它是 OpenAI 相容的 API,載入要幾分鐘,/v1/models 回 200 就能打:
curl -s localhost:8096/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model": "shio",
  "messages": [{"role": "user", "content": "用 Python 寫一個判斷質數的函式"}],
  "reasoning_effort": "low",
  "max_tokens": 512
}'
reasoning_effort 我每次都帶 low。Strata 預設會開思考,而且是 xhigh;同一組 140 題 low 分數反而比較高、時間只要三分之一,數字在進階那節。
跟 27B 同時跑:Strata 慢 1.3%,27B 慢 7.7%
這張卡要能常駐,前提是不拖累旁邊的 27B。我讓兩邊同時收到同一題寫程式,跑三組。看「差異」那欄:
| 單獨跑 | 同時跑 | 差異 | |
|---|---|---|---|
| Strata(GPU2) | 70.3 | 69.4 | −1.3% |
| Qwen3.8-27B(GPU0+1) | 243.1 | 224.4 | −7.7% |
27B 為什麼慢得比較多?兩邊用的是不同的顯卡,搶的應該是 CPU 和記憶體頻寬,Strata 的 expert 全靠 CPU 算;這點我沒單獨驗。
有一個要說清楚:27B 一題約 3 秒就答完,Strata 要 10–12 秒,所以真正「同時在跑」的只有 Strata 的前三秒左右。Strata 的 −1.3% 是這個條件下的數字,兩邊都長時間滿載的情況我沒量。
整段測試 27B 的服務沒有重啟過,每 5 秒打一次健康檢查,106 次全部 200。
27B 那個 243 是這篇的量法(串流、不開思考、650 token),跟 #22 的 151.7 量法不同,不能直接比。
跟 ComfyUI 輪班:切回去 12.4 秒,切過來要 5 分鐘
第三張卡平常還是要生圖生影片,兩邊沒辦法同時放在一張 22GB 的卡上。我把這一席取名「汐」(Shio),潮汐的意思:卡平常給 Shio,要做影片時退潮,換 ComfyUI 上來。
做法是兩個 systemd user service 互相 Conflicts=,啟動一個就會停掉另一個,再加一支 gpu2-mode 腳本:
~/bin/gpu2-mode shio      # ComfyUI → Shio
~/bin/gpu2-mode comfy     # Shio → ComfyUI
~/bin/gpu2-mode status    # 目前是誰、VRAM 和 RAM 剩多少
腳本切換前會先檢查:ComfyUI 的佇列有工作就不切,Shio 有請求在跑也不切;切過去在 10 分鐘內沒就緒,就自動切回原本那邊。
三輪實測,看「就緒」那欄:
| 方向 | 就緒 | 之後第一個工作 |
|---|---|---|
| ComfyUI → Shio | 281–334 秒 | 第一個請求 2.6–3.4 秒 |
| Shio → ComfyUI | 12.4 秒 | 第一張 512 圖 30.5–31 秒(冷),第二張 18.3–18.4 秒 |
切回 ComfyUI 很快:從下指令到第一張圖出來約 43 秒,其中 31 秒是 ComfyUI 第一次載入生圖模型,平常本來就要等。切到 Shio 要等將近 5 分鐘,大部分時間在把模型讀進 RAM;第二、三輪比第一輪快,可能是作業系統的檔案快取還留著一部分,這點沒單獨驗證。
所以日常用法是:Shio 掛著,要做影片時切 ComfyUI,做完再切回來,等 5 分鐘的那一次放在不急的時候。開機預設還是 ComfyUI,Shio 的 service 沒設開機自動啟動。
進階:parallel、思考檔位與雙卡實驗
不讀這節不影響使用。這裡是為什麼 parallel 設 1、為什麼思考預設改 low,以及雙卡那邊試過但沒用的加速方法。
parallel 設 2:單路掉到 44–60,兩路合計也只有 60
一開始我照 27B 的習慣開 parallel: 2,想讓兩個人同時用。狀態 API 確認兩個 slot 都在用,結果是:
| 同時請求數 | 每路生成速度 | 合計 |
|---|---|---|
| 1 | 60.32 | 54.49 |
| 2 | 30.39 / 32.26 | 60.23 |
(每路速度用輸出 token 數除以扣掉第一個字等待後的時間;合計用整批的總時間算,所以單路的合計比每路低一點。)
兩路同時,合計 60,跟一路差不多,等於只是把速度切一半給兩個人。開了 parallel: 2 之後,就算只有一個請求,速度也掉下來。那單路為什麼也變慢?Strata 的批次路徑不用 MTP 草稿,但它的文件說單獨一個請求仍然走有 MTP 的路徑。原因我還沒查出來,只確定改回 1 就恢復。切換實驗那三輪用的是 parallel: 2,第一個請求量到 44.4、60.3、44.8 tok/s。
改回 parallel: 1 之後重測,寫程式 67.2 和 70.1。
思考:Strata 預設 xhigh,改 low 分數更高、時間只要三成
Strata 預設開思考,而且檔位是 xhigh。我在另一台機器(GX10)上同一顆 Qwen3.8-Flash-Next 跑過同一套 140 題,比 low 和 xhigh:
| 思考檔位 | 140 題得分 | 總耗時 |
|---|---|---|
| low | 126 | 1,736 秒 |
| xhigh | 117 | 5,902 秒 |
那台的引擎跟這篇不一樣,所以這組數字只拿來看兩個檔位的相對差距,不是 Strata 在 2080 Ti 上的分數。low 多對 9 題、時間是 xhigh 的 29%。在 70 tok/s 的卡上,想太久的代價更明顯,所以 Shio 的預設改成 low。
改法有兩種。不想動程式,就每個請求帶 "reasoning_effort": "low"。我的 client(Pi)只會送「開思考」、不帶檔位,所以我在 serve/server.py 的 OpenAI 請求入口加了三行:請求沒帶任何檔位就補 low,有帶的照用。Strata 自己的 /settings 也能設共用預設,但它只在請求完全沒帶思考參數時才生效,對只送「開思考」的 client 沒用。
16K prompt 的完整數字
| 單卡 | 雙卡 | |
|---|---|---|
| 第一個字 | 12.2 秒 | 10.6 秒 |
| prompt 讀取速度 | 1,325 tok/s | 1,525 tok/s |
| 之後的生成 | 49.8 tok/s | 66.1 tok/s |
都只量一發。這組的設定是 --max-context 32768;上線的設定改成 128K 加 --kv-resident 32768,之後重測寫程式是 70.1,跟 32K 時的 70.3 差不多。
雙卡試過、沒用的加速方法
雙卡那篇(下一篇)試了幾個加速方法,結論先放這裡:
--ple-io ram(n-gram 表放 RAM 而不是 SSD):速度沒差,SSD 讀那張表本來就不卡。單卡我還是放 RAM。--peer-device(走 NVLink):慢約 10%。- 把第三張卡當成 helper 分擔 expert:寫程式從 91.4 掉到 48,慢 47%。
所以這張單卡 Shio 沒加任何這類旗標,只開了 STRATA_BF16_TC=1。
版本與環境
- Strata:
6f32ec07,引擎 0.1.39,--build --cuda 12自編,CUDA 12.4、sm_75 - 模型:ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF,IQ3_S,兩個檔的 SHA-256 都跟 Hugging Face 上對過
- MTP 草稿層:Qwen/Qwen3.8-Flash-Next 官方權重裡抓出來的那幾段
- 草稿詞表:Strata 內建的中日韓詞表(106,299 個 id)
- 機器:ai-lab,EPYC,128GB RAM,三張 RTX 2080 Ti 22G(GPU0+1 跑 27B,GPU2 跟 ComfyUI 輪班)
還沒做的
- 140 題沒在 Shio 本身(IQ3_S、Strata)上跑過,low 和 xhigh 的比較是另一台機器的數字。
同系列:
常見問題
- 一張 2080 Ti 22G 跑得動 177B 的 Qwen3.8-Flash-Next 嗎?
- 用 Strata 跑得動。Strata 把 attention、共用的部分和最常用的 expert 放在顯卡上,全部 24,576 個 expert 放在 RAM、由 CPU 直接在 RAM 裡算。一張改裝 2080 Ti 22G 加 128GB 記憶體跑 IQ3_S,寫程式 70.3 tok/s、中文 52.9、英文 51.5,顯卡用掉約 21.6GB,可用記憶體少了約 37–48GB。
- 跑 Strata 的 IQ3_S 需要多少記憶體?
- Strata 的安裝程式把 IQ3_S 標成 62GB RAM、下載 83.6GB(切成兩個檔,54.8GB + 28.8GB)。我的機器有 128GB,三輪實測 Strata 就緒後可用記憶體少了約 37–48GB。64GB 的電腦官方說也行,但要幾乎不跑別的東西。
- 單卡跟雙卡跑 Strata 差多少?
- 同一台機器、同一組題目,單卡寫程式 70.3、雙卡 91.4 tok/s(慢 23%);中文 52.9 對 60.0、英文 51.5 對 60.0。中英文差得比較少,因為大部分 expert 本來就在 CPU 上算,多一張卡只多放一些常用的 expert。
- Strata 和另一個模型同時跑會互相拖慢嗎?
- 會,但不多。Strata 在第三張卡、Qwen3.8-27B 在另外兩張卡,同時送寫程式的請求:Strata 從 70.3 到 69.4(−1.3%),27B 從 243.1 到 224.4(−7.7%)。27B 每次只花約 3 秒就答完,Strata 要 10–12 秒,所以同時跑的只有 Strata 的前段。
- Strata 的 parallel 該開多少?
- 一張 2080 Ti 開 1。開 `parallel: 2` 時單路掉到 44–60 tok/s,兩路同時各約 31、合計 60,跟一路差不多。改回 1 之後單路回到 67–70。
接著讀
- 2026-09-282080 Ti 沒有 FP4 也能跑 NVFP4:自己轉 Qwen3.8-27B,寫程式快 31%
2080 Ti 沒有 FP4 硬體,FastLLM 在 kernel 裡解包 NVFP4 照樣變快:自己把 Qwen3.8-27B BF16 轉成 NVFP4,寫程式 151.7 tok/s(FP8 116.1),四條請求同時跑合計 297,140 題 131/128。附轉換腳本與三顆 NVFP4 的比較。
- 2026-09-28雙 2080 Ti FastLLM 升級:寫程式快 16%、兩人同時用,長請求不再擋人
兩張改裝 2080 Ti 22G 的 FastLLM + DFlash2 換成自編的上游最新版:寫程式 116.1 tok/s(同組題目原本 100.3),兩個請求同時跑,長請求讀 prompt 時短請求 1.1 秒開始回。附編譯步驟、啟動指令和兩個上游 PR。
- 2026-09-21特化的啟動器 FastLLM + DFlash2,居然可以在魔改的 2080 Ti 雙卡跑出 100+ tok/s!
兩張改裝 2080 Ti 22G 用 FastLLM 跑 Qwen3.8-27B FP8,掛上 DFlash2 草稿模型:寫程式 153.8 tok/s、數學 134.9,散文 53.1。262K context、看圖、prefix cache 都在。附完整啟動指令和四個會卡住你的設定。
- 2026-09-21什麼!?Qwen3.8 27B 居然被壓到 5.9GB,跑起來能力居然有無損模型的 98.2%
PrismML 的 Ternary Bonsai 2 把 Qwen3.8-27B 壓成三值權重,官方說 5.9GB 保留 FP16 的 98.2% 能力。我在一張改裝 2080 Ti 22G 上跑同一組權重的 7.2GB 版:140 題拿 130,兩張卡跑 Q8_0 是 131。附編譯、啟動指令,以及為什麼最小那包反而最慢。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。