MiniMax-H3 on RTX 5090 · part 12
[AI Workflow] 真人舞蹈轉成深度影片,讓 MiniMax-H3 的古風角色在宮殿跳同一段舞:768 直接生成
❯ cat --toc
TL;DR
看到有人用真人舞蹈帶 AI 角色跟著跳,我想試 MiniMax-H3 能不能也做到,就用本機的一張 RTX 5090 跑了一次:Video Depth Anything 轉深度,Qwen-Image 把古風角色放進宮殿當第一格,Ref2VA 只給這一張場景圖,再用 AddGuide 釘在第 0 格。768×1376 直接生成 8.7 秒約 12 分鐘,補幀到 48fps。動作大致跟得上,但不是一格一格完全照跳。
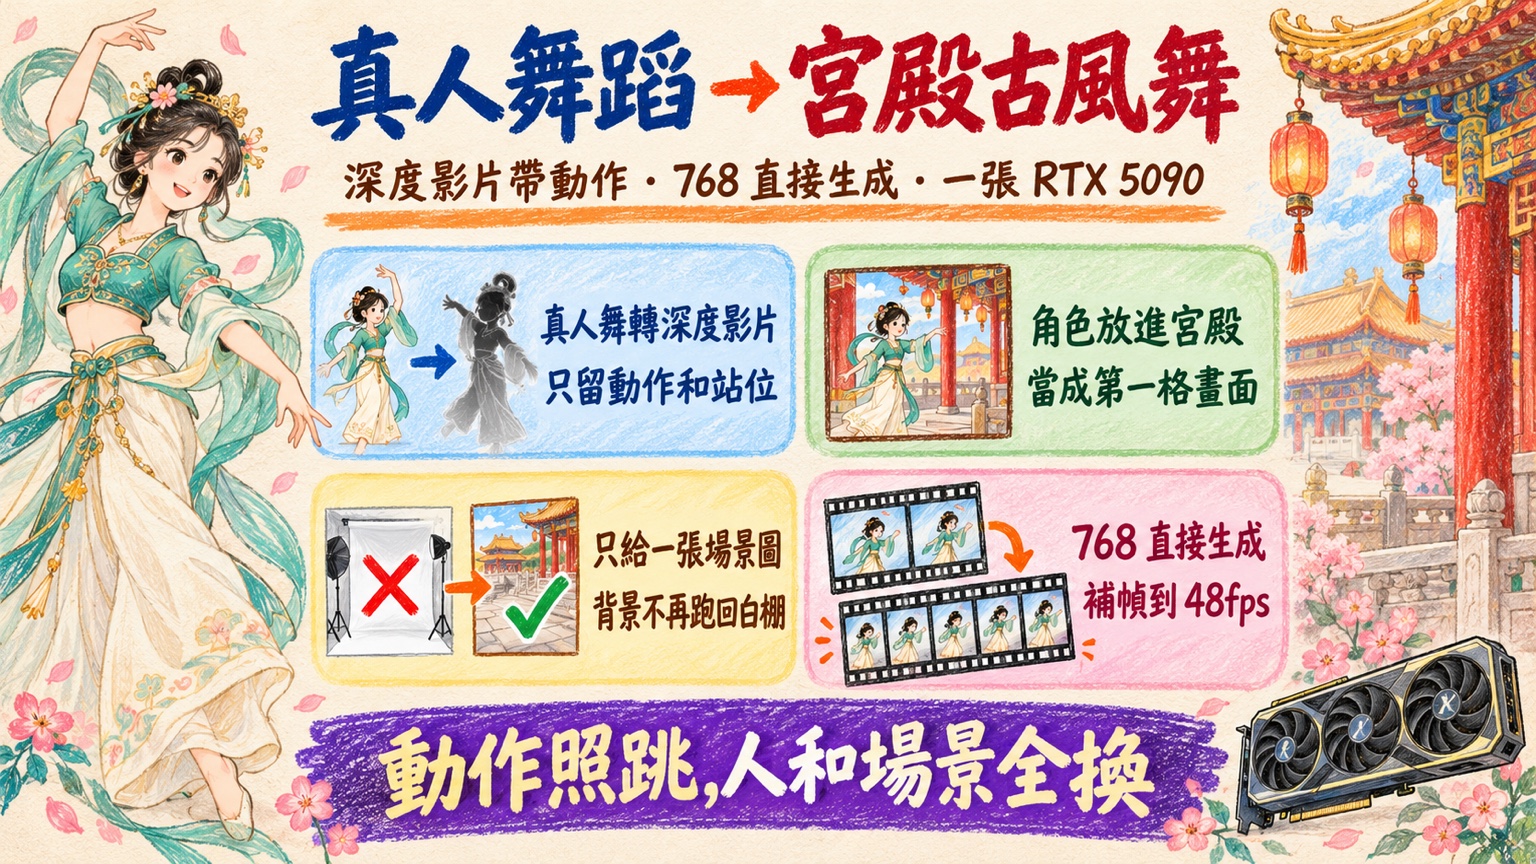
MiniMax-H3 在一張 RTX 5090 上以 768×1376 直接生成 8.7 秒,RTX 補幀到 48fps。動作來自一段真人舞蹈轉出的深度影片,角色和宮殿是 Qwen-Image 生的。配樂是我自己用 ACE-Step 生的曲子
前言
前幾天看到有人拿一段真人跳舞的影片,換成另一個角色、另一個場景跳同一段舞。我想試試看用 H3 能不能也做得出來。我的作法是先把舞轉成深度影片:深度影片只剩下遠近,長相、衣服、背景都被剝掉了,留下來的只有動作和站位。
這個作法看起來很適合 MiniMax-H3 的 Ref2VA。Part 9 我用 Blender 白模當參考影片,H3 會照著走位拍;那這次把白模換成真人舞蹈的深度影片,應該也能動。我想知道的是:本地一張 5090,能不能做出一支看得下去的古風宮殿舞。
結果做出來了,但中間背景跑回白棚兩次、有一發還整片變黑。下面先講做法,踩坑的過程放在後面的進階。
整條流程:深度影片帶動作,宮殿首幀定場景
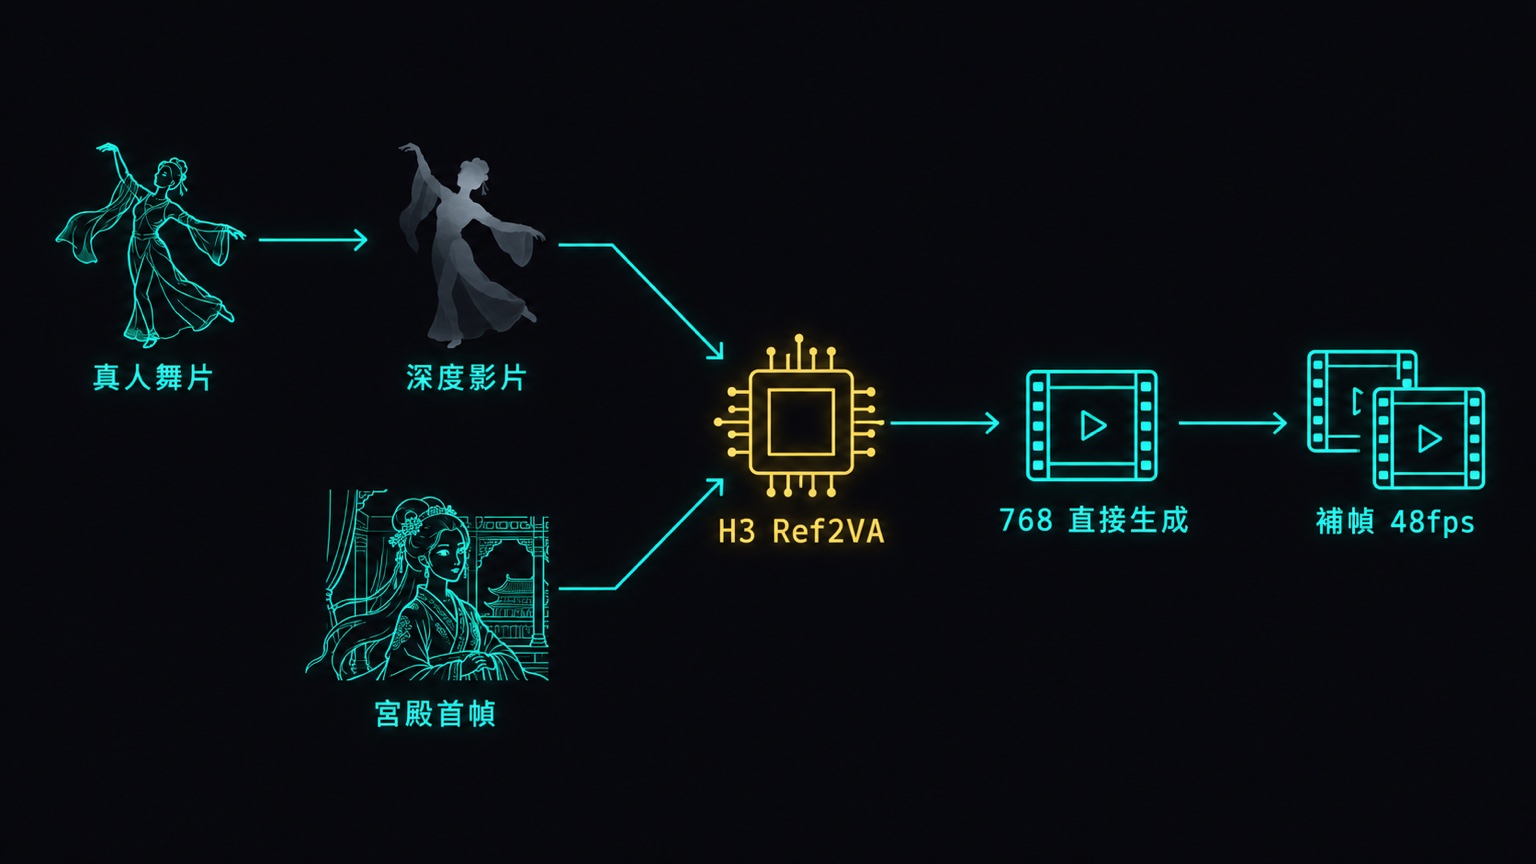
- 真人舞蹈片截一段,用 Video Depth Anything 轉成灰階深度影片
- Qwen-Image 生一個古風角色,再把她放進宮殿,姿勢對齊原片第 0 格,這張就是首幀
- H3 Ref2VA:參考影片給深度影片,參考圖只給首幀這一張
- 再接一個 AddGuide,把首幀釘在第 0 格
- 768×1376 直接生成,再用 RTX 補幀到 48fps
全部在 5090 的 ComfyUI 裡跑,只多裝了一個深度節點。
步驟一:截一段單人全身的舞,轉成深度影片
挑素材看三個條件:單人、全身入鏡含腳、鏡頭大致不動。我從一支 YouTube 上的 TikTok 舞蹈合輯截了 8.7 秒、209 格、24fps;合輯是三欄並排的,我只裁右邊那欄單人的畫面,等比補黑邊到 480×864,人沒有被拉變形。
深度節點用 yuvraj108c/ComfyUI-Video-Depth-Anything,底下是官方的 Video-Depth-Anything。裝之前先 pip install --dry-run 看過,它不會動 torch、torchvision、numpy 的版本,才直接裝進 ComfyUI;只新增了 easydict、imageio-ffmpeg、imath、opencv-python、OpenEXR 五個套件。
| 節點 | 設定 |
|---|---|
| LoadVideoDepthAnythingModel | video_depth_anything_vits.pth(Small) |
| VideoDepthAnythingProcess | input_size 518、max_res 864、fp16 |
| VideoDepthAnythingOutput | colormap gray |
它是整片共用同一組明暗範圍,不是每格各自拉亮暗,所以不會因為逐格調整而一格亮一格暗。209 格轉完約 11 秒。
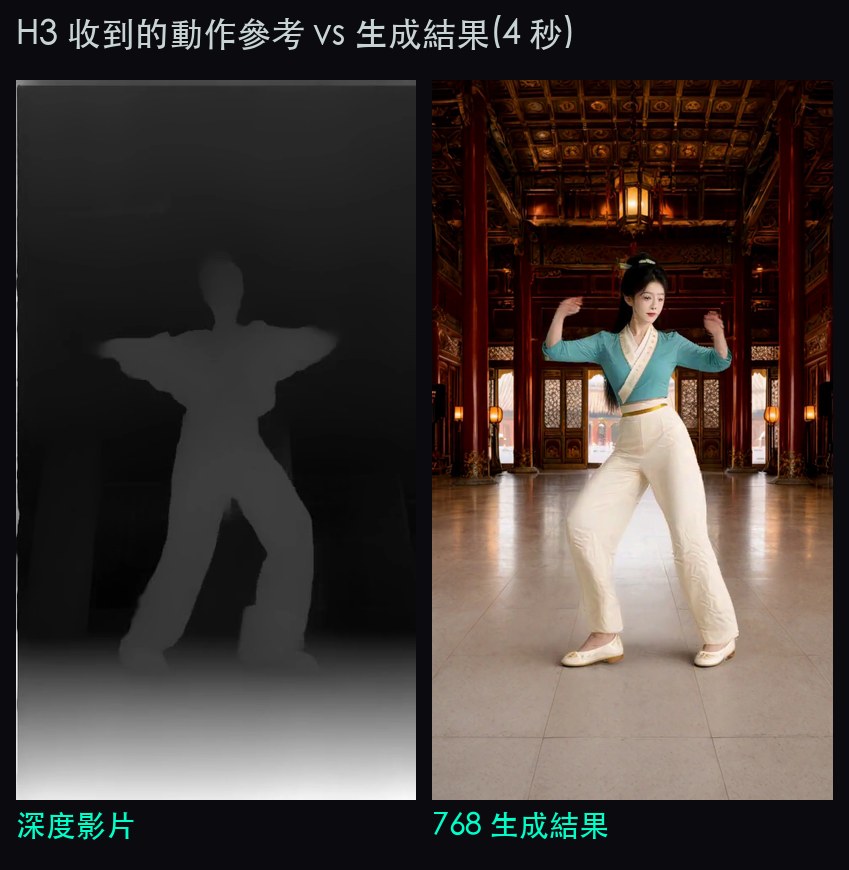
左起:原片、H3 收到的深度影片、生成結果。深度影片裡看不出原本舞者的長相和衣服,只剩動作
步驟二:角色穿褲裝,再放進宮殿當第一格
角色用 Qwen-Image 2.1 生。第一版我讓她穿長裙,生出來膝蓋整個被裙子蓋住,屈膝和左右換重心都看不出來,跳舞像在原地晃。改成短上衣加寬褲,兩條腿的輪廓出來,動作才看得出來。
角色圖生好之後,再做一張「她站在宮殿裡」的首幀。用 Qwen-Image 的多參考,一次餵三張:宮殿背景、角色圖、深度影片的第 0 格。提示詞寫明 Picture 1 是背景和鏡頭、Picture 2 是人、Picture 3 是姿勢,並描述人在畫面中央、頭頂和鞋底大約在哪個高度、手放在髖旁、兩腳一前一後。設定是 CFG 4、40 步(CFG 是要它多聽提示詞的強度,步數越多越細)。
這套流程裡我沒有把原片的彩色畫面餵給 Qwen-Image 或 H3(第一輪有一組對照刻意拿原片當參考,見進階),原片只拿來自己比對姿勢。對出來不是每個像素都對上,頭頂和鞋底跟原片差 10 到 16 像素左右,但站位、比例、手腳位置都接近,H3 接得上。
步驟三:Ref2VA 只給首幀這一張,再用 AddGuide 釘在第 0 格
這一步要讓 H3 同時知道兩件事:動作照深度影片跳,畫面從「她站在宮殿裡」那張圖開始。
Ref2VA 節點(MiniMaxH3ReferenceToVideo)負責第一件:它收參考影片和參考圖,但沒有「第一格要長這樣」的輸入。第二件要另外接一個 MiniMaxH3AddGuide,它會把一張圖指定成某一格的樣子,Ref2VA 收到的參考照樣有效。我把首幀指定在第 0 格,生成出來的第 0 秒就是那個構圖。
在 ComfyUI 裡的接法如下,每一行都是「左邊的東西拉一條線,接到右邊那個節點的輸入」。沒用過 ComfyUI 的話,這段照著接就好:
深度影片 ─→ Ref2VA.ref_videos
首幀     ─→ Ref2VA.ref_images(只放這一張)
Ref2VA.positive ─→ AddGuide(image=首幀, frame_idx=0) ─→ BasicGuider
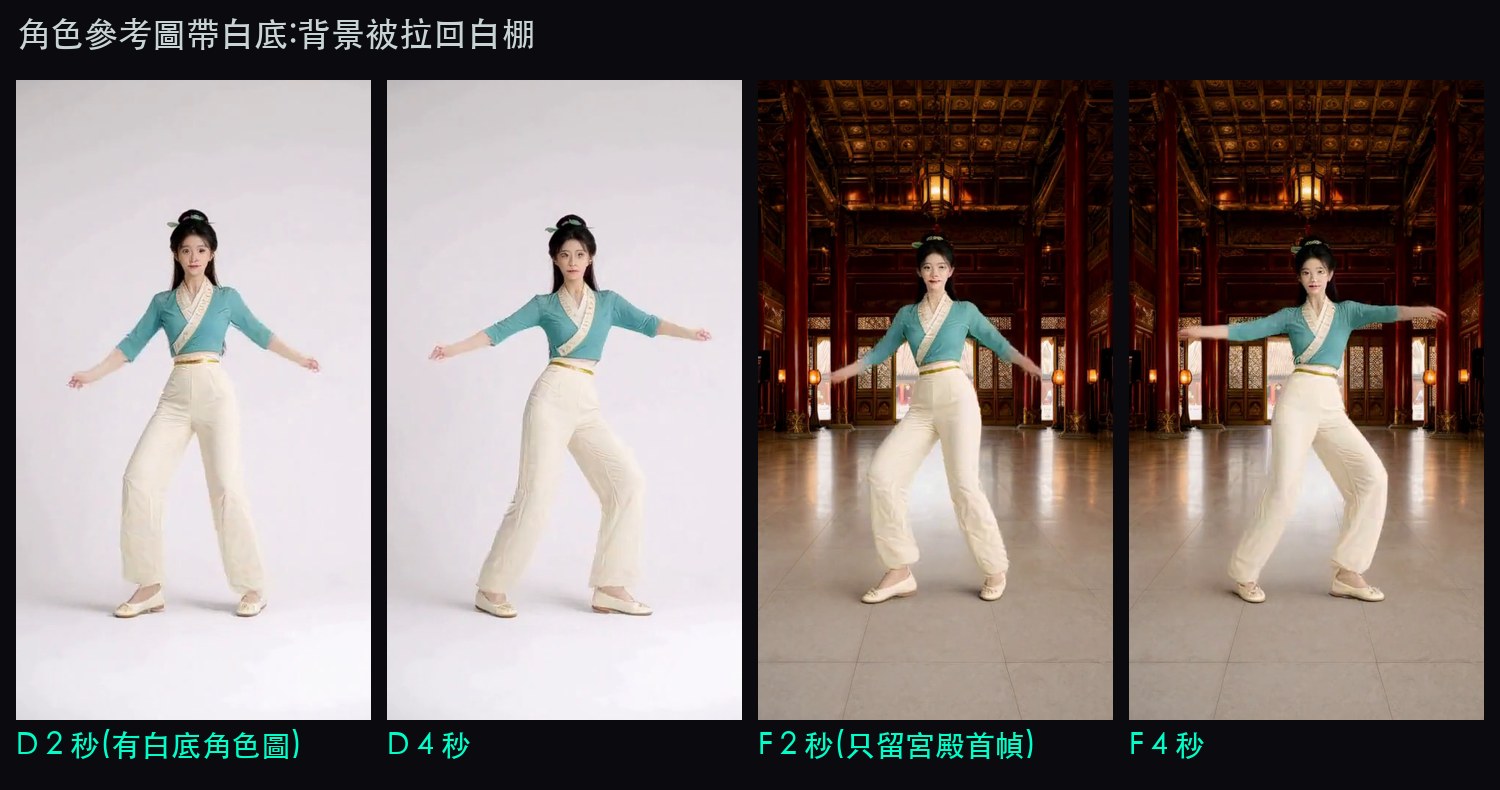
參考圖只能放首幀這一張。 我原本還多放了一張白底的角色圖,想讓臉和衣服更穩,結果 1.5 到 5.25 秒背景整個變成白色攝影棚,5.5 秒才回到宮殿。把白底那張拿掉、提示詞裡講它的那句也刪掉,同一個 seed 從頭到尾都是宮殿,臉和衣服也沒有走樣。
提示詞照 H3 的六段式寫。我只寫想要的東西:Picture 1 是第 0 格的宮殿畫面、Video 1 是整段動作和節奏、全程在同一座宮殿、鏡頭固定、屈膝和雙臂開合要明顯。不要提原片舞者或她的衣服,否定句也不要提。 第一輪我在否定句裡寫了「不要出現原本的衣服」,其中一發反而長出了原片那種綠色短外套。
其他設定沿用系列前幾篇:209 格、14 步、res_multistep / simple、seed 固定。seed 是生成時的隨機起點,同一個 seed、同一組設定會生出同一支片,換 seed 就是換一次抽籤;比較設定時固定它,才知道差異是設定造成的。
步驟四:一開始就用 768 生成,不要事後放大
我第一次交出去的版本是 480×864 生成,再用 RTX Video Super Resolution 放大到 1080×1944。畫面大了、邊緣乾淨了,但臉還是糊的,被當場打回來:應該一開始就用 768 生成。
改成 768×1376 直接生成,其他設定一個字都不動。寬 768 照原比例算高是 1382.4,H3 的畫布要是 32 的倍數,最接近的是 1376。同一個 seed 比臉:
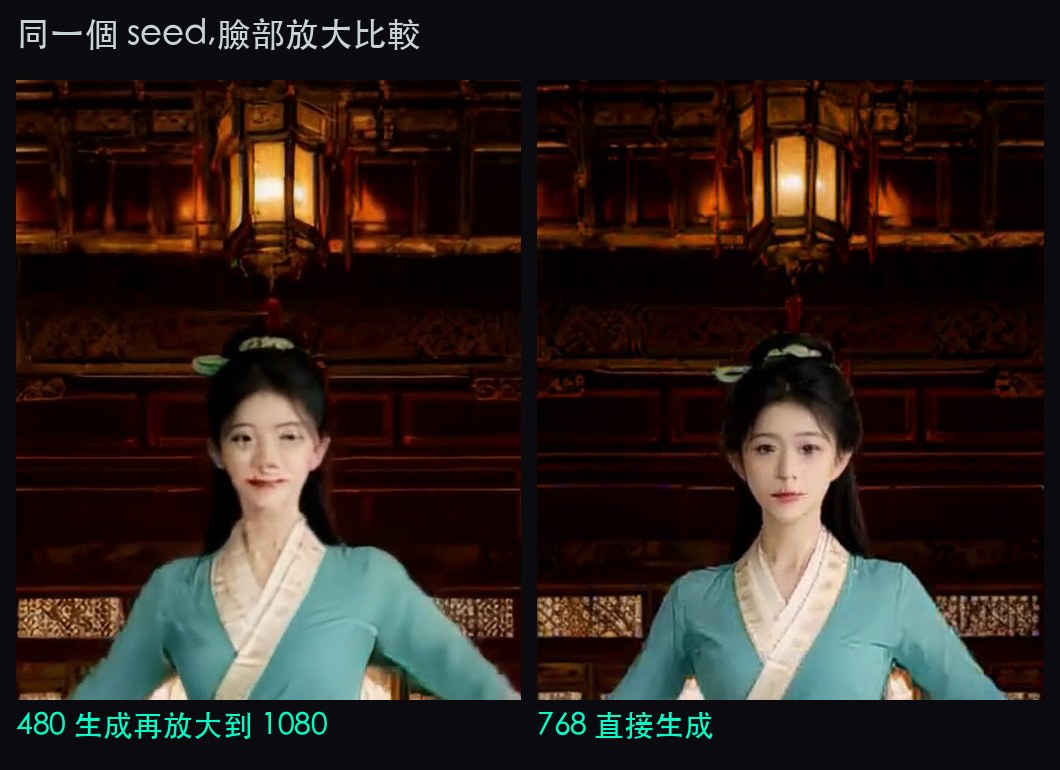
代價是時間和 VRAM。480×864 一發約 172 秒;768×1376 光是 H3 就約 12 分鐘(採樣 648.81 秒),VRAM 峰值 31,731 MiB,總量 32,607 MiB,差一點就滿了。
768 第一發在 3 秒後背景開始變暗,5 到 7 秒幾乎全黑。 H3 一生成出來就是黑的,跟補幀和壓縮無關。我只換了 seed(2026101801 換成 2026101902),其他一個字都沒改,第二發宮殿從頭到尾都在。
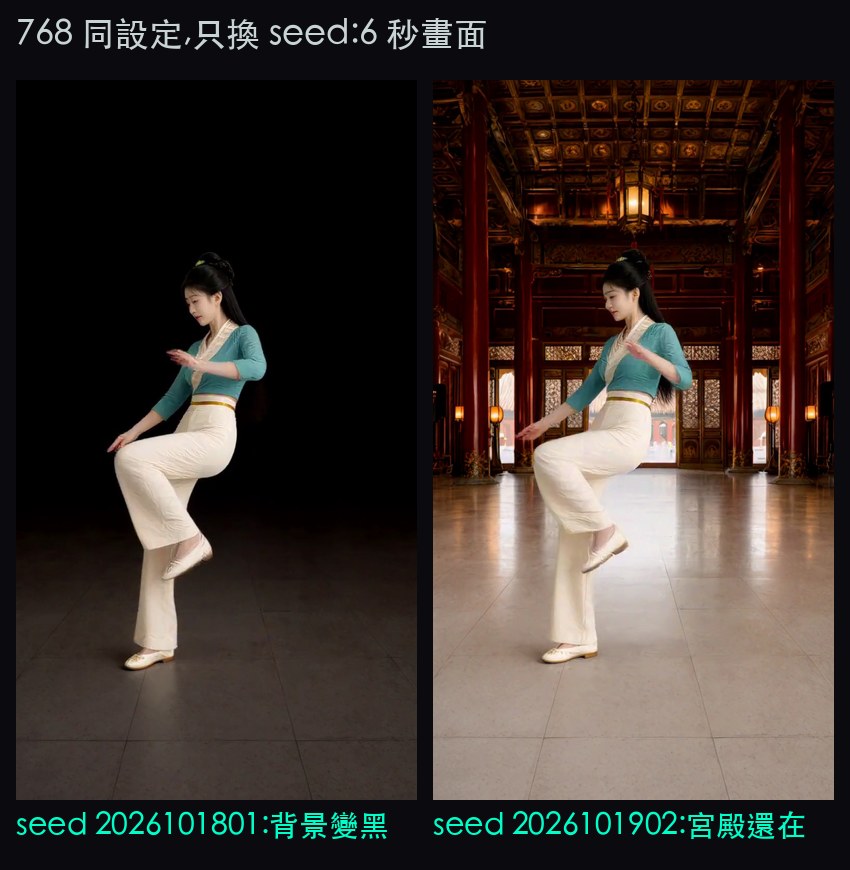
我只多試了一個 seed,不能保證每個 seed 都不會變黑。
步驟五:RTX 補幀到 48fps,存 PNG 自己壓
補幀用 Comfy 官方的 ComfyUI_Nvidia_VFX_Nodes,RTXVideoFrameGeneration 設 multiplier 2、mode MEDIUM。輸出是 2n−1 格,209 格補成 417 格,48fps 剛好 8.69 秒。
存檔不要用 ComfyUI 的 SaveVideo 預設。我第一次用它,1080×1944 的片只有約 3.9Mbps,暗部會有色塊。改成 SaveImage 存 417 張 PNG,拉回來用 ffmpeg 自己壓:
ffmpeg -framerate 48 -i frames48/%05d.png -i music.m4a \
  -c:v libx264 -preset slow -crf 15 -pix_fmt yuv420p \
  -c:a aac -shortest out.mp4
H3 會自己生一段音軌,但那是照它的理解生的環境音,我換成配樂。
還沒做到的
- 動作是大致跟,不是一格一格完全照跳。 屈膝、雙臂張開、側身抬膝這幾個大動作的時間點對得上,手臂角度和幅度還是有落差。
- 768 一發 12 分鐘,有一個 seed 會整片變黑,要多抽幾次就得多等。
- 只做了一段 8.7 秒、一個鏡頭固定的舞,鏡頭會動的素材還沒試。
進階:四輪試錯的完整紀錄
不讀這節不影響使用。這裡是每一輪改了什麼、看到什麼,數字都是那一輪的報告。每輪都是同一段 209 格素材、seed 2026101801、14 步,一個條件只跑一發,所以都是 n=1。
第一輪:角色圖加背景圖分開給,前 6 秒卡在白棚
第一輪用最直覺的接法,Ref2VA 給兩張參考圖:Picture 1 角色(白底全身)、Picture 2 宮殿背景,參考影片則用深度影片。同時跑了兩個對照:
| 組 | 參考影片 | 結果 |
|---|---|---|
| A | 深度影片 | 0 到 5.5 秒是角色圖的白棚,6 秒後才進宮殿;長裙遮膝,手臂多半朝下 |
| B | 原片彩色 | 跟 A 幾乎一樣,前段白棚、約 5.5 秒淡入宮殿 |
| C | 深度當 FunControl ControlNet | 多轉了好幾圈,2 到 4.5 秒長出橄欖綠外套和黑色下身,背景混進白色工業結構 |
B 這組是想看「直接拿原片當參考,原舞者的長相或衣服會不會被帶進來」。18 個半秒抽樣都沒看到原舞者的外套、眼鏡或工業背景。所以這組沒有證明深度影片比原片更能擋住原舞者的長相衣服跑進來。我最後還是用深度,是因為它本來就沒有原舞者的臉,發出去不用擔心。
C 用的是 H3 的 FunControl depth ControlNet(strength 0.7、end 0.8),結果反而更亂。它冒出的綠外套很像原片的衣服,但 C 根本沒收到原片的彩色畫面,而那一輪的提示詞否定句裡有寫原衣服的字。我沒有拆開驗證是哪個原因。
H3 時間:A 179 秒、B 172 秒、C 99 秒(伺服器端整段執行時間)。
第二輪:首幀接上了,中段還是跑回白棚
這輪一次改了三件事:角色改穿褲裝、做了宮殿首幀、提示詞完全不提原片舞者。接法是 Ref2VA(depth, ref_images=[首幀, 白底角色圖]) → AddGuide(首幀, frame_idx=0)。
先確認 H3 能不能同時吃首幀和參考影片。我直接讀 5090 上正在跑的 nodes_minimax_h3.py:Ref2VA 在 242 到 364 行,沒有 first_frame 輸入;AddGuide 在 165 到 239 行,會把圖編碼後寫進 minimax_keyframes,不動原本的參考。model_base.py 2188 到 2219 行同時讀 keyframes 和 refs,所以兩條路是真的接得起來,不是看節點名稱猜的。
結果(D):0、0.25、0.5 秒是宮殿,首幀有生效;0.75 秒開始泛白,1.5 到 5.25 秒是白棚,5.5 秒回宮殿。動作比 A 清楚很多:1.5 秒看得到屈膝和胸前交叉手臂,4 秒雙臂接近水平張開,6 秒側身抬膝對得上原片。
AddGuide 是條件引導,不是把第 0 格像素直接貼上去。D 的第 0 格跟首幀的 RGB 平均差約 8.3/255,構圖目視一樣。
第三輪:拿掉白底角色圖,全程宮殿
懷疑白棚是白底角色圖在跟宮殿搶背景,這輪只改一件事:Ref2VA 的 ref_images 拿掉角色圖,只留首幀;提示詞刪掉描述 Picture 2 的那一句。
結果(F):1 到 6 秒每 0.25 秒抽樣、加上 1 到 6 秒連續 121 格的縮圖,全部是宮殿。量畫面上方不含舞者的建築區域裡 RGB 都大於 180 的亮像素比例,F 是 0.068% 到 0.099%,D 最高到 98.3%。臉和服裝靠首幀就保住了,動作也沒有比 D 差。H3 一發 168.658 秒。
看來確實是白底參考圖在搶背景,但這是同 seed 一發的結果,不能證明換場景、換 seed 都成立。
第四輪:480 放大 vs 768 直接生成
F 是 480×864。第一次交出去的版本我用 RTXVideoSuperResolution(ULTRA、target 1080×1944)放大,再補幀到 48fps,被打回來之後改 768。
768×1376 那一發的細節:
| 項目 | 數字 |
|---|---|
| latent shape | [1, 24, 62, 86, 48] |
| H3 採樣 | 648.81 秒 |
| 條件準備+採樣+解碼 | 717.65 秒 |
| 含 209 張 PNG、RTX 補幀、417 張 PNG 存檔 | 747.76 秒 |
| VRAM 峰值 | 31,731 / 32,607 MiB(每 2 秒抽一次 nvidia-smi,含桌面占用) |
nodes_minimax_h3.py 裡 CANVAS_MULTIPLE=32,Ref2VA 照你給的寬高直接建 latent。另外有一個 adapt_canvas 的 768×1344 面積上限,但它只管參考影片的預處理縮放,不限制生成尺寸;深度影片我先用 lanczos 放到 768×1376 再上傳,H3 內部照規則重採樣。首幀用 RTX Super Resolution 放到 768×1376。
背景變黑那一發,畫面上方 300 列的平均 RGB 亮度(0–255):
| 秒 | 480 的 F | 768 seed 2026101801 | 768 seed 2026101902 |
|---|---|---|---|
| 4 | 17.42 | 2.71 | 19.01 |
| 6 | 17.42 | 0.00 | 19.11 |
| 8 | 17.47 | 0.28 | 19.02 |
換 seed 那一發 417 張補幀後的 PNG 也全部量過,最低 18.78(3.04 秒),沒有短暫變黑。這個指標只是 RGB 算術平均,拿來佐證「有沒有變黑」,不是畫質分數。
相關
常見問題
- MiniMax-H3 的 Ref2VA 沒有首幀輸入,要怎麼指定第一格畫面?
- 接一個 MiniMaxH3AddGuide。Ref2VA 節點只收參考圖和參考影片,沒有 first_frame;AddGuide 會把一張圖經 VAE 編碼後,掛在你指定的 frame_idx 當關鍵影格,原本的參考條件照樣保留。我把角色站在宮殿裡的那張圖接在 frame_idx=0,生成第 0 秒就是那個構圖。
- 用深度影片帶 H3 跳舞,為什麼背景一直跑回白色攝影棚?
- 因為參考圖裡有一張白底的角色圖。我同時給「角色站在宮殿裡的首幀」和「白底角色圖」時,1.5 到 5.25 秒背景變成白棚;把白底那張拿掉、只留宮殿首幀,同一個 seed 從頭到尾都是宮殿。臉和服裝靠首幀就保得住。
- 480 生成再放大,跟一開始就用 768 生成差多少?
- 差在臉。我把 480×864 的成品用 RTX Video Super Resolution 放到 1080×1944,畫面變大、邊緣變乾淨,但五官還是糊的;改成 768×1376 直接生成,同一個 seed 的眉眼、鼻樑、唇線和領口金邊都分得出來。
- 在 RTX 5090 上用 H3 生 8.7 秒 768×1376 要多久?
- H3 本身約 12 分鐘(採樣 648.81 秒,含條件準備與解碼 717.65 秒),加上 RTX 補幀和存 PNG 整段約 12.5 到 12.8 分鐘。VRAM 峰值 31,731 MiB,總量 32,607 MiB,很貼頂但沒有 OOM。480×864 同設定只要約 172 秒。
- H3 生到一半背景變黑是什麼原因?
- 我遇到的那次是 seed 的關係。768×1376 第一發在 3 秒後宮殿變暗、5 到 7 秒幾乎全黑;只換 seed、其他一個字都沒改,第二發 4、6、8 秒畫面上方的平均亮度都在 19 左右,宮殿從頭到尾都在。只試了一個新 seed,不保證每個 seed 都不會變黑。
接著讀
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
- 2026-09-06[Benchmark] 兩張人設圖餵進去,讓小販跟書生自己演完自相矛盾:MiniMax-H3 Ref2VA 入門
Ref2VA 是 H3 唯一吃得下多張參考圖的模式。用兩張 z-image 人設圖生一段 10.1 秒的雙角色對話,台詞 ASR 逐字比對 CER 6.8%,三個錯字全是同音字。含六段格式全文與節點接線。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。