MiniMax-H3 on RTX 5090 · part 13
[MiniMax-H3] 用 16 格分鏡讓本地 H3 演出場景可行嗎?分鏡管構圖、角色圖管長相、時間軸管順序
❯ cat --toc
- 前言
- 結論:分鏡表管構圖,角色圖管長相,文字時間軸管順序
- 步驟一:用 ChatGPT 生分鏡表,每格寫運鏡、畫面、導演三行
- 步驟二:角色設定圖另外生,拿分鏡表當參考
- 步驟三:把 16 格拆成逐格時間軸,照官方鏡頭表格式寫
- 步驟四:接 Ref2VA,Picture 1 給分鏡表、Picture 2 給角色圖
- 哪種做法不行:一句話、只給文字、分鏡表上的字
- 進階:七組完整紀錄
- 七組結果表:一句話 2–3 格,逐格時間軸 12–14 格
- 一句話為什麼只有兩三格
- S2 和 S4:逐格抄成時間軸,就跳到 12–14 格
- S5c:切格塞 Continuum,每段至少 4 秒、全片只有 9 個槽
- S6 跟 S4 比:哪幾格變好、哪幾格變差
- S6 實際送出的英文 prompt 節錄
- 坑一:Autogrow 參考圖寫成巢狀 dict,會被靜默忽略
- 坑二:`codex exec -i` 會把 prompt 吃成第二張圖
- 這次測試的邊界
- 相關
TL;DR
看到 IG 上有人用 GPT Image 2 生一張 16 格分鏡表,配一句話丟給線上的 Seedance 2.0 就拍出照分鏡走的影片,我想試本地的 MiniMax-H3 能不能照做。直接丟分鏡表加一句話,只對上 3/16 格。把分鏡照官方鏡頭表的格式拆成逐格時間軸、再配一張角色圖,RTX 5090 跑 339.9 秒拍出 10 秒片,16 格對上 13 格。分鏡表管構圖,角色圖管長相,文字時間軸管順序和道具狀態。只跑了一個 seed、一個故事。
MiniMax-H3 Ref2VA 在一張 RTX 5090 上生成的 10 秒片,1344×768、24fps。參考圖只有兩張:ChatGPT 生的 16 格分鏡表和角色設定圖;prompt 是照官方鏡頭表格式寫的逐格時間軸
前言
前幾天在 IG 滑到一支 Reel:創作者用 GPT Image 2 生了一張 16 格分鏡表,每一格自己就帶著運鏡標註、畫面說明和導演批註;影片的 prompt 只寫一句話,整張丟給線上 Seedance 2.0 的「全能參考」,生出來的片真的一格一格照分鏡走。他還提醒兩件事:角色要另外給一張單人參考圖,因為 16 格裡每個人都太小;模式別選「首尾幀」。
我想知道的是,自己 5090 上的本地 MiniMax-H3 能不能也這樣做,不用花錢買點數。H3 的 Ref2VA 本來就吃參考圖(Part 6 拿它讓兩個角色演完一齣戲),分鏡表也是一張圖,照理說丟得進去。
結果第一發就卡住:分鏡表加一句話,H3 只對上 2/16 格,換成 ChatGPT 生、每格都寫滿字的分鏡表,也只有 3/16。我猜線上服務在那一句話背後多做了一層,本地 H3 沒有這一層,要自己補(Seedance 那邊我沒有實測)。我的猜測是「全能參考也只是把分鏡拆成描述而已」,那我照 MiniMax 官方的格式自己拆,應該會更準。這篇就是驗這句話。
結論:分鏡表管構圖,角色圖管長相,文字時間軸管順序
同一張 ChatGPT 分鏡表、同一張角色圖、同一個 seed,只換 prompt 的寫法。這表看最後一欄:
| 組 | prompt 怎麼寫 | 16 格對上幾格 |
|---|---|---|
| S3 | 一句話(「依照分鏡表 16 個鏡頭順序拍成一支短片」) | 3/16 |
| S4 | 逐格抄分鏡表上的運鏡和畫面 | 12/16 |
| S6 | 照官方鏡頭表格式,每格寫動作、運鏡、位置、聲音和交接 | 13/16 |
「對上」的算法:那一格的主要構圖和動作有出現、而且順序跟前後格接得上才算,只對一半不算。
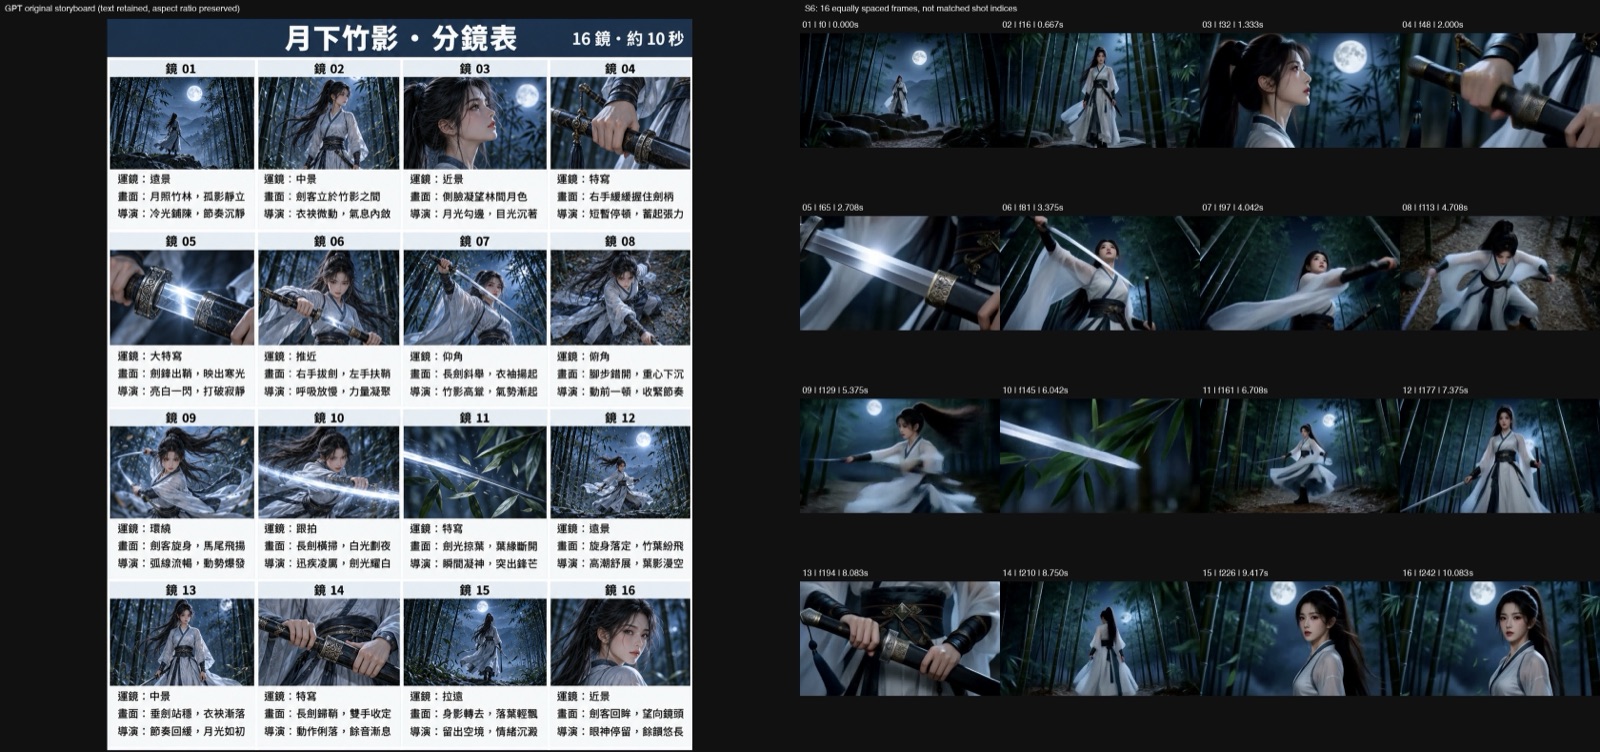
一句話跟逐格時間軸差在順序。H3 會從分鏡表拿人物、服裝、色調和姿態,但不會自己把 4×4 網格切成 16 個時間點;你得在文字裡告訴它第幾秒是哪一格、那一格結束時人和劍是什麼狀態。左邊一句話、右邊官方格式,同一張分鏡表:
左:S3,分鏡表加角色圖,prompt 只有一句話。右:S6,同樣兩張圖,prompt 照官方鏡頭表格式逐格寫。並排無聲
下面照順序講怎麼做。
步驟一:用 ChatGPT 生分鏡表,每格寫運鏡、畫面、導演三行
我第一輪是用 Qwen-Image 生分鏡表,格內只放格號和一個短運鏡詞。後來改用 ChatGPT(gpt-image),因為它塞得下每格三行繁中小字,而且全部讀得出來。這次沒看出這些字對 H3 有幫助,我把它們當成給你自己、或幫你寫時間軸的模型看的;下一步要照著它抄。
我給 ChatGPT 的 prompt 長這樣(節錄,不用照抄,講清楚格數、每格要寫什麼、起承轉合怎麼分就好):
主題:電影分鏡表,月夜竹林,一位古風成年女劍客(黑長髮束高馬尾、月白交領長衫、墨青腰帶、細長直劍)。
故事約 10 秒:靜立 → 拔劍 → 旋身 → 劍光掃過竹葉、竹葉紛飛 → 收劍 → 回望鏡頭。

版面:直式整頁分鏡表,4 列 × 4 欄共 16 格,每格 16:9 畫面。每格上方小標「鏡 01」到「鏡 16」,
每格下方三行小字(繁體中文):
第 1 行「運鏡:」接一個運鏡詞(遠景、中景、近景、特寫、大特寫、推近、拉遠、環繞、仰角、俯角、跟拍、定格)
第 2 行「畫面:」接一句動作描述
第 3 行「導演:」接一句批註(節奏、光線、情緒)
16 格要有起承轉合:前 4 格建立場景與人物、5–8 格拔劍蓄勢、9–12 格旋身與劍光高潮、13–16 格收劍回望與餘韻。
運鏡要有變化,不要連續三格同景別。

文字要求:所有字為繁體中文、清晰可讀;格內畫面裡不要出現文字。
避免:格數不是 16、人物在不同格換臉換衣服、文字溢出格框、手指與劍柄畸形。
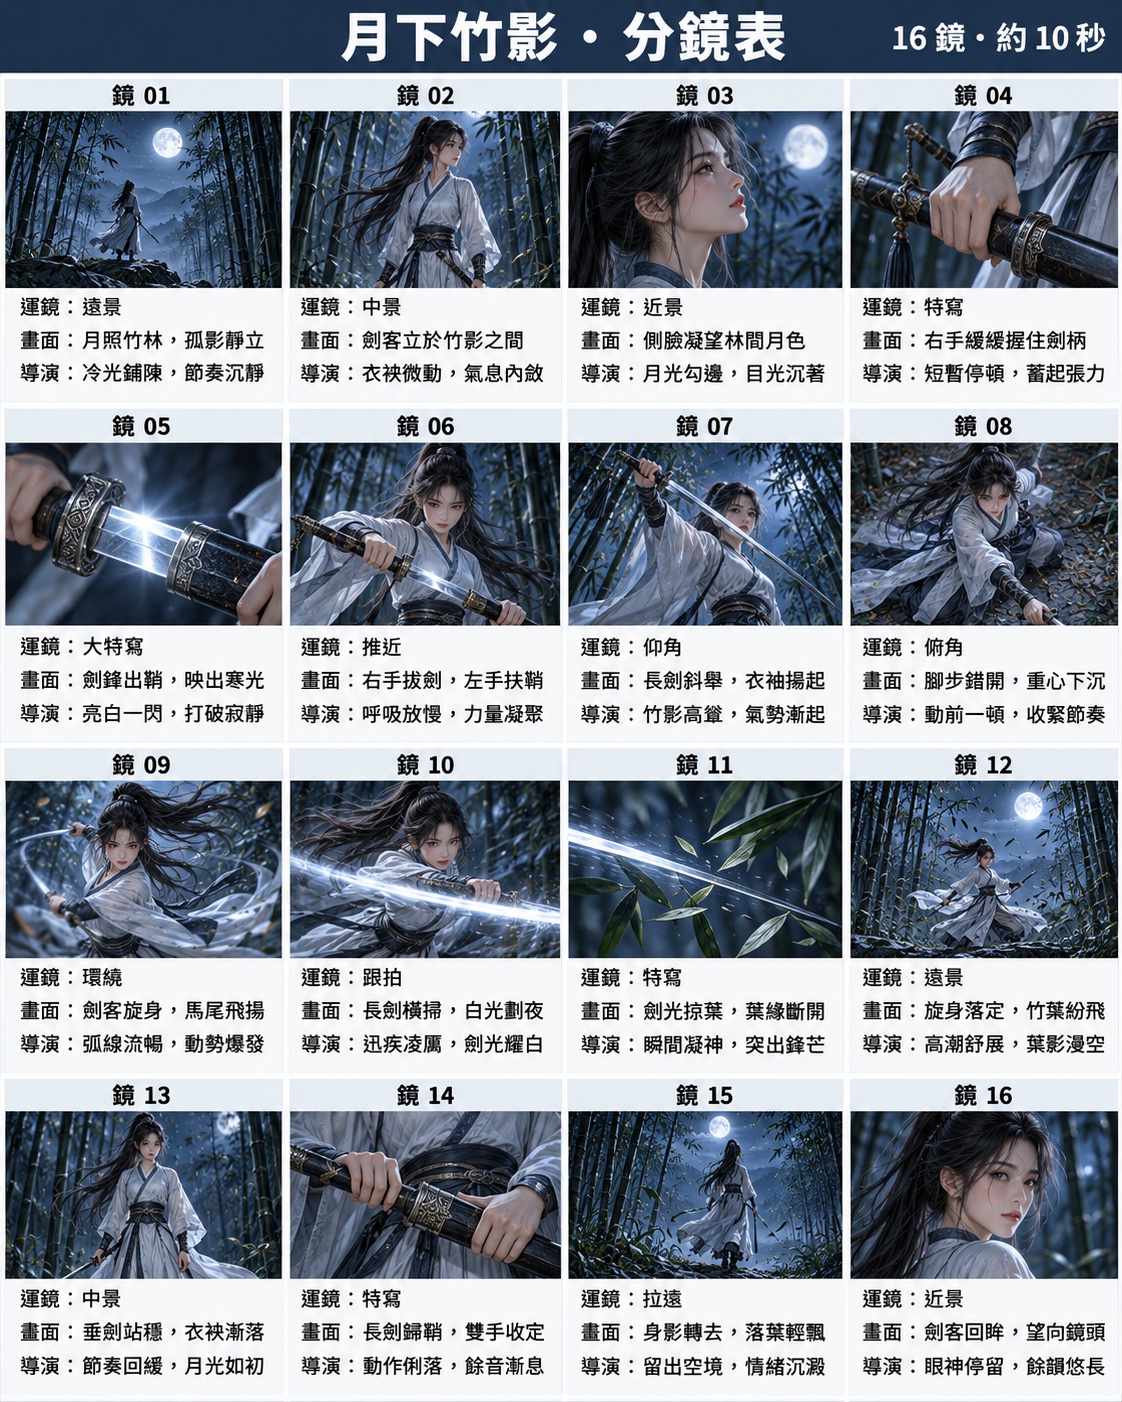
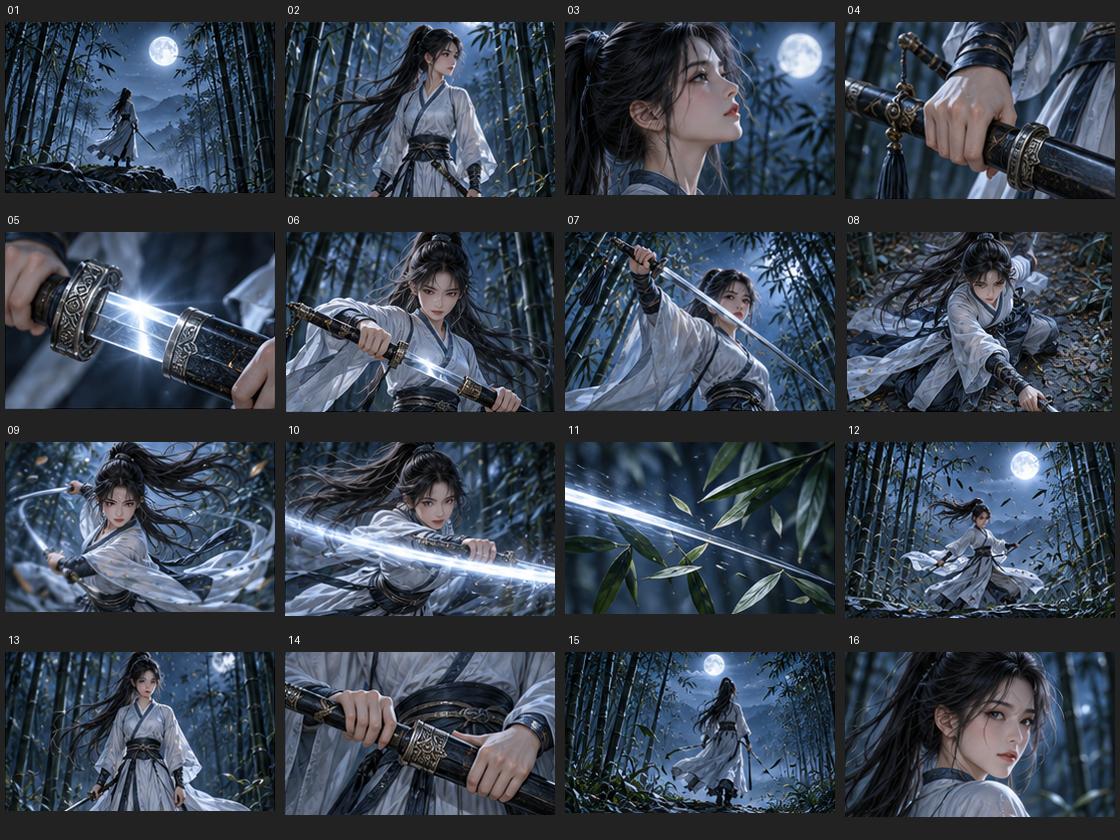
出來是 1122×1402、16 格,每格三行字都清楚,格內畫面也沒有字。
步驟二:角色設定圖另外生,拿分鏡表當參考
16 格塞在一張圖裡,每個人都很小。H3 會把參考圖縮到跟輸出差不多的尺寸,以正方形的分鏡表來說大約是 1024×1024,切成 4×4 之後每格只剩約 256×256,臉根本看不清楚。所以跟 Seedance 那邊一樣,角色要另外給一張。
我讓 ChatGPT 拿剛才那張分鏡表當參考圖,生同一個人的角色設定圖(一樣不用照抄):
參考附圖分鏡表裡的女劍客,做她的「角色設定圖」,臉、髮型、服裝必須和分鏡表同一人。

版面:橫式 16:9,淺灰白底,左側三個全身視角(正面、四分之三側、背面)並排,右上一張臉部特寫,
右下一列配件分解(直劍連劍鞘、墨青腰帶、髮帶),最下方一條色票(月白、墨青、黑、銀)。
避免:多個視角臉不一樣、服裝前後不一致、多出手指、背景雜物、浮水印。
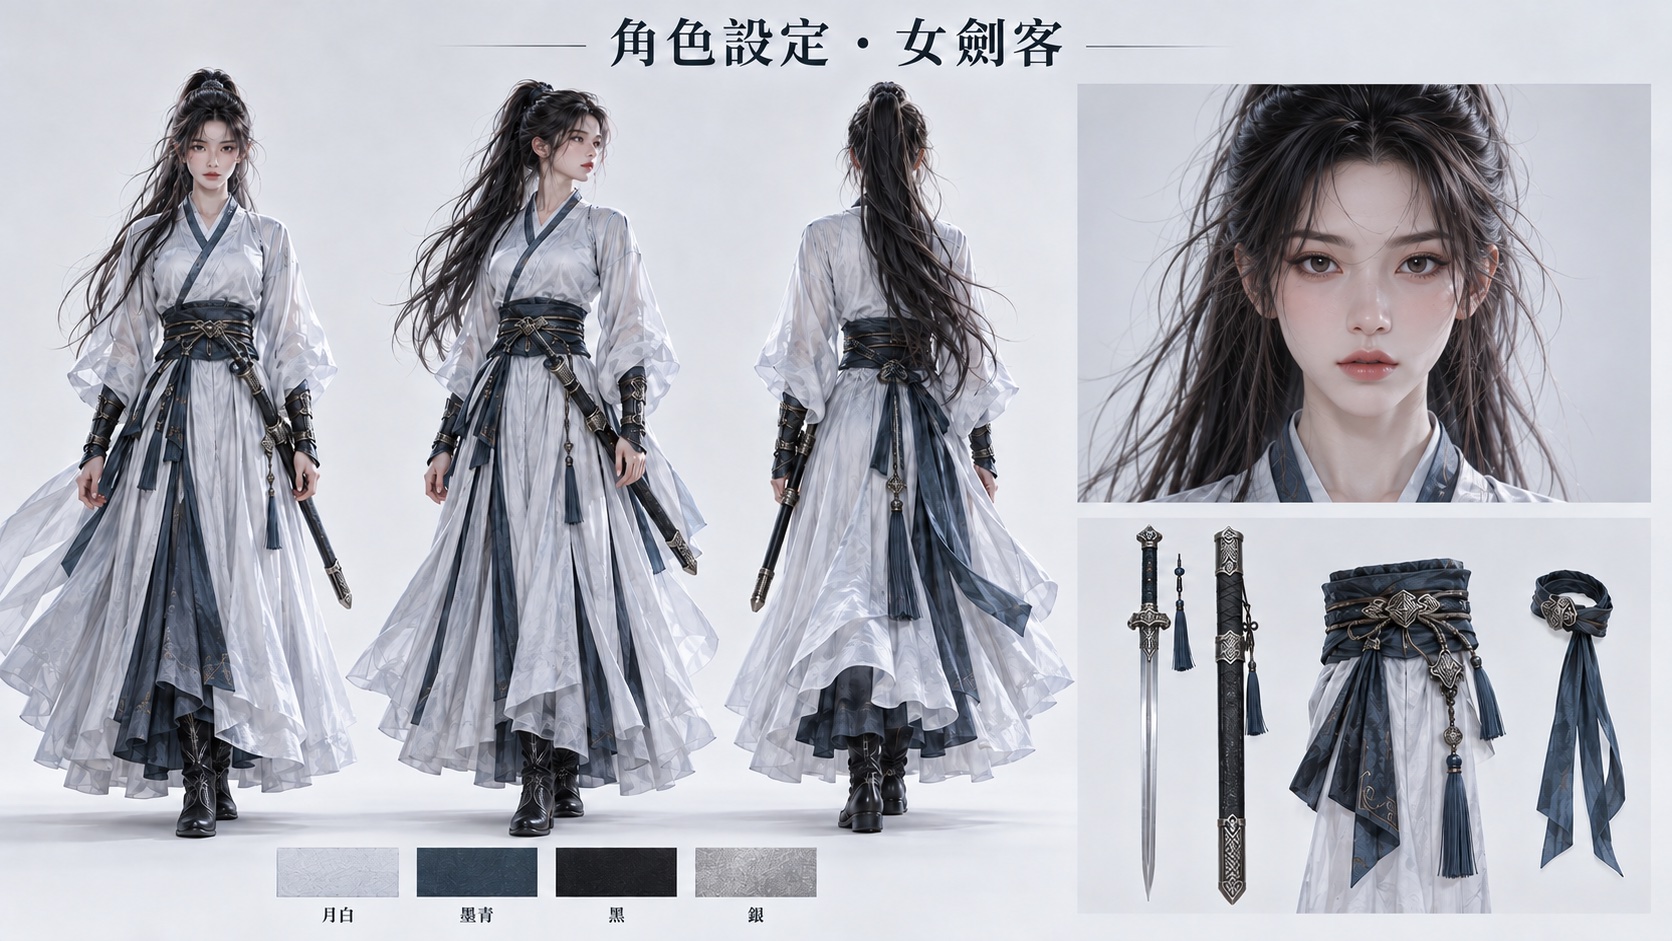
出來是 1672×941,三個視角加臉部特寫,跟分鏡表是同一個人。只有一個小差:角色圖多畫了一雙黑靴,分鏡表裡腳大多被衣襬遮住。拍出來沒差。
步驟三:把 16 格拆成逐格時間軸,照官方鏡頭表格式寫
這一步就是線上服務幫你做掉的那一層。MiniMax 官方 repo 裡 H3 的短片 skill 有一份鏡頭表規格 shot-table-spec,搭配同目錄的 storyboard-guidelines 一起看,講得很明白:一切以文字分鏡為準,分鏡圖是每個鏡頭一張、每秒一格,主要是給人審的。也就是說,官方本來就沒打算讓模型自己看圖猜順序。
規格裡每個鏡頭要寫五件事:
- 動作、姿勢、表情
- 運鏡
- 人在畫面的哪裡
- 聲音
- 交接:這一格結束時是什麼狀態,下一格從哪裡接
再加上前後兩個方向的交接說明,和一組固定錨點(不會動的地標、人的位置和朝向、光從哪來)。
我沒有自己一格一格寫,是叫一個會看圖的 AI 模型(我用的是自己機器上跑的本地模型)讀整張分鏡表,外加四張按列放大的裁圖,照這份規格把 16 格填成鏡頭表。第一輪它把繁中字讀成英文、還漏了欄位,第二輪要它照繁中原文補齊。你用 ChatGPT 或其他看得懂圖的模型做一樣,重點是一定要自己再看一遍,我手動改了五處:
- 左手右手寫反的地方改掉
- 第 6 格補上「正面中景」
- 第 8 格補上「重心下沉」
- 第 13 格原本寫「已入鞘或垂劍」,模稜兩可,改成「垂著出鞘的劍」
- 第 15 格原本寫人「消失」,改成「背影還在」
最後兩條都是道具和人的狀態。模型給的描述只要留了兩種可能,H3 就可能兩種都拍,或拍錯順序。
鏡頭表寫好之後,要轉成 H3 看得懂的 prompt。為什麼要這麼麻煩?因為 H3 不會看圖排順序,它只照文字走,所以要把「第幾秒拍什麼」一條一條寫給它,像拍片用的劇本。
這一步也可以直接叫看圖模型做。我給它的要求大概是這樣,不用照抄,講清楚要什麼就好:
讀這張 16 格分鏡表,照由左到右、由上到下的順序,把每一格寫成一段:
從第幾秒開始、拍什麼景、人在做什麼、鏡頭怎麼動、這一格結束時人和劍是什麼狀態。
第一張圖是分鏡表,第二張圖是角色長相。看不清楚的地方寫「看不清楚」,不要自己編。
寫成 prompt 之後長這樣,拿第 13、14 格當例子(我實際送的是英文,這裡翻成中文好讀,英文原文放在進階):
第一張圖是 4×4 分鏡表,由左到右、由上到下對應鏡 1 到鏡 16;第二張圖只管女劍客的長相。

鏡 13|從 7.594 秒開始|中景|女劍客站穩,劍尖朝下,衣袖慢慢落下|鏡頭不動
  結束時:她垂著出鞘的劍站好,準備收劍。
鏡 14|從 8.227 秒開始|大特寫|雙手把劍平順地收進鞘裡
  結束時:劍完全入鞘,手放在劍柄和劍鞘上。從這格之後到最後一格,劍都在鞘裡。
一樣不用照抄。要講清楚的只有三件事:
- 哪張圖管什麼:Picture 1 是分鏡表、照列由左到右對應 Shot 1 到 16;Picture 2 只管長相。
- 每格從第幾秒開始:像上面的「從 7.594 秒開始」
- 每格結束時人和道具的狀態:尤其是劍出鞘還是入鞘。我在總述裡多寫了一句「第 14 格之後劍一直在鞘裡」,就是為了擋入鞘後下一鏡又冒出裸劍。
時間怎麼算:10.125 秒除以 16 格,每格 0.633 秒。官方 repo 裡做 MV 的另一個 skill 是用每鏡 2 到 5 秒在接片,我這次是刻意塞爆、看它極限在哪。你自己做的話,10 秒放少一點格,應該會更好對。
步驟四:接 Ref2VA,Picture 1 給分鏡表、Picture 2 給角色圖
最後把兩張圖和這份 prompt 一起交給 H3。H3 的參考圖節點叫 Ref2VA,沒裝過的話,Part 6 有從頭接一次的過程。ComfyUI 的接法:
分鏡表   ─→ Ref2VA.ref_images 第 1 張(Picture 1)
角色圖   ─→ Ref2VA.ref_images 第 2 張(Picture 2)
逐格 prompt ─→ Ref2VA.prompt
Ref2VA.positive ─→ BasicGuider ─→ SamplerCustomAdvanced
參考圖的順序要跟 prompt 裡的 <Picture 1>、<Picture 2> 對上。ref_image_size 設 match,參考圖會縮到跟輸出差不多大。
會影響結果的設定:
| 項目 | 設定 |
|---|---|
| 模型 | minimax_h3_ref2va_pruned_nvfp4.safetensors,文字編碼器 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
| 輸出 | 1344×768、24fps、243 幀(10.125 秒),video 和 audio VAE 都接,會生音軌 |
| 採樣 | 14 步、res_multistep / simple、shift video 12 / audio 3、BasicGuider |
| seed | 20261025,所有組別都一樣 |
這一發在 5090 上 ComfyUI 端 339.9 秒。
如果你是用 API 送 workflow,不是在畫面上拉線,參考圖的寫法有個坑:巢狀寫法會被靜默忽略、不報錯,片照樣生得出來,只是沒吃到參考圖。正確寫法和我怎麼發現的放在進階。
哪種做法不行:一句話、只給文字、分鏡表上的字
- 分鏡表加一句話:2/16、3/16。整支片在差不多的景別裡反覆旋身,沒有開場遠景,也沒有收劍回望。那一招是給線上服務用的,本地 H3 沒有幫你拆分鏡的那一層。
- 指望 H3 讀分鏡表上的字:ChatGPT 版每格三行繁中,Qwen 版只有短詞,一句話的結果差不多,都是兩三格。好消息是三組都沒有把格線、格號或文字畫進畫面。
- 只給文字時間軸、不給參考圖:順序對得不錯(12/16),但人換了臉也換了髮型。只要有給角色圖的組別,人物的整體造型都保住了,臉的細節略有差異,目前沒看到人物崩掉。
另外我也試過把分鏡表切成單格、用 Continuum 分段餵關鍵格,結果是 13/16,跟整張分鏡表一樣,還多了一個 8 秒處的硬切,這次不值得多花那個功夫,細節放在進階。
S6 那 13 格以外,沒對上的是第 2 格(中景拍成了全身遠景)、第 6 格(正面拔劍有改善,但頭被切掉,不算)和第 12 格(還是沒有竹葉紛飛)。
進階:七組完整紀錄
不讀這節不影響使用。這裡是七組各自改了什麼、看到什麼,給想深追或要把整篇丟給 AI 參考的人。全部組別都是同一個 seed(20261025)、同一個故事、各跑一發。
七組結果表:一句話 2–3 格,逐格時間軸 12–14 格
| 組 | 輸入 | 對上 | ComfyUI 秒數 |
|---|---|---|---|
| S0 | 純文字時間軸,不給參考圖 | 12/16 | 301.5 |
| S1 | Qwen 分鏡表+Qwen 定裝圖,一句話 | 2/16 | 326.3 |
| S2 | Qwen 分鏡表+定裝圖+完整時間軸 | 14/16 | 332.7 |
| S3 | ChatGPT 分鏡表+ChatGPT 角色圖,一句話(與 S1 同一句) | 3/16 | 324.3 |
| S4 | ChatGPT 分鏡表+角色圖+16 格時間軸(逐格抄運鏡和畫面) | 12/16 | 325.7 |
| S5c | 16 格切開,挑 8 張關鍵格+角色圖,Continuum 三段各 4 秒、Per chunk | 13/16 | 378.5(12 秒片) |
| S6 | 同 S4 的輸入,prompt 改照官方鏡頭表規格寫 | 13/16 | 339.9 |
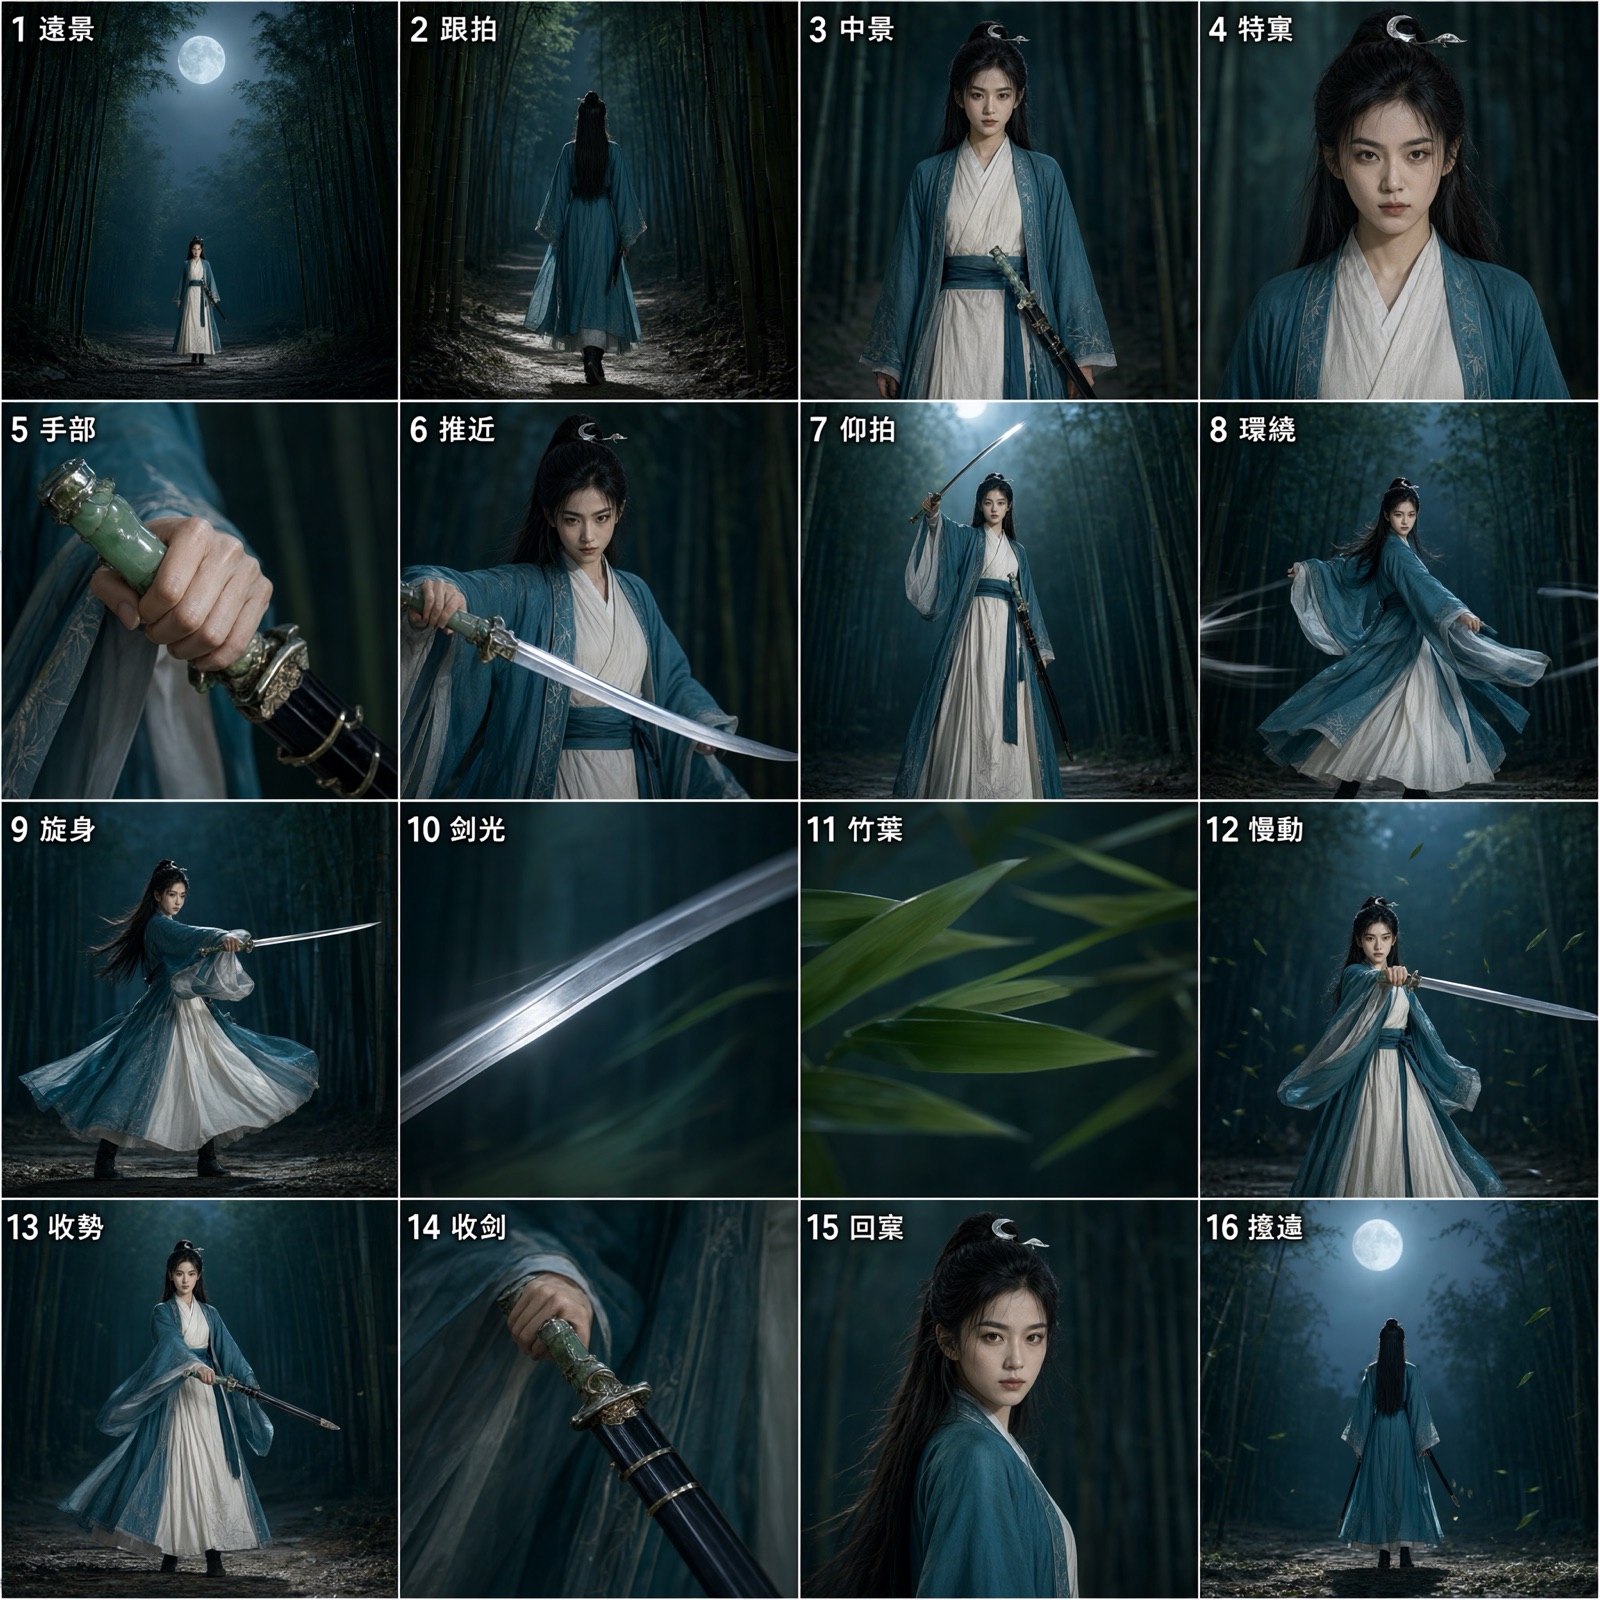
S0–S2 和 S3–S6 用的是兩張不同的分鏡表,各自有自己的 16 格,所以 S2 的 14/16 跟 S6 的 13/16 不能直接比高下,只能在同一張表內比。S5c 輸出 288 幀、12.0 秒,其他組都是 243 幀、10.125 秒。
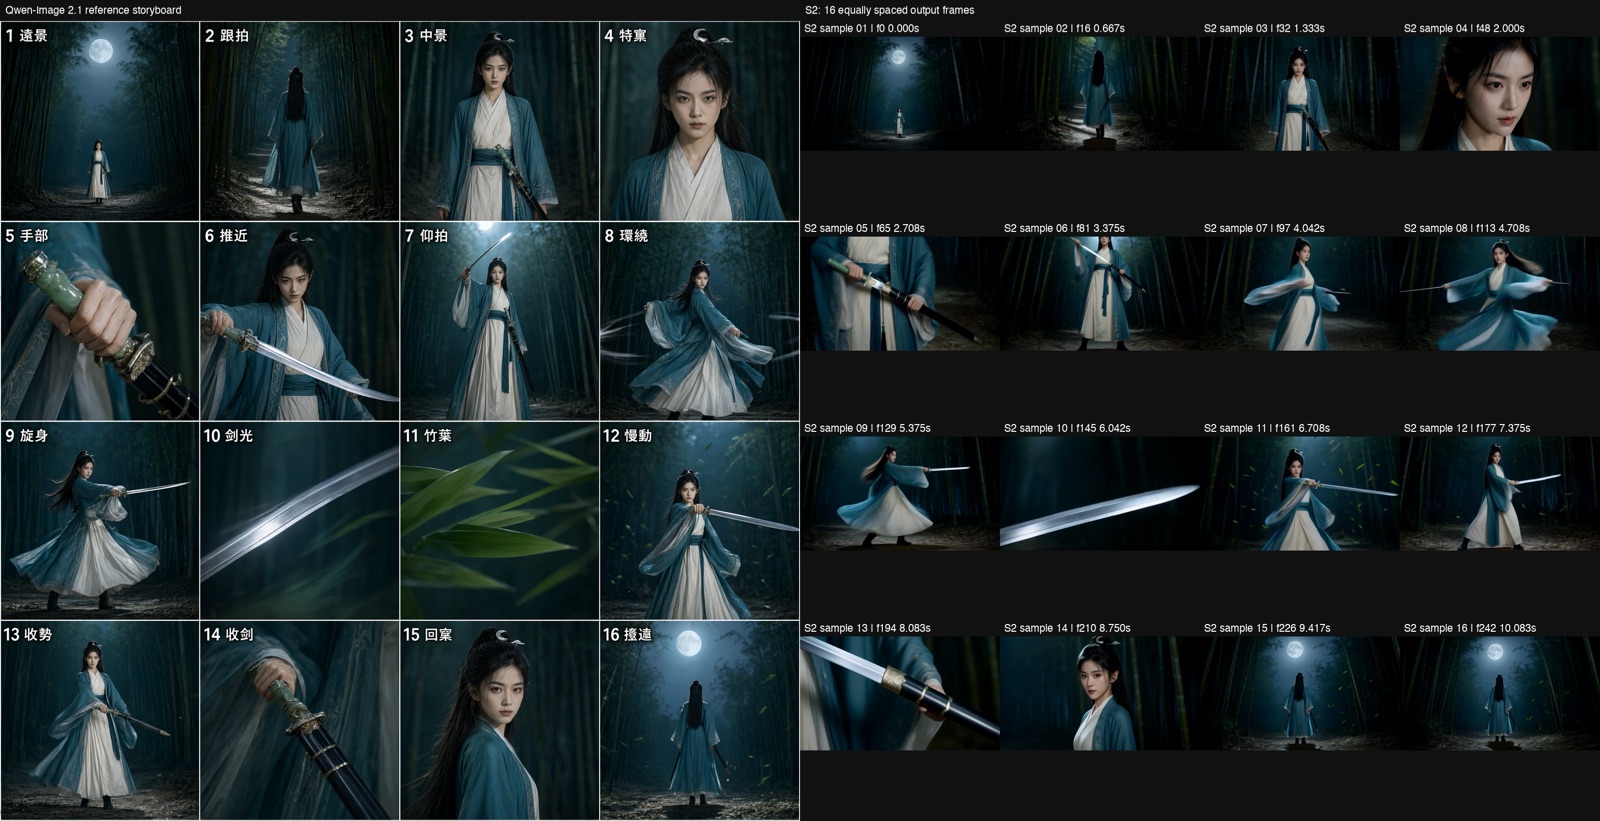
Qwen 那張分鏡表是 Qwen-Image 2.1(int8、40 步 euler / simple、CFG 1.0)生的 2048×2048,格內只有格號和短運鏡詞,第 16 格的短詞有錯字我沒修;定裝圖同設定生 1536×1536。
一句話為什麼只有兩三格
S1 和 S3 的片很像:從頭到尾在相近景別裡反覆旋身,沒有開場遠景、沒有收劍、沒有回望。H3 把整張網格當成「一張」參考圖,它拿走的是人物、服裝、色調和姿態;這兩次一句話的測試,都沒有照 16 格的順序拍。
我原本以為 ChatGPT 版分鏡表寫滿了字,H3 會讀得懂,結果 S3 跟 S1 一樣只有兩三格。這次看來,字的用處是讓人(和看圖模型)抄成時間軸。
S2 和 S4:逐格抄成時間軸,就跳到 12–14 格
S2 拍出來的順序是:遠景 → 背面跟拍 → 中景持鞘 → 臉特寫 → 握柄插入 → 仰拍舉劍 → 旋身 → 劍刃高光 → 竹葉微距 → 收勢 → 越肩回望 → 背面遠景。沒中的是第 6 格(側面中景半拔劍)和第 14 格(入鞘):第 14 格畫面裡有黑色劍鞘,但露出的劍刃越來越長,比較像在拔劍。
S4 前 5 格全中(遠景、站立、側臉、握柄、出鞘大特寫)。沒中的四格:
- 第 6 格:左手扶鞘、正面拔劍
- 第 8 格:俯角、腳步下沉
- 第 12 格:竹葉紛飛的高潮
- 第 13 格:垂劍站穩出現在入鞘之後,順序錯
入鞘之後,下一鏡又出現裸劍。
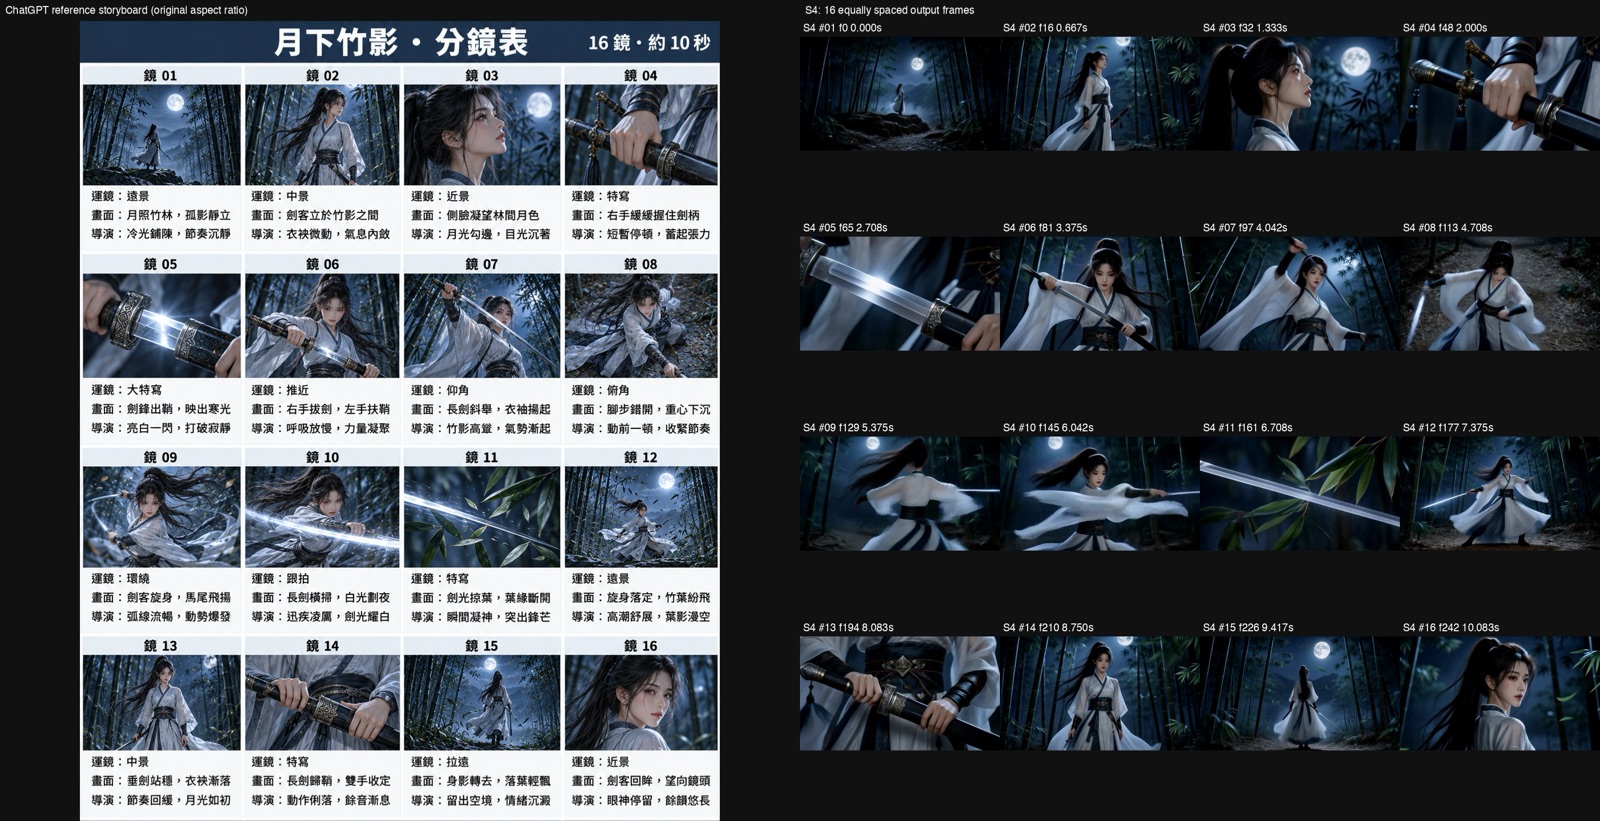
S4 的 prompt 是逐格抄分鏡表上的「運鏡」和「畫面」那兩行,沒有寫每格結束時的狀態,結果入鞘之後下一鏡又冒出裸劍。這就是 S6 要補的東西。
S5c:切格塞 Continuum,每段至少 4 秒、全片只有 9 個槽
想法是:既然 H3 不會自己切網格,那我先切好,每一段只給那段該用的關鍵格。
用的是 Continuum V3.9,碰到兩個限制:
- 每段最少 4 秒。 我原本想每 2 秒一段,送出去直接 HTTP 400:
Value 2.0 smaller than min of 4.0。 - Reference Images 全片只有 9 個槽。 Per chunk 不是每段各有一組槽,只是指定某個槽在哪一段生效。
我第一版(S5b)在工單上寫「8 張關鍵格」,實際列了 9 張,加角色圖變 10 張,被擋下來。改成三段、每段 4 秒,總長 12 秒,槽位這樣分:
| 槽 | 內容 | 生效段 |
|---|---|---|
| R1、R2 | 鏡 01、鏡 05 | 段 1 |
| R3、R4、R5 | 鏡 07、鏡 09、鏡 10 | 段 2 |
| R6、R7、R8 | 鏡 11、鏡 14、鏡 16 | 段 3 |
| R9 | 角色圖 | 三段都生效 |
結果 13/16。好的地方:第 14 格的入鞘比 S4 完整(S4 也有局部入鞘),9.25 秒還是一長段露刃,10.17 秒剩很短,10.33 秒劍格合上鞘口、雙手定住;第 13、14 格的順序也修好了。壞的地方:
- 10.79 秒下一鏡又是裸劍
- 段 2 和段 3 的接點在 f192(8.0 秒)硬切,而且橫掃動作重複一次。接點那一格前後的平均絕對差(MAD)是 52.3,全片中位數的 8.28 倍
- 第 11 格有專屬的參考圖,還是漏拍
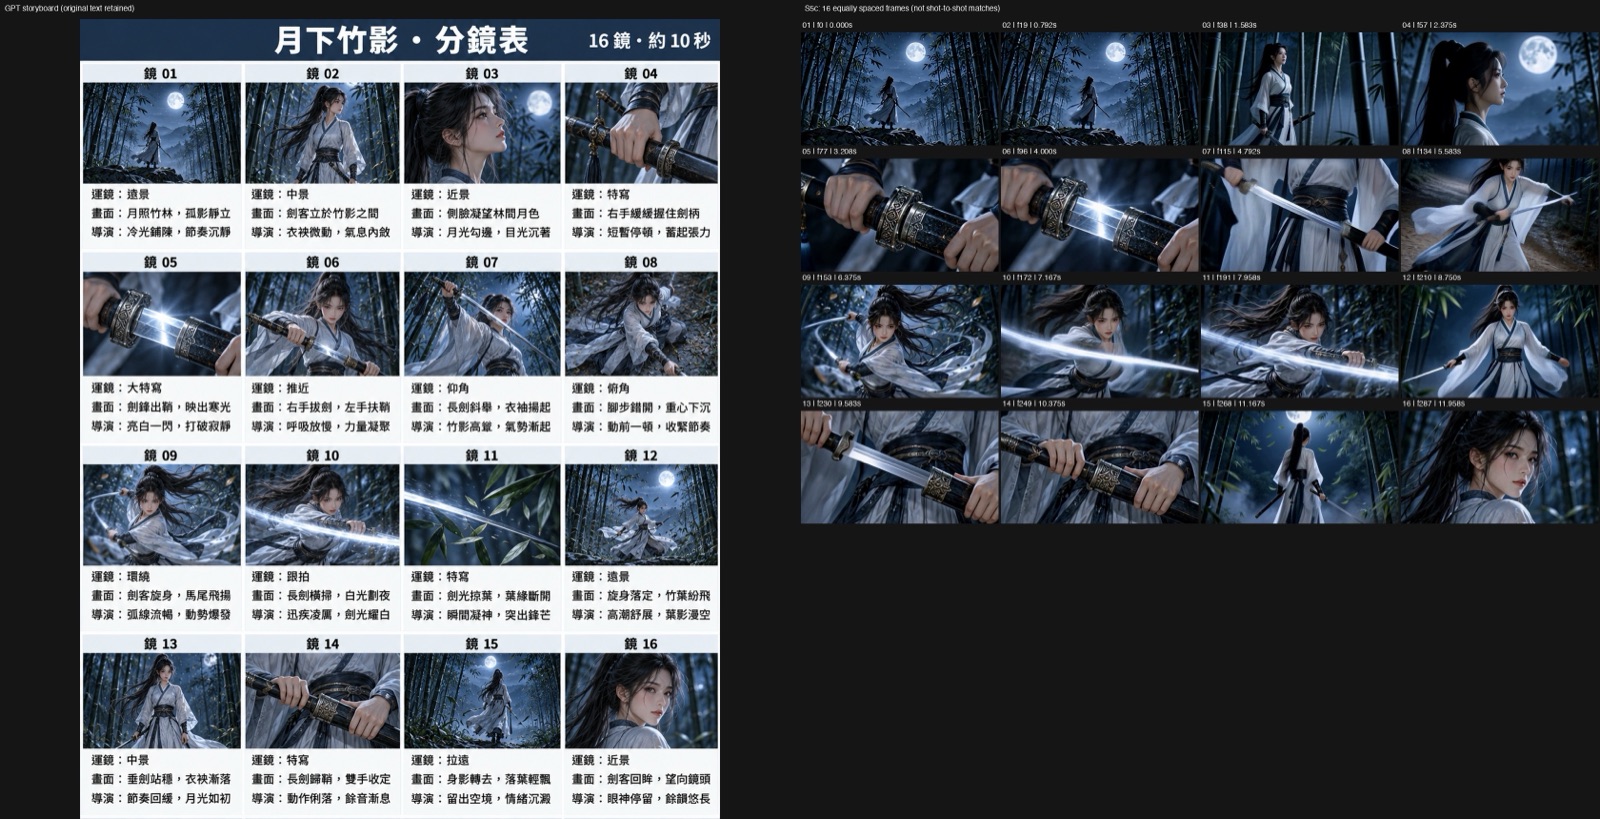
跟 S6 同樣 13/16,S6 還不用處理接點。
S6 跟 S4 比:哪幾格變好、哪幾格變差
S6 的輸入跟 S4 完全一樣(同一張分鏡表、同一張角色圖、同 seed),只換 prompt 寫法。鏡頭表是 Hina 寫的,Hina 是我在 ai-lab 機器上跑的本地看圖模型。它讀整張 ChatGPT 分鏡表加四張按列放大的裁圖,依官方 shot-table-spec 每格寫五件事(動作姿勢表情、運鏡、空間位置、聲音、交接),加上雙向的 Continuity Handoff 和 Reference Anchors(固定地標、人物位置朝向、光源)。
第一輪 79.8 秒寫完,但把繁中字讀成英文、漏了欄位;第二輪才照繁中原文補齊。人工改的五處見第一幕步驟三。
逐格跟 S4 比:
| 格 | S6 vs S4 |
|---|---|
| 第 8 格 | 變好:屈膝低身,看得到錯開的兩條腿和靴子 |
| 第 13 格 | 變好:先垂劍站穩,再入鞘,順序對了 |
| 入鞘之後 | 變好:不再出現裸劍,第 15 格手中是暗色長鞘 |
| 第 2 格 | 變差:中景拍成了全身遠景 |
| 第 6 格 | 部分改善,但頭被切掉,仍不計 |
| 第 12 格 | 沒變:還是沒有竹葉紛飛 |
變好的三項都是道具和姿勢的「狀態」,正好是 S4 沒寫、S6 每格交接有寫的東西。
S6 實際送出的英文 prompt 節錄
第一幕步驟三的中文例子,原文長這樣。H3 的 prompt 有固定段落:subject_definitions(誰是誰、哪張圖是什麼)、summary、retention_analysis(哪些要保留)、detailed_description(逐格內容)、overall_soundscape、non_diegetic_music。
subject_definitions:
<Subject 1> is the adult swordswoman from <Picture 2>. ...
<Picture 1> is the original four-by-four storyboard sheet: its sixteen panels, read row by row,
map in order to [Shot 1] through [Shot 16], specifying composition, action, camera viewpoint
and shot order. <Picture 2> supplies only the identity reference of <Subject 1>.

detailed_description:
... Each interval ends in the specified pose and prop state for the next shot; after [Shot 14],
the sword stays fully enclosed in its scabbard through the final frame.
[Shot 13] At 00:07.594, the camera cuts to Medium shot of <Subject 1> standing steady with her
sword pointing down, her robes settling. The camera holds a static shot. ... At the handoff,
she stands steady with the bare sword lowered, ready to sheath it.
[Shot 14] At 00:08.227, the camera cuts to Extreme close-up of <Subject 1>'s hands sheathing
the sword smoothly into the scabbard. ... At the handoff, the sword is fully sheathed,
hands resting on the hilt/scabbard.
坑一:Autogrow 參考圖寫成巢狀 dict,會被靜默忽略
Ref2VA 的參考圖輸入是 ComfyUI v3 的 Autogrow(接一張就多長一個插槽)。用 API 送 workflow 時,寫成巢狀物件會被動態 schema 直接略過,不報錯:
"ref_images": {
  "ref_image_0": ["20", 0],
  "ref_image_1": ["21", 0]
}
要寫成頂層的 dotted key,這是 S6 實際送出的寫法:
"ref_image_size": "match",
"ref_images.ref_image_0": ["20", 0],
"ref_images.ref_image_1": ["21", 0]
第一版 S1 就是巢狀寫法,片照樣生得出來,事後才發現根本沒吃到參考圖;表裡的 S1 是改正後重跑的那一發。
坑二:codex exec -i 會把 prompt 吃成第二張圖
我是透過 codex exec --enable image_generation 叫 ChatGPT 生圖的。生角色圖要附上分鏡表當參考,第一次這樣寫:
codex exec --enable image_generation -i storyboard.png "參考附圖分鏡表裡的女劍客……"
它把後面那串 prompt 也當成一張圖,回 No prompt provided via stdin。要改成用 - 從 stdin 讀 prompt;不在 git repo 裡跑還要加 --skip-git-repo-check:
codex exec --enable image_generation --skip-git-repo-check -i storyboard.png - < prompt.txt
這次測試的邊界
- 每一組只跑一發,seed 全部是 20261025,換 seed 結果會不會一樣我沒測。
- 只有一個故事(月夜竹林女劍客、靜立到回望)。換成有對白、多角色或鏡頭大幅移動的題材,沒試過。
- S0–S2 和 S3–S6 的分鏡內容不同,跨兩組的格數不是同題排名。
- 16 格塞 10.125 秒,每格 0.633 秒,遠低於官方 MV skill 接片用的每鏡 2 到 5 秒,是刻意加壓的條件。
- 「對上」是我看 16 幀和分鏡表並排逐格判的,主要構圖和動作出現、順序接得上才算,部分符合一律不算。
相關
常見問題
- 直接把 16 格分鏡表加一句話丟給 MiniMax-H3,它會照分鏡拍嗎?
- 不會。我用兩張不同的分鏡表各試一次,只對上 2/16 和 3/16 格:整支片在差不多的景別裡反覆旋身,沒有開場遠景,也沒有收劍回望。H3 把整張網格當成一張參考圖,沒有把 4×4 自動切成 16 個時間點的機制,它從分鏡表拿走的是人物、服裝、色調和姿態。
- 分鏡表每格都寫了運鏡和畫面說明,H3 讀得懂那些字嗎?
- 這次沒看出效果。ChatGPT 那張分鏡表每格有三行繁中說明,全部清楚可讀,丟分鏡表加一句話的結果還是只有 3/16 格,跟格內只有短詞的 Qwen 版差不多。我目前的用法是讓人(或看圖模型)照著抄成文字時間軸,抄完寫進 prompt,H3 才照順序拍。
- 用分鏡表當參考圖,還需要另外給角色圖嗎?
- 要。4×4 網格縮進參考圖之後,每格大約只剩 256×256,臉太小。我每一組只要有給角色圖,人物的整體造型都保住了,只是臉的細節各組略有不同;完全不給參考圖、只寫文字的那組,人換了臉也換了髮型。
- 在 RTX 5090 上用 H3 Ref2VA 生 10 秒 1344×768 要多久?
- 我這次 14 步、243 幀(24fps、10.125 秒、含音軌),ComfyUI 端一發大約 300 到 340 秒;照官方格式寫 prompt 的那發是 339.9 秒。
- ComfyUI 的 H3 參考圖明明接了,為什麼看起來沒生效?
- 如果你是用 API 送 workflow,檢查參考圖的寫法。Ref2VA 的參考圖輸入是 v3 的 Autogrow,寫成巢狀的 ref_images 物件會被靜默忽略、不報錯;要寫成頂層的 ref_images.ref_image_0、ref_images.ref_image_1。我第一版就是這樣,跑完才發現參考圖根本沒吃進去。
- 把分鏡切成單格、用 Continuum 分段餵參考圖,會比較準嗎?
- 我試的那次是 13/16 格,跟整張分鏡表加官方格式 prompt 一樣,收劍入鞘那一格也拍得比較完整,竹葉紛飛的第 12 格也只有這組拍到;但段與段之間在 8.0 秒硬切,橫掃動作重複了一次。另外 Continuum 每段至少 4 秒,全片的參考圖只有 9 個槽,16 格塞不進去,要挑關鍵格。
接著讀
- 2026-10-19[AI Workflow] 真人舞蹈轉成深度影片,讓 MiniMax-H3 的古風角色在宮殿跳同一段舞:768 直接生成
看到有人用真人舞蹈帶 AI 角色跟著跳,我想試試 MiniMax-H3 能不能也做得出來,就用本機的一張 RTX 5090 跑了一次:Video Depth Anything 轉深度、Qwen-Image 把角色放進宮殿當第一格、Ref2VA 只給這一張場景圖,768×1376 直接生成再補幀到 48fps。含節點設定、首幀接法、背景跑回白棚的原因和換 seed 的坑。
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。