MiniMax-H3 on RTX 5090 · part 10
[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
❯ cat --toc
TL;DR
IG 上看到有人在照片上畫紅線,叫 AI 照線飛出無人機鏡頭。我在一張 RTX 5090 上做了本地版,換成台灣四個地標:玉山、太魯閣、101、日月潭,一鏡飛完 22 秒。紅線圖直接當首幀,飛到建築側面就會變形;一次生 15 秒,模型會自己硬切。最後的作法是先在 Blender 用方塊把路線飛一遍,拆成三段、段尾衝進霧,MiniMax-H3 Ref2VA 只負責把方塊畫成真的。1344×768 三段合計約 17 分 41 秒,再用 RTX VSR 放大到 2688×1536。霧的接縫還看得出來,101 也沒繞滿一圈。
玉山、太魯閣、台北 101、日月潭,三段生成、在霧裡接成 22.7 秒,看起來像一鏡到底。原始畫面由 MiniMax-H3 在一張 RTX 5090 上生成,再用 RTX 放大與補幀;網頁版縮成 1680×960
前言
前幾天在 IG 上看到一種做法:在一張靜態照片上用紅筆畫一條無人機路線,prompt 叫模型照著線飛,成片裡再把紅線拿掉。雪山、杜拜塔、競技場、歌劇院一路飛過去,看起來很爽。原作用的是雲端模型,我想知道在自己的 RTX 5090 上做不做得到,順便把地標換成台灣的。
結果照抄不太行。直接拿一張圖給模型,它飛到建築側面就得自己猜後面長怎樣,建築會融掉;一次塞 15 秒、五個場景,它會自己剪接,明明 prompt 寫了不准切。
最後的分工是:鏡頭怎麼飛,我在 Blender 用方塊先飛一遍;AI 只負責把方塊畫成真的。同系列 Part 9 用白模排兩個人的走位,這篇把同一招拿來排無人機路線。
成品:四個地標拆三段生,在霧裡接起來
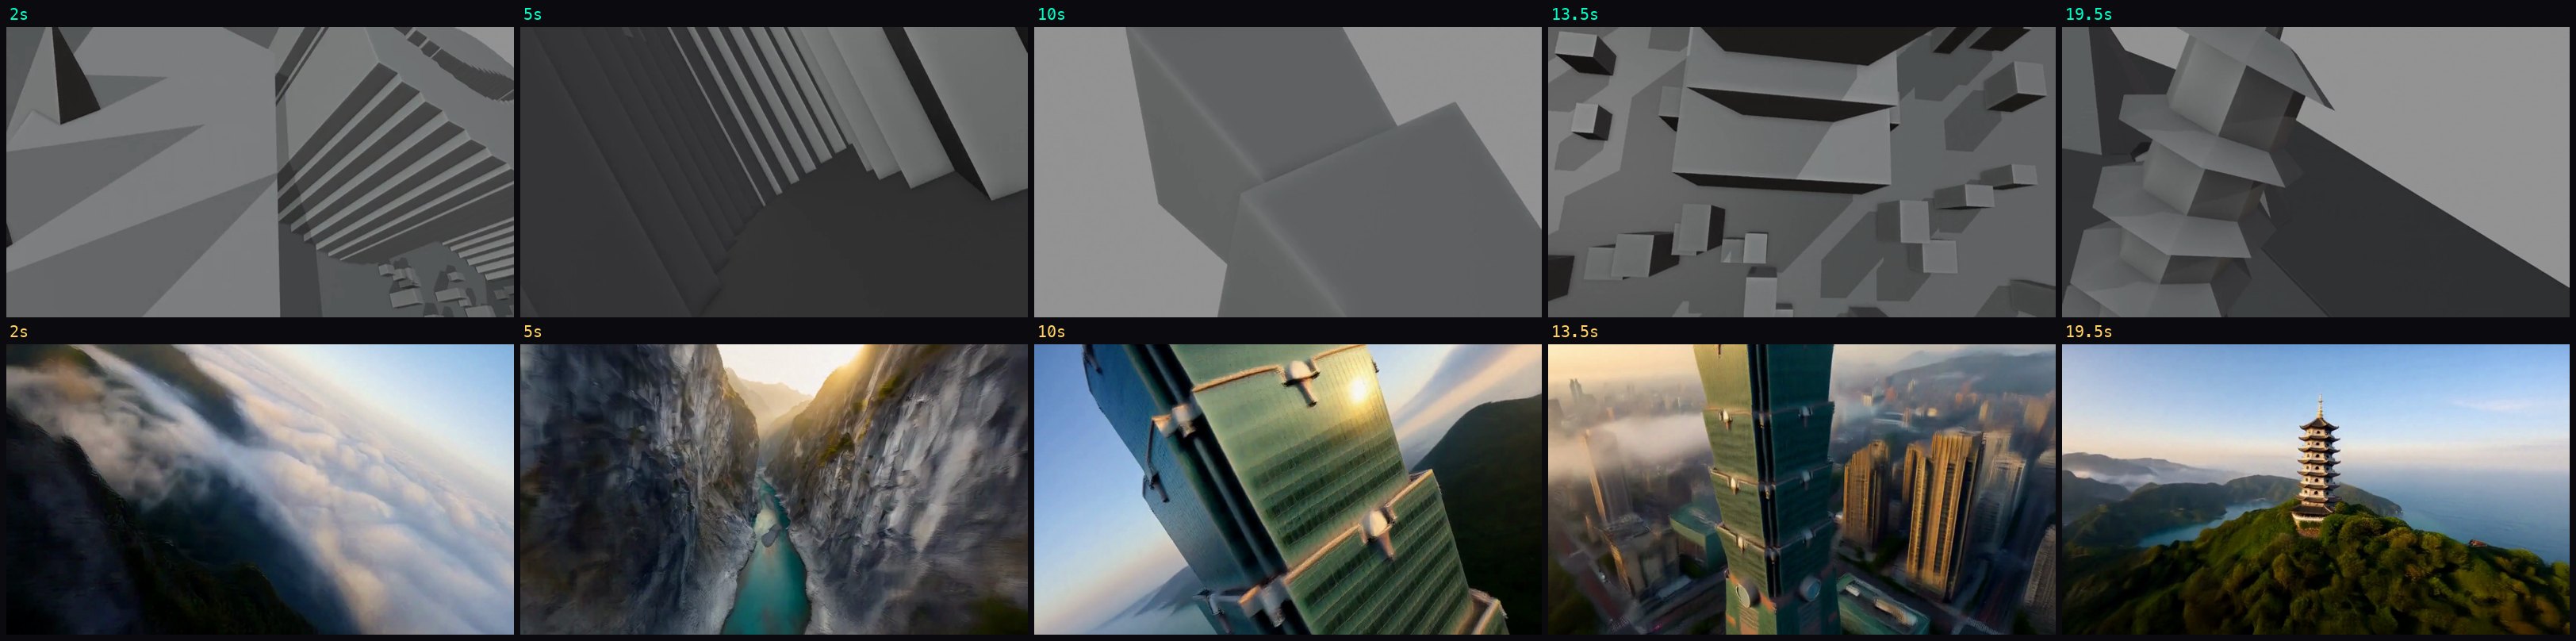
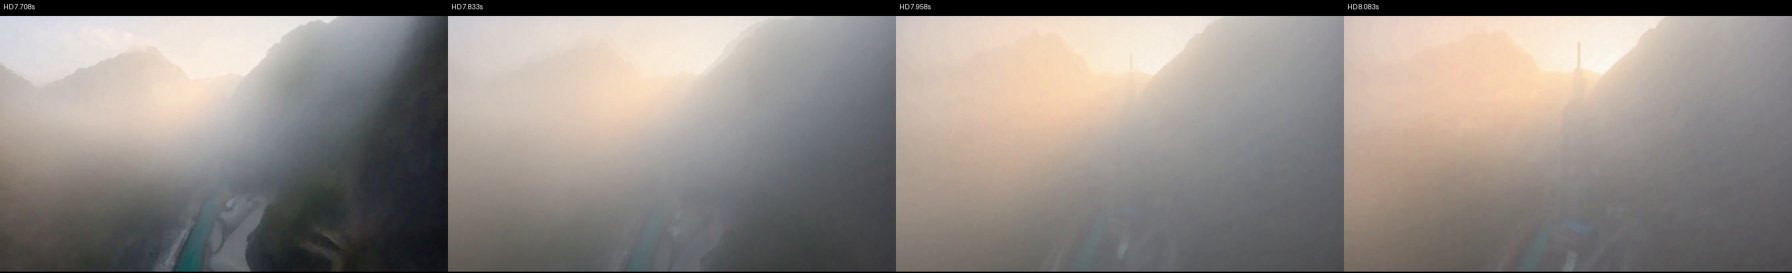
成片 22 秒、2688×1536、48fps,玉山→太魯閣→101→日月潭→最後拉高看全景,中間沒有硬切。它其實是三段分開生的,每段結尾衝進一團霧,下一段從霧裡出來,接縫藏在霧裡。
| 段 | 內容 | 長度 | H3 生成時間(1344×768) |
|---|---|---|---|
| S1 | 玉山 + 太魯閣 | 192 幀 / 8 秒 | 363.32 秒 |
| S2 | 101 | 192 幀 / 8 秒 | 373.57 秒 |
| S3 | 日月潭 + 全景 | 175 幀 / 7.3 秒 | 324.14 秒 |
三段 H3 合計 1061 秒,約 17 分 41 秒,三段都一次跑完、沒有爆記憶體。整條流程:
- Qwen-Image 2.1 生一張全景、四張地標參考圖
- Blender 用方塊搭白模、排相機路線,拆三段,每段結尾衝進霧
- H3 Ref2VA 每段吃三種參考:全景、該段地標、前一段的最後一格
- ffmpeg 在霧裡交叉淡化接片
- RTX VSR 放大兩倍到 2688×1536,RTX 補幀補到 48fps
步驟一:Qwen-Image 2.1 先生全景和地標參考圖
參考圖負責「長相」,白模負責「怎麼飛」。我用 Qwen-Image 2.1(int8、40 步、1344×768)生了一張台灣全景和四張地標圖,每張跑兩個 seed 挑一張。
101 的八節竹節它畫對了,這點讓我滿意外的。玉山就比較普通,看起來像隨便哪座岩山,認不太出是玉山。
步驟二:Blender 白模把路線飛一遍,段尾衝進霧
白模就是只用方塊這種粗形狀搭的 3D 草稿,不管長相,只管東西在哪、鏡頭怎麼走。101 我用八個上寬下窄的方形截錐疊起來,對應那八節竹節;山和峽谷也一樣用粗形狀擺。
相機路線拆成三段,每段結尾讓鏡頭衝進一團霧,下一段從霧裡出來。拆段時有一條規矩我是吃過虧才加的:每段白模裡,相鄰兩格的畫面差不能超過中位數的 3 倍,也就是鏡頭不能突然甩一下。我最後三段的數字:
| 段 | 相鄰幀差中位數 | 最大值 |
|---|---|---|
| S1 | 9.62 | 24.66 |
| S2 | 8.38 | 19.56 |
| S3 | 6.38 | 9.78 |
為什麼要守這條,後面進階會講:一次生 15 秒那版,其中一刀剛好切在白模鏡頭大跳的那一格。
幀數照 H3 的規格,17 的倍數再加 5:192 = 17×11+5,175 = 17×10+5。白模放在另一台 Linux 機器用 headless Workbench 算圖,不占 5090。白模腳本怎麼叫 Claude 寫、要交代哪些規矩,Part 9 有完整說明,這篇不重複。
步驟三:H3 Ref2VA 每段給全景、地標、前一段末幀
Ref2VA 是 MiniMax-H3 的參考生成模式:白模影片接參考影片插槽,圖片接參考圖插槽。它不是把白模改一改,而是從零生一支新片,生的時候一路參考白模怎麼動。
每段的參考圖都有全景和這一段的地標(第一段玉山、太魯閣各一張),第二、三段再加上前一段成片的最後一格。最後一格是為了讓下一段接得上;Ref2VA 沒有首幀輸入,只能把它當參考圖丟進去,接不準的地方就靠霧蓋掉。接線以第二段為例:
LoadVideo(S2 白模.mp4) → GetVideoComponents.images → MiniMaxH3ReferenceToVideo.ref_videos.ref_video_0
LoadImage(全景)               → ref_images.ref_image_0
LoadImage(101 地標圖)          → ref_images.ref_image_1
LoadImage(S1 成片最後一格)      → ref_images.ref_image_2
width 1344 · height 768 · length 192 · seed 2026101602
第一段前面沒有東西可接,就給全景、玉山、太魯閣三張。prompt 的六段格式跟 Part 9 一樣,只是主角從兩個人換成一路飛過的地景。
步驟四:在霧裡交叉淡化接片
三段生完,用 ffmpeg 的 xfade 在霧裡做 7 格(0.29 秒)的交叉淡化,接成 22 秒的一支片。接完跑一次場景切換偵測,門檻 scene>0.18,零個候選,硬切沒了。
步驟五:放大到 2K,補幀到 48fps
放大用 ComfyUI 的 RTX VSR 節點,設定只有兩個:
RTXVideoSuperResolution
scale 2.0 · quality ULTRA
1344×768 放大兩倍到 2688×1536,花 43.5 秒。最後用 RTX 補幀從 24fps 補到 48fps,一共 1089 格,花 150 秒。
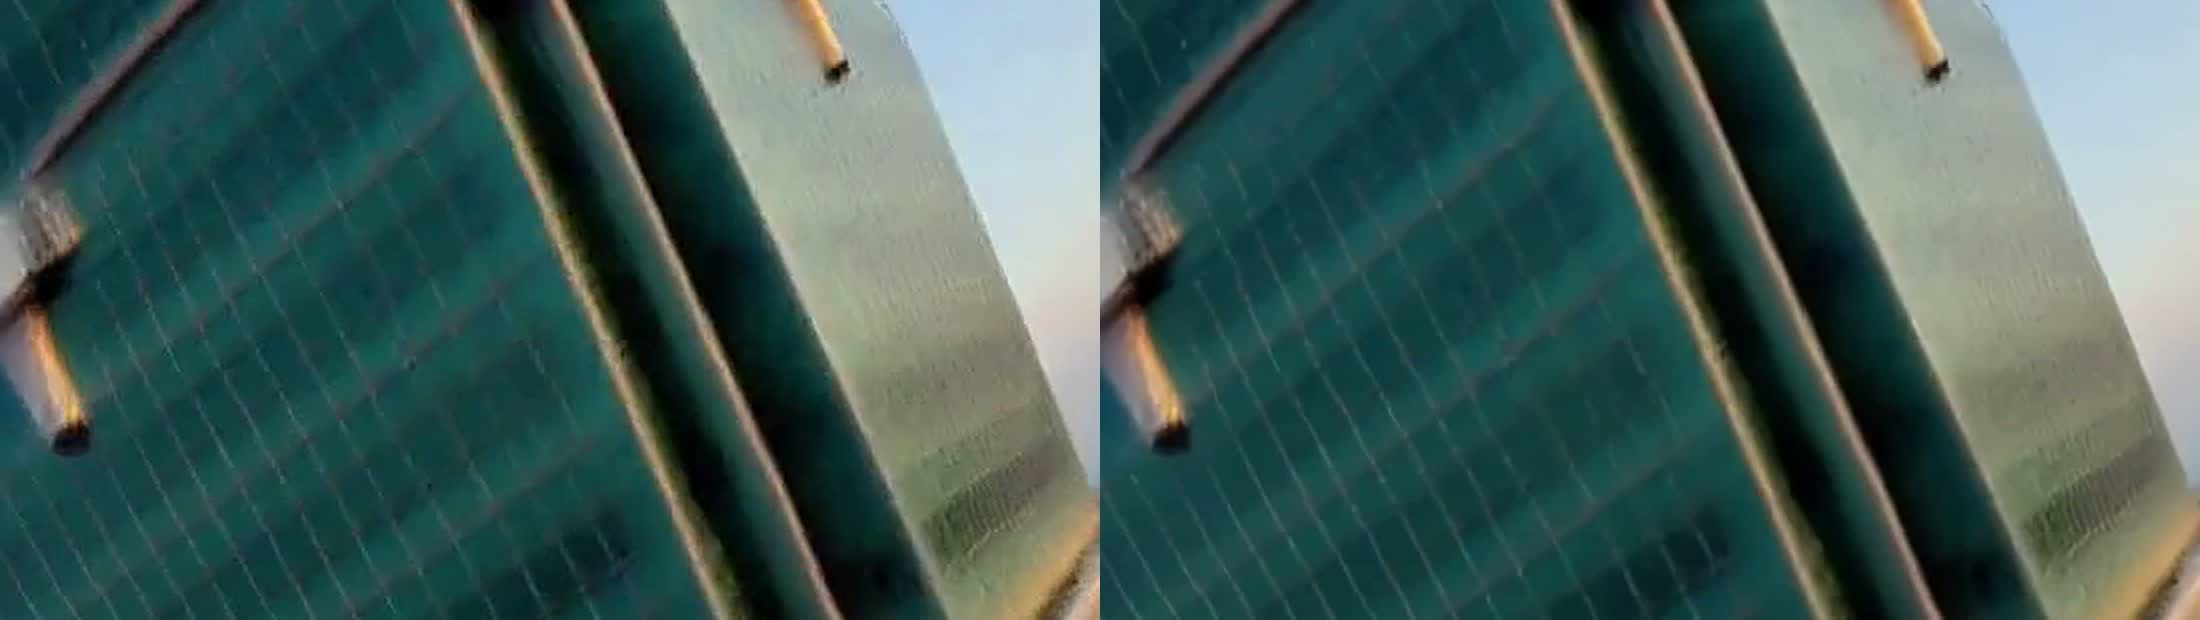
放大的效果有限。101 的窗框略清楚一點,但高速段本來就有的動態模糊補不回來;我也沒看到放大後多出振鈴或閃爍。想要細節,還是得靠 H3 那一步直接生大一點。
還沒做到的
前三條是在 864×480 版確認的,高畫質版沒有逐條重看。
- 101 想繞塔螺旋一整圈,沒繞滿
- 塔尖想定格 0.5 秒,沒停住
- 日月潭想貼水 2 公尺飛,沒貼上去
- 霧的接縫看得出是淡化接過去的
- 局部還有變形:5–6.5 秒峽谷壁、10 秒和 14 秒的竹節、18 秒的塔山
- 1344×768 版新出現的:第 4 秒峽谷的霧更厚,18–19 秒的島和塔山看起來像黏在一起
每段都只跑一次,沒有換 seed 測穩定度。
進階
不讀這節不影響使用。這裡是走到最終版之前的實驗和一次除錯紀錄。
先用 864×480 試路線,確定了再出高畫質
1344×768 一段要 324–374 秒,路線還沒定的時候每改一次就等十幾分鐘不划算。我的作法是先用 864×480 跑:同樣三段、同樣白模和參考圖,S1 161.3 秒、S2 161.3 秒、S3 141.2 秒,合計 463.8 秒,大約 7.7 分鐘。1344×768 的總時間是它的 2.29 倍。
864×480 版接完也沒有硬切:場景切換偵測零候選,我自己量相鄰幀差,中位數 7.7,最大 25.5,落在 1.6 秒玉山過頂那個側滾。
要注意的是,換解析度構圖會跟著變。同一份白模、prompt、參考圖和 seed,1344×768 版的鏡頭走法跟 864×480 版不一樣。所以 864×480 只能拿來確認路線和接片可行,高畫質版出來要重新看一遍。1344×768 版比較好的地方:101 的窗格和竹節邊緣(10.5 秒)、湖面的細波紋(17.5 秒)、玉山的岩塊;變差的就是上面「還沒做到的」最後一條。
紅線圖直接當首幀:順序對,側面會融掉
第一輪照 IG 上看到的做法,把畫了紅線的圖直接當首幀(H3 的 I2VA 首幀模式),地標還是原圖的雪山、杜拜塔、競技場、歌劇院。5090 上 1344×768、345 幀(14.375 秒),生成 112.4 秒。
順序照走,紅線 0.5 秒內就消失了,第 0 格還殘留原圖浮水印的變形字。問題出在側面:鏡頭鑽進競技場時,場地變成一圈圈同心螺旋;繞過杜拜塔轉角時,塔身被拉長。只給一張圖,模型飛到側面只能自己猜 3D,猜錯就融掉。
我也在 ai-lab 的 2080 Ti 上用 int8 跑了草稿版,672×384、10 秒片,花 342 秒。RTX 補幀補到 48fps 在 5090 上要 25 秒,我挑最快的第 11 秒看,補出來的中間格沒有鬼影,只是略糊,變形的地方補完還是變形。
白模接一張圖:競技場的螺旋消失了
第二輪先在 Blender 照同一條路線做白模:19mm 鏡頭、345 幀,速度從每秒 6.58 到 51.81 單位,最大側傾 28.96°,headless Workbench 算圖 39 秒。再送進 H3 Ref2VA,ref_videos 吃白模,ref_images 吃一張乾淨的場景圖(第一輪成片第 1 秒那格),864×480、14 步,生成花 378.8 秒。
競技場的螺旋消失了,看得到場地、看台和拱門,也沒有灰色材質滲出來。各段比白模早到 0.5–1.5 秒。歌劇院的殼還是變形,因為我白模只用五片尖殼帶過,模型拿到的形狀本來就不夠。
一次生 15 秒,為什麼會被硬切?
第三輪換成台灣四個地標,白模 362 幀(15.08 秒)一次生完。兩支都被硬切:A 版切在 5.92 秒和 9.50 秒,B 版切在 5.75、10.96、13.63 秒。prompt 是單一 [Shot 1],而且明寫不准切。
我回頭量白模每兩格之間的畫面差,出太魯閣峽谷那一刀,正好對上白模第 138 幀的大跳:那一格的相鄰幀差是 35.4,中位數只有 7.9,鏡頭在那裡突然甩了一下。其他切點的白模都很平順,所以不是每一刀都是白模的問題。
我的處理是兩件一起做:每段縮到 7–8 秒,白模相鄰幀差壓在中位數 3 倍以內,段和段之間用霧接。之後三段生完,一刀都沒有。
參考圖 A/B:構圖選 A,質感選 B
第三輪同時做了參考圖 A/B:A 只給全景,B 給全景加四張地標圖。H3 生成時間 A 394 秒、B 471 秒。
我本來以為多給每個地標一張參考圖會更穩。盲看結果是構圖選 A,四個地標在畫面裡的位置比較好看;質感選 B,比較沒有塑膠感。
盲看要把構圖和質感分開問。最終版兩邊都取:每段給全景顧構圖,再加該段的地標圖顧質感,沒有四張全塞。
除錯紀錄:5090 一載入文字編碼器就崩
做到一半,5090 上的 H3 開始一載入文字編碼器就崩。ComfyUI 的 log 停在這行:
Requested to load MiniMaxH3TEModel_
Python exit code 3221225477(0xC0000005,記憶體存取違規),Windows 事件記錄的模組寫 unknown。我手上 nvfp4 和 awq 兩版文字編碼器(各 15.7GB)都崩。ComfyUI 套件、節點、驅動從 10-15 03:13 之後都沒動過,當時 H3 的 smoke test 是過的,所以應該不是改壞了什麼。
最後懷疑是系統記憶體。vmmemWSL 閒置還佔著 20.4GB,可用記憶體只剩 27GB(總共 61.6GB),commit 用到 38.4/71.1GB。關掉 WSL:
wsl --shutdown
可用記憶體回到 47.6GB,commit 降到 17.5GB,同一份工作直接跑完。之後 H3 崩在載入文字編碼器,我會先看 vmmemWSL。
相關
常見問題
- 只給 AI 一張畫了紅線的圖,它能照線飛出無人機鏡頭嗎?
- 順序會照走,紅線也會在 0.5 秒內消失,但飛到建築側面時模型得自己猜 3D,我那支的競技場鑽進去變成同心螺旋,杜拜塔轉角被拉長。先用 Blender 白模把路線飛一遍再交給 Ref2VA,競技場的螺旋就消失了。
- 在 RTX 5090 上生這支 22 秒的台灣 FPV 要多久?
- 1344×768 拆三段生成,玉山加太魯閣 363.32 秒、101 是 373.57 秒、日月潭加全景 324.14 秒,合計 1061 秒,約 17 分 41 秒。接片後用 RTX VSR 放大兩倍到 2688×1536 花 43.5 秒,再補幀到 48fps 花 150 秒。
- 為什麼不一次生 15 秒,要拆成三段?
- 我一次生 15 秒的兩支都被模型自己硬切了兩到三次,prompt 明寫只有一個鏡頭、不准切也一樣。拆成 7 到 8 秒一段、段尾衝進霧,再在霧裡交叉淡化接起來,成片就找不到硬切了。
- 每個地標都多給一張參考圖,效果會比較好嗎?
- 不一定。我做了只給全景和全景加四張地標圖的 A/B 盲看,構圖選了只給全景那支,質感選了多給地標圖那支(比較沒有塑膠感)。所以盲看時構圖和質感要分開問。
- 可以先用低解析度試路線,再出高畫質嗎?
- 可以,864×480 每段 141 到 161 秒,三段合計 463.8 秒,適合先看路線對不對。但換解析度構圖會跟著變,等於換一條軌跡,高畫質版要重新看一次。
- RTX 5090 跑 H3,載入文字編碼器時 ComfyUI 直接當掉怎麼辦?
- 先看 WSL 佔了多少記憶體。我那次 vmmemWSL 閒置還佔 20.4GB,跑 wsl --shutdown 之後可用記憶體從 27GB 回到 47.6GB,同一份工作就跑完了。
接著讀
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
- 2026-09-06[Benchmark] 兩張人設圖餵進去,讓小販跟書生自己演完自相矛盾:MiniMax-H3 Ref2VA 入門
Ref2VA 是 H3 唯一吃得下多張參考圖的模式。用兩張 z-image 人設圖生一段 10.1 秒的雙角色對話,台詞 ASR 逐字比對 CER 6.8%,三個錯字全是同音字。含六段格式全文與節點接線。
- 2026-09-11[Benchmark] 同一句中文台詞,LTX-2.5 用 29 秒、MiniMax-H3 用 81 秒:一張 5090 的實測
同一張 RTX 5090、同一句簡體台詞、同一段雙人對白,兩個會講話的開源影片模型對打。LTX-2.5 出片 28.67 秒,H3 81.22 秒,ASR 逐字比對都是 CER 0%。兩邊峰值 VRAM 都落在 31,7xx MiB,只剩不到 900 MiB。
- 2026-09-13[Benchmark] 先抽到好的再強化:詳解 NVIDIA 的 H3 + LTX-2.5 兩段式影片產線
NVIDIA Sol-H3 的兩段式做法搬到 RTX 5090:H3 只生 672×384 草稿(25.5 秒一支),挑中的那支才交給 LTX-2.5 三步精修。附可下載的 ComfyUI workflow。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。