MiniMax-H3 on RTX 5090 · part 11
[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
❯ cat --toc
- 前言
- 成品:五段連續生成,四個接點肉眼找不到
- 白模改成轉頭才露出下一個地標:先藏在右後方
- 裝 Continuum:git clone 進 custom_nodes,不用裝套件
- 接點不在整數秒:天空要對準 124、243、362、481 幀
- 提示詞逐段寫:每段只寫自己那一段
- 結尾全景重做:五張參考圖加分區描述,四個地標同框
- 想只重生一段,先把 run_storage 設成 Save + Auto Resume
- 還沒做到的
- 進階
- 冒煙那發:接點一格跳回山頂,5.84 倍
- Continuum 原始碼讀到的規則
- 接點倍率怎麼量
- 接點 1 窗內峰值 4.37×:山稜衝進畫面
- 磁碟不夠,Finalize 失敗,五段整片重跑
- 整片重跑,前 20 秒幾乎沒變
- 耗時與 VRAM
- 跟 H3LongVideos 能不能共存
- 相關
TL;DR
上一篇的台灣 FPV 是三段在霧裡淡化接起來的,霧的接縫看得出來。這篇拿掉霧,把下一個地標先藏在鏡頭右後方,鏡頭向右轉頭、畫面只剩天空的那不到一秒換段,接縫就藏在天空裡。用 ComfyUI-H3-Continuum 讓 MiniMax-H3 連續生五段、25 秒,四個接點的畫面變化是平常的 1.28、0.86、0.33、0.15 倍,肉眼看不出接片。接點不在整數秒,白模時間軸要跟著對齊;101 那段還會提早露出日月潭。
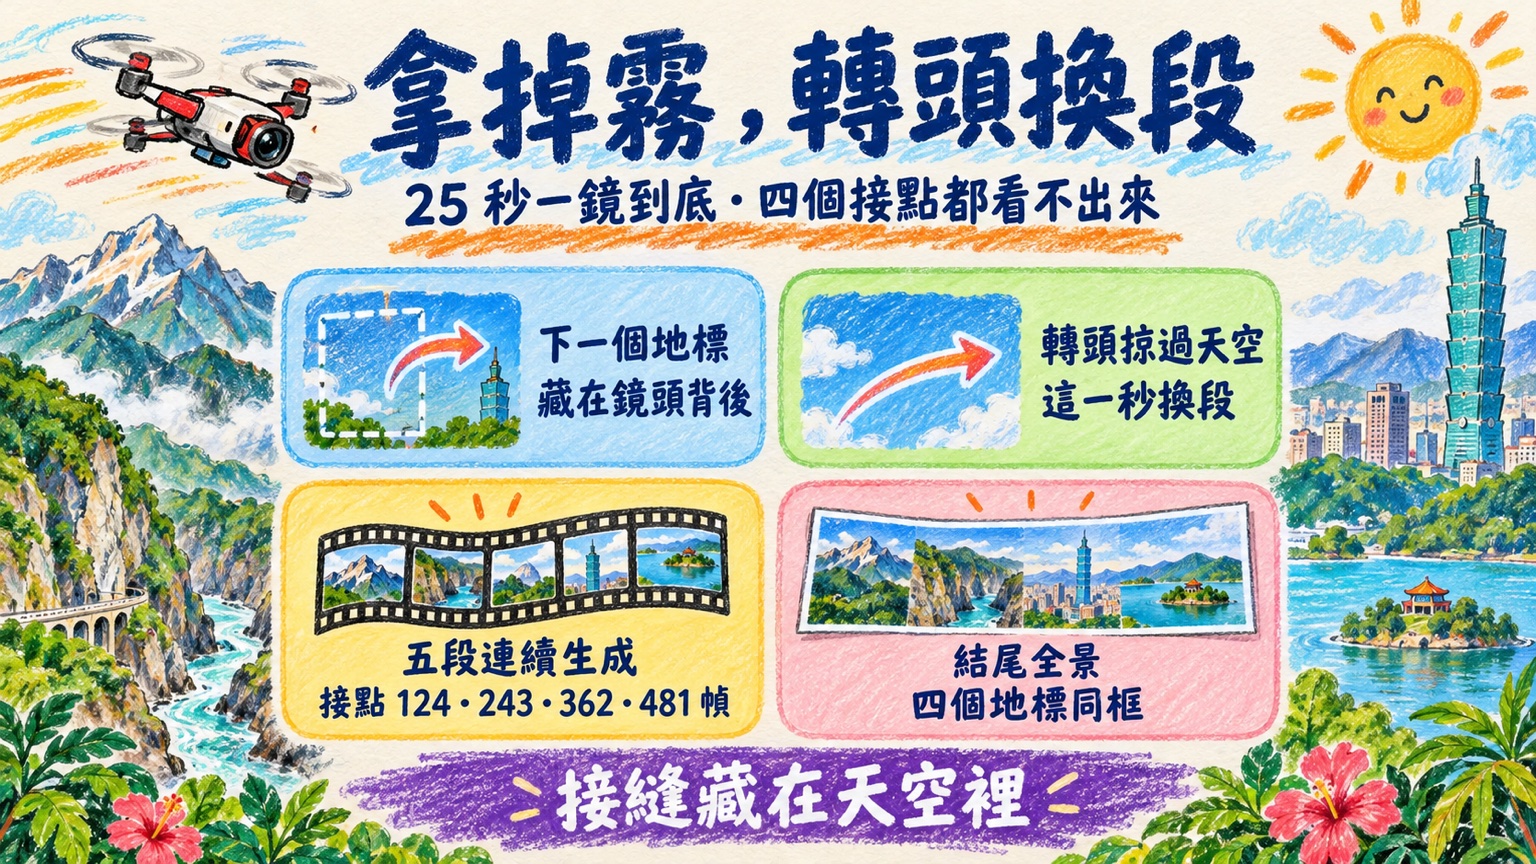
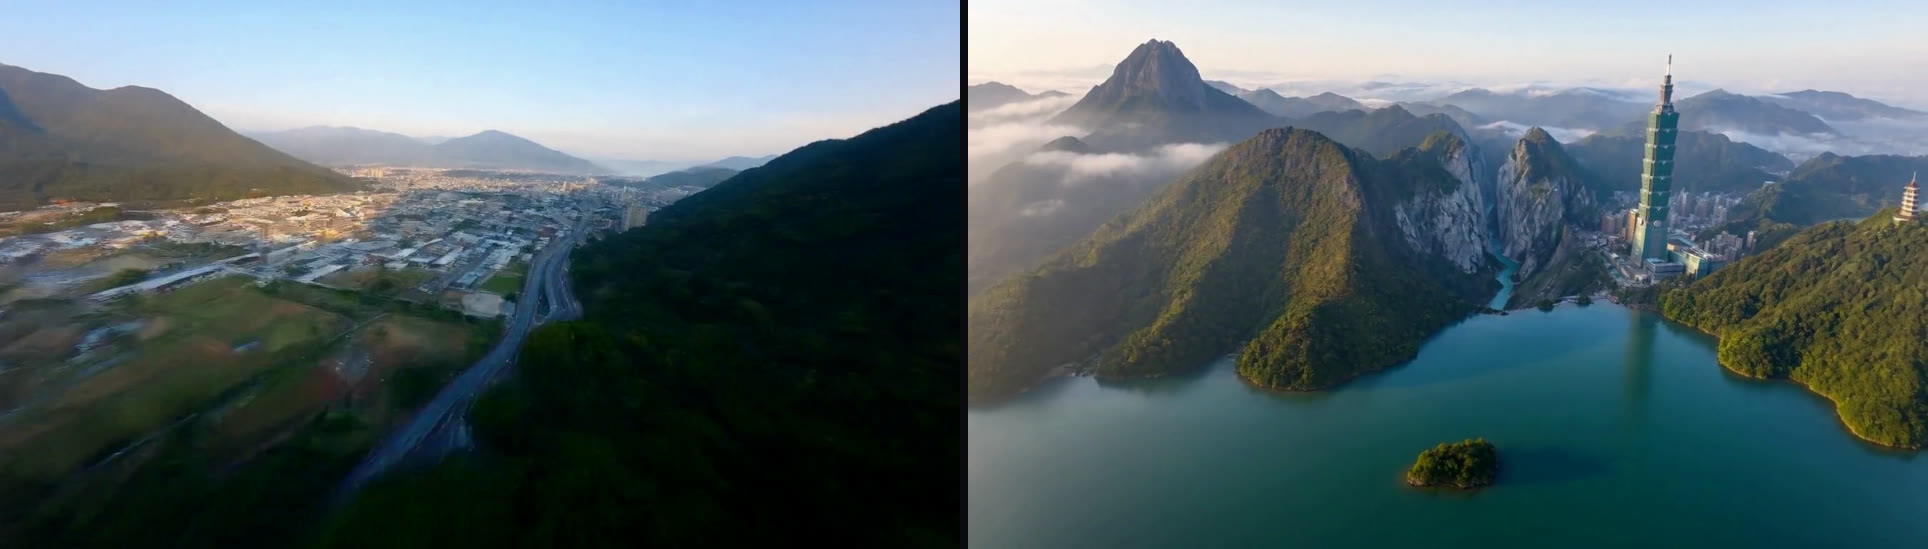
玉山、太魯閣、台北 101、日月潭,最後拉高看全景。鏡頭每次向右轉頭掠過天空時換一段,五段接成 25 秒,沒有霧轉場。MiniMax-H3 在一張 RTX 5090 上以 1344×768 生成
前言
上一篇的台灣 FPV 是三段分開生、每段結尾衝進霧、在霧裡淡化接起來的。成片沒有硬切,但霧的接縫看得出來,我自己在「還沒做到的」也寫了這條。我想要的是真的一鏡到底,像一開始在 Blender 畫的那條線那樣,直接飛過去。
卡住的地方有三個。H3 一次只能生幾秒,拆段就有接縫;用霧遮,看得出是淡化;直接把第二段接在第一段後面,第二段會把故事從頭再演一次,一格從霧中峽谷跳回晴朗山頂。
後來想到的作法很簡單:下一個地標先藏在鏡頭背後,鏡頭轉過去、畫面只剩天空的那不到一秒換段,接縫就藏在天空裡。
成品:五段連續生成,四個接點肉眼找不到
成片 25 秒、1344×768、24fps,玉山→太魯閣→101→日月潭→最後拉高看全景。它是五段各 5 秒接起來的,四個接點都落在鏡頭轉頭的時候:白模那一刻只有天空,成品大多是藍天,有的下緣還留一點山稜。
我量接縫的方式是:拿接點那一對相鄰幀的畫面變化,跟整片平常每一格的變化比。1 倍就是跟平常一樣;後面會講的冒煙失敗那發是 5.84 倍。
| 接點 | 時間 | 畫面變化(平常的幾倍) |
|---|---|---|
| 1 玉山→太魯閣 | 5.167 秒 | 1.28× |
| 2 太魯閣→101 | 10.125 秒 | 0.86× |
| 3 101→日月潭 | 15.083 秒 | 0.33× |
| 4 日月潭→全景 | 20.042 秒 | 0.15× |
四個都在 1.28 倍以內,量的是重做結尾後的最終版。肉眼看,四個接點都是藍天連過去,接著下壓露出下一個地標,找不到硬切。
整條流程:
- Blender 白模改成轉頭才露出下一個地標:它先藏在右後方,轉頭時中間 0.9 秒只有天空
- 白模的時間軸對齊 Continuum 的真接點:124 / 243 / 362 / 481 幀
- ComfyUI 裝 Continuum,H3 Ref2VA 照白模走,五段連續生
- 提示詞和參考圖都逐段給,每段只寫自己那一段
- 結尾全景另外加強,讓四個地標同框
白模改成轉頭才露出下一個地標:先藏在右後方
上一篇的白模是一路往前飛,下一個地標一直在前方等著。這篇把每個地標的位置挪了:下一個要去的地方,整組搬到鏡頭右後方,飛這一段時完全看不到它。
四次轉頭的做法都一樣:
- 玉山→太魯閣:峽谷整組旋轉搬到右後方,鏡頭右偏航 120°,抬頭經過天空,再俯回峽谷
- 太魯閣→101:101 和街廓搬到峽谷出口右後方,右偏航 120°,塔從畫面下緣露出來
- 101→日月潭:湖、拉魯島、慈恩塔搬到右後方,右偏航 145°,經過天空後從下緣露出
- 日月潭→全景:右偏航 120°,抬頭讓所有地標離開畫面並升高,再俯回完整場景
每次轉頭 3 秒,正中間有 0.917 秒(23 幀)畫面只有天空,所有地標都在畫面外。鏡頭抬頭最高到 +65°。換段就放在這 23 幀的正中央。
左邊是 Blender 白模,右邊是同一秒的 H3 成品,兩邊同步播放 25 秒。注意每次鏡頭向右轉、畫面只剩天空的時候,就是換段的地方
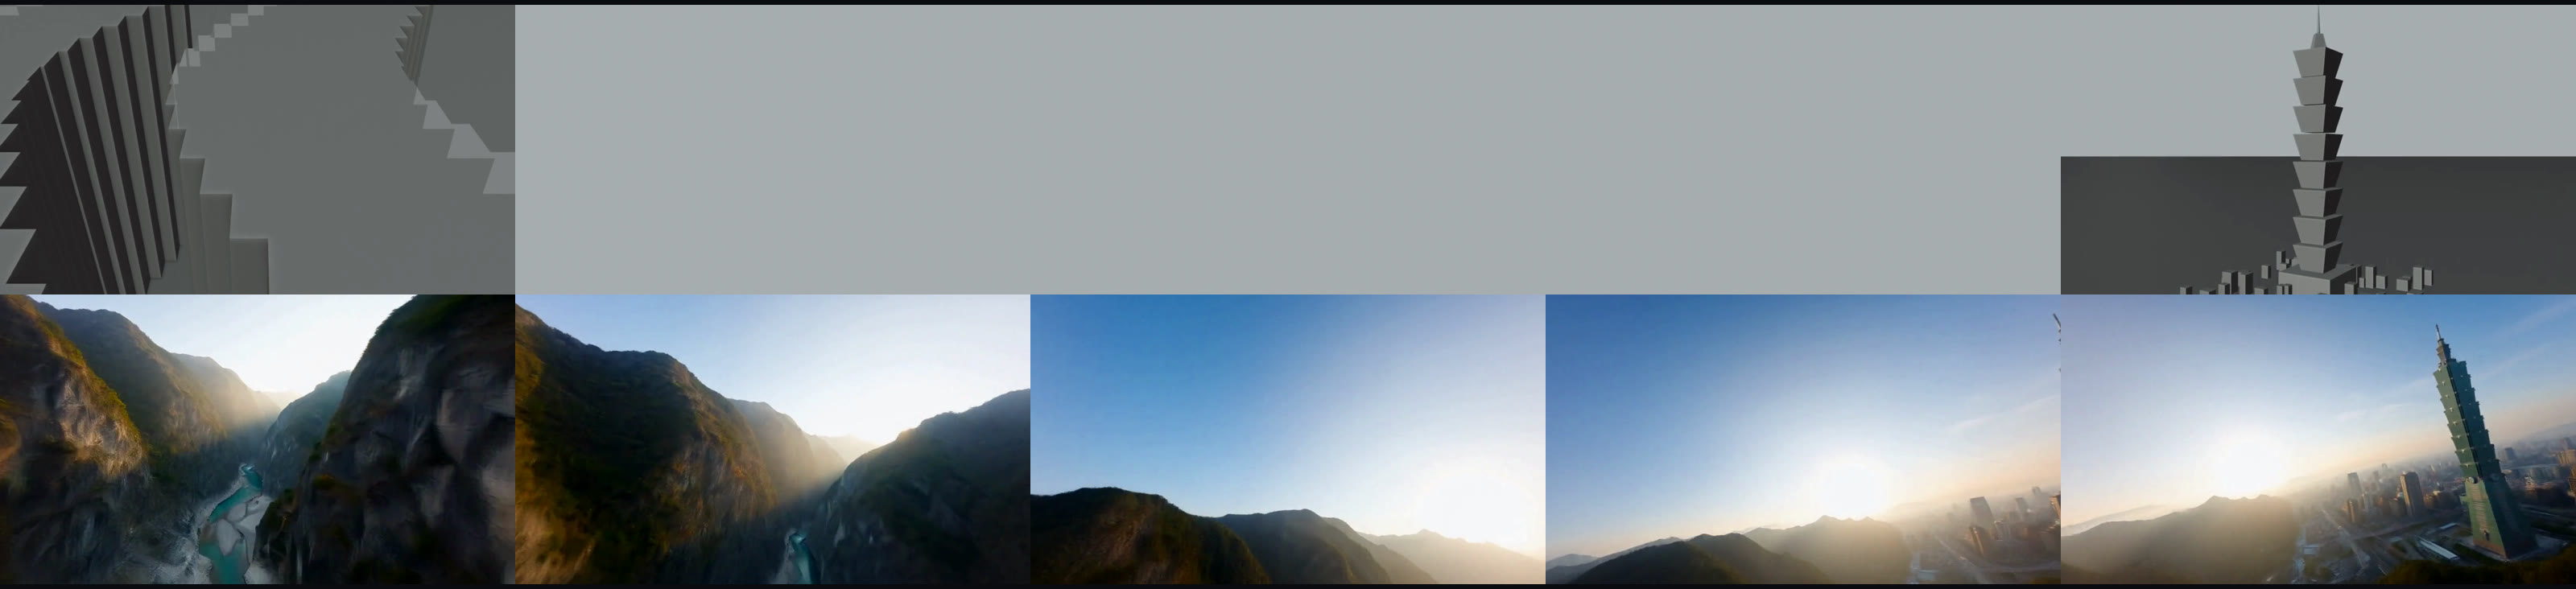
白模一樣用方塊搭,用 CPU 的 Workbench 算圖,不占 5090。白模腳本怎麼叫 Claude 寫,Part 9 有完整說明。
裝 Continuum:git clone 進 custom_nodes,不用裝套件
ComfyUI 是我生 H3 影片用的工具,把模型、提示詞、參考圖接成一張流程圖,按執行就開始生。節點包就是別人寫好、可以直接加進這張圖的新方塊。
ComfyUI-H3-Continuum 是讓 H3 一段接一段往下生的節點包,MIT 授權,不用另外裝 Python 套件。它每段開頭會拿前一段最後幾幀當 context(我用的 Balanced 是 22 幀),聲音也一起延續,所以接點不是兩支片硬拼,是第二段看著第一段的結尾往下生。
我裝的是 v3.9.8:
cd ComfyUI/custom_nodes
git clone --branch v3.9.8 https://github.com/ukr8b3g-cmyk/ComfyUI-H3-Continuum
重啟 ComfyUI 就好。這兩行也可以直接叫 Claude 幫你做,跟它說「把這個 repo 裝進我的 ComfyUI」就行。Workflow 從 repo 裡的 examples/workflows/MiniMax_H3_Continuum_V39.json 改起,模型沿用上一篇的 MiniMax-H3 Ref2VA(給它參考圖和參考影片、讓它照著生的那個版本)。
下面是我最後的設定。看不懂的行先跳過,這篇真正要改的只有四行:Chunks 5 · 每段 5 秒 決定切幾段、Follow Timeline 讓每段照白模那幾秒走、Prompt 和 Reference Use 讓提示詞與參考圖逐段給。其餘是模型檔名和畫質設定,沿用上一篇。
Ref2VA     minimax_h3_ref2va_pruned_nvfp4
TE         qwen3vl_32b_minimax_h3_nvfp4_awq
VAE        video fp16 · audio fp32
Manual 1344×768 · 20 steps · res_multistep / simple · seed 2026101702
Chunks 5 · 每段 5 秒 · context Balanced 22 frames · audio continuity on
Video Reference Mode   Follow Timeline
Prompt                 Timeline,[Chunk 1] 到 [Chunk 5]
Reference Use          Per chunk
Spectrum 關 · 不用 Turbo LoRA
Finalize buffer_backend   RAM
Follow Timeline 是每段只拿白模對應那段時間的畫面當參考,不是每段都從白模開頭看起。最後一行 RAM 是踩過坑才改的,原因放在進階。
Ref2VA 那行是我本地的 NVFP4 量化檔,官方 repo 裡沒有這個檔名。手上沒有的話,用官方的 minimax_h3_ref2va_pruned_fp8_scaled 或 minimax_h3_ref2va_pruned_int8_convrot 代替;文字編碼器 qwen3vl_32b_minimax_h3_nvfp4_awq 官方有。
接點不在整數秒:天空要對準 124、243、362、481 幀
每段 5 秒,接點不就在 5、10、15、20 秒嗎?讀了 Continuum 的原始碼才知道不是。
兩條規則:
- chunk 只能等長。 每段長度是全片共用的一個數字,Timeline 裡寫
[0-5s]或[Chunk N]只決定這段用哪段提示詞,不會改這段生多長。 - 真接點不是整數秒。 H3 的幀數要落在 17 的倍數加 5,第一段 5 秒是 120 幀,往上對齊到 124。之後每段生 141 幀,前 22 幀是前一段的結尾,扣掉後每段新增 119 幀。
所以四個真接點在 124 / 243 / 362 / 481 幀,換成秒是 5.167 / 10.125 / 15.083 / 20.042 秒,全片 600 幀剛好 25 秒。
我第一版白模的天空中點在 3.5、8.5、14.5、20.5 秒,完全對不上。於是只改時間軸:轉頭一樣各 3 秒、偏航角一樣 120 / 120 / 145 / 120 度、地標擺位一格都沒動,只挪每次轉頭的時間點,讓四個天空的中點剛好落在真接點上,誤差 0。
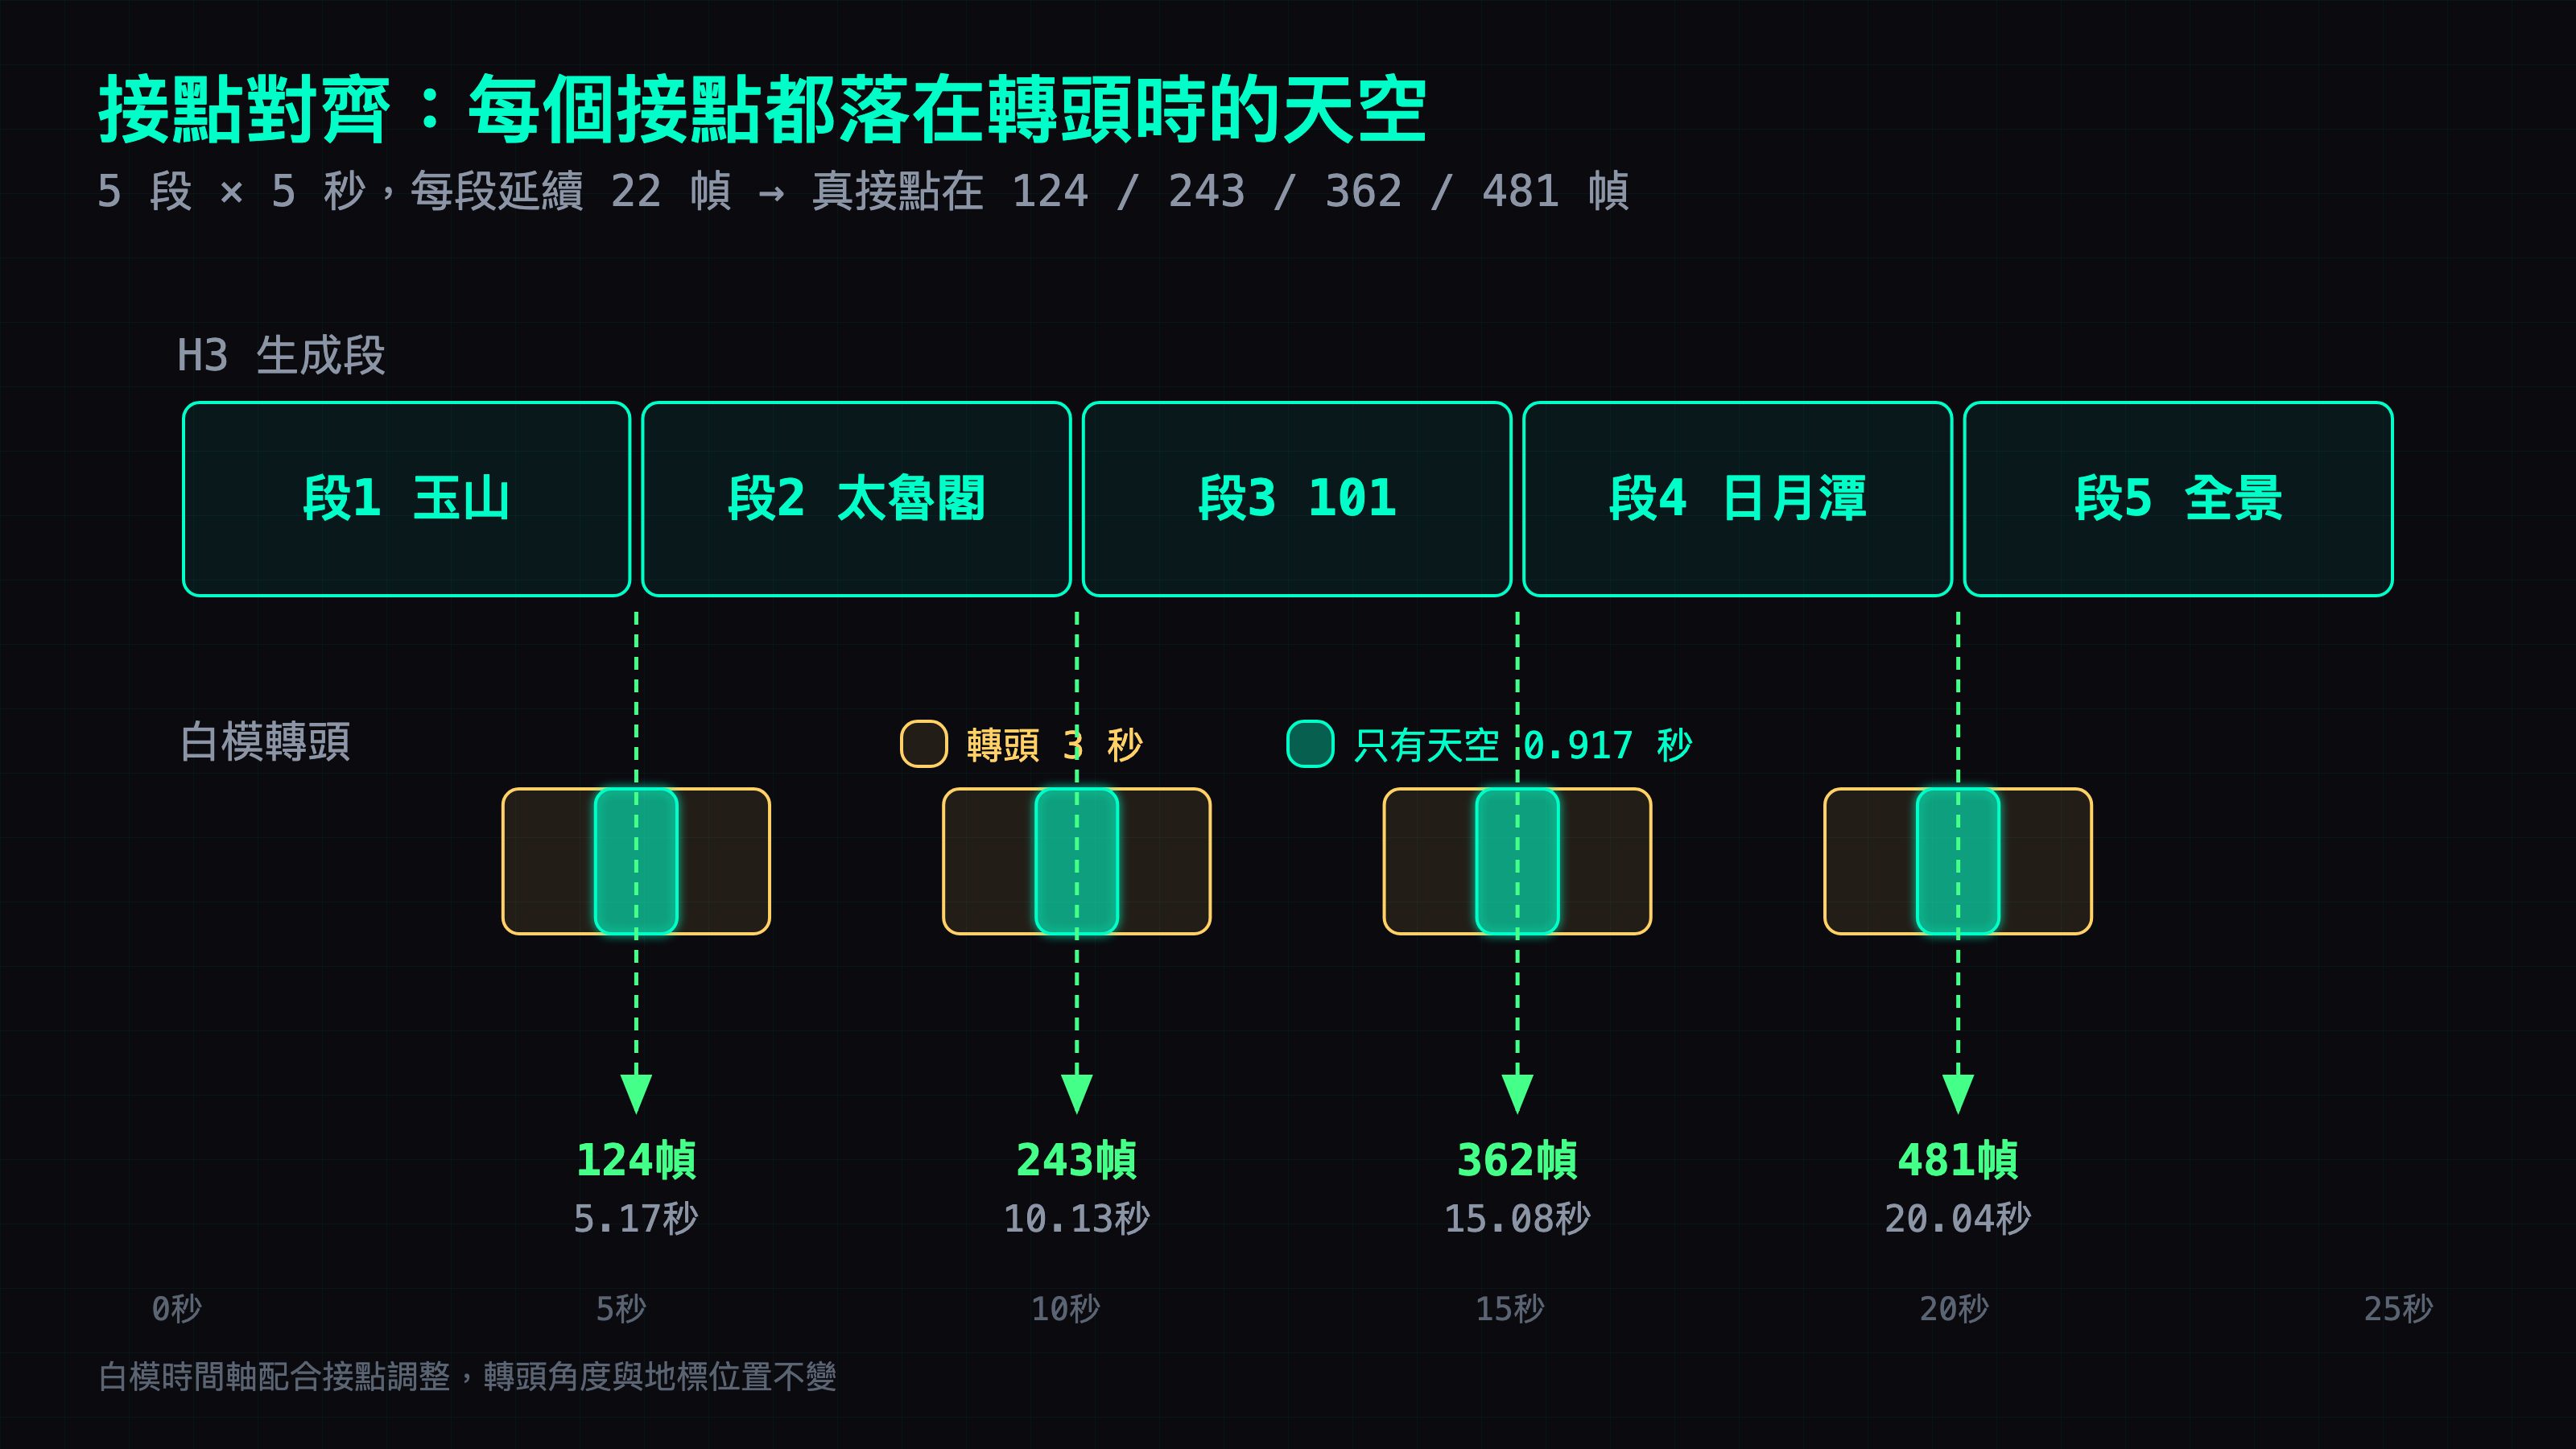
如果你改成每段 4 秒或 6 秒,接點會跟著變,照同一個算式重算一次:第一段幀數往上找最近的 17k+5,之後每段加 119(或你那個長度對應的數字),再把白模的天空挪過去。
提示詞逐段寫:每段只寫自己那一段
這是我踩最大的坑。冒煙那發兩段用同一份提示詞,寫的是上一篇第一段完整的故事(從山頂飛進雲海再到峽谷),三張參考圖也每段都掛。結果第二段把故事從頭再演一次:
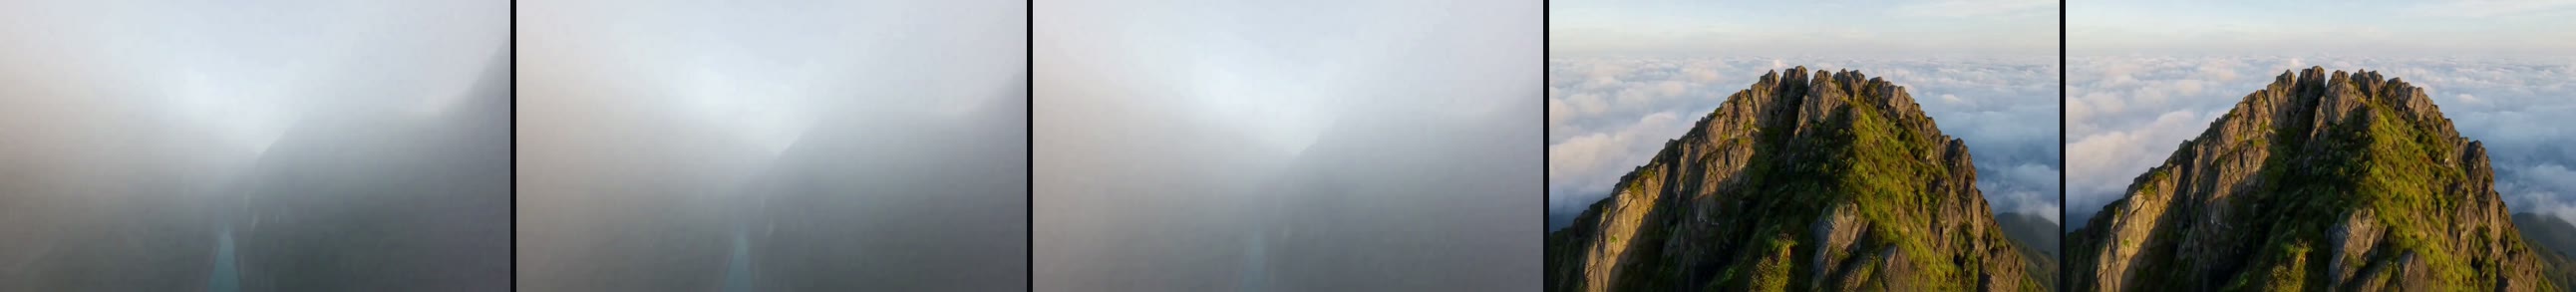
正式版改了三件事:
- 每段只寫自己那一段。 Timeline 用
[Chunk 1]到[Chunk 5]一段一段寫,不在第二段重複第一段發生過的事。 - 轉頭寫成主動運鏡。 不是寫「接下來是太魯閣」,是寫「鏡頭向右急轉、抬頭掠過晴朗天空、再俯衝向太魯閣」,段尾停在天空,下一段從天空接著轉完。
- 全片不寫霧。 fog、mist、雲海、霧、分段邊界這些字一個都沒有,反過來寫 clear、crisp visibility、clean blue sky。
第二段的寫法節錄如下,不用照抄,講清楚每段要看到什麼就好:
[Chunk 2]
subject_definitions:
@R2 defines Taroko Gorge marble cliff faces and a winding turquoise stream.
@R3 defines the upcoming Taipei 101 tower, hidden off to the right.
detailed_description:
Local 0.0-1.50s: resume the same moving camera already looking at clean blue sky,
finish the rightward turn and pitch down to reveal Taroko Gorge entering from the lower right.
Local 1.50-3.46s: accelerate above the winding river between distinct tall textured marble walls,
banking into the channel with strong parallax.
Local 3.46-4.96s: make the next sharp rightward turn, pitching upward until only clear blue sky is visible.
鏡頭向右急轉、抬頭掠過晴朗天空、再俯衝向台北101;結尾停留在持續前進的天空轉頭動作中。
時間寫的是這一段內部的秒數(Local),不是全片的秒數。
參考圖也逐段掛,Reference Use 設 Per chunk。每段掛「這段的地標」加「下一段的地標」,飛過的就不再給:
| 段 | 內容 | 參考圖 |
|---|---|---|
| 1 | 玉山,轉向太魯閣 | 玉山 + 太魯閣 |
| 2 | 太魯閣,轉向 101 | 太魯閣 + 101 |
| 3 | 101,轉向日月潭 | 101 + 日月潭 |
| 4 | 日月潭,轉向全景 | 日月潭 + 全景 |
| 5 | 全景 | 全景(重做後改成五張) |
參考圖是上一篇用 Qwen-Image 2.1 生的那一組,沒有重生。
結尾全景重做:五張參考圖加分區描述,四個地標同框
第一版的最後 21 到 25 秒變成一般的山丘加城市,四個地標一個都認不出來。第 5 段原本只掛全景一張圖,提示詞也只寫「拉遠成廣角全景」,模型就自己隨便填了。
重做只動第 5 段:
- 參考圖從一張加到五張:全景、玉山、太魯閣、101、日月潭。Continuum 一段最多九張,五張沒問題。
- 提示詞把畫面分區講死:左遠方玉山主峰、中景太魯閣峽谷、右側 101 和城市、前景日月潭和唯一一座拉魯島,四區不准混。
- 加一句最後 1.5 秒停止爬升拉遠,穩住全景。
第一次重做四個地標都出來了,但玉山變成畫面中間一座大山,湖裡還長出兩座島。第二次把「遠方獨立主峰」「只有一座島」「最後 1.5 秒停止拉遠」寫得更重,玉山退到左遠方變成尖峰,湖裡剩一座島,四個地標同框。接點 4 的畫面變化是平常的 0.15 倍。
想只重生一段,先把 run_storage 設成 Save + Auto Resume
結尾那兩次我都是整片重跑,不是只重生第 5 段。原因是生成的時候沒有存檔。
Continuum 有 Regenerate From 可以選從第幾段開始重生,但前提是生成時 run_storage 設成 Save + Auto Resume(run_name 是選填,想固定名字再填),它才會把每段存到 output/h3_continuum/runs/ 底下。Progress 打開只是預覽,不算存檔。我那次是 Off,事後只填 Regenerate From=Chunk 5,前四段也變不出來。
整片重跑的代價是每次多等前四段。那前四段會不會跟著跑掉?同 seed、前四段提示詞和參考圖都不動的話,前四段幾乎長一樣。下次開工前我會先開 Save。
還沒做到的
- 101 那段提早露出日月潭:13.5 秒還在 101 近景,右後方已經出現湖和島。第 3 段掛了日月潭的參考圖,模型就提早畫出來了
- 日月潭那段(約 17 秒)有兩座長得很像的塔和好幾座小島,結尾重做時才壓成一座島
- 玉山只畫成左遠方的尖峰,沒畫出參考圖那種鋸齒狀岩脊
- 最後 1.5 秒提示詞要它停住,它還在微微上升拉遠
- 開頭山側有低雲,101 那段的城市和遠山有一層薄霾,不算嚴格的全片無霧
每個版本都只用一個 seed,沒有換 seed 測穩定度。
進階
不讀這節不影響使用。這裡是冒煙失敗那發的完整數字、Continuum 原始碼的規則、量測方法和兩次重跑的紀錄。
冒煙那發:接點一格跳回山頂,5.84 倍
裝好 Continuum 先跑一發冒煙。設定:上一篇的舊白模前 10 秒、2 段 × 5 秒、1344×768、Fixed 提示詞(上一篇 S1 完整 0–8 秒的故事,原樣沿用)、三張參考圖(全景、玉山、太魯閣)每段都掛,Follow Timeline。
生成 710.354 秒,VRAM 峰值 31687 MiB,沒有 OOM。接點在 frame 123→124(0-based),124/24 = 5.167 秒。第 123 幀是被霧遮住的峽谷,第 124 幀已經回到晴朗開闊的山頂。量出來接點 MAD 58.956,段內中位 10.099,5.84 倍。Continuum 的 Finalize 自己也判了 scene_cut=yes、motion_jump=7.11×,保留原本的邊界沒去修,因為那不是閃一下能修掉的東西。
鏡頭也沒跟白模走。6 秒時白模大幅傾斜、貼近一面灰牆,生成的畫面卻是開闊山頂;9 秒白模還貼著牆,生成的畫面已經在峽谷裡正向前飛。
我的判斷是兩個原因疊在一起:兩段同一份提示詞加同一組參考圖,第二段就照提示詞把故事從頭再演;舊白模那 10 秒大多是灰色遮擋,鏡頭貼著牆,能給模型的控制訊號本來就弱。只跑一發,分不出責任在提示詞、白模、Ref2VA 還是 Continuum,但正式版這兩個一起換掉之後就沒再重演。
Continuum 原始碼讀到的規則
以下是 v3.9.8 原始碼。
chunk 只能等長。 constants.py 的 chunk_seconds 是全段共用的一個純量。v2/prompts.py 的 Timeline 標頭可以寫 [0-5s](非負小數秒)或 [Chunk N],時間標頭是用「跟哪段重疊最多」去挑提示詞,chunk 標頭一對一指定,兩種都不會改生成長度。我用 [Chunk N] 避免重疊歧義。
真接點怎麼算。 temporal.py 把第一段向上對齊到 17k+5 格點,5 秒的 120 幀變成 124。延續段在 v2/sequence.py:1049 用「累計目標幀數減去已留存幀數」決定這段要生多長,取最近的格點 total=141、扣掉 22 幀 context,每段新增 119。累計 124 / 243 / 362 / 481 / 600。冒煙那發只有兩段,自然總長 243 幀,Finalize 裁掉尾端 3 幀成 240 幀、10.000 秒。
沒存檔就不能只重生一段。 _preserved_prefix 在沒有 session(run_storage=Off)時一段都不保留。
接點倍率怎麼量
ffmpeg 把成片解碼縮到 96×54 灰階(0–255),逐對相鄰幀算每個像素絕對差的平均(MAD)。基準是全片所有相鄰差排除每個真接點前後各 0.5 秒之後取中位數。接點倍率 = 接點那一對(例如 frame 123→124)的 MAD ÷ 基準。另外存每個接點 ±0.5 秒內 25 對的最大值,避免只報一格。
第一版的基準是 7.017:
| 接點 | 邊界 MAD | 邊界倍率 | ±0.5 秒窗峰值 |
|---|---|---|---|
| 1 | 9.117 | 1.30× | 4.37× |
| 2 | 6.112 | 0.87× | 1.01× |
| 3 | 2.356 | 0.34× | 0.78× |
| 4 | 0.974 | 0.14× | 0.72× |
結尾重做後基準 7.107,接點 4 的 MAD 1.065,0.150 倍,窗峰值 0.755 倍。接點 1 到 3 的 MAD 沒變,用新基準算是 1.28、0.86、0.33 倍,前面成品表用的就是這組。接點 1 到 3 的五幀灰階跟第一版完全相同。
第一版 Finalize Auto 在接點 1 對 1 幀做了曝光和色彩修正,其餘三個接點沒有另外修正,量的是最後輸出的成片。
接點 1 窗內峰值 4.37×:山稜衝進畫面
接點 1 本身 1.30 倍,但前後 0.5 秒內有一格衝到 4.37 倍,在 5.333 秒(frame 127→128)。那是鏡頭從天空往下壓之後,山稜快速從畫面下緣進來的時刻,是鏡頭動作本身的變化,不是接片。逐格看接點前後五幀,找不到硬切,只是俯衝開始得有點急。
另外接點 2 的白模那一刻只有天空,生成畫面下緣還留著一條山稜,沒有完全照白模。肉眼看不出問題,接點也連得上。
磁碟不夠,Finalize 失敗,五段整片重跑
第一次五段都採樣完了,最後 Finalize 卻失敗。它預設 Auto,判斷成片太大就走磁碟暫存,要的空間是成片影像另外預留 2 GiB,共 9,579,266,048 bytes;C 槽只剩 8,780,574,720 bytes。
更痛的是快取沒留下來。第二次只把 Finalize 的 buffer_backend 改成 RAM(當時可用 RAM 49.37 GiB),其他都不動,但 sampler 沒吃到快取,五段全部重採一次,花 1721.584 秒。
C 槽是 1.86TB,只剩 8.2 GiB,主因是 WSL 的虛擬硬碟 ext4.vhdx 吃掉 809.5GB,清完剩 589.7GB。跑 Continuum 前先看一下磁碟,或直接把 buffer_backend 設成 RAM。
整片重跑,前 20 秒幾乎沒變
改結尾時沒存檔,只能整片重跑。兩次都只改第 5 段的提示詞和參考圖,其他全部不動:前四段提示詞逐字相同、參考圖一樣 2/2/2/2、Follow Timeline 的白模和 seed 2026101702 都一樣。執行時印出來的前四段 seed 也跟原版一致。
逐幀比 0 到 20 秒(480 幀):第一次重跑有 476 幀解碼後跟原版完全相同,PSNR 72.54 dB;採用的第二次是 477 幀相同、PSNR 73.729 dB,不同的只有 frame 477 到 479,貼著新的第 5 段。接點 1 到 3 完全相同,接點 4 邊界本身並非 bit-identical(原 MAD 0.974、新 1.065)。
耗時與 VRAM
全部在一張 RTX 5090 32GB(Windows、ComfyUI 0.37.0)上跑,1344×768:
| 發 | 內容 | 生成時間 | VRAM 峰值 |
|---|---|---|---|
| 冒煙 | 2 段 × 5 秒 | 710.354 秒 | 31687 MiB |
| 正式版 | 5 段 × 5 秒(第二次提交) | 1721.584 秒 | 31696 MiB |
| 結尾重做 | 5 段整片重跑,兩次 | 各約 1814 秒 |
VRAM 是每 2 秒抽一次 nvidia-smi 的峰值,總量 32607 MiB,很貼頂但沒有 OOM。正式版含 CPU 重渲白模和量測總共 72.96 分鐘,結尾重做 67.27 分鐘。音訊是 H3 原生的 AAC 32000 Hz。
跟 H3LongVideos 能不能共存
我機器上原本就裝了 H3LongVideos。裝 Continuum 前比對了兩包的 NODE_CLASS_MAPPINGS 和前端擴充名稱,H3LongVideos 那邊是 H3LongVideosV2、H3ShotLength、H3ModelInspector、H3Overlay,沒有同名衝突。重啟一次,兩包的節點同時載入、沒有 import error,H3LongVideos 的五個 Python 檔安裝前後 SHA-256 都沒變。
相關
常見問題
- AI 生長片要拆段,不用霧遮,接縫要藏在哪裡?
- 藏在天空裡。我把下一個地標放在鏡頭右後方,每次轉頭 3 秒,中間有 0.917 秒畫面只有天空,換段就落在這段天空的正中央。25 秒的成片四個接點,畫面變化是平常的 1.28、0.86、0.33、0.15 倍,肉眼看不出接片。
- 用 ComfyUI-H3-Continuum 接片,為什麼第二段會把故事從頭再演一次?
- 我那發兩段用同一份提示詞、同一組參考圖,第二段就從山頂重新飛一遍,接點一格從霧中峽谷跳回晴朗山頂,畫面變化是平常的 5.84 倍。改成每段只寫自己那一段、參考圖也逐段掛之後,就沒再重演。
- ComfyUI-H3-Continuum 每段可以設不一樣長嗎?接點在哪一格?
- 不行,chunk 只能等長。每段設 5 秒時,第一段對齊到 124 幀,之後每段扣掉 22 幀 context(Balanced 設定)新增 119 幀,真接點在 124、243、362、481 幀,也就是 5.167、10.125、15.083、20.042 秒,不是整數秒。
- Continuum 只想重生最後一段,要怎麼設定?
- 生成前就要把 run_storage 設成 Save + Auto Resume(run_name 可填可不填),之後才能用 Regenerate From 選某一段重生。Progress 預覽不算存檔。我沒開,改結尾只能整片重跑;同 seed、前四段不動,前 20 秒 480 幀,第一次重跑有 476 幀、採用的第二次有 477 幀解碼後完全相同。
- 在 RTX 5090 上用 Continuum 生 25 秒 1344×768 要多久?
- 五段一次跑完 1721.584 秒,約 28.7 分鐘,VRAM 峰值 31696 MiB(總共 32607 MiB)。重做結尾那兩次整片重跑各約 1814 秒。
- Continuum 跑完五段,Finalize 卻失敗了怎麼辦?
- 看磁碟。Finalize 預設 Auto 會走磁碟暫存,我 C 槽剩 8,780,574,720 bytes,它要 9,579,266,048 bytes 就失敗了,五段的快取也沒留。把 buffer_backend 改成 RAM 重跑就過了。
接著讀
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
- 2026-09-06[Benchmark] 兩張人設圖餵進去,讓小販跟書生自己演完自相矛盾:MiniMax-H3 Ref2VA 入門
Ref2VA 是 H3 唯一吃得下多張參考圖的模式。用兩張 z-image 人設圖生一段 10.1 秒的雙角色對話,台詞 ASR 逐字比對 CER 6.8%,三個錯字全是同音字。含六段格式全文與節點接線。
- 2026-09-11[Benchmark] 同一句中文台詞,LTX-2.5 用 29 秒、MiniMax-H3 用 81 秒:一張 5090 的實測
同一張 RTX 5090、同一句簡體台詞、同一段雙人對白,兩個會講話的開源影片模型對打。LTX-2.5 出片 28.67 秒,H3 81.22 秒,ASR 逐字比對都是 CER 0%。兩邊峰值 VRAM 都落在 31,7xx MiB,只剩不到 900 MiB。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。