MiniMax-H3 on RTX 5090 · part 15
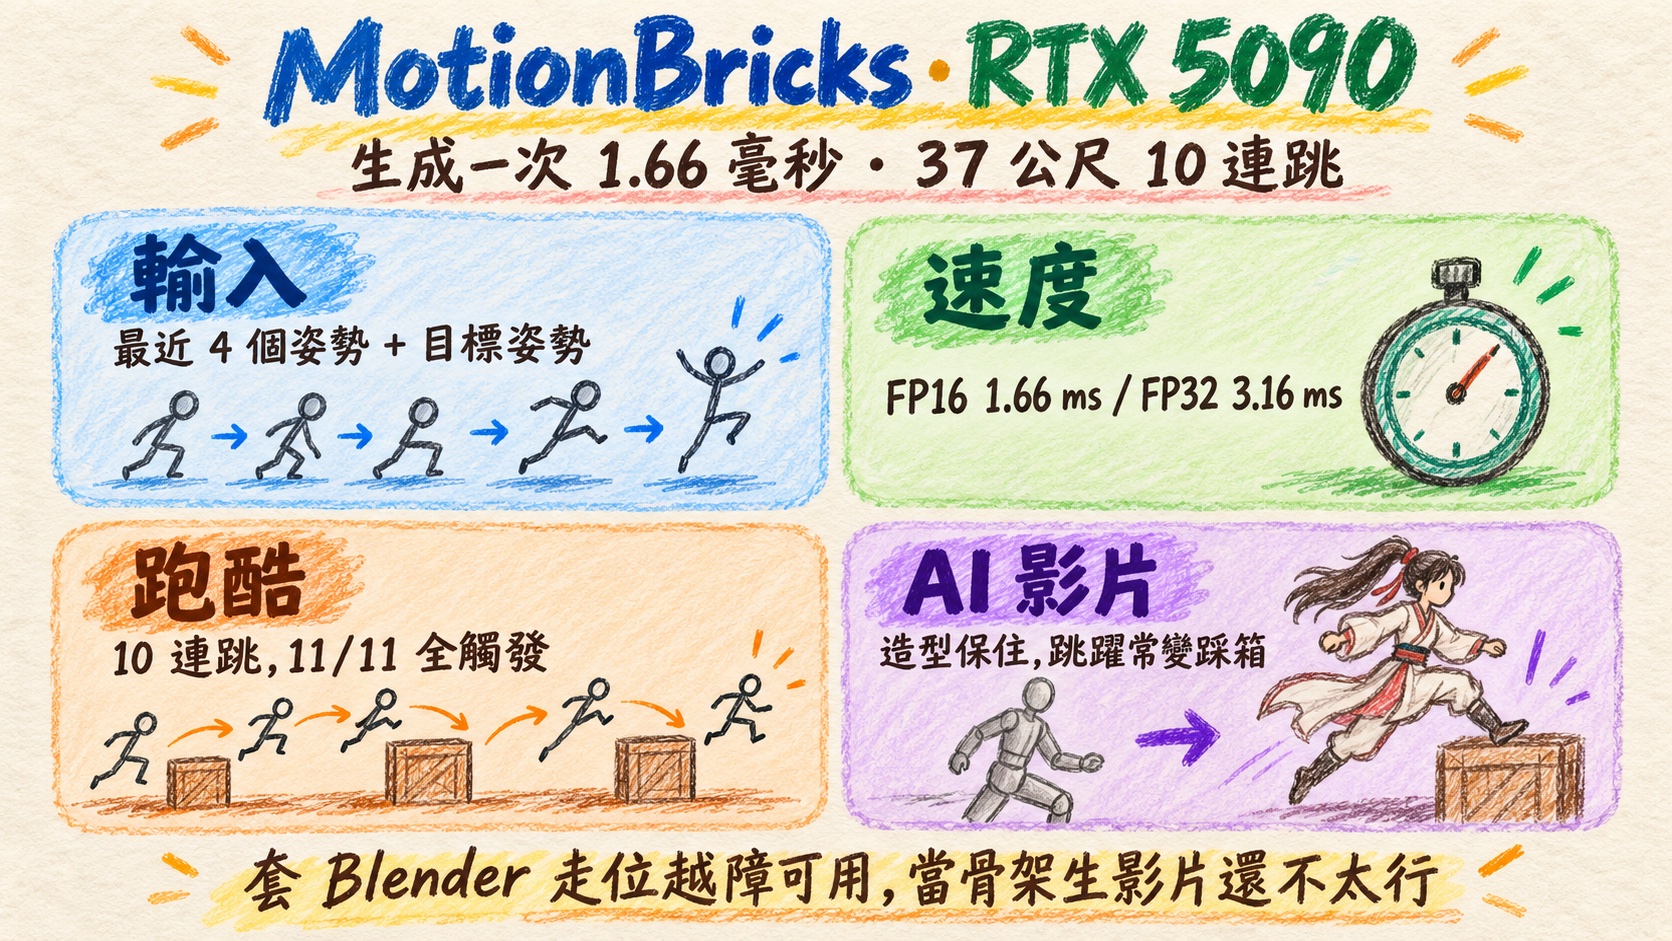
[MiniMax-H3] NVIDIA MotionBricks 在 RTX 5090 上讓角色自己跑酷:1.66 毫秒生成一段動作,再交給 H3 拍成俠女
❯ cat --toc
- 前言
- MotionBricks 是什麼:給它四個姿勢和目標,它補出中間那段
- Smart Primitives:把「跳過 0.5 公尺箱子」做成放在箱子旁的目標姿勢
- 三個模組、約 2 億參數,訓練資料不公開
- 它不是物理引擎:箱子對它來說只是畫面
- RTX 5090:FP16 一次生成 1.66 毫秒,19.4 秒的跑酷 1.015 秒算完
- 怎麼讓它跑酷:把障礙排成賽道,角色走進互動框就自己跳
- 第一輪:31 公尺、六個障礙,四條 take 都過完並坐下
- 第二輪:跑速拉到 6.0 m/s、重組兩種新跳法、10 連跳 20.27 秒
- 灰模交給 MiniMax-H3:衣服和古鎮全程保住,跳躍對不準
- 預演:24 fps、481 幀的古鎮灰模,出灰模版和深度版
- 10 連跳為什麼不能直接拿去生影片?接點會落在跳躍中
- 試片選深度版,20 秒成片送了八次生成
- 自己重現:安裝三步,官方兩個 demo,再寫一支無畫面腳本
- 安裝
- 先跑官方兩個 demo
- 無畫面腳本:重用 Scene Preview 的角色和狀態機
- 走位越障可以用,拿來生影片還不太行
- 進階:完整數據與除錯紀錄
- 跑速掃描:6.5 m/s 腳開始滑,7 m/s 出現離群
- 兩輪每條 take 的檢查數字
- FastJumpBehavior:只提高速度沒用,要略過 approach
- 新跳法怎麼從範例重組
- Blender 渲染:CPU 440.5 秒、5090 OptiX 180.3 秒
- 5 秒接點為什麼無解:跑步空隙最長 0.22 秒
- 第二版接點:9 跳 3/3/2/1,自動試了 497 輪
- H3 每段耗時與提交次數
- 接點 MAD:三個接點約 1.0–1.2 倍段內中位數
- 這次測試的邊界
- 相關
TL;DR
NVIDIA 的 MotionBricks 不吃文字也不吃場景:給它最近四個姿勢和想到達的姿勢,它補出中間 0.6 到 1.9 秒的動作,在 RTX 5090 上一次生成 1.66 毫秒(FP16 中位數)。我用官方的跳箱、翻牆動作,加上自己從範例重組的兩種跳法,排出 37.2 公尺的賽道,灰人偶 10 連跳加坐下,11 個動作全部觸發,20.27 秒跑完。再把灰模預演交給 MiniMax-H3 生成 20 秒古裝俠女跑酷:造型和古鎮全程保住,跳躍時序對不準。它不是物理引擎,最多穿模約 11 公分。
MotionBricks 生成跑酷動作,MiniMax-H3 Ref2VA 照著灰模預演生成的古裝俠女古鎮跑酷,四段 5 秒接成 20 秒,有聲
前言
在 X 上看到 NVIDIA 研究院放出 MotionBricks。官方寫得很大:一個模型涵蓋 35 萬段以上的動作,15,000 FPS、延遲 2 毫秒,SIGGRAPH 2026。UE5 的展示說整段都是神經網路生成的,沒有 foot-lock、沒有動作混接(blending)、沒有碰撞偵測,也沒有人工手調的過渡。另外還看到轉述,說有一位日本開發者把它搬進瀏覽器,用 WebGPU 加 VRM 模型,方向鍵按下去,動漫角色就即時生成動作。這個瀏覽器 demo 我沒找到原連結,這裡只能算轉述。
做過角色動畫的人應該知道這件事為什麼吸引人。傳統做法是走、跑、跳、轉身一段段預錄好,再手寫規則把片段接起來;接得不好,腳就在地上滑,轉身轉得像被人扯過去。另一條路是直接叫 AI 生影片,畫面很漂亮,但動作控制不了:跳幾下、什麼時候跳,你說了不算。
所以我想知道兩件事:官方講的是真的嗎?能不能拿來讓動畫人物跑酷?手邊剛好有一張 RTX 5090,就拿它來跑。
MotionBricks 是什麼:給它四個姿勢和目標,它補出中間那段
給它最近四個姿勢跟想到達的姿勢,它自己把中間那 0.6 到 1.9 秒補起來,在 5090 上一次 1.66 毫秒。
講細一點(GitHub README、Hugging Face model card、論文 arXiv 2604.24833):
- 前情(context):角色最近的四個姿勢,30 Hz。
- 目標(target):一到四個姿勢。只給一個,代表角色要停在哪裡;給多個,連「到那裡時怎麼動」也一起指定。
- 輸出:一次生成 6 到 16 個 token,每個 token 是 4 幀;頭尾各去掉 3 幀之後,大約 0.6 到 1.9 秒的動作。過渡要多長,模型自己決定。
- 長動作怎麼來:播放剛生成的這段,記下最後四幀,當成下一次的前情,再生一段。一直串下去就是連續的走路、跑步。
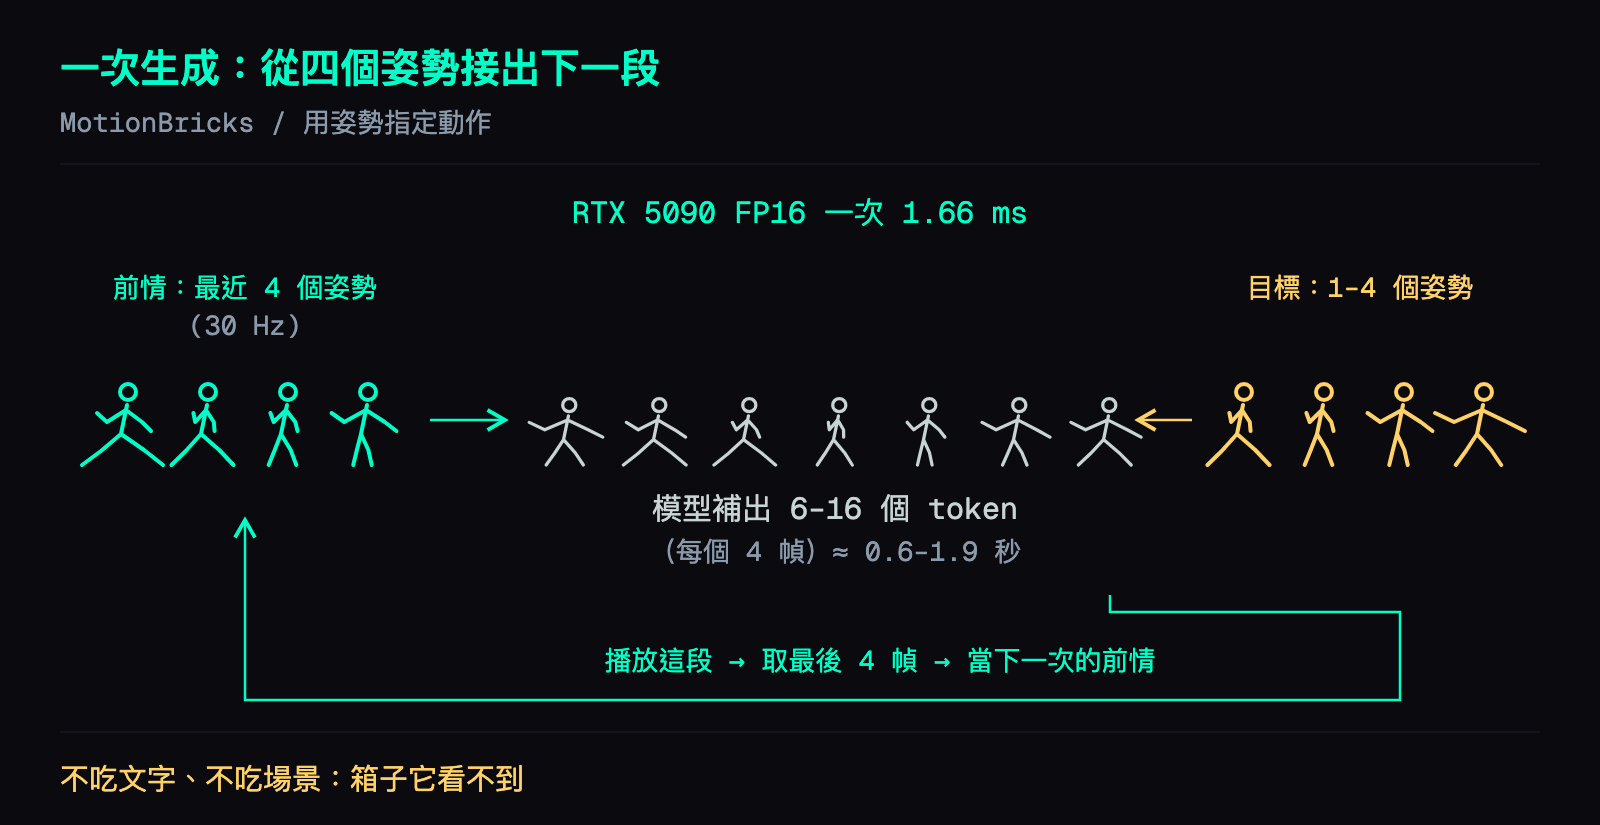
重點是它不吃文字、不吃場景。model card 寫得很直白:沒有文字、圖片、影片或場景幾何輸入。你沒辦法打一句「跑過去跳過那個箱子」,它也看不到箱子在哪。要它跳箱子,你得把「跳箱子」換成一組目標姿勢給它。
Smart Primitives:把「跳過 0.5 公尺箱子」做成放在箱子旁的目標姿勢
這就是 Smart Primitives 在做的事。它把「跳過 0.5 公尺箱子」「坐上椅子」這種動作,包成放在物件周圍的一組目標姿勢(姿勢取自動作捕捉),再畫一個互動框。角色一走進框,就自動觸發,把那組目標依序送給模型。不用重新訓練。
有點像舞蹈教室地上貼的腳印貼紙:貼紙決定你要踩在哪、用什麼姿勢踩;從這一張走到下一張中間怎麼移動,模型自己補。
官方附的有:jump_0_5m(跳過 0.5 公尺箱子)、jump_0_75m(翻 0.75 公尺牆)、avoidance(彎身鑽過或閃過懸空障礙)、sit(坐下),還有走跑的 locomotion 系列,以及 Skipping、Zombie、Combat 等走路風格。
三個模組、約 2 億參數,訓練資料不公開
這節是給想知道模型內部的人看的,只想照著做可以直接跳到下一節。
模型本身分三塊:root module 預測過渡要多長、骨盆(根節點)走哪條路;pose module 是 masked token transformer,沿著那條路預測動作 token;decoder 是有多個 codebook head 的 VQ-VAE,把 token 解回連續動作。SOMA 版約 2 億參數(VQ-VAE 23.4M、pose 136.5M、root 40.4M),骨架是 30 個關節的 SOMA 人體。
另一個家族是 Unitree G1 機器人版,同一套 runtime 驅動。
訓練資料是 Bones RigPlay 1,選用 313,526 段(來源約 35 萬段、700 小時),是談授權拿到的,不釋出。
授權:權重是 NVIDIA Open Model Agreement,可以商用、可以散布修改版;程式碼是 Apache 2.0。repo 附帶的 38 段 BONES 範例動作只限內部評估,這點要注意,因為後面我做新跳法就是從這 38 段裡挑的。
它不是物理引擎:箱子對它來說只是畫面
這是最容易誤會的地方。MotionBricks 生成的是運動學動作,只管每一幀關節在哪,不管力和碰撞。箱子只用來判斷角色有沒有走進互動框、要不要觸發動作,沒有任何碰撞反應;model card 也寫了,生成結果不保證物理上可行。repo 用到 Newton 和 Warp,是拿來畫畫面和跑 runtime 的,要上真的機器人得另外接追蹤控制器。
所以你會看到兩種現象:
- 穿模:腳或骨盆穿進箱子裡幾公分,因為模型根本不知道箱子有多高、邊在哪。
- 滑步:腳著地時還在地上水平移動,因為沒有人把腳釘在地上。
我的跑酷實測,最大穿透 11.44 公分,著地時腳的水平路徑 35 到 47 公分。拿來做動畫預演可以,拿來當要求碰撞可靠的正式遊戲角色,不行。
RTX 5090:FP16 一次生成 1.66 毫秒,19.4 秒的跑酷 1.015 秒算完
摘要裡的 15,000 FPS、2 毫秒沒寫硬體,論文第 7.4 節才寫明是在一台 RTX 5090 桌機上量的;repo 裡的 Python demo 則是在 RTX 4090 上測試。剛好我手上就是 5090,可以直接對照。我用官方的 TensorRT 10.8,repo 一行沒改,在 5090(Blackwell)上就建得出 plan。
FP16 和 FP32 是兩種計算精度,FP16 比較快;中位數是一半比它快、一半比它慢,p95 是 100 次裡只有 5 次比它慢。量法:暖機 10 次,接著 50 次同步 generate(每次前後都等 GPU 做完),只量單次生成,不含播放和存檔。看第一列就好:
| 精度 | 生成中位數 | p95 | 9 秒動作 14 次生成合計 |
|---|---|---|---|
| FP16(官方 mixed) | 1.6581 ms | 2.0701 ms | 0.024677 s |
| FP32(TF32 關) | 3.1565 ms | 3.3127 ms | 0.044821 s |
| FP32(官方預設允許 TF32) | 3.0115 ms | 3.1420 ms | 0.043008 s |
整卡 VRAM 峰值約 3 GB,這還包含桌面和其他閒置程式。
放到實際用途:一條 19.4 秒的跑酷動作,逐幀步進、處理互動、錄下每一幀姿勢,全部加起來實際耗時 1.015 秒,約 19 倍即時。真正花時間的是後面用 Blender 把它渲染成影片。
怎麼讓它跑酷:把障礙排成賽道,角色走進互動框就自己跳
官方的 Scene Preview demo 本來就有 Auto Interact:角色走到物件前,自動跳、翻、鑽、坐。所以跑酷的做法很直接:
- 在場景裡沿一條直線擺障礙,每個障礙掛一個 Smart Primitive。
- 讓角色一直往前跑。
- 跑進互動框就觸發,跳完接著跑,跑到終點的椅子坐下。
Scene Preview 是開視窗用鍵盤操作的,我要批次跑好幾條、還要錄下每一幀姿勢,所以另外寫了一支無畫面的腳本:直接重用 Scene Preview 的角色、狀態機和互動派發,只是不開視窗,起跑前固定亂數種子,跑完把姿勢存檔,再交給 Blender 套灰人偶渲染。怎麼寫放在後面「自己重現」那節。
第一輪:31 公尺、六個障礙,四條 take 都過完並坐下
賽道 31 公尺,每 4.5 公尺一個障礙:兩個 0.5 公尺箱子、兩面 0.75 公尺薄牆、兩個懸空的鑽越障礙(用官方 avoidance 彎身鑽過去),終點一張椅子。全用官方附的 Smart Primitives。
跑了四條:正常跑、Skipping 風格、慢跑、換一種起跑輸入重跑一次。結果:
- 四條都是 7/7 觸發(六個障礙加坐下),全部坐下。
- 零個關節速度離群值(我把單一關節超過 20 公尺/秒當成明顯壞掉的幀)。
- 最大穿透 11.44 公分,發生在 Skipping 翻 0.75 公尺牆;著地時腳的水平路徑 35 到 47 公分。
- 換起跑輸入重跑,關節位置 RMS 差 20.9 公分。這只證明輸入一變動作就跟著變,不能拿來說同一個輸入每次都會隨機不同。
第一輪的灰人偶是在一台 3×2080 Ti 的 Linux 伺服器上用 CPU(Cycles)渲染的。
第二輪:跑速拉到 6.0 m/s、重組兩種新跳法、10 連跳 20.27 秒
第一輪跑得完,但看起來就是「慢跑,偶爾跳一下」。第二輪想讓它更像跑酷:跑更快、跳更多、跳得更密。這裡卡了三個地方。
一、能跑多快? 我在 12 秒直線上,同一個 seed,把跑速指令從 4.5 一路拉到 14 公尺/秒。判斷界線定兩條:著地腳的水平速度 p95 不能超過 4.5 公尺/秒那條的兩倍(超過就是明顯在滑),而且不能有超過 20 公尺/秒的關節離群值。結果 6.5 公尺/秒著地腳 p95 1.528 超標,7 公尺/秒開始出現離群值,9 公尺/秒以上模型連腳什麼時候著地都預測不出來。所以採 6.0 公尺/秒,實速中位數 5.945。
二、範例動作不夠。 官方 38 段範例裡,跳躍只有 5 段。我照 Smart Primitive 的格式,從這幾段裡重新挑時間點、改互動框,組出兩種新跳法:
jump_compact_0_35m:收腿跳過低欄的小跳jump_nohands_0_75m:不扶手直接跨過 0.75 公尺欄
這不是新的動作捕捉資料,只是從同一批範例裡換一種取法。跳上平台、跨溝這類範例庫裡根本沒有的,我就沒做。
三、障礙一密,它就慢下來。 官方的跳躍動作會先走一段「接近」(approach)的目標姿勢,障礙間距一縮短,角色每跳一個都要重新減速對準。我加了一個 FastJumpBehavior:障礙很密時跳過接近那段,只送起跳(Action)和離開(Exit)兩組目標。同一條路線,跑完的時間從 26.3 秒變 20.3 秒,少了 23%。
最後的賽道:37.2 公尺,四種跳法輪流,10 個障礙間距 3.3 公尺,終點坐下。11/11 觸發,20.27 秒跑完。最大穿透 10.93 公分,一樣出在翻 0.75 公尺牆。
MotionBricks 在 RTX 5090 上生成的 10 連跳:37.2 公尺賽道,四種跳法輪流,跑速上限 6.0 m/s,最後坐下,Blender 灰人偶,20 秒無聲
這一輪我把 Blender 也裝到 5090 上,改用 OptiX 渲染。同一支 583 幀的片,CPU 要 440.5 秒,5090 是 180.3 秒,快 2.44 倍。
灰模交給 MiniMax-H3:衣服和古鎮全程保住,跳躍對不準
動作有了,下一個念頭很自然:灰人偶太醜,能不能拿這段動作當骨架,讓 AI 生一支古裝俠女跑酷?
做法跟第 9 篇一樣:白模負責走位和鏡頭,參考圖負責長相,交給 H3 的 Ref2VA(丟參考圖和參考影片進去,生成一支新的有聲影片)。20 秒太長,一次生不完,所以用 ComfyUI-H3-Continuum 每 5 秒生一段,四段接起來。
預演:24 fps、481 幀的古鎮灰模,出灰模版和深度版
參考圖兩張,都是本機生圖模型產的:俠女定裝(墨綠交領勁裝、高馬尾綁紅髮帶、背上一把劍),和一張江南古鎮街景。
預演這邊:
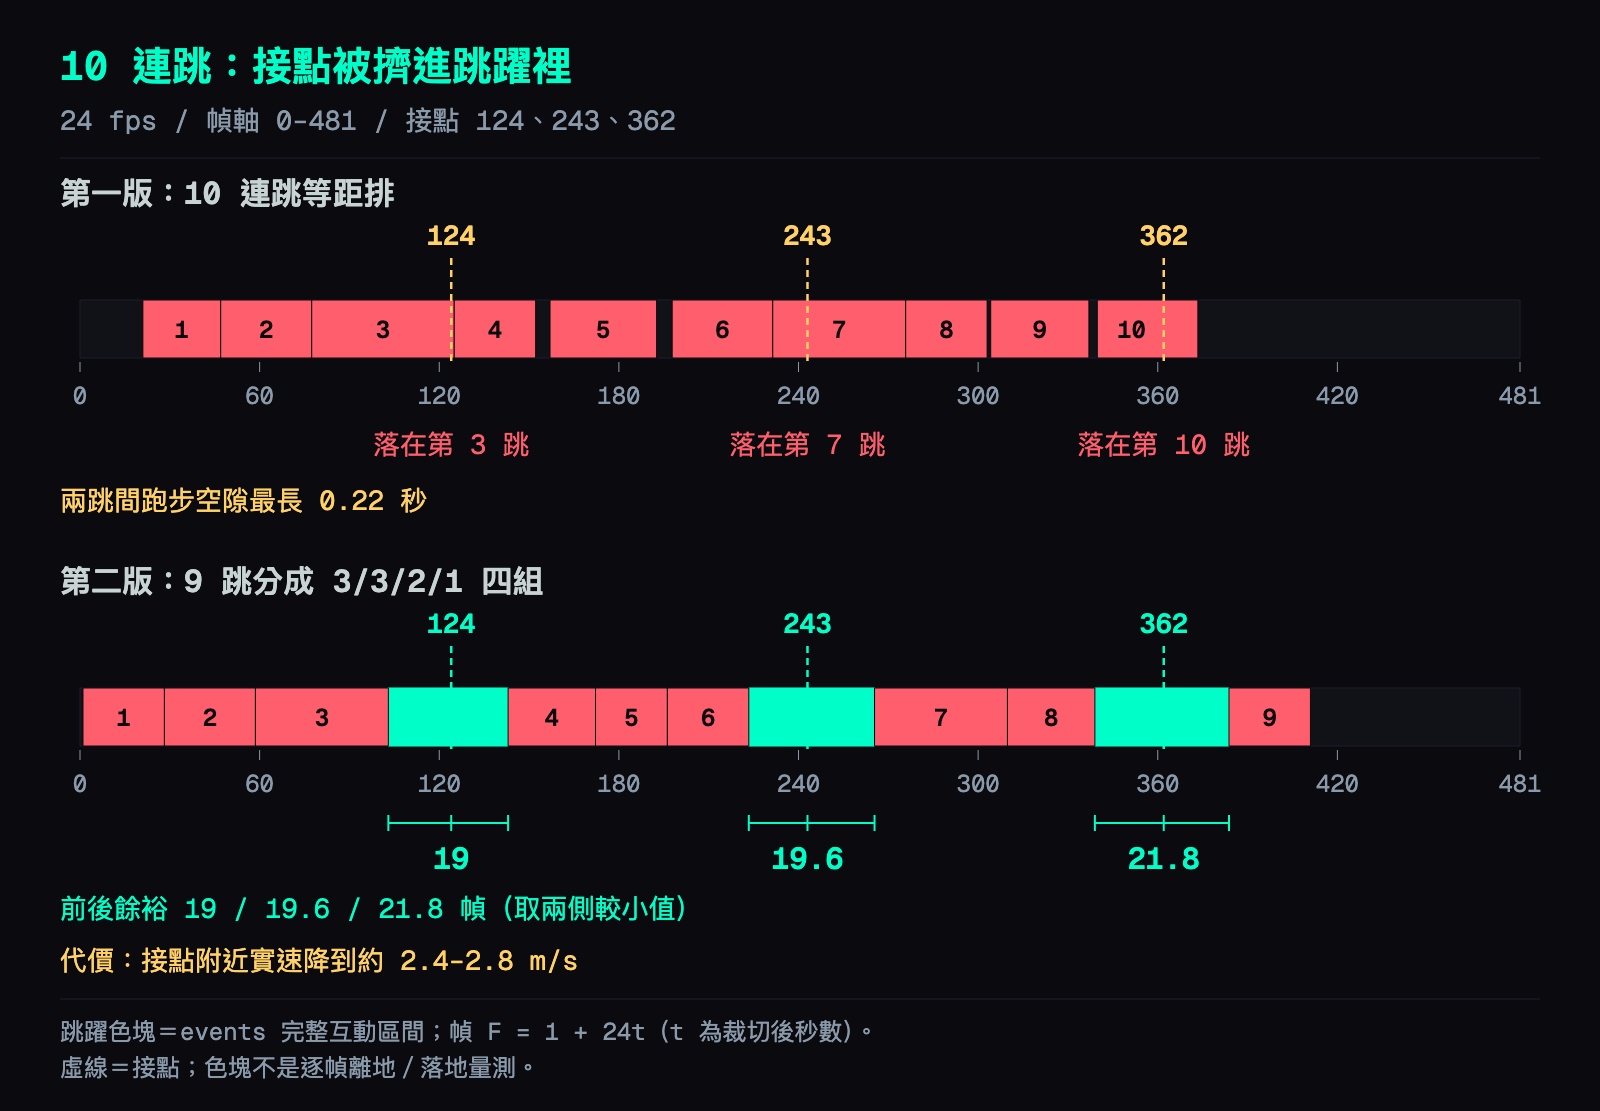
- 動作重新取樣成 24 fps、481 幀,剛好是 Continuum 四段 5 秒,接點在第 124、243、362 幀。
- 場景改成古鎮長街:兩側是建築量體,街尾一座拱橋;障礙換成木箱、竹欄、石牆、木欄杆,終點的椅子換成石墩。
- 鏡頭在側面跟拍。
- 同一個鏡頭出兩版:一般的灰模版,和第 12 篇用過的深度版(越近越亮)。
10 連跳為什麼不能直接拿去生影片?接點會落在跳躍中
這裡卡最久。Continuum 是一段接一段生,下一段從上一段的結尾接著畫;接點如果剛好落在人在空中的那一刻,H3 很容易把那一跳畫壞或畫成兩次。所以接點前後都要留一小段跑步。
問題是 10 連跳的間距只有 3.3 公尺,兩跳之間的跑步空隙最長只有 0.22 秒。三個接點不管怎麼挪,都會落在某一跳裡面;把每段改成別的秒數也一樣無解。
所以第二版預演改成照 5 秒分組排障礙:9 跳分成 3/3/2/1 四組,每組塞在一段 5 秒裡,組和組之間多留一段跑步給接點。三個接點前後的跑步餘裕是 19、19.6、21.8 幀。代價是接點附近人物得慢下來,實速掉到大約 2.4 到 2.8 公尺/秒。
試片選深度版,20 秒成片送了八次生成
正式生成前先試片:同一個 seed,只換參考影片,灰模版一支、深度版一支。兩版都保住了造型和古鎮,但深度版的跳躍時機比較貼近預演,所以選深度版。1344×768 每 5 秒一段約 5 到 7 分鐘。
成片 20 秒,總共送了八次生成:兩次試片、四段正式生成、第 2 段和第 4 段各重試一次。上面是灰模預演,下面是 H3 成片:
上:MotionBricks 動作加 Blender 古鎮灰模預演;下:MiniMax-H3 Ref2VA 照著深度版預演生成的俠女成片,四段 5 秒接成 20 秒,時間軸對齊,無聲
做得好的:
- 墨綠勁裝、紅髮帶、背劍和古鎮街景,20 秒全程沒跑掉,沒有冒出灰人偶。
- 三個接點看不出來,用畫面切換偵測(
scene>0.18)掃,硬切 0 次。 - 起跑、幾組障礙、最後減速轉身坐上石墩,大致的動作階段都有跟上。
做不好的:
- 跳躍常變成踩上木箱再下來,不是跳過去。
- 跳幾下、什麼時候跳都對不準,尾段還多了一次小跳。
- 店招上是假字。
- 為了讓接點落在跑步段,接點附近人物慢下來,我自己看完的感想是速度感不夠,但蠻有趣的。
自己重現:安裝三步,官方兩個 demo,再寫一支無畫面腳本
安裝
先裝 Git LFS 和 uv,clone NVlabs/motionbricks 之後在根目錄跑:
git lfs pull
uv sync
git lfs pull 一定要跑完,模型的 ONNX 檔是放在 LFS 裡的,沒下載完就啟動會直接說找不到檔案。每種模型和精度第一次啟動時會建 TensorRT plan,要幾分鐘,建好會快取在 .trt-cache/,之後就很快。
先跑官方兩個 demo
先看核心概念:自己挑姿勢擺在畫面上,讓它照順序補動作。
uv run python -m app.inbetweener_demo
再看跑酷要用的 Scene Preview:角色在場景裡走、跑、跳、鑽、坐。加 --model-precision fp16 就是上面表格裡 1.66 毫秒的那個 mixed FP16(預設是 FP32)。
uv run python -m app.scene_preview --scene assets/scenes/soma_gym.scene.json
uv run python -m app.scene_preview --scene assets/scenes/soma_gym.scene.json --model-precision fp16
Auto Interact 預設是開的,直接往物件走就會觸發。
⚠️ 如果你跟我一樣是遠端連進 Windows 操作:GPU 程式要在已登入的桌面 session 裡跑,直接從 ssh session 起的程式可能用不到 CUDA。我的做法是讓程式在已登入的使用者桌面上啟動(例如用工作排程器設成「只在使用者登入時執行」),ssh 只拿來看結果。
無畫面腳本:重用 Scene Preview 的角色和狀態機
要批次跑賽道、錄姿勢,就不能靠鍵盤。做法是:
- 用 repo 的 Scene Editor(
uv run python -m app.scene_editor)或直接寫 scene JSON,沿直線擺障礙,每個掛一個 Smart Primitive。 - 腳本裡直接建 Scene Preview 用的那幾個東西:角色(SOMA character)、狀態機、Smart Primitive 素材庫,照 Scene Preview 的方式判斷角色有沒有碰到互動框、有就派發互動,但不開視窗。
- 每一幀送「往前跑」的輸入,起跑前固定亂數種子。
- 每一幀記下世界座標的關節姿勢,存檔,再匯出 BVH 或 GLB 給 Blender。
匯出到 Blender 有一個小地方:GLB 是 30 Hz,匯入前先把場景 FPS 設成 30,Blender 的一幀才會剛好對上一個姿勢,渲染出來的幀數也跟動作檔一致。
這些我都是叫 Claude 寫的。給你參考我大概怎麼講,不用照抄,講清楚你要什麼就好:
我 clone 了 NVlabs/motionbricks。幫我寫一支不開視窗的腳本,重用 app.scene_preview 裡的角色、狀態機和互動派發,
讓 SOMA 角色在我給的 scene JSON 裡一直往前跑、碰到障礙自動觸發 Smart Primitive,最後在椅子坐下。
把每一幀關節姿勢存下來,再匯出成 Blender 讀得到的檔案。跑完告訴我每個障礙有沒有觸發。
幫我在 Blender 裡用灰人偶把這份動作渲染成影片,鏡頭從側後方跟拍,障礙用不同顏色。
有 RTX 顯卡就用 OptiX。
跑出來之後,記得自己檢查有沒有穿模、腳有沒有滑;這兩件事模型不會幫你管。
走位越障可以用,拿來生影片還不太行
跑完一圈,我的結論是:MotionBricks 確實能照你擺的障礙,自動做出對應又合理的動作,套到 Blender 的模型上走路、越障礙都沒問題,在 5090 上一次生成的中位數 1.66 毫秒。拿它當骨架交給 H3 生 AI 影片,造型和場景保得住,但跳幾下、什麼時候跳還對不準,現在還不太行。
進階:完整數據與除錯紀錄
不讀這節不影響使用。這裡放完整數字和查證過程,給想深追、或要把整篇丟給 AI 參考的人。
跑速掃描:6.5 m/s 腳開始滑,7 m/s 出現離群
12 秒直線、沒有障礙、同一個 seed(11),固定 60 Hz 步進。實速和著地腳統計排除前 3 秒加速段;最大關節速度和離群值用全段。品質界線:著地腳水平速度 p95 不可超過 4.5 m/s 基線(0.535)的兩倍(1.070),且不得有 >20 m/s 的關節速度離群。
| 指令 m/s | 實速中位數 | 實速 p95 | 著地腳速度 p95 | 接觸段最大腳路徑 cm | 最大關節速度 m/s | >20 m/s 關節幀 |
|---|---|---|---|---|---|---|
| 4.5 | 4.576 | 4.856 | 0.535 | 2.392 | 11.738 | 0 |
| 5 | 5.058 | 5.402 | 0.630 | 4.005 | 12.549 | 0 |
| 5.5 | 5.368 | 5.971 | 0.785 | 4.769 | 14.196 | 0 |
| 6 | 5.945 | 6.562 | 1.015 | 4.688 | 15.507 | 0 |
| 6.5 | 6.548 | 7.146 | 1.528 | 5.271 | 17.826 | 0 |
| 7 | 7.005 | 7.704 | 1.569 | 6.033 | 20.412 | 4 |
| 7.5 | 7.472 | 8.187 | 1.283 | 3.450 | 41.364 | 127 |
| 8 | 7.986 | 8.731 | 1.221 | 3.483 | 30.670 | 187 |
| 9 | 8.955 | 9.767 | 無足接觸 | — | 30.372 | 151 |
| 10 | 9.757 | 10.817 | 無足接觸 | — | 26.305 | 137 |
| 11 | 10.745 | 11.790 | 無足接觸 | — | 35.055 | 275 |
| 14 | 11.575 | 13.118 | 無足接觸 | — | 44.584 | 602 |
- 7.5 和 8 m/s 的著地腳 p95 反而比 6.5 低,是因為那時已經出現大量離群值,接觸段變短,不代表比較好。
- 9 m/s 以上「無足接觸」,接觸段是空集合,路徑那欄的空白不能當成零滑步。
- 這是本次 12 秒、seed 11、固定 60 Hz 的上限,不是所有場景、所有 seed 的普遍模型極限。
- 我只提高了 SOMA 預設 linear 模式的
max_speed(預設 4.5),其他 locomotion 參數沒動。Skipping 風格有自己的上限 1.45 m/s,沒有被硬拉到 6。
兩輪每條 take 的檢查數字
檢查方式兩輪一樣:
- 穿透:四個腳接觸關節加骨盆的中心點,對障礙的軸對齊 box 檢查,進入時取離最近表面的深度。不是完整人體網格碰撞。
- 滑步:接觸值 ≥0.5 算著地,每一段連續著地的水平總路徑;沒有扣掉模型本身的晃動。
- 離群值:60 Hz 關節位置差分算速度,門檻 max(20, 中位數 + 20×MAD),這幾批都落在 20 m/s。
| take | 路線 m | 跳躍數 | 動作秒數 | 觸發(含坐) | 最大穿透 cm | 接觸段最大腳路徑 cm | 最大關節速度 m/s | >20 m/s 關節幀 |
|---|---|---|---|---|---|---|---|---|
| 首輪 run | 31 | 4 | 19.417 | 7/7 | 0.645 | 37.593 | 9.660 | 0 |
| 首輪 skipping | 31 | 4 | 28.967 | 7/7 | 11.440 | 46.852 | 12.299 | 0 |
| 首輪 jog | 31 | 4 | 21.933 | 7/7 | 5.982 | 36.907 | 9.628 | 0 |
| 首輪 run-repeat | 31 | 4 | 19.883 | 7/7 | 8.545 | 35.394 | 10.137 | 0 |
| 二輪 fast-6 | 37.2 | 10 | 20.267 | 11/11 | 10.928 | 40.059 | 14.810 | 0 |
| 二輪 skipping-fast | 37.2 | 10 | 23.250 | 11/11 | 11.945 | 27.368 | 9.796 | 0 |
首輪「跳躍數 4」是兩個箱子加兩面牆,另外兩個鑽越障礙不算跳。首輪 jog 第一版在坐下過渡有 15 個關節幀超過 20 m/s(最大 67.69 m/s),我固定初始化 seed,並在 x>25.5 m 把輸入限制到 0.35 讓它先減速,四條重新生成後全部零超標;沒有對錄下的關節做任何平滑。
FastJumpBehavior:只提高速度沒用,要略過 approach
10 連跳賽道第一次是用原本的三組目標(含完整 approach)跑,把跑速上限從 4.5 拉到 14 m/s,跑完的時間都在 26.033 到 28.400 秒之間,幾乎沒變快。原因是障礙太密:角色一直在「接近 → 起跳 → 離開」的互動裡,平地加速的空間不夠,速度上限根本用不到。
FastJumpBehavior 讀每個跳躍 primitive 原本的 sequence,略過 approach 的 Entry,只把 Action→Exit 兩組目標送給模型,token 限制 6–10。模型、錄好的姿勢、追蹤檔都沒動。同路線對照:原行為 4.5 m/s 26.317 秒,新行為 4.5/6/6.5 m/s 分別 20.767/20.267/20.417 秒,全部 11/11、零離群,採 6.0 m/s。首輪路線和跳躍數不同,所以我不把 19.417→20.267 秒說成「同路線變快」。
新跳法怎麼從範例重組
Smart Primitive 的編輯格式可以指定範例動作的取樣時間,從那個時間點取連續 4 幀(30 Hz)當目標姿勢,再設定階層變換、pivot、互動框、IK pin、token 範圍和目標順序。目標姿勢和 token 範圍是給模型的條件;IK pin 則是播放時再用 IK 把手腳拉到目標位置。整個過程都不是把原本的 BVH 直接播出來。
jump_compact_0_35m:從範例 A437 重新取 entry 1.75 s、action 2.16 s、exit 2.55 s,互動框改成 0.35 m,token 6–10,轉換 4 幀。空中姿態沿用 0.5 m 的樣本,沒有另外的 0.35 m 動作捕捉。jump_nohands_0_75m:只保留 NoHandsJump 那條 sequence,max token 12,最多提前 4 幀轉換。
賽道上四種跳法交替:官方 jump_0_5m 在第 1/5/9 個,官方 jump_0_75m 在第 4/8 個,無手跨在第 3/7 個,收腿低欄跳在第 2/6/10 個,位置 x = 4 + 3.3 × i,終點 37.2 m 坐下。
Blender 渲染:CPU 440.5 秒、5090 OptiX 180.3 秒
Cycles、8 samples、1280×720、30 fps、H.264。時間從渲染迴圈開始算到 PNG 編成影片、做完 contact sheet(縮圖總表),不含 Blender 啟動和建場景。
| 渲染 | 幀數 | 影片秒數 | 渲染+編碼 s | s/幀 |
|---|---|---|---|---|
| 首輪 Linux 伺服器 CPU / run | 583 | 19.433333 | 440.470 | 0.7555 |
| 首輪 Linux 伺服器 CPU / skipping | 869 | 28.966667 | 621.720 | 0.7154 |
| 二輪 5090 OptiX / fast-6 | 608 | 20.266667 | 191.246 | 0.3145 |
| 二輪 5090 OptiX / skipping-fast | 698 | 23.266667 | 220.772 | 0.3163 |
| 二輪 5090 OptiX / 首輪 run 重新渲染 | 583 | 19.433333 | 180.294 | 0.3093 |
最後一列是拿首輪同一份動作檔、同場景、同人偶、同相機重渲,所以 440.470→180.294 秒(2.44×)是同一支片的直接對照。兩台機器的 OS 和編碼器版本不同,這是整條交付流程的對照,不是純 GPU 硬體 benchmark。
5 秒接點為什麼無解:跑步空隙最長 0.22 秒
fast-6 這條 10 連跳,第一跳從 0.83333 秒開始,最後一跳到 15.51667 秒結束,中間任兩跳之間的跑步空隙最長只有 0.21667 秒(5.2 幀)。接點前後各要留一段跑步,兩邊加起來就超過這個空隙了。
我先把每個接點和每一跳的時間區間(前後各放寬 0.25 秒)逐一比對:481 幀從原始動作裡能取的起始偏移只有 0 到 0.25 秒,在這個範圍裡,第 124/243/362 幀三個接點沒有任何一個偏移能全部避開跳躍。而且因為最大空隙本身就不夠,把每段改成其他等長的秒數也一樣無解。所以第一版預演的接點還是落在跳躍中。
第二版接點:9 跳 3/3/2/1,自動試了 497 輪
第二版讓程式自己搜:只改我自己場景裡障礙的 x 座標,每輪都重新跑一次模型生成,再看三個接點的跑步餘裕。安全門檻 18 幀,以事件的閉區間判定,任何漏觸發、沒坐下或餘裕不夠都不選。
- 一開始試 10 跳分 3/3/3/1,前段留不出完整安全窗,坐下也超時,改成 9 跳。
- 四種跳法維持輪流,只換循環起點和組內間距;中途也試了不同 seed 和較長的起跑。
- 有一輪餘裕已經合格,但第三組間距 5.4 m,超過「約 3.3 m」的要求,沒採用。
- 最後選中的那一輪:seed 11,起始偏移 1.0 秒,全組內間距 2.5667–3.4014 m。
| 接點幀 | 成片秒 | 距前一跳結束 | 距後一跳開始 | 最小餘裕 |
|---|---|---|---|---|
| 124 | 5.125000 | 21.0 幀 | 19.0 幀 | 19.0 幀 |
| 243 | 10.083333 | 19.6 幀 | 22.4 幀 | 19.6 幀 |
| 362 | 15.041667 | 23.0 幀 | 21.8 幀 | 21.8 幀 |
代價有兩個:
- 接點窗附近實速中位數只剩約 2.4–2.8 m/s(指令上限還是 6 m/s),因為人物要在組和組之間慢下來等接點。
- 用固定 20 m/s 門檻檢查,第二版有 70 個關節幀超標(8 個 60 Hz 姿勢幀),最大 37.6069 m/s 在左手中指末端;fast-6 是 0。第二版的自適應門檻算出來是 38.4459 m/s,所以自適應判定是 0 個離群值,但那不能說成零尖峰。我沒有平滑或刪幀去蓋掉它,這是預演品質的限制。
H3 每段耗時與提交次數
Continuum 設定:Ref2VA nvfp4、Qwen3VL 32B nvfp4 AWQ 文字編碼器、20 步、1344×768、每段都給同樣兩張參考圖(定裝和街景)、逐段寫 [Chunk N] 提示詞、逐段驗收(Review Each Chunk)。延續段每段 141 幀,含前一段的 22 幀當 context,實際新增 119 幀;累計 124/243/362/481。
| 提交 | 內容 | 端到端秒(含輪詢) | 取樣秒 | 觀測峰值 GiB |
|---|---|---|---|---|
| 1 | 試片 A 灰模版 | 332.0 | 267.7 | 28.116 |
| 2 | 試片 B 深度版 | 317.1 | 267.6 | 31.008 |
| 3 | 成片第 1 段 | 301.8 | 267.5 | 30.993 |
| 4 | 第 2 段初版 | 377.9 | 317.4 | 29.596 |
| 5 | 第 2 段重試 | 377.6 | 318.9 | 31.046 |
| 6 | 第 3 段 | 393.1 | 318.8 | 30.952 |
| 7 | 第 4 段初版 | 423.2 | 319.2 | 31.005 |
| 8 | 第 4 段重試 | 408.2 | 319.7 | 31.030 |
- 成片第 1 段跟選中的試片 B 同 seed、同輸入,解碼後逐幀 MD5 完全一樣。
- 第 2 段初版第一跳晚了約 0.5 秒、三次跨越不清楚,重試時在提示詞裡寫明局部時間窗(0.75–1.97/1.97–2.97/2.97–4.10 秒),重試後看得出木箱→竹欄→石矮牆三次跨越。
- 第 4 段初版坐下成功,但最後一跳延遲又不清楚;重試之後,跨越提早到約 16.3–16.8 秒,但約 17.3–17.6 秒多了一次欄杆跨步,就是成片尾段那一小跳。兩段各只給一次重試,用完就停。
- 峰值是每 3 秒取一次 ComfyUI
/system_stats的整卡用量,不是單一程序的精確峰值。
接點 MAD:三個接點約 1.0–1.2 倍段內中位數
成片相鄰幀亮度差(96×54 灰階、0–255 的 MAD),段內基線排除接點前後 0.5 秒,中位數 10.516589。看第三欄,越接近 1 代表接點跟平常的幀差不多:
| 接點 | 接點前/中/後三對 MAD | 中心 / 段內中位數 | ±0.5 秒內最大倍率 |
|---|---|---|---|
| 124→125 | 8.7515 / 11.4302 / 12.9805 | 1.087× | 1.461× |
| 243→244 | 10.5226 / 12.6470 / 9.2022 | 1.203× | 1.258× |
| 362→363 | 9.1962 / 10.6092 / 11.3823 | 1.009× | 1.138× |
scene>0.18 硬切偵測 0 次,三個接點的前後幀都延續跑步和街景,沒有故事重來。
這次測試的邊界
- 每種設定只跑一次。 速度表是 50 次取樣,但跑酷 take、H3 成片都是單發。
- 穿透和滑步是簡化檢查。 只看腳和骨盆的中心點對軸對齊 box,不是完整人體網格碰撞;互動全部觸發不等於物理正確。
- H3 成片的動作只有大致對上。 逐幀起落、九跳計數和障礙幾何都沒有全過;人物在畫面裡比灰模大,場景也不是逐像素照抄。音軌沒有逐段聽過。
- 5090 能直接建 TensorRT plan 的結論,只適用我這台 Windows 的驅動、Warp、TensorRT 組合。
相關
常見問題
- MotionBricks 是什麼?可以打字叫它做動作嗎?
- 不行。MotionBricks 是 NVIDIA 研究院的即時動作生成模型(SIGGRAPH 2026),只吃姿勢:最近四個姿勢當前情,再給一到四個目標姿勢,它以 30 Hz 補出中間 0.6 到 1.9 秒的動作,過渡多長由模型自己決定。官方 model card 寫明它沒有文字、圖片、影片或場景幾何輸入。要它跳箱子、坐椅子,得用 Smart Primitives 把動作包成放在物件周圍的目標姿勢。
- MotionBricks 在 RTX 5090 上多快?
- 官方 TensorRT 10.8、repo 不用改就能在 5090 上建 plan。暖機 10 次、量 50 次同步生成:官方 mixed FP16 中位數 1.6581 毫秒、p95 2.0701 毫秒;FP32 關掉 TF32 是 3.1565 毫秒。整卡 VRAM 峰值約 3 GB(含桌面)。一條 19.4 秒的跑酷動作,逐幀步進加互動加錄姿勢共 1.015 秒算完。
- MotionBricks 會處理碰撞嗎?為什麼人物會穿進箱子?
- 不會。它生成的是運動學動作,箱子只拿來判斷角色有沒有走進互動框,沒有碰撞反應,model card 也寫生成結果不保證物理上可行。我的第一輪跑酷最大穿透 11.44 公分(Skipping 風格翻 0.75 公尺牆),著地時腳的水平路徑有 35 到 47 公分,也就是會滑步。
- MotionBricks 的人物最快可以跑多快?
- 在我的 12 秒直線測試(同一個 seed)裡,指令上限 6.0 公尺/秒時實速中位數 5.945,著地腳和關節速度都正常;6.5 公尺/秒著地腳水平速度 p95 超過基線兩倍,7 公尺/秒開始出現關節速度離群值,9 公尺/秒以上連腳接觸都預測不出來。這是我定的品質界線,不是模型的普遍上限。
- 能把 MotionBricks 的灰模動作交給 AI 影片模型,生成古裝角色跑酷嗎?
- 能生成,但動作對不準。我把 24 fps、481 幀的古鎮灰模預演交給 MiniMax-H3 Ref2VA 加 ComfyUI-H3-Continuum,四段接成 20 秒。俠女的造型和古鎮全程保住,三個接點看不出來;但跳躍常變成踩上木箱,跳幾下、什麼時候跳都對不準,尾段多一小跳,招牌是假字。
- MotionBricks 可以商用嗎?
- 權重是 NVIDIA Open Model Agreement,可商用、可散布修改版;程式碼是 Apache 2.0。repo 附的 38 段 BONES 範例動作只限內部評估。訓練資料 Bones RigPlay 1 是談授權取得的,沒有釋出。
接著讀
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
- 2026-10-25[MiniMax-H3] 用 16 格分鏡讓本地 H3 演出場景可行嗎?分鏡管構圖、角色圖管長相、時間軸管順序
本地 MiniMax-H3 能不能像線上 Seedance 2.0 全能參考那樣,照一張 16 格分鏡表拍片?丟分鏡表加一句話只對上 3/16 格;把分鏡照官方鏡頭表格式改寫成逐格時間軸、再配角色圖,RTX 5090 一發 339.9 秒拍出 10 秒片、13/16 格對上。含分鏡表與角色圖怎麼生、Ref2VA 接法和坑。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。