MiniMax-H3 on RTX 5090 · part 17
[Benchmark] 沒有顯卡也能跑 MiniMax-H3:Colab G4 一支 10 秒片 66 秒,一小時約 49 支
❯ cat --toc
- 前言
- Colab 的 G4:用 Google 帳號開一張 96 GB 的卡,開著就按小時扣點數
- 熱跑一支 66.1 秒,家裡的 5090 要 82–88 秒
- 開機一小時約 49 支,扣 10 個 CU 左右
- 十支都能看,台詞聽得出來,嘴型沒驗
- 怎麼跑:開一台 G4、裝 ComfyUI 和三個節點、抓四個權重、跑完停機
- 步驟一:裝 colab CLI,先看餘額
- 步驟二:開一台 G4
- 步驟三:裝 ComfyUI v0.37.0 和三個 custom node
- 步驟四:HF token 只上傳一次,下載完就刪
- 步驟五:從固定 revision 抓四個權重,對 SHA256
- 步驟六:開 ComfyUI、送 workflow、取回 MP4
- 步驟七:一定要停機,確認 0 active
- 用我的 runner:上面七步包成一行
- 進階:完整版本、逐支數字、沒採用 WorldForge 的原因
- 完整版本清單
- 每支秒數與 VRAM
- Sol-H3 草稿:L4 241.63 秒,G4 20.00 秒
- CU 兩種算法對不起來
- WorldForge 為什麼沒採用
- prompt 原文
- 量法
- 相關
TL;DR
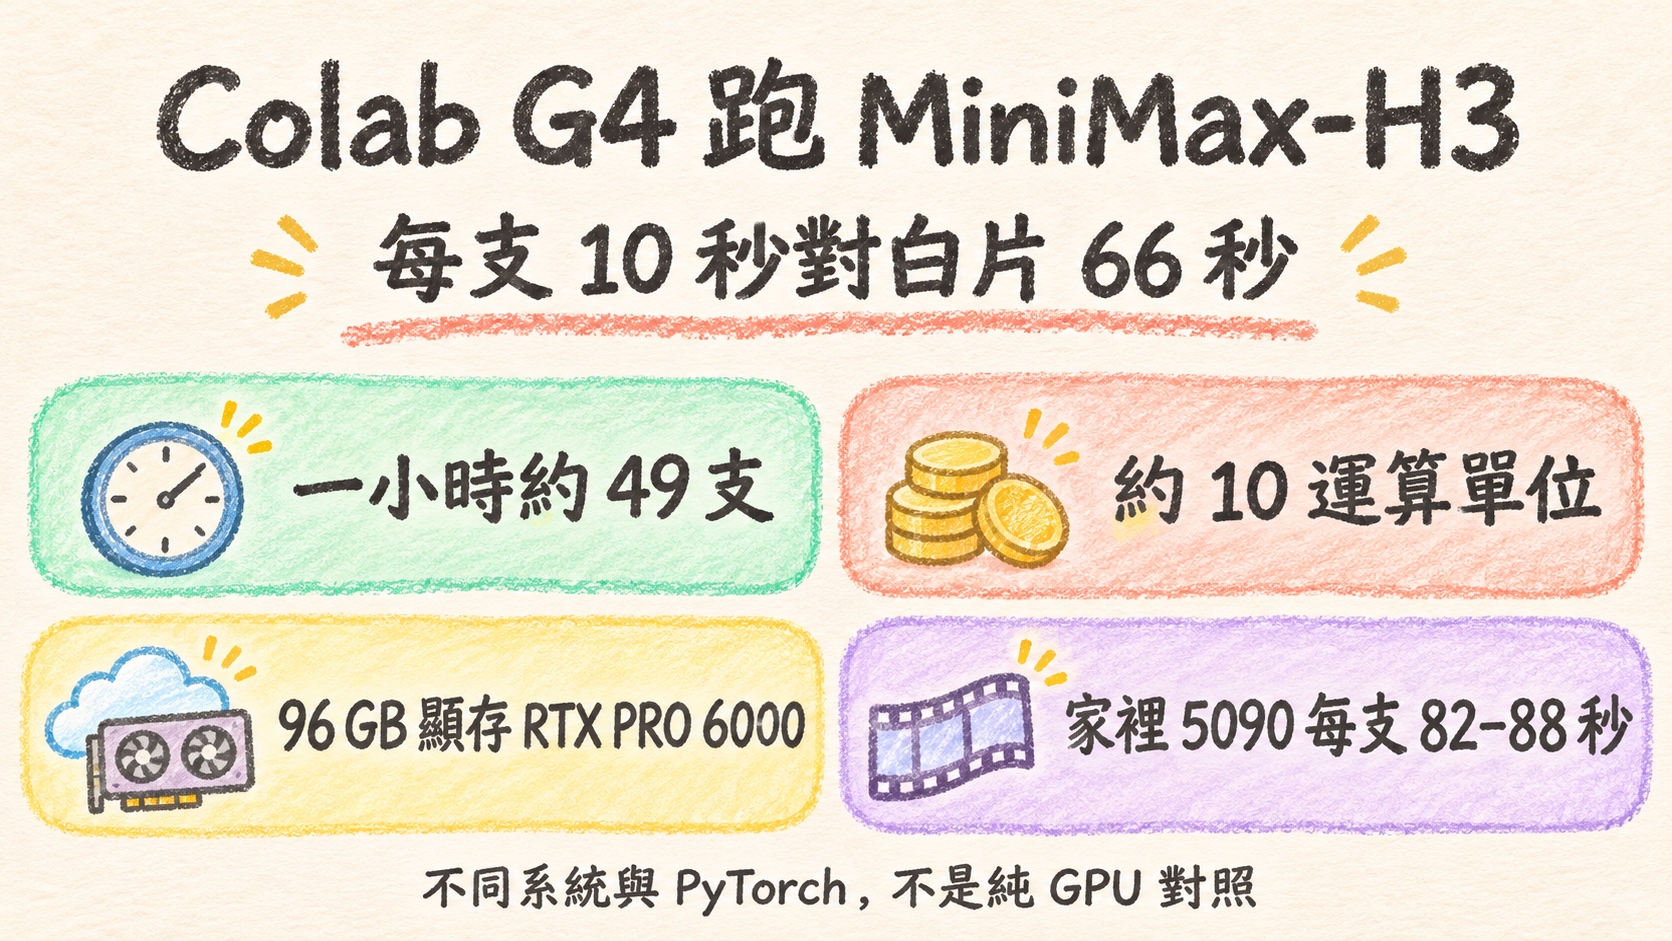
Google AI Pro 帳號開 Colab 配得到 G4(RTX PRO 6000 Blackwell,96 GB)。我把 5090 上的 H3 Ref2VA 雙人對白配方原封不動搬上去,連跑十支 10 秒片:熱跑每支 66.1 秒,家裡 5090 要 82–88 秒。推估開機一小時約 49 支,費率 10.05 CU/hr。做法是用官方 colab CLI 開機、從固定 revision 抓權重、跑完停機。熱跑重用了同 prompt 的快取,每支換 prompt 要另測。
seed 807,G4 熱跑 66.133 秒:夜晚燈籠街口,穿白制服的巡查對穿深藍衣的廖添丁說話。原片 864×480、10.125 秒,有對白聲音
前言
前幾天在 X 上看到 WorldForge 的貼文,一個把 Colab GPU 當遠端工作台的開源專案。照著試跑了一輪,WorldForge 本身最後沒用,但試的過程發現一件事:我的 Google AI Pro 帳號開 Colab,配得到 G4,也就是 RTX PRO 6000 Blackwell,96 GB。
家裡只有一張 5090,一次只能跑一支 H3,要大量出片就得排隊。沒有顯卡的朋友更慘,連 H3 都跑不了。所以我把平常在 5090 上跑的 H3 Ref2VA 雙人對白配方原封不動搬上 G4,連跑十支,看一支要多久、一小時能出幾支、要花多少點數。
上一篇 Part 16 還在 5090 上比 Pika 的 LoRA,這篇換一張不在家裡的卡。
Colab 的 G4:用 Google 帳號開一張 96 GB 的卡,開著就按小時扣點數
Colab 是 Google 的雲端筆記本服務,背後是一台臨時的 Linux VM,開機時可以選 GPU。付費帳號裡有一筆 compute units(運算單位,下面寫 CU),可以把它想成 Colab 的儲值點數:VM 開著,就照 GPU 種類每小時扣掉固定的點數,卡越好扣越快。這次 G4 的費率是 10.05 CU/hr,我的帳號開跑前餘額 392.57 CU。
開始之前先知道三件事:
- 扣點看的是 VM 開了多久,不是生成了多久。 裝環境、下載權重、忘了關機,全部都在扣。
- VM 是暫存的。 停機之後裝好的 ComfyUI 和下載的權重全部不見,下次要重裝、重下載。
- 不用開網頁。 Google 有官方的 colab CLI,在自己電腦的終端機就能開機、丟腳本、拿檔案、停機,這篇全程用它。
這次配到的卡,nvidia-smi 寫 NVIDIA RTX PRO 6000 Blackwell Server Edition、97,887 MiB,是 NVIDIA 放在資料中心用的卡,顯卡記憶體是 5090(32 GB)的三倍。VM 的系統記憶體約 176.88 GiB。
有一點要先講:MiniMax-H3 的社群授權寫明,在美國、英國、歐盟、韓國不能使用它,也不能使用它產出的東西。偏偏 colab new 只能選 GPU、不能選區域,VM 的 metadata 也查不到它實際在哪個區域。要拿成品做正式用途的,先自己讀一遍授權。
熱跑一支 66.1 秒,家裡的 5090 要 82–88 秒
配方就是我在 5090 上平常在跑的那份:864×480、243 幀、24 fps、14 步,三張參考圖(首幀、巡查、廖添丁),prompt 裡寫兩句中文對白,沒掛 LoRA、沒給參考音訊。十份 workflow 除了 seed 和輸出檔名,每個值都一樣,seed 從 801 跑到 810。
看第二列:
| 一支 10 秒片 | |
|---|---|
| G4 冷跑第一支(seed 801) | 73.3 秒 |
| G4 熱跑第 2–10 支(中位數) | 66.1 秒 |
| G4 熱跑第 2–10 支(範圍) | 65.4–66.7 秒 |
| 家裡的 RTX 5090 | 82–88 秒 |
G4 約快 1.24–1.33 倍,每支少 19.4–24.8% 的時間。熱跑九支都落在 65.4–66.7 秒之間,很穩。
這不是純 GPU 的對照。5090 那邊是 Windows、Torch 2.13.0+cu130、開 --use-sage-attention;G4 是 Linux、Torch 2.11.0+cu130、預設 attention。兩邊對齊的是 ComfyUI 核心版本、三個 custom node 的 revision,以及四個權重的 SHA256。
看這個數字還有一個前提:H3 生成前會先把 prompt 和參考圖轉成模型讀得懂的格式(conditioning),熱跑那九支 prompt 和參考圖都沒變,這一步的結果直接重用。所以 66 秒代表的是「同一份配方換 seed」。那每支都換 prompt、換參考圖的批次,一支會多花幾秒?這次沒測。
開機一小時約 49 支,扣 10 個 CU 左右
開機到第一支開始生成,中間要準備約 289 秒:
| 階段 | 秒數 |
|---|---|
| VM 配置 | 3.98 |
| 裝 ComfyUI 與相依套件(鎖定版本) | 119.16 |
| 42.47 GB 權重下載+SHA256 驗證 | 126.154 |
| 全部準備(含上傳、啟動 ComfyUI) | 約 288.7 |
一小時扣掉準備和冷跑那一支,剩下的時間每 66.133 秒出一支:
1 + floor((3600 - 288.7 - 73.287) / 66.133) = 49
這是用十支推出來的,沒有真的跑滿一小時,也沒扣最後取回檔案和停機的時間,長時間跑會不會飄也還不知道。只算準備好之後的熱跑,理論上一小時約 54.4 支。
費率 10.05 CU/hr,開一小時就是 10 個 CU 左右。這批十支實際扣了多少有兩個數字:餘額從 392.57 掉到 390.41,差 2.16 CU;用 VM 開機總時間 1006.389 秒乘費率估是 2.81 CU。兩個對不起來,我照實記,原因放在進階。
顯卡記憶體(VRAM)最高用到 45.38 GiB(每秒用 nvidia-smi 採樣,可能漏掉更短的尖峰),96 GB 的卡用不到一半。
十支都能看,台詞聽得出來,嘴型沒驗
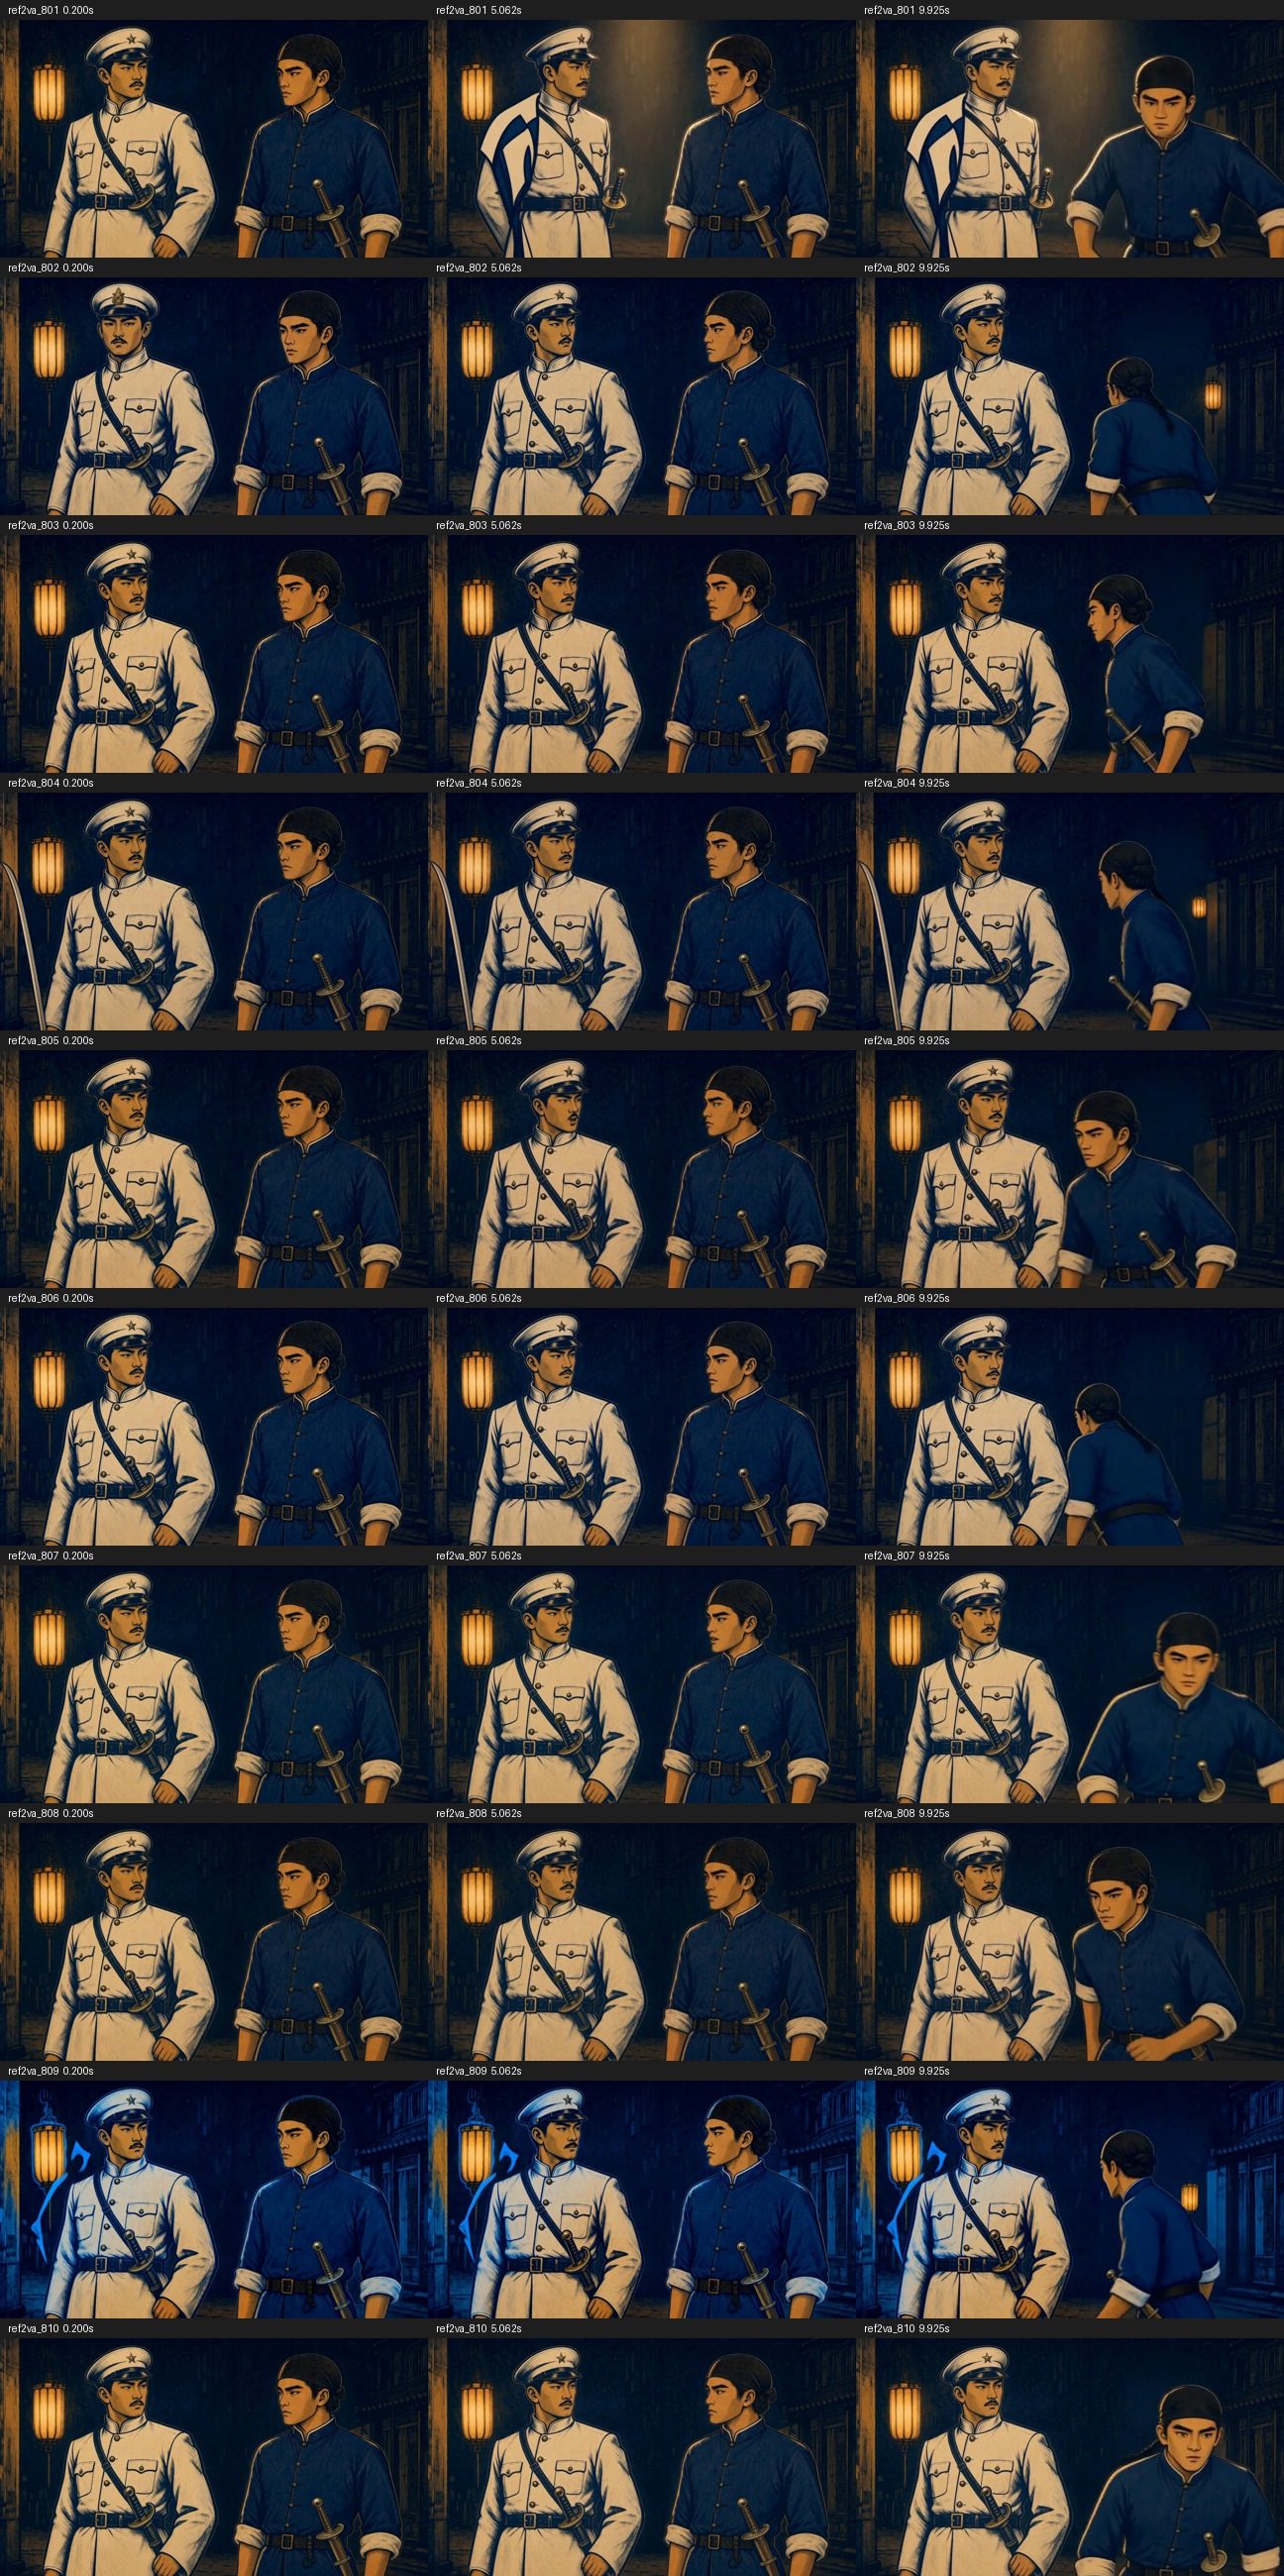
十支各抽頭、中、尾三格排在一起看:巡查和廖添丁兩個角色、燈籠街口、木刻風格大致一致。也有走樣的:seed 809 整支偏藍,801 和 804 畫面邊緣多出旗子或刀形的東西,結尾那段轉身的動作每支都不一樣。
格式這關十支全過:H.264+AAC、864×480、243 幀、24 fps,ffmpeg 完整解碼沒有錯誤,blackdetect 沒抓到黑畫面。
聲音只抽兩支(801、810)丟語音辨識,兩支都辨識成:
站住!你就是廖天丁。是又怎樣?你追得上我嗎?
兩句的順序和內容都對,語音辨識把「添丁」記成同音的「天丁」,其他是繁簡和標點差異。但兩支的第二句都在 8.6 秒左右才講完,prompt 要求 7 秒前收尾,沒守住。嘴型對不對、逐幀畫質,這次都沒驗。
怎麼跑:開一台 G4、裝 ComfyUI 和三個節點、抓四個權重、跑完停機
整個流程其實只有五件事:租一台有 G4 的雲端電腦、裝上 ComfyUI(跑 H3 的軟體)、把模型檔放進去、送工作讓它生成、跑完把電腦還回去。下面七步就是這五件事拆開寫,指令和版本號是給 Claude 或想自己動手的人看的;不想讀指令,把這一節整段丟給 Claude Code,叫它照做就好。
前提是你手上已經有一份跑得動的 H3 Ref2VA workflow(ComfyUI 的 API 格式 JSON)。沒有的話,Part 9 有從零接起來的過程。
步驟一:裝 colab CLI,先看餘額
照 google-colab-cli 的說明裝好、登入 Google 帳號(可以叫 Claude 幫你裝)。裝好先看一次帳戶狀態:
colab usage
會列出餘額、目前的費率和 active assignments。開機前 active 應該是 0,不是 0 的話代表有一台還開著在扣。
步驟二:開一台 G4
colab new -s h3 --gpu G4
colab sessions
-s 後面是你自己取的名字,後面每個指令都用它指定這台 VM。從這一刻開始扣點。
步驟三:裝 ComfyUI v0.37.0 和三個 custom node
這一步把跑 H3 的軟體裝上剛開的雲端電腦。custom node 是 ComfyUI 的外掛,H3 的聲音、省記憶體和加速各靠一個。版本全部固定,跟家裡 5090 那套一模一樣,比較才有意義。要裝的東西:
- ComfyUI v0.37.0
- PyTorch 2.11.0+cu130(torchvision 0.26.0、torchaudio 2.11.0),從 PyTorch 的 cu130 index 裝
- 三個 custom node,固定在指定 commit:
| custom node | 用途 | commit |
|---|---|---|
comfyui-minimax-h3-audio-T8 | 影音 latent 分離 | 6490906 |
ComfyUI-KJNodes | 記憶體用量係數覆寫 | e8e88f7 |
ComfyUI-Spectrum-MiniMax-H3 | Spectrum 加速 | 5161f04 |
完整網址和 commit 放在進階。最省事的做法是叫 Claude 把這些寫成一支 setup.py,再丟上 VM 跑:
colab exec -s h3 --timeout 900 -f setup.py
⚠️ colab exec 就算腳本裡丟了 Python 例外,exit code 也可能是 0。腳本最後印一行自己的成功標記(我的是 REF2VA_SETUP_OK),看到那行才算裝好。
步驟四:HF token 只上傳一次,下載完就刪
抓模型檔要用 Hugging Face token,也就是你 Hugging Face 帳號的通行碼。它等同你的帳號權限,不能留在別人的電腦上,所以我的做法是只傳一次、用完就刪:
- 在本機把 token 寫進一個只有自己能讀的暫存檔(權限 0600)。
colab upload -s h3 <暫存檔> /content/.hf_token傳上去,傳完馬上刪掉本機那份。- VM 上的下載腳本讀完 token、抓完權重,就把
/content/.hf_token刪掉,並確認檔案不存在。
別用 colab exec --env 傳 token,也別把它放進指令參數,那樣會留在本機的 shell history 裡。這段流程一樣可以叫 Claude 寫。
步驟五:從固定 revision 抓四個權重,對 SHA256
H3 要四個模型檔,都放在 Hugging Face 上。每個檔都從指定的版本(revision)抓,不抓最新版,以後 repo 更新了你的結果也不會跟著變。放的位置以 ComfyUI 的 models/ 為根:
| 來源 repo(revision) | 檔案 | 放哪 |
|---|---|---|
Comfy-Org/MiniMax-H3(5447222) | minimax_h3_ref2va_pruned_int8_convrot.safetensors | diffusion_models/ |
Comfy-Org/MiniMax-H3(5447222) | minimax_h3_video_vae_fp16.safetensors | vae/ |
Comfy-Org/MiniMax-H3(5447222) | minimax_h3_audio_vae_fp32.safetensors | vae/ |
Momoking/Qwen3-VL-32B-Heretic-MiniMax-H3-NVFP4(0a9486d) | qwen3vl_32b_heretic_minimax_h3_nvfp4.safetensors | text_encoders/ |
四個合計 42.47 GB,在 G4 上下載加驗證 126 秒。下載完每個檔都算一次 SHA256,這是檔案的指紋,只要差一個位元組就會不一樣;跟你本機跑得動那份比對一致,才代表下載的是同一個檔。完整 revision 和 hash 在進階。我的 runner 下載用的是 huggingface_hub:
from huggingface_hub import hf_hub_download
hf_hub_download(repo_id="Comfy-Org/MiniMax-H3",
                filename="diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors",
                revision="54472221d27c695fca9621b0c3ed52f06c4af707",
                local_dir="/content/ComfyUI/models", token=token)
步驟六:開 ComfyUI、送 workflow、取回 MP4
workflow JSON 和三張參考圖用 colab upload 傳上去。VM 上 ComfyUI 只開在本機位址,不對外開 tunnel:
python main.py --listen 127.0.0.1 --port 8188 --reserve-vram 2
接著把 workflow 一支一支送進 /prompt,從 /history 讀結果,片子生成在 /content/ComfyUI/output/,再用 colab download 拿回來:
colab download -s h3 /content/ComfyUI/output/<檔名>.mp4 ./<檔名>.mp4
這一步也是叫 Claude 寫一支 run.py,用 colab exec 丟上去跑最快。秒數要看 /history 裡的時間戳,不要用本機輪詢自己計的時間。
步驟七:一定要停機,確認 0 active
colab stop -s h3
colab sessions
colab usage
colab sessions 要看到 No active sessions found on server.,colab usage 要看到 Active assignments: 0,才算真的停了。中途下載失敗、生成失敗,也一樣要跑 colab stop,不然 VM 會一直開著扣點,token 檔也可能還留在上面。
用我的 runner:上面七步包成一行
我把上面的流程寫成一支 runner,在自己的專案裡用:
python3 run_colab_ref2va.py --gpu G4 --dry-run
python3 run_colab_ref2va.py --gpu G4 --allow-token-upload
第一行不連 Colab,只檢查 workflow、參考圖和權重清單對不對。第二行才真的開機,它依序做這些事:
- 開機前讀
colab usage:餘額不到 5 CU、已經有 active session、或費率高於 10.05 CU/hr,就直接拒絕,不開機。 - 只開一台 G4,失敗不會自動重開第二台。
- 裝步驟三那套固定版本、上傳 token 一次、照步驟五抓權重並逐檔對 SHA256,抓完刪 token。
- 開 ComfyUI,seed 801–810 連跑十支,每秒記一次 VRAM,每支記
/history的精確秒數。 - 取回十支 MP4,逐支驗格式、幀數、黑畫面、完整解碼。
- 工作時限 1950 秒;另有一個 2050 秒的 watchdog,時間到不管跑到哪都停機。失敗時先存下已完成的片,再刪 token、停機。
這支 runner 綁著我本機的 workflow 和參考圖路徑,不能直接拿去用;想照做的話,把這篇丟給 Claude,叫它照這個流程幫你寫一份自己的就好。
進階:完整版本、逐支數字、沒採用 WorldForge 的原因
不讀這節不影響使用。這裡放完整版本、每支秒數、一組 Sol-H3 的對照、CU 對不起來的帳、prompt 原文,給想深追或要把整篇丟給 AI 參考的人。
完整版本清單
G4 這邊:
- GPU:NVIDIA RTX PRO 6000 Blackwell Server Edition,97,887 MiB;VM RAM 185,477,132 kB(約 176.88 GiB)
- 系統:Linux,PyTorch 2.11.0+cu130、torchvision 0.26.0+cu130、torchaudio 2.11.0+cu130,預設 attention
- ComfyUI:v0.37.0,commit
73c9bad4d21e7addbe1d13bc92eee0f1431b017d - 啟動參數:
--listen 127.0.0.1 --port 8188 --reserve-vram 2
5090 這邊:Windows、Torch 2.13.0+cu130、--use-sage-attention。ComfyUI 核心和三個 custom node 的 revision 跟 G4 相同,5090 上的 git status 都是 clean。
三個 custom node:
comfyui-minimax-h3-audio-T8   https://github.com/T8mars/comfyui-minimax-h3-audio-T8.git   649090681aa11b2082c2beeb09000d8ae939df1d
ComfyUI-KJNodes               https://github.com/kijai/ComfyUI-KJNodes.git                e8e88f7c88e3f6205b122f5de87e69a09fbce5ac
ComfyUI-Spectrum-MiniMax-H3   https://github.com/xmarre/ComfyUI-Spectrum-MiniMax-H3.git   5161f0457bc8c52535212d6783eee73f439e1537
T8 那個用到的是 AV latent separate,KJNodes 用到的是 ModelMemoryUsageFactorOverride。其餘節點(Ref2VA conditioning、SigmaShift、UNET/CLIP/VAE 載入、影片編碼)都是 ComfyUI 核心。
四個權重的 revision 和 SHA256:
| Repo/revision | 檔名 | SHA256 |
|---|---|---|
Momoking/Qwen3-VL-32B-Heretic-MiniMax-H3-NVFP4 / 0a9486d17cfb20c1a7abc97118c4d95910b9b1f4 | qwen3vl_32b_heretic_minimax_h3_nvfp4.safetensors | a166c7bbbe66a22065159e478335fee4a633c4a3e3bb34c8e8ac4cc91bf4996f |
Comfy-Org/MiniMax-H3 / 54472221d27c695fca9621b0c3ed52f06c4af707 | diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors | 9255f52b6677845ad238f20dfaafa94727053694127ab7f255c048f0f9365779 |
Comfy-Org/MiniMax-H3 / 54472221d27c695fca9621b0c3ed52f06c4af707 | vae/minimax_h3_audio_vae_fp32.safetensors | 8e505d95dd1561d47abd43d4238fd40d9bb1ae9e147ed0a4cba778d76ae4db48 |
Comfy-Org/MiniMax-H3 / 54472221d27c695fca9621b0c3ed52f06c4af707 | vae/minimax_h3_video_vae_fp16.safetensors | 7c1f131492e7eddacaac9069a61b81bdd39de5cc96561e677c5eab1cdce5e522 |
四個檔都是 Colab 直接從 Hugging Face 抓的,沒有從家裡的機器上傳任何權重。5090 那邊只讀檔案清單和實際 SHA256,四筆跟 G4 抓到的完全相同。
取樣設定:14 步、res_multistep/simple、shift_video 12、shift_audio 3,Spectrum 開著、參數照 5090 那份原樣保留,ref_image_size 設 match。三張參考圖順序是首幀、巡查、廖添丁。
每支秒數與 VRAM
| Seed | 冷/熱 | ComfyUI 秒 | 峰值 MiB | 格式驗收 |
|---|---|---|---|---|
| 801 | 冷 | 73.287 | 42,243 | PASS |
| 802 | 熱 | 66.372 | 46,435 | PASS |
| 803 | 熱 | 66.663 | 46,467 | PASS |
| 804 | 熱 | 66.351 | 46,467 | PASS |
| 805 | 熱 | 65.539 | 46,467 | PASS |
| 806 | 熱 | 66.297 | 46,467 | PASS |
| 807 | 熱 | 66.133 | 46,467 | PASS |
| 808 | 熱 | 65.861 | 46,467 | PASS |
| 809 | 熱 | 65.400 | 46,467 | PASS |
| 810 | 熱 | 65.893 | 46,435 | PASS |
格式驗收的內容:H.264+AAC、864×480、243 幀、24 fps、容器長度在 9.8–10.4 秒內、blackdetect(d=0.2、pix_th=0.05)沒有黑段、ffmpeg 完整影音解碼的 error log 是空的。
熱跑那九支重用了 ComfyUI 的 conditioning、影像編碼和模型快取,冷跑那支沒有。
Sol-H3 草稿:L4 241.63 秒,G4 20.00 秒
同一天也用 G4 跑了另一條產線,Sol-H3(H3 4 步出 672×384 草稿,再接 LTX-2.5 三步精修到 1344×768)的 2 秒片。workflow、模型、步數、prompt、seed 都跟 9 月在 Colab L4 跑的那次一樣,只差輸出檔名。
| 2 秒 H3→LTX 草稿 | |
|---|---|
| Colab L4(2026-09-29) | 241.63 秒 |
| Colab G4(2026-11-09) | 20.00 秒 |
約 12.08 倍,但兩邊都只各跑了一次。G4 這次的 custom node 是裝上游現行的 revision,沒有重建 9 月 L4 那套完整軟體環境,所以不能把整個差距都算在 GPU 頭上。
CU 兩種算法對不起來
這批十支的帳:
- 開跑前餘額 392.57 CU,停機後 390.41 CU,差 2.16 CU。
- VM 開機總時間 1006.389 秒 × 10.05 CU/hr,估 2.81 CU。
我不確定停機後重查的餘額是不是已經全部結算,所以不把兩者的差當成折扣。兩種算法都低於我給這批設的 6 CU 上限。要估一小時花多少,我用費率算的 10 CU 左右比較保守。
WorldForge 為什麼沒採用
WorldForge 是這篇的起點。我在本機 clone 下來試跑了一輪,G4 第一次就配到,也真的生了圖和影片,但有兩件事讓我不用它:
- 它會把本機的 Google 憑證寫進 VM。
forge_local/app.py連線時,會把本機~/.config/colab-cli/token.json裡的 OAuth refresh token 和 client secret 寫進 VM 的 rclone 設定(token 有 drive.file 權限就會觸發,我的有)。試跑時我在本機那份 clone 的那個函式開頭加了一行return關掉,再到 VM 上確認兩個 rclone 設定檔都不存在。 - 它會改你的提示詞。
remote/diffusers_worker.py預設在一般提示詞後面加 ARRI、85mm、golden hour、porcelain skin、bokeh 這類攝影風格字尾;只有開raw_lens、disable_cinema_lens,或提示詞裡已經有它認得的鏡頭或風格關鍵字,才會跳過。我要的是夜晚木刻版畫,出來是一張亮場攝影風的照片。
另外它在沒掛 Google Drive 時,每次開機都要重新下載權重,那次試跑兩個模型下載就佔了全部時間約一半。
prompt 原文
十支共用這一份(B_en),對白那兩句照原樣用簡體寫在 prompt 裡:
subject_definitions:
<Subject 1> is the middle-aged Japanese constable in <Picture 2>, wearing a white uniform and white peaked cap, with a short moustache and a Western-style police sabre at his waist.
<Subject 2> is young Liao Tianding in <Picture 3>, with his braid coiled inside a black headscarf, wearing a short indigo shirt, black waistband and black leg wraps, with a Western-style police sabre with a brass D-shaped guard at his waist.
<Subject 3> is the nighttime Dadaocheng street corner and lanterns in <Picture 1>, serving as the environment and spatial-layout reference. All characters and objects throughout the film are limited to those specified above; do not add, move or touch any other objects at any time.
<Picture 1> controls the opening composition, character positions and scene state, and must be followed exactly at 0.00 seconds. Reference images lock identity, clothing and environment only; do not inherit their expressions. Fully preserve the identities, clothing and sabres of <Subject 1> and <Subject 2>, and the environment and spatial layout of <Subject 3>; re-perform expressions and actions as specified below.

Voice settings: (S1) corresponds to <Subject 1>, the constable in <Picture 2>: an adult male, medium-low voice, Mandarin, clearly audible, moderate speaking pace, clipped articulation; (S2) corresponds to <Subject 2>, Liao Tianding in <Picture 3>: a young male, medium voice, Mandarin, clearly audible, moderate speaking pace. Keep each character's voice consistent throughout the film. No reference audio.

detailed_description:
【Shot 1 | 0.0–10.125 seconds | Medium shot, two people facing each other】
【Subjects】<Subject 1>, <Subject 2>, <Subject 3>. Taiwanese woodcut print style, indigo, vermilion, ochre, black carved lines and aged paper texture. Beneath lanterns at a nighttime Dadaocheng street corner during Japanese colonial rule, the constable stands in the left third of the frame and Liao Tianding in the right third, facing each other in a medium shot; both faces are visible in three-quarter profile, with empty hands hanging naturally at their sides. Warm lantern light and indigo night tones.
【Camera】Static camera, no cuts, no zoom. Ref2VA, a 10.125-second Mandarin dialogue between two people.
【Actions】
(0.0–0.5 seconds) Both keep their mouths closed and look at each other.
(0.5–3.0 seconds) <Subject 1> (S1) looks at <Subject 2>, juts his jaw slightly forward, and asks in a clipped manner using the voice specified above: <d>[中文] 站住!你就是廖添丁?</d>; <Subject 2> watches the constable with his mouth closed.
(3.0–4.0 seconds) Both keep their mouths closed and maintain eye contact.
(4.0–7.0 seconds) <Subject 2> (S2) first waits until the constable finishes speaking, raises his chin, slightly lifts the corners of his mouth, and answers using the voice specified above: <d>[中文] 是又怎样,你追得上我吗?</d>; <Subject 1> watches Liao Tianding with his mouth closed.
(7.0–10.125 seconds) <Subject 2> closes his mouth, turns around and leans forward preparing to run, without yet leaving his original position; <Subject 1> keeps his mouth closed and stays in place watching him.
【Sound effects】Light night wind throughout, one distant dog bark; no music.
【Constraints】Stable facial features, no facial distortion, lip movements synchronized with dialogue, no visual jumps; consistent character appearance, clothing and lighting throughout. Only the two specified lines: only the current speaker's lips open and close, while the other person's mouth remains closed; do not add, repeat or rewrite dialogue, and do not include narration, humming or any other human vocal sounds; no subtitles, text, garbled characters or speech bubbles in the image; no new characters or props, no drawing of sabres, no swapping positions. All dialogue ends by 7.0 seconds, and there is no dialogue during the final 1 second.
量法
- 每支秒數取 ComfyUI
/history裡execution_success減execution_start的毫秒差,含文字編碼、取樣、解碼、存檔,不含取回檔案。 - 準備時間從 session 建立的 UTC 秒級時間算到第一支的
execution_start,誤差小於約 1 秒,包含安裝、權重下載驗證、上傳參考圖和啟動 ComfyUI。 - VRAM 是每秒一次
nvidia-smi --query-gpu=memory.used的採樣峰值,不是 allocator 的瞬時峰值。 - 語音辨識只跑 801 和 810 兩支,用 CPU 跑,沒算完整 CER,也不把同音字當成發音錯誤。
- 5090 的 82–88 秒是同一份配方在家裡產線的既有紀錄,不是這次同時重跑的。
相關
常見問題
- Colab G4 跑一支 MiniMax-H3 Ref2VA 對白片要多久?
- 864×480、243 幀、14 步、10 秒的雙人對白片,同一台 G4 連跑十支:第一支冷跑 73.3 秒,第 2 到 10 支熱跑中位數 66.1 秒,範圍 65.4 到 66.7 秒。熱跑重用了同 prompt、同參考圖的快取,所以 66 秒只代表同一份配方換 seed,每支都換 prompt 要另外測。
- Colab G4 開一小時能出幾支?要花多少運算單位?
- 推估約 49 支:開機到第一支開始要約 289 秒準備(安裝 119 秒、42.47 GB 權重下載加驗證 126 秒),冷第一支 73.3 秒,剩下的時間每 66.1 秒一支。這是用十支推出來的,沒有真的跑滿一小時。G4 費率 10.05 CU/hr,一小時約 10 個運算單位。
- Colab G4 比 RTX 5090 快多少?是純 GPU 比較嗎?
- 同一份 H3 Ref2VA 配方,G4 熱跑每支 66.1 秒,家裡 5090 每支 82 到 88 秒,約快 1.24 到 1.33 倍。不是純 GPU 對照:5090 是 Windows、Torch 2.13.0+cu130、開 sage attention;G4 是 Linux、Torch 2.11.0+cu130、預設 attention。ComfyUI 核心、三個 custom node 的 revision 和權重 SHA256 兩邊一樣。
- 在 Colab 跑 H3 Ref2VA 要裝哪些東西?
- ComfyUI v0.37.0、PyTorch 2.11.0+cu130,加三個 custom node:T8 的 comfyui-minimax-h3-audio-T8、kijai 的 ComfyUI-KJNodes、xmarre 的 ComfyUI-Spectrum-MiniMax-H3。權重四個,Ref2VA 底模、影片 VAE、音訊 VAE 從 Comfy-Org/MiniMax-H3 抓,文字編碼器從 Momoking/Qwen3-VL-32B-Heretic-MiniMax-H3-NVFP4 抓,合計 42.47 GB。
- Colab 跑完要做什麼才不會繼續扣點數?
- 跑 colab stop 停掉那台 VM,再用 colab sessions 和 colab usage 確認沒有 active session、Active assignments 是 0。VM 開著就照 GPU 種類按小時扣,跟有沒有在生成無關。跑到一半失敗也一樣要停。
- 為什麼不用 WorldForge 在 Colab 跑?
- 兩個原因。它連線時會把本機 Colab CLI 的 OAuth refresh token 和 client secret 寫進 VM 的 rclone 設定;它也預設在提示詞後面加 ARRI、85mm、golden hour 這類攝影風格字尾,我要的木刻版畫風格出來變成攝影照。所以改用自己的 runner。
接著讀
- 2026-11-04[MiniMax-H3] Pika-H3-Flex 在 RTX 5090 實測:快一倍,加 Blender 灰模後 180° 環繞 6 發全中
Pika 出的 MiniMax-H3 官方 LoRA Pika-H3-Flex 6 步生成影片,另有 4 步的 Turbo 版。我在 RTX 5090 用 ComfyUI 實測:5 秒片原版 H3 38 秒、Flex 20.8 秒、Turbo 16.3 秒;只靠文字寫 180° 環繞不穩,餵 Blender 灰模當參考影片後 6/6 繞到對面,Turbo 一支 34 秒。
- 2026-10-25[MiniMax-H3] 用 16 格分鏡讓本地 H3 演出場景可行嗎?分鏡管構圖、角色圖管長相、時間軸管順序
本地 MiniMax-H3 能不能像線上 Seedance 2.0 全能參考那樣,照一張 16 格分鏡表拍片?丟分鏡表加一句話只對上 3/16 格;把分鏡照官方鏡頭表格式改寫成逐格時間軸、再配角色圖,RTX 5090 一發 339.9 秒拍出 10 秒片、13/16 格對上。含分鏡表與角色圖怎麼生、Ref2VA 接法和坑。
- 2026-10-19[AI Workflow] 真人舞蹈轉成深度影片,讓 MiniMax-H3 的古風角色在宮殿跳同一段舞:768 直接生成
看到有人用真人舞蹈帶 AI 角色跟著跳,我想試試 MiniMax-H3 能不能也做得出來,就用本機的一張 RTX 5090 跑了一次:Video Depth Anything 轉深度、Qwen-Image 把角色放進宮殿當第一格、Ref2VA 只給這一張場景圖,768×1376 直接生成再補幀到 48fps。含節點設定、首幀接法、背景跑回白棚的原因和換 seed 的坑。
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。