MiniMax-H3 on RTX 5090 · part 16
[MiniMax-H3] Pika-H3-Flex 在 RTX 5090 實測:快一倍,加 Blender 灰模後 180° 環繞 6 發全中
❯ cat --toc
- 前言
- Pika-H3-Flex 是什麼:掛在 H3 上的 LoRA,分首幀和參考影片兩顆
- Flex 快約 1.8 倍、Turbo 快約 2.3 倍
- 只靠文字叫它 180° 環繞:Flex 兩個 seed 都不到半圈
- 給它一支 Blender 灰模當參考影片:6/6 都繞到對面
- 怎麼跑:五個檔案、三組取樣設定、一支灰模
- 步驟一:下載 LoRA 和 Ref2VA 底模
- 步驟二:三組取樣設定照抄
- 步驟三:解析度用 864×480,不要用 848×480
- 步驟四:在 Blender 做一支 180° 灰模
- 步驟五:接 Ref2VA,原圖同時鎖首幀
- 怎麼選:要快用 Turbo,要指定運鏡就給灰模
- 進階:除錯紀錄與完整數字
- 848×480 在原生 H3 節點報 shape 錯誤
- 白底圖判不了環繞:人自轉和相機繞,畫面長得一樣
- 官方五段 3 秒腳本:俯拍、降到桌高、拉遠做得到,whip pan 不穩
- FastH3 8 步、Sol-H3 兩段式的對照
- 拉長秒數的完整結果
- 灰模的細節:焦距 72%,深度圖也繞得到但沒比較好
- Ref2VA 底模:從 NVFP4 換成 int8,複製了 21 GB
- LoRA 有沒有真的掛上:208 patches 加 strength 0 對照
- 完整 prompt
- 量法
- 這次測試的邊界
- 相關
TL;DR
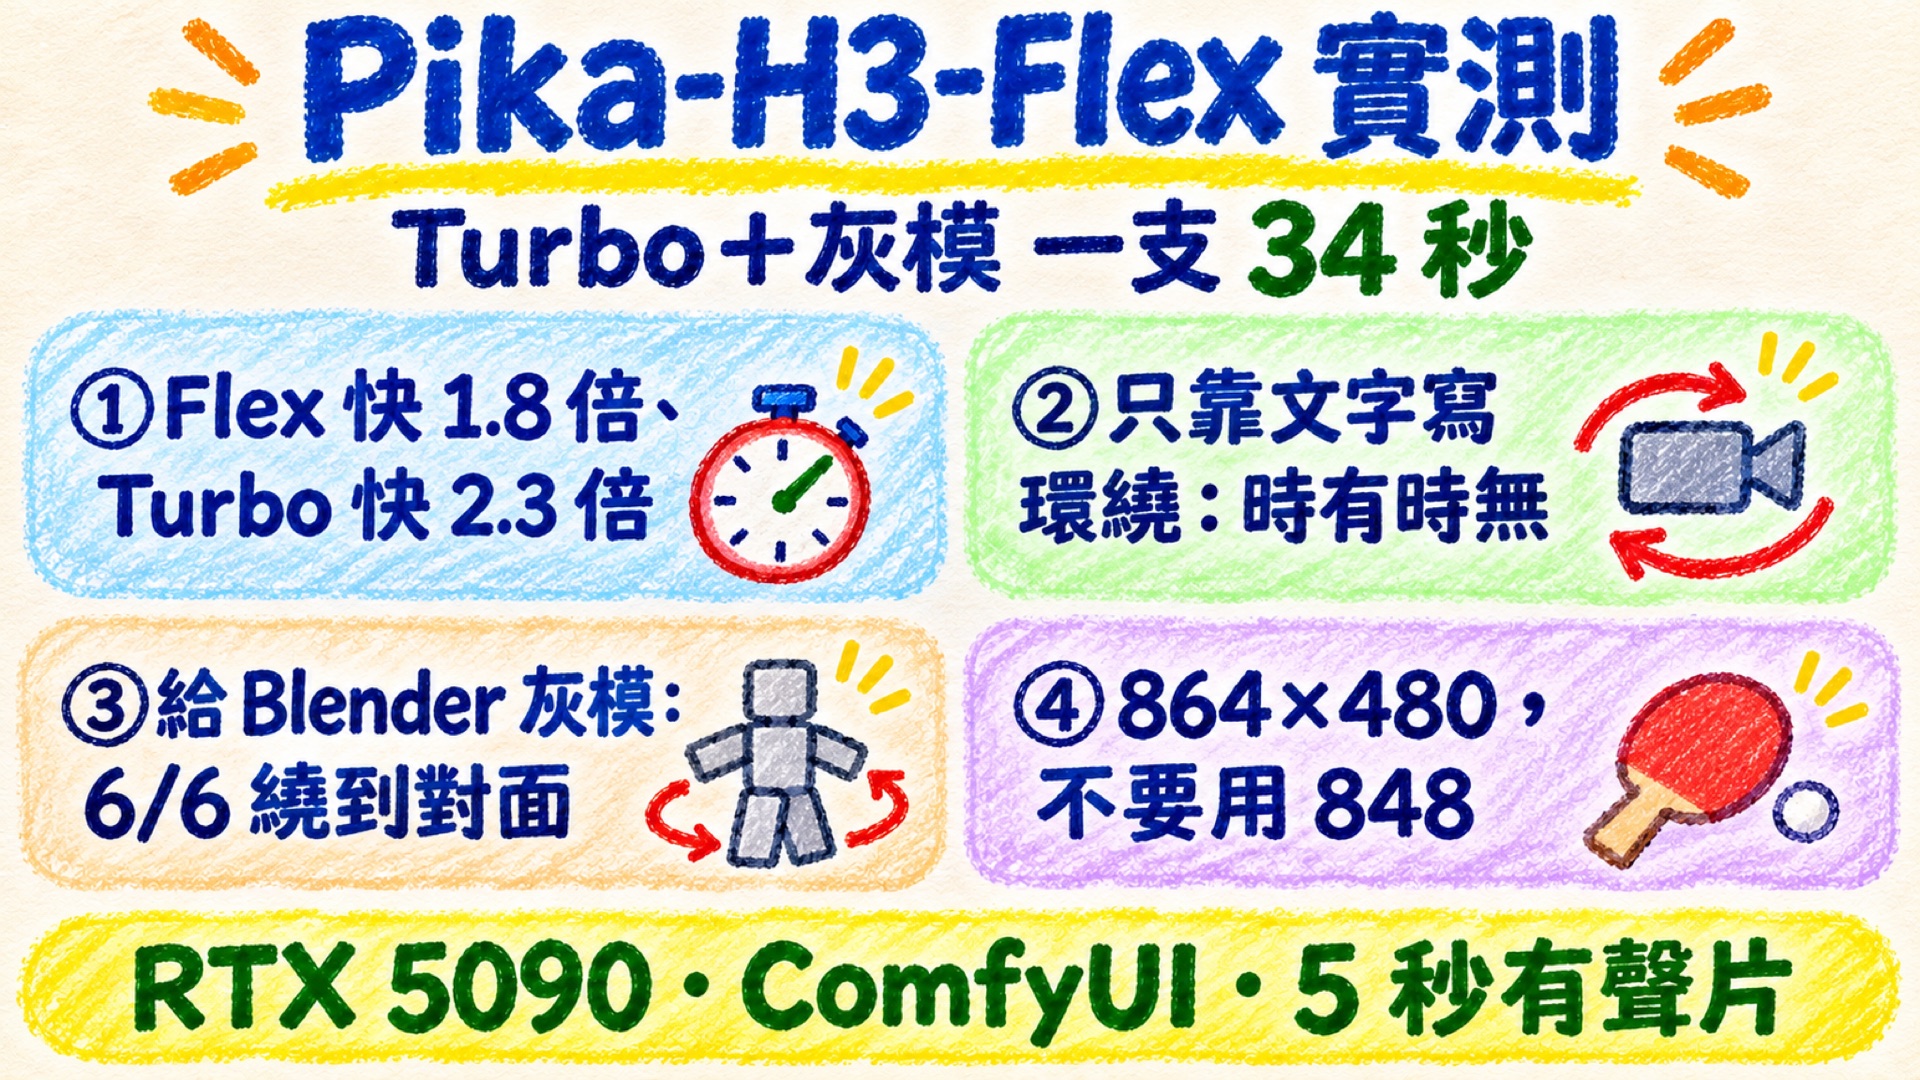
Pika 出的 Pika-H3-Flex 是掛在 MiniMax-H3 上的官方 LoRA,6 步生成影片,另有 4 步的 Turbo 版。我在 RTX 5090 用 ComfyUI 跑 864×480,Flex 比原版 H3 14 步快約 1.8 倍、Turbo 快約 2.3 倍。運鏡光靠文字寫 180° 環繞不穩,Flex 兩個 seed 都沒繞到對面。改餵一支 Blender 灰模當參考影片,三個版本兩個 seed 6/6 都繞到對面,Turbo 一支 5 秒片 34 秒,原版要 97–116 秒。每組設定只跑一到兩個 seed。
seed 42,同一張球桌圖、同一句 180° 環繞:左欄只靠文字、右欄加 Blender 灰模參考影片,由上到下是 H3 原版 14 步、Pika Flex 6 步、Turbo 4 步。原片 864×480、5 秒,無聲
前言
Pika 前幾天放出 Pika-H3-Flex,是 MiniMax-H3 的官方 adapter(掛在原模型上的外掛權重)。模型卡主打兩件事:6 步就生成影片,還有範例 prompt 是用「00:00–00:03 俯拍、00:03–00:06 降到桌高」這種分秒段落寫的運鏡腳本。同一個 Hugging Face 帳號底下,接著又放了 4 步的 Turbo 版。
我現在的 H3 原版設定是 14 步,864×480 的 5 秒片一支 38 秒,加參考影片的版本一支要 100 秒左右。比速度更煩的是運鏡:只用文字叫它 180° 環繞,有時繞得到、有時繞一半就停,常常沒繞到對面。
所以這篇想知道兩件事:Pika 這個版本快多少?運鏡有沒有比較聽話?
Pika-H3-Flex 是什麼:掛在 H3 上的 LoRA,分首幀和參考影片兩顆
Pika-H3-Flex 不是新模型,是 Pika 拿 MiniMax-H3 繼續訓練出來的兩顆 adapter:
- FL2VA:給首幀(或首尾幀)加文字生影片,就是平常的圖生影片。
- Ref2VA:吃參考圖、參考影片、參考音訊,最多 12 個參考檔。
兩顆都是 6 步生成,一樣同時生出畫面和立體聲音軌。本地權重只出得了 480p 和 768p,更高的解析度要走 Pika 自家的付費 API。
Pika-H3-Flex-Turbo-LoRA 也在 Pika-Labs 帳號底下:把 Flex 跟社群的少步數蒸餾 LoRA(lightx2v Turbo 等)疊在一起,合成單一個 LoRA 檔,分 2、4、8 步三種。有一點要先知道:2 步和 4 步的 Turbo 檔裡,Flex 份量是 0.5(8 步 HD 版是 0.6),外面強度設 1 也不等於掛了一整顆 Flex。所以 Flex 和 Turbo 的差異不能全算在「步數少了兩步」。這篇測 4 步,2 步那顆只有 Ref2VA 版,首幀版沒得比。
授權沿用 MiniMax H3 Community License,有地區與用途條款,商用前自己讀一遍。
Flex 快約 1.8 倍、Turbo 快約 2.3 倍
同一張圖、同一段 prompt、864×480、seed 7(亂數種子,同一個 seed 才能公平比),模型都已經載入好(熱機),三個版本各跑一發。看同一列三個數字差多少:
| 片長 | H3 原版 14 步 | Flex 6 步 | Turbo 4 步 |
|---|---|---|---|
| 5 秒(124 幀) | 38.0 秒 | 20.8 秒(1.83×) | 16.3 秒(2.33×) |
| 15 秒(362 幀) | 162.0 秒 | 82.7 秒(1.96×) | 62.8 秒(2.58×) |
這是古風美女那張圖的數字,球桌那張圖差不到 1 秒。原版這邊沒開 Spectrum(我平常會開的一個 H3 加速選項),所以跟我平常產線的秒數不能直接比。
只靠文字叫它 180° 環繞:Flex 兩個 seed 都不到半圈
運鏡我用 Pika 官方的球桌示範圖(乾掉的泳池裡打桌球,一個戴青蛙頭套、一個穿紅色運動服),prompt 只寫一個動作,關鍵句是:
One continuous shot: the camera slowly orbits 180 degrees around the subject over the full five seconds, moving from the opening view through a clear side profile to the opposite side, with strong background parallax. No cuts.
判斷有沒有繞到對面,看兩個人的前後左右有沒有交換、池壁和球桌方向有沒有跟著轉。每支片抽四格人工看,沒做相機姿態重建:
| 版本 | seed 42 | seed 7 |
|---|---|---|
| H3 原版 | 近半圈(前段停住、後半才轉) | 近半圈(同時推近、降低) |
| Flex | 小幅弧移,兩人沒換位 | 部分繞桌,紅衣一直在左 |
| Turbo | 部分弧移,停在青蛙側面 | 近半圈,最後到青蛙背面 |
Flex 兩個 seed 都沒繞到對面,Turbo 一個有一個沒有。至少在這張圖上,Pika 版只靠文字並沒有比原版聽話。
我也試了「是不是 5 秒太趕」:只把 five 改成 fifteen、幀數改成 362。Flex 和 Turbo 的 seed 42 從部分弧移變成近 180°,繞到青蛙背後;seed 7 的 Flex 沒改善,Turbo 反而退成部分弧移。多給時間有時有用,但靠不住,完整結果放在進階。
給它一支 Blender 灰模當參考影片:6/6 都繞到對面
既然文字講不準,就直接給它看路線。我在 Blender 擺了一張球桌、兩個灰色假人、一圈偏心的池壁和一段池階,相機 5 秒繞桌子 180°,做成一支灰模影片,接到 Ref2VA 的參考影片插槽。
H3 原版、Flex、Turbo 各跑 seed 42 和 7,六支全部繞到對面:紅衣從近端左邊轉到遠端右邊,青蛙從遠端右邊轉到近端左邊,池壁也一路有視差。
seed 7 加灰模參考:左上 Blender 灰模、右上 H3 原版 14 步、左下 Flex 6 步、右下 Turbo 4 步。原片 864×480、5 秒,無聲
時間看最後一欄:
| 版本 | seed 42 | seed 7 | 沒參考影片(首幀版,seed 7) |
|---|---|---|---|
| H3 原版 14 步 | 116.4 秒 | 97.0 秒 | 38.9 秒 |
| Flex 6 步 | 49.0 秒 | 46.5 秒 | 21.0 秒 |
| Turbo 4 步 | 34.8 秒 | 33.7 秒 | 16.7 秒 |
參考影片會多送一大段畫面給模型看,三個版本都慢了一倍多。但跟原版加參考影片比,Turbo 一支 34 秒左右,原版要 97 到 116 秒。原版 seed 42 那發是第一支,含換底模後的載入。
成品裡沒看到灰模的灰色或假人混進畫面,衣服和池底的顏色都跟原圖一樣。池階在 5/6 支裡有長出來,出現時間約 2.5 到 4 秒,灰模裡是 2.5 秒,所以它跟的是路線,不是逐幀照抄。
怎麼跑:五個檔案、三組取樣設定、一支灰模
這節給已經在用 ComfyUI 跑 H3、想自己照做的人;沒用過 ComfyUI 的話,可以直接跳到下一節「怎麼選」。我的環境是 RTX 5090(32 GB)、ComfyUI 0.37.0,平常跑 H3 的同一份,文字編碼器 qwen3vl_32b_minimax_h3_nvfp4_awq、影片 VAE minimax_h3_video_vae_fp16、音訊 VAE minimax_h3_audio_vae_fp32 都沿用。
步驟一:下載 LoRA 和 Ref2VA 底模
首幀版和參考影片版各要一顆,Flex 在官方 repo 的 comfy/loras/ 底下,Turbo 在 Turbo repo 根目錄。檔名照第三欄下載:
| 用途 | 放哪 | 檔案 |
|---|---|---|
| Flex 首幀版 | models/loras/ | pika_h3_flex_fl2va_comfy_bf16.safetensors(1.96 GB) |
| Flex 參考影片版 | models/loras/ | pika_h3_flex_ref2va_comfy_bf16.safetensors(1.96 GB) |
| Turbo 首幀版 | models/loras/ | pika_h3_flex_turbo_4step_fl2va.safetensors(3.91 GB) |
| Turbo 參考影片版 | models/loras/ | pika_h3_flex_turbo_4step_ref2va.safetensors(3.91 GB) |
| Ref2VA 底模 | models/diffusion_models/ | minimax_h3_ref2va_pruned_int8_convrot.safetensors(21 GB) |
首幀版的底模用平常的 minimax_h3_fl2va_pruned_int8_convrot.safetensors。ComfyUI 原生的 LoraLoaderModelOnly 就吃得下這四顆,不用轉檔、不用裝節點,強度設 1,載入時 log 會印 208 patches attached。
Ref2VA 底模我用 int8,不用 NVFP4。之前在 NVFP4 底模上掛 LoRA 碰過畫面壞掉卻不報錯,原因放在進階。
步驟二:三組取樣設定照抄
三個版本的取樣器、步數、shift 都不一樣,別混用:
H3 原版   res_multistep / simple,14 步,shift video 12 / audio 3
Flex      lcm + ManualSigmas 1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0
Turbo     res_multistep / simple,4 步,shift video 6 / audio 3
共通      CFG 1(BasicGuider),LoRA 強度 1
Flex 那 7 個 sigma 值(6 步的邊界)要照官方範本填。官方說明特別寫了:隨便挑一個 6 步的 scheduler 來跑,不等於官方配方。
步驟三:解析度用 864×480,不要用 848×480
Turbo 的模型卡和不少範例寫 848×480,在 ComfyUI 原生 H3 節點上會直接報 shape 錯誤。改成 864×480 就好,錯誤原文放在進階。
步驟四:在 Blender 做一支 180° 灰模
灰模就是用灰色方塊、假人擺出來的 3D 草稿,只負責告訴模型相機怎麼走、誰站在哪。腳本不用自己寫,把需求講給 Claude 或其他 AI 聽就好:
幫我寫一支 Blender 腳本,用 blender -b --python 跑,輸出 864×480、24fps、124 幀的 mp4。
場景照這張圖擺:一張標準桌球桌,桌子兩側各一個灰色假人,一個在近端拉拍、一個在遠端準備回球。
四周是一圈乾掉的泳池池壁,池壁故意不要圍著桌子置中,再放一段四級的池階,讓畫面有不對稱的地標。
相機從跟原圖差不多的斜上方俯角開始,5 秒內繞桌子中心 180° 到對面,頭尾稍微加減速,全程不能讓假人出框。
不用照抄,講清楚要什麼就好。重點有三個:
- 一定要有不對稱的地標。 池壁置中、沒有池階的話,繞到對面跟原地不動看起來差不多,模型和你都分不出來。
- 幀數跟成品一樣。 124 幀 = 17×7+5,符合 H3 的幀數規格。
- 鏡頭可以比原圖廣一點。 我的灰模焦距是原圖的 72%,為了繞到側面時假人不出框,代價是首幀跟原圖構圖對不齊,細節在進階。
Blender 不用顯卡,我放在另一台 2080 Ti 機器上用 CPU 算,那張卡完全沒碰。
步驟五:接 Ref2VA,原圖同時鎖首幀
拿 ComfyUI 官方的 Pika Flex R2V workflow 來改。範本裡參考影片插槽是空的,要自己接;範本預設的 LoRA 檔名也跟實際下載的不一樣,記得改成上面那張表的名字。接線:
LoadVideo(whitebox.mp4) → GetVideoComponents.images → MiniMaxH3ReferenceToVideo.ref_videos.ref_video_0
LoadImage(原圖)         → MiniMaxH3ReferenceToVideo.ref_images.ref_image_0
LoadImage(原圖)         → MiniMaxH3AddGuide.image(frame_idx 0)
LoadVideo(whitebox.mp4) → GetVideoComponents.images → MiniMaxH3ReferenceToVideo.ref_videos.ref_video_0
LoadImage(原圖)         → MiniMaxH3ReferenceToVideo.ref_images.ref_image_0
LoadImage(原圖)         → MiniMaxH3AddGuide.image(frame_idx 0)
影片 VAE                → MiniMaxH3AddGuide.vae
MiniMaxH3ReferenceToVideo.positive → MiniMaxH3AddGuide.positive
MiniMaxH3ReferenceToVideo.latent   → MiniMaxH3AddGuide.latent,也接到 sampler 的 latent_image
MiniMaxH3AddGuide.positive         → BasicGuider.conditioning
width 864 · height 480 · length 124 · ref_image_size match
原圖接兩次:當參考圖負責長相,接 MiniMaxH3AddGuide 鎖住第 0 幀,開頭才會是原圖的構圖和顏色,不是灰色假人。灰模沒有聲音,ref_video_audio 不用接。
prompt 裡要講清楚灰模只拿來幹嘛,我加的是這幾句:
<Video 1> is a gray previs reference. Use only its camera path and the positions of the two players and the table. Do not copy gray materials, mannequin appearances, or geometry other than the pool steps. Match all appearance and lighting to <Picture 1>.
完整 prompt 放在進階。
怎麼選:要快用 Turbo,要指定運鏡就給灰模
| 你要的 | 用什麼 | 5 秒片一支 |
|---|---|---|
| 要快,運鏡隨它 | Turbo 首幀版 | 16.3 秒 |
| 要照指定路線繞 | 灰模 + Turbo | 34 秒左右 |
| 要照指定路線,臉是重點 | 灰模 + Flex | 47–49 秒 |
Turbo 的臉像開了美顏,磨得比較平,細節也簡化一些,臉部特寫多的片我會換 Flex。
進階:除錯紀錄與完整數字
不讀這節不影響使用。這裡放完整數字、prompt 原文和幾個踩過的坑,給想深追、或要把整篇丟給 AI 參考的人。
848×480 在原生 H3 節點報 shape 錯誤
第一發照模型卡用 848×480,原版 H3 還沒進 LoRA 就失敗:
RuntimeError: shape '[1, 24, 1, 1, 15, 2, 26, 2]' is invalid for input of size 38160
comfy/ldm/minimax/model.py:47, patchify_video
x = latent.reshape(b, c, t, pt, h, ph, w, pw)
H3 的 latent 寬度是畫面寬除以 16,848/16 = 53,空間 patch 是 2×2,奇數切不整齊。864/16 = 54 就過了。FastH3 那組也撞到同一個錯,跟 LoRA 無關。所以這篇的數字除了 Sol-H3(草稿 896×512、成品 1344×768)都是 864×480,跟模型卡上 848×480 的硬體數字不是同規格。
白底圖判不了環繞:人自轉和相機繞,畫面長得一樣
這一步讀者很可能也會踩,所以寫完整一點。
第一輪我準備了兩張圖:一張白底古風美女(臉看得清楚),一張 Pika 官方球桌圖。跑完我先看古風那組,每支片的人都從正面轉到側面或背面,可是都沒有很乾脆地停在正對面,我就記成「180° 都沒做滿」。
我當時的想法是:人轉到背面 = 相機繞到背後,轉得不夠 = 環繞沒做完。
後來回頭看球桌那組,判法換成看固定不動的東西:池壁的弧線、球桌長軸的方向、兩個人的前後左右。結果原版 H3 兩個 seed 都轉了近半圈,球桌和池壁的視差很清楚。白底那四支反而說不出任何結論:背景是一片白,沒有東西可以對照,相機繞人 180° 跟人原地轉身 180° 拍出來是同一個畫面。
要判環繞,畫面裡一定要有不動、而且不對稱的參照物。這也是灰模裡放偏心池壁和池階的原因。15 秒那輪的古風片更明顯:模型自己長出屏風、燈和矮桌,那些東西位置幾乎不動、人在轉,一看就知道是人自轉。
官方五段 3 秒腳本:俯拍、降到桌高、拉遠做得到,whip pan 不穩
模型卡的球桌示範腳本(362 幀、15 秒)原文:
Image 1 is the exact two players, outfits, frog mask, table-tennis table and drained pool: keep them exactly as in Image 1.
A fast table-tennis rally, shot with exactly these camera moves:
00:00–00:03 — top-down from directly overhead, as in Image 1, as the rally begins and the ball flicks back and forth.
00:03–00:06 — a smooth crane straight down from overhead to table height, ending right beside the net as the ball zips across.
00:06–00:09 — fast whip pans left and right following the ball across the net, from one player to the other.
00:09–00:12 — a 180-degree orbit around the frog-masked player as she leaps and smashes the ball.
00:12–00:15 — a low-angle dolly backward along the pool floor as the woman in the red tracksuit dives and misses; the frog raises both arms and does a little victory dance; the camera settles and holds.
The players, table and pool stay consistent and in the same place throughout. Photoreal 35mm film look, true colour, light natural grain, matching Image 1. SPEED IS CRITICAL: everything moves at normal real-time speed, like 24fps footage played back at 24fps - natural motion, NO slow motion.
Sound: the quick tock-tock of the ball, sneakers squeaking on concrete, the smash, a thud as she dives, echo in the empty pool, the frog's muffled cheer. Music: a funky, upbeat drum-and-bass groove.
每支抽 16 格(約每秒一格)人工看:
| 段落 | H3 原版 | Flex | Turbo |
|---|---|---|---|
| 0–3 秒俯拍 | 兩 seed 都有 | 兩 seed 都有 | 兩 seed 都有 |
| 3–6 秒降到桌高 | 兩 seed 都有 | 兩 seed 都有 | 兩 seed 都有 |
| 6–9 秒左右 whip pan | seed 42 有,seed 7 部分 | 兩 seed 都只有部分 | 兩 seed 都只有部分 |
| 9–12 秒 180° 環繞 | 兩 seed 近 180° | seed 42 大角度;seed 7 有回返 | seed 42 大角度、約 9 秒看到青蛙背面;seed 7 青蛙多是正面或側面 |
| 12–15 秒貼地拉遠 | 兩 seed 都有 | 兩 seed 都有 | 兩 seed 都有 |
古風美女套同一個五段時間軸(主體和動作換掉),三個版本兩個 seed 都沒看到明確的 whip pan;seed 7 三個版本都把白底換成了室內場景。
FastH3 8 步、Sol-H3 兩段式的對照
順手把另外兩條我會用的加速路線放進來比,只跑古風美女那張圖。FastH3 用 trim 8 步 int8(fastvideo_fasth3_trim_8step_int8_convrot.safetensors),照 ComfyUI 官方範本 video_fastvideo_fasth3_i2v.json,開 VSA。Sol-H3 是 Part 8 那條 H3 4 步草稿接 LTX 精修的兩段式產線,草稿 896×512、成品 1344×768。
| 版本 | 成品尺寸 | 15 秒片 seed 42 / 7 | 5 秒片 seed 42 / 7 |
|---|---|---|---|
| H3 原版 14 步 | 864×480 | 165.6 / 162.0 秒 | 45.5 / 38.0 秒 |
| Flex 6 步 | 864×480 | 84.5 / 82.7 秒 | 23.4 / 20.8 秒 |
| Turbo 4 步 | 864×480 | 64.9 / 62.8 秒 | 19.0 / 16.3 秒 |
| FastH3 trim 8 步 | 864×480 | 76.7 / 73.7 秒 | 25.6 / 23.6 秒 |
| Sol-H3 H3 4 步→LTX | 1344×768 | 115.4 / 105.1 秒 | 66.3 / 42.1 秒 |
seed 42 那欄多半是第一發,含載入或換 LoRA,seed 7 才是同 prompt 熱機。Sol-H3 每一發都要從 H3 換到 LTX,解析度也不同,秒數不能當同條件的速度對決。
觀察:
- 同 864×480 下 Turbo 4 步還是最快。FastH3 在 15 秒片接近 Flex,5 秒片比 Flex 慢。
- 運鏡沒有哪一條明顯比原版好:俯拍、下降、拉遠都做得到,whip pan 和完整 180° 一樣不穩。
- FastH3 兩個 seed 的 15 秒片都把白底換成舞台(地磚加金色山水、金屏風和燈籠),Sol-H3 也是(橙色棚景、黃色山水牆)。原版和 Pika 是 seed 7 才換。
- Sol-H3 seed 7 的 15 秒片首幀有兩個人影疊在一起,約 1 秒後消失,這支不能直接交片;臉認得出來,但跟原圖有差。它的 Spectrum offline smoothing 因為只有 4 個 anchor(要 5 個)沒有生效,log 寫
offline smoothing requires at least 5 actual anchors。 - 臉:Turbo 和 FastH3 的臉都像開了美顏,Turbo 古風近景的衣袖細節也變簡單。480p 的臉太小,看不出三者誰的臉比較好。
拉長秒數的完整結果
第三輪問的是「是不是每個運鏡給的時間不夠」。兩種改法:
- L1:單一 180° 環繞那句,只把 five 改成 fifteen、124 幀改成 362 幀,其他節點全部照舊(逐節點 diff 確認過)。這是最乾淨的對照。
- L3:五段改三段,各 5 秒(俯拍下降、環繞、拉遠),拿掉 whip pan。腳本同時變簡單,不是純秒數對照。
球桌圖,對照的是同版本同 seed 的舊片:
| 版本 / seed | 舊 5 秒 → L1 15 秒 | 舊五段(環繞 3 秒)→ L3(環繞 5 秒) |
|---|---|---|
| H3 原版 / 7 | 舊片已近 180°;L1 路徑更長、可能超過半圈 | 舊片近 180°;L3 只有橫移回返,比舊片弱 |
| Flex / 7 | 都不到半圈,沒改善 | 8.25–9.50 秒連續近半圈,9.75 秒跳回 |
| Turbo / 7 | 舊片近半圈;L1 退成部分弧移 | 8.25–9.50 秒連續近半圈,9.75 秒跳回 |
| Flex / 42 | 舊片小幅弧移;L1 近 180°,繞到青蛙背後 | 舊片已近 180°;L3 約 9 秒疊化換回 |
| Turbo / 42 | 舊片部分弧移;L1 近 180° | 舊片已近 180°;L3 約 10 秒跳回 |
L3 的跳回我另外在 8 到 10 秒每 0.25 秒抽一格確認過:前面那段近半圈是真的,接著鏡位突然換回側面的舊構圖,像被剪了一刀,沒有停在對面。只看最後一格會誤判成從沒繞過。
古風圖的 L1、L3 全部自己長出室內背景,而且多半是人原地轉,判不了相機環繞。
15 秒片的時間(L1,seed 7):原版 168.1 秒、Flex 86.8 秒、Turbo 67.9 秒,跟第一輪的 15 秒片差不多。
灰模的細節:焦距 72%,深度圖也繞得到但沒比較好
灰模場景(Blender 5.2.2,Workbench 用 CPU 算):
- 標準球桌 2.74×1.525×0.76 公尺加球網,兩個灰色假人頭頂高 1.65 公尺,一個近側拉拍、一個遠側準備回球,姿勢靜止。
- 池壁是偏心的橢圓(中心偏 1.3, -0.4 公尺,半軸 7.0 和 4.8 公尺,高 1.35 公尺),只在起始鏡頭背後放 4 級池階。
- 相機俯角 55°,距桌心 5.06 公尺,繞世界 Z 軸轉 180°;頭尾各 0.3 秒加減速,中間約每秒 37.3°。從逐幀相機座標重算總角度是 180.000°。
- 124 幀全部檢查過,桌子和假人沒有出框,相機也沒穿進池壁。
把鏡頭拉廣,是為了讓假人繞到側面時不出框。我先手標原圖桌面四個角,推算出 26.5 mm;可是固定焦距繞一圈,張開手的假人在側面會出框,只好把焦距縮短到 19.1 mm,是原本算出來的 72%。代價是灰模首幀的視角比原圖廣,桌子和人變小、池壁入畫更多。生成時第 0 幀被 MiniMaxH3AddGuide 鎖成原圖構圖,接著要往灰模那個比較廣的構圖拉開,開頭幾格會有一段過渡。
另外做了一支同路徑的深度圖(Cycles CPU、真的 Z 深度,2 公尺最亮、11 公尺最暗,不逐幀正規化),只跑 seed 42 的原版和 Flex,沒跑 Turbo:
| 參考影片 | 原版 seed 42 | Flex seed 42 |
|---|---|---|
| 灰模 | 繞到對面,116.4 秒 | 繞到對面,49.0 秒 |
| 深度圖 | 繞到對面,112.3 秒 | 繞到對面,47.6 秒;青蛙頭中段歪斜、略拉長 |
兩種都繞得到,沒看到深度圖比灰模更可靠,Flex 那支的頭還比較怪,所以留灰模。
成品的小毛病:幾乎每支的桌面中段都有反光褪色,後段才變回綠色,有可能是桌面那塊被灰模的灰色帶到;紅衣的臉細節偏軟,沒看到融臉或雙頭;青蛙轉到背面後只看得到頭頂,背面五官沒辦法驗。
Ref2VA 底模:從 NVFP4 換成 int8,複製了 21 GB
5090 上原本只有 minimax_h3_ref2va_pruned_nvfp4.safetensors,沒有 Ref2VA 的 int8 版;現有的 minimax_h3_fl2va_pruned_int8_convrot 是首幀版,不能拿來當 Ref2VA 用。我在 Part 14 碰過 NVFP4 底模掛 LoRA 之後畫面壞掉(重邊、膚質變平),而且不會報任何錯,這次不想再賭,就從另一台機器把 minimax_h3_ref2va_pruned_int8_convrot.safetensors(20,970,379,616 bytes)複製過來,兩端 SHA256 對過。
官方 R2V 範本裡寫的 LoRA 檔名是 pika_h3_flex_ref2va_v1_bf16.safetensors,實際從 Pika repo 下載到的是 pika_h3_flex_ref2va_comfy_bf16.safetensors,照範本選會找不到檔。
LoRA 有沒有真的掛上:208 patches 加 strength 0 對照
LoRA 掛了沒作用、但也不報錯,是最難發現的坑,所以第一輪先驗這件事:
- Flex 和 Turbo 檔都是 208 個模組,鍵名是 ComfyUI 原生的
diffusion_model.blocks.0.attn.qkv_proj.lora_A.weight這種,跟之前用過的 lightx2v 8 步檔 208 個鍵完全對得上。 - 強度 1 時 log 印
208 patches attached,強度 0 印0 patches attached,整批沒有出現lora key not loaded。 - 同圖同 seed 只改強度:Flex 那組末幀從背面變成側面,構圖不同;Turbo 那組強度 0 時白背景有黑灰漂浮雜點、衣服較糊,強度 1 雜點消失。全片 SSIM 分別 0.892 和 0.920。
int8 底模掛 LoRA 時光是重新量化,SSIM 就不會是 1,所以光看 SSIM 不算證據,要跟鍵名、patch 數、畫面差異一起看。
完整 prompt
只靠文字的 5 秒單一環繞(球桌圖,seed 42 和 7):
For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.

integrated_multimodal_description: [Shot 1] Live-action, cinematic, the frog-masked table-tennis player beside the table in the drained pool, matching the reference face, outfit and setting. The subject stays in place with natural small movements. One continuous shot: the camera slowly orbits 180 degrees around the subject over the full five seconds, moving from the opening view through a clear side profile to the opposite side, with strong background parallax. No cuts.

overall_soundscape: Soft fabric rustle, light footsteps, quiet location ambience. No speech.

non_diegetic_music: A solo guzheng plays four plucked notes at 60 BPM, with each note decaying naturally.
加灰模參考影片(三個版本共用同一段):
For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.

integrated_multimodal_description: [Shot 1] Live-action, cinematic, the frog-masked table-tennis player beside the table in the drained pool, matching the reference face, outfit and setting. The subject stays in place with natural small movements. One continuous shot: <Video 1> is a gray previs reference. Use only its camera path and the positions of the two players and the table. Do not copy gray materials, mannequin appearances, or geometry other than the pool steps. Match all appearance and lighting to <Picture 1>. The camera orbits 180 degrees around the table within five seconds to the opposite side: the two players exchange front/back and left/right positions, with clear parallax in the background pool wall. No cuts.

overall_soundscape: Soft fabric rustle, light footsteps, quiet location ambience. No speech.

non_diegetic_music: A solo guzheng plays four plucked notes at 60 BPM, with each note decaying naturally.
量法
秒數取 ComfyUI /history 的 execution_start 到 execution_success,含文字編碼、取樣、解碼、存檔,不含把影片拉回來。每發都在佇列空的時候才送。第一發前用 /free 卸載過模型,但服務沒重開、系統檔案快取也沒清,不能算整機冷啟動。H3 原版、Flex、Turbo 都沒開 Spectrum、沒加 compile;FastH3 照官方範本用 VSA 注意力,Sol-H3 開著 Spectrum(但只有 4 個 anchor,offline smoothing 沒生效)。ComfyUI 服務本來就開著的 SageAttention 保留。音軌都有(32 kHz 立體聲),這篇沒有評聲音。
這次測試的邊界
- 每組設定只有一到兩個 seed(n=1 或 2)。 6/6 只代表這兩個 seed,不能說任何 seed 都會成功。
- 加灰模那輪不是單變因對照。 底模從 FL2VA 換成 Ref2VA、LoRA 換成 Ref2VA 版、prompt 也加了參考說明,沒有另外跑「Ref2VA 但不給參考影片」那組,所以分不開哪個因素貢獻多少。
- 環繞角度是人工看抽幀判的。 看池壁、球桌方向和兩人前後左右,沒做相機姿態重建,不宣稱成品是精確的 180°。
- 灰模實驗只用了一張球桌圖。換成別的場景、別的運鏡,結果可能不一樣。
相關
常見問題
- Pika-H3-Flex 比原版 MiniMax-H3 快多少?
- RTX 5090、ComfyUI 0.37.0、864×480、熱機、同一個 seed:5 秒片(124 幀)原版 H3 14 步 38.0 秒,Flex 6 步 20.8 秒,Turbo 4 步 16.3 秒;15 秒片(362 幀)是 162.0、82.7、62.8 秒。Flex 約快 1.8 到 2.0 倍,Turbo 約快 2.3 到 2.6 倍。每組設定只跑一發。
- 只在 prompt 裡寫 180° 環繞,Pika 版會照做嗎?
- 不穩。官方球桌圖、單一句 180° 環繞、5 秒:原版 H3 兩個 seed 都轉了大角度,Flex 兩個 seed 都不到半圈,Turbo 一個 seed 近半圈、一個沒有。把同一句改成 15 秒,Flex 和 Turbo 的 seed 42 變成近 180°,seed 7 沒改善,Turbo 還退步。多給時間有時有用,但靠不住。
- 怎麼讓 H3 照指定路線繞到對面?
- 改用 Ref2VA,在 Blender 做一支 5 秒繞桌 180° 的灰模影片當參考影片,原圖同時當參考圖和第 0 幀的 guide,prompt 寫明灰模只取相機路徑和位置。H3 原版、Flex、Turbo 各跑 seed 42 和 7,6 支全部繞到對面。Turbo 一支 34 秒,Flex 47 到 49 秒,原版 97 到 116 秒。
- 模型卡寫 848×480,為什麼在 ComfyUI 會報錯?
- ComfyUI 原生 H3 節點把 latent 切成 2×2 的 patch,848 除以 16 是 53,奇數切不整齊,會報 RuntimeError: shape '[1, 24, 1, 1, 15, 2, 26, 2]' is invalid for input of size 38160。改成 864×480 就好,864 除以 16 是 54。
- Pika-H3-Flex 在 ComfyUI 要轉檔或裝自訂節點嗎?
- 不用。官方 repo 的 comfy/loras/ 有 ComfyUI 格式的 bf16 檔,Turbo repo 的檔案也是 ComfyUI 原生鍵名,用 LoraLoaderModelOnly 強度 1 掛上去,log 會印 208 patches attached。灰模接線用到的 LoadVideo、GetVideoComponents、MiniMaxH3ReferenceToVideo、MiniMaxH3AddGuide 都是原生節點。
- Flex 和 Turbo 怎麼選?
- 要快、不在意運鏡,用 Turbo 首幀版,5 秒片 16.3 秒。要指定運鏡,給灰模參考影片,Turbo 34 秒、Flex 47 到 49 秒,兩個在 6 支測試裡都繞到對面。Turbo 的臉像開了美顏,臉是重點的鏡頭可以改用 Flex。
接著讀
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-12[AI Workflow] 用 Blender 白模排走位,MiniMax-H3 照著拍成真人影片:RTX 5090 一支 90 秒
白模只帶位置、走位和鏡頭。在 Blender 排好兩個替身,把白模影片和兩張角色圖餵進 MiniMax-H3 Ref2VA,RTX 5090 上 864×480 一支約 82–90 秒,左右交換和誰從誰前面走過都跟到。含腳本、接線與 prompt。
- 2026-11-01[MiniMax-H3] NVIDIA MotionBricks 在 RTX 5090 上讓角色自己跑酷:1.66 毫秒生成一段動作,再交給 H3 拍成俠女
NVIDIA 研究院的 MotionBricks 給它最近四個姿勢和目標姿勢,就補出中間的動作。我在 RTX 5090 上實測一次生成 1.66 毫秒,用 Smart Primitives 排出 37.2 公尺、10 連跳的跑酷賽道,再把灰模預演交給 MiniMax-H3 生成 20 秒古裝俠女跑酷:造型和古鎮保住了,跳躍時序還對不準。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。