MiniMax-H3 on RTX 5090 · part 14
[MiniMax-H3] 開源 2K 重繪在 RTX 5090 實測:細節比 VSR 多,一支 5 秒片 133 秒
❯ cat --toc
- 前言
- 它是什麼:不是放大,是拿草稿當底稿重畫一遍
- 在 RTX 5090 上怎麼跑:社群 r128 版,峰值 31.7 GB 剛好塞進 32 GB
- VSR 2K 19 秒、重繪 2K 133 秒:多花的時間換到睫毛和耳環
- 招牌字為什麼被改壞?91% 重畫,字也一起重畫
- 該怎麼選:有字用 VSR,臉部特寫用 1 步重繪
- 解碼換 int8 VAE:42.7 秒變 19.6 秒,肉眼看不出差別
- 進階:重繪強度、量化提速、有字鏡頭的繞法
- 重繪強度掃描:1 步最像草稿,0.5 起跑細節反而少
- 量化提速:只有 int8 VAE 留下來
- 為什麼官方 B200 的 1.6 秒解碼在 5090 上做不到
- SwiGLU 半部順序:對調後照樣改字,問題不在轉檔
- 字多的鏡頭:MOSS 生首幀,重繪時也餵首幀,六塊招牌 6/6
- 這次測試的邊界
- 相關
TL;DR
NVIDIA 研究團隊放出的 Open-H3-Regenerate-2K,把 MiniMax-H3 的 1344×768 草稿以 91% 雜訊起跑、3 步重畫成 2560×1440。官方版塞不進 32 GB,我用社群 r128 版在 RTX 5090 上跑,一支 5 秒片 133 秒,RTX VSR 只要 19 秒;多出來的時間換到睫毛、耳環珠鏈和刺繡,代價是臉略瘦、中小招牌字變假字,有字的鏡頭還是用 VSR。臉部特寫改用 1 步重繪,81 秒,臉最接近草稿。每組只跑一次。
S1 古風美女臉部 1:1 裁切,左 RTX VSR 2K、右 Open-H3-Regenerate-2K 重繪 2K(官方 3 步),來自同一份 1344×768 草稿,5 秒有聲
前言
刷 X 看到 NVlabs 剛放出的 Open-H3-Regenerate-2K,號稱是 MiniMax H3 官方付費 2K 重繪 API 的開源替代品:一顆掛在 H3 上的 LoRA(外掛在原模型上的小型權重),先在 latent(模型內部壓縮過的畫面,還不是像素)裡把畫布放大,再用 3 步重畫補細節。它不是 SeedVR2 那種修復,比較像畫家拿草稿精修一遍。
我自己的 H3 只出得了 1344×768,要更高只能接放大器。Part 2 換成 RTX VSR 之後速度很漂亮,但人臉放大起來糊到有點可悲。放大器只能把已經有的東西銳化,草稿裡沒畫出來的睫毛,它變不出來。
所以這篇想知道兩件事:重繪 2K 跟 VSR 比,細節到底多多少?要多花多少時間?
它是什麼:不是放大,是拿草稿當底稿重畫一遍
官方的說法(Hugging Face 權重、專案頁):把 768P 草稿(1344×768、121 幀)重畫成 2560×1440。H3 本體和 VAE(把 latent 解回像素的解碼器)都不動,只多掛一顆 refiner LoRA。
流程只有兩段:
草稿 latent ─→ 3D-conv latent 放大器 ─→ Euler 3 步重繪(sigma 0.909375 → 0.857143 → 0.666667 → 0,CFG 1)─→ 解碼成 2K
sigma 是畫面裡雜訊占的比例,從 0.909 降到 0 就是畫完。關鍵在起跑狀態:9% 放大後的草稿 latent 加 91% 雜訊。草稿只負責告訴模型構圖和顏色大概在哪,細節幾乎全部重新畫。這就是它畫得出睫毛的原因,也是它會把招牌字畫錯的原因,後面會看到。
官方拿它跟付費 API 比(RefinerBench-150,都是 2560×1440):VBench 平均 0.814 對 0.802,盲測 50 組、共 200 次判斷裡有 87%(174/200)選開源版。但除了直接縮放,頁面上沒有跟 RTX VSR 這類專門的放大器比,也沒有單獨測人臉。我手上的對手剛好就是放大器,所以自己量。
授權是 MiniMax H3 Community License(有地區與用途條款),latent 放大器和合併進去的兩顆 LoRA 各有各的授權,商用前自己看一下。
在 RTX 5090 上怎麼跑:社群 r128 版,峰值 31.7 GB 剛好塞進 32 GB
這一節是給想自己跑的人:官方版塞不進消費級顯卡,要換成社群壓小的版本,再把五個檔案放對位置。只想看結果,直接跳到下一節。
官方 LoRA 是三顆 adapter 合併的,rank 576、FP32 12.4 GB,程式 README 寫 sol_engine_fwd 一張卡約需 150 GB(B200/GB200)。32 GB 的卡別想了。
我用的是社群轉檔 father558/H3-Open-Regenerate-2K-ComfyUI-r128:它把官方 LoRA 改成 ComfyUI 讀得懂的格式,再用 SVD 壓到 rank 128(把外掛權重壓小,代價是一點誤差),檔案剩 1.96 GB,在 ComfyUI 裡用 LoraLoaderModelOnly 節點、強度 1.0 掛上去。它跟官方版的差別要先講清楚:
- 不是官方,也不是原作者發布的。
- 壓小之後跟官方版有一點誤差,數字放在進階。
需要準備的東西(ComfyUI 0.37,開著 Sol-Attn 稀疏注意力加速)。下載時對第三欄的檔名:
| 用途 | 做什麼 | 檔案 |
|---|---|---|
| H3 底模 | 生草稿、也負責重畫 | minimax_h3_fl2va_pruned_int8_convrot |
| 文字編碼器 | 把提示詞變成模型讀得懂的向量 | qwen3vl_32b_minimax_h3_nvfp4_awq |
| 重繪 LoRA | 讓 H3 學會「照草稿重畫成 2K」 | father558 r128(1.96 GB) |
| latent 放大器 | 把草稿 latent 放大到 2K 的畫布 | minimax_h3_latent_upscaler_3d_fp16 |
| 影片 VAE | 把 latent 解回像素 | 原版 fp16,或換 minimax_h3_video_vae_int8_convrot(見後面) |
草稿我用 1344×768、121 幀、24 fps、有音軌、20 步,生一支約 103–123 秒(下面的秒數都不含這段)。有一個小坑:H3 生出來的長度會補到 124 幀,我存完整的 latent 交給重繪,輸出時再裁成前 121 幀。
S1 那支 3 步重繪的時間花在哪:
| 階段 | 秒數 |
|---|---|
| latent 放大 | 2.1 |
| 3 步重繪 | 76.0 |
| 原版 VAE 解碼 | 42.7 |
| 存檔 | 6.0 |
峰值 31.7 GB,32 GB 的卡剛好。注意解碼吃掉快一半時間,這是後面要砍的地方。
整理好的 ComfyUI workflow 在這裡:open-h3-regenerate-2k-rtx5090.json。從文字一路做到 2K mp4:預設 1 步重繪、int8 VAE,可以切回官方 3 步,也留了接首幀的入口;各個權重的下載連結寫在 workflow 裡的 Note。除了 ComfyUI 原生節點,只要多裝一個公開節點包 comfyui-minimax-h3-audio-T8。我在 5090 上照原樣跑一次,從提示詞到 2K mp4 共 173.8 秒(含草稿),峰值 32.0 GB。
如果你想要 1080p:latent 寬高要能被 32 整除,所以先做 1920×1088 再裁成 1920×1080。S1 跑 65 秒,但臉走樣得比 2K 多(唇色變淡、笑容不見),我不推薦拿它省時間。
VSR 2K 19 秒、重繪 2K 133 秒:多花的時間換到睫毛和耳環
三個場景,同一份草稿 latent 出發,計到 2560×1440 的 mp4 存好,含解碼和存檔。看兩欄差多少:
| 場景 | RTX VSR 2K | 重繪 2K(官方 3 步) |
|---|---|---|
| S1 古風美女近景 | 18.3 秒 | 132.8 秒 |
| S2 夜市繁中招牌 | 19.1 秒 | 132.6 秒 |
| S3 雨中兩人短兵交擊 | 19.1 秒 | 134.4 秒 |
VSR 本身只要 1.5–1.7 秒,其餘都是解碼和存檔,峰值約 20 GB。
畫質看頂部那支影片。S1 臉部,重繪 2K 的睫毛一根根分開,眼睛有反光,耳環的珠鏈和金屬鏈畫出來了,細髮和刺繡也更細;VSR 只是把草稿原本有的東西磨利。代價是臉型被畫瘦了一點,耳環和髮飾的造型被改,刺繡圖案的排列也不一樣。
S3 動作場景也是同一個走向:
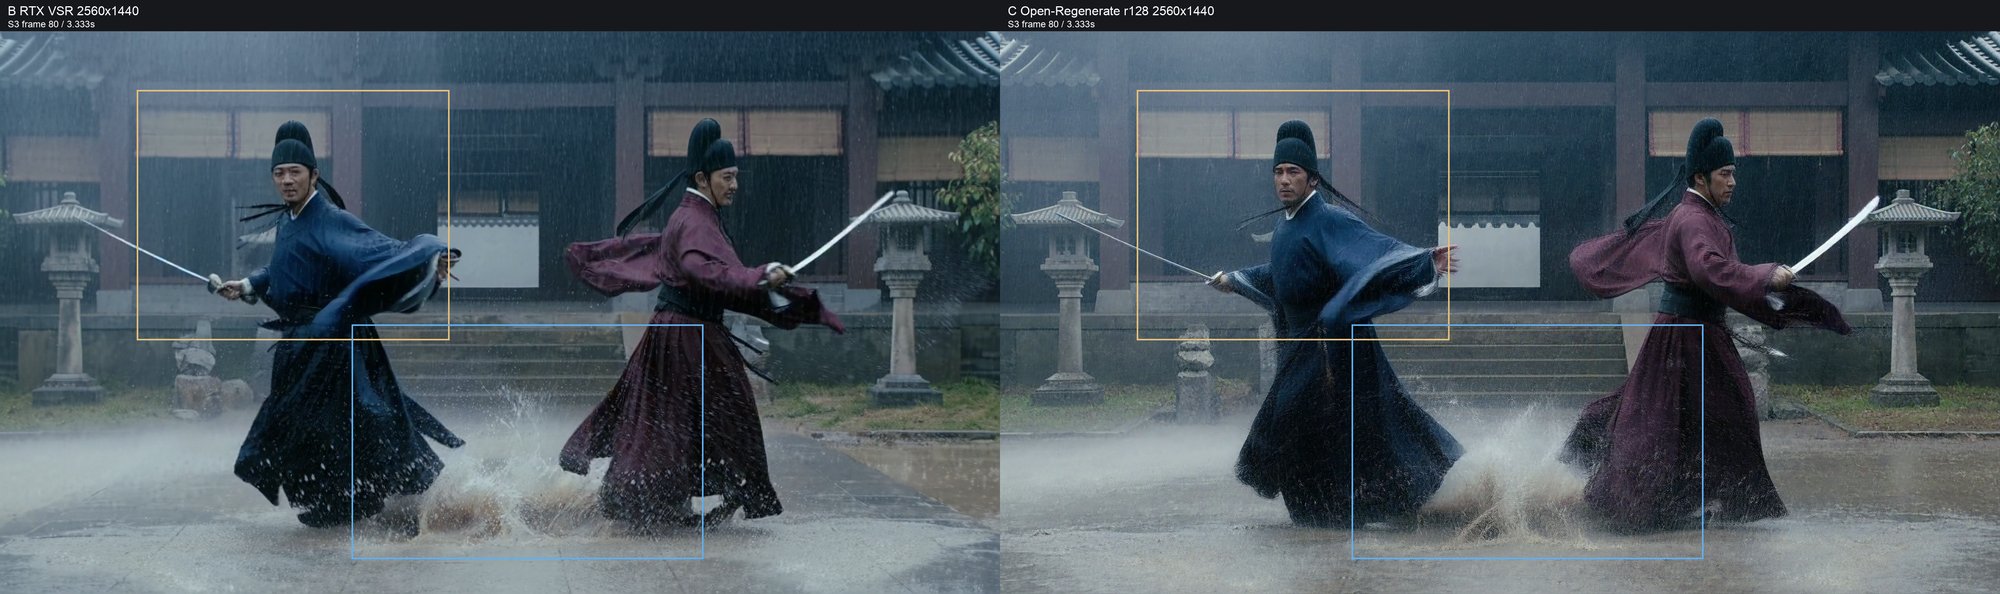
右邊的臉、手背、衣料、雨線、屋瓦都更清楚,更像電影。但看左邊那個人的手,重繪把手勢改成張開手;大水花是重新生成的,跟草稿的形狀對不起來,劍和袖口也有局部位移。VSR 的水花比較粗,可是輪廓跟草稿一致。如果這一鏡要跟前後鏡接動作,這點差很多。
招牌字為什麼被改壞?91% 重畫,字也一起重畫
S2 是 H3 直接文生影片的夜市,一堆繁中招牌。先說草稿本身就有錯字(「鹽酥酥雞」「鹽珠奶」)。
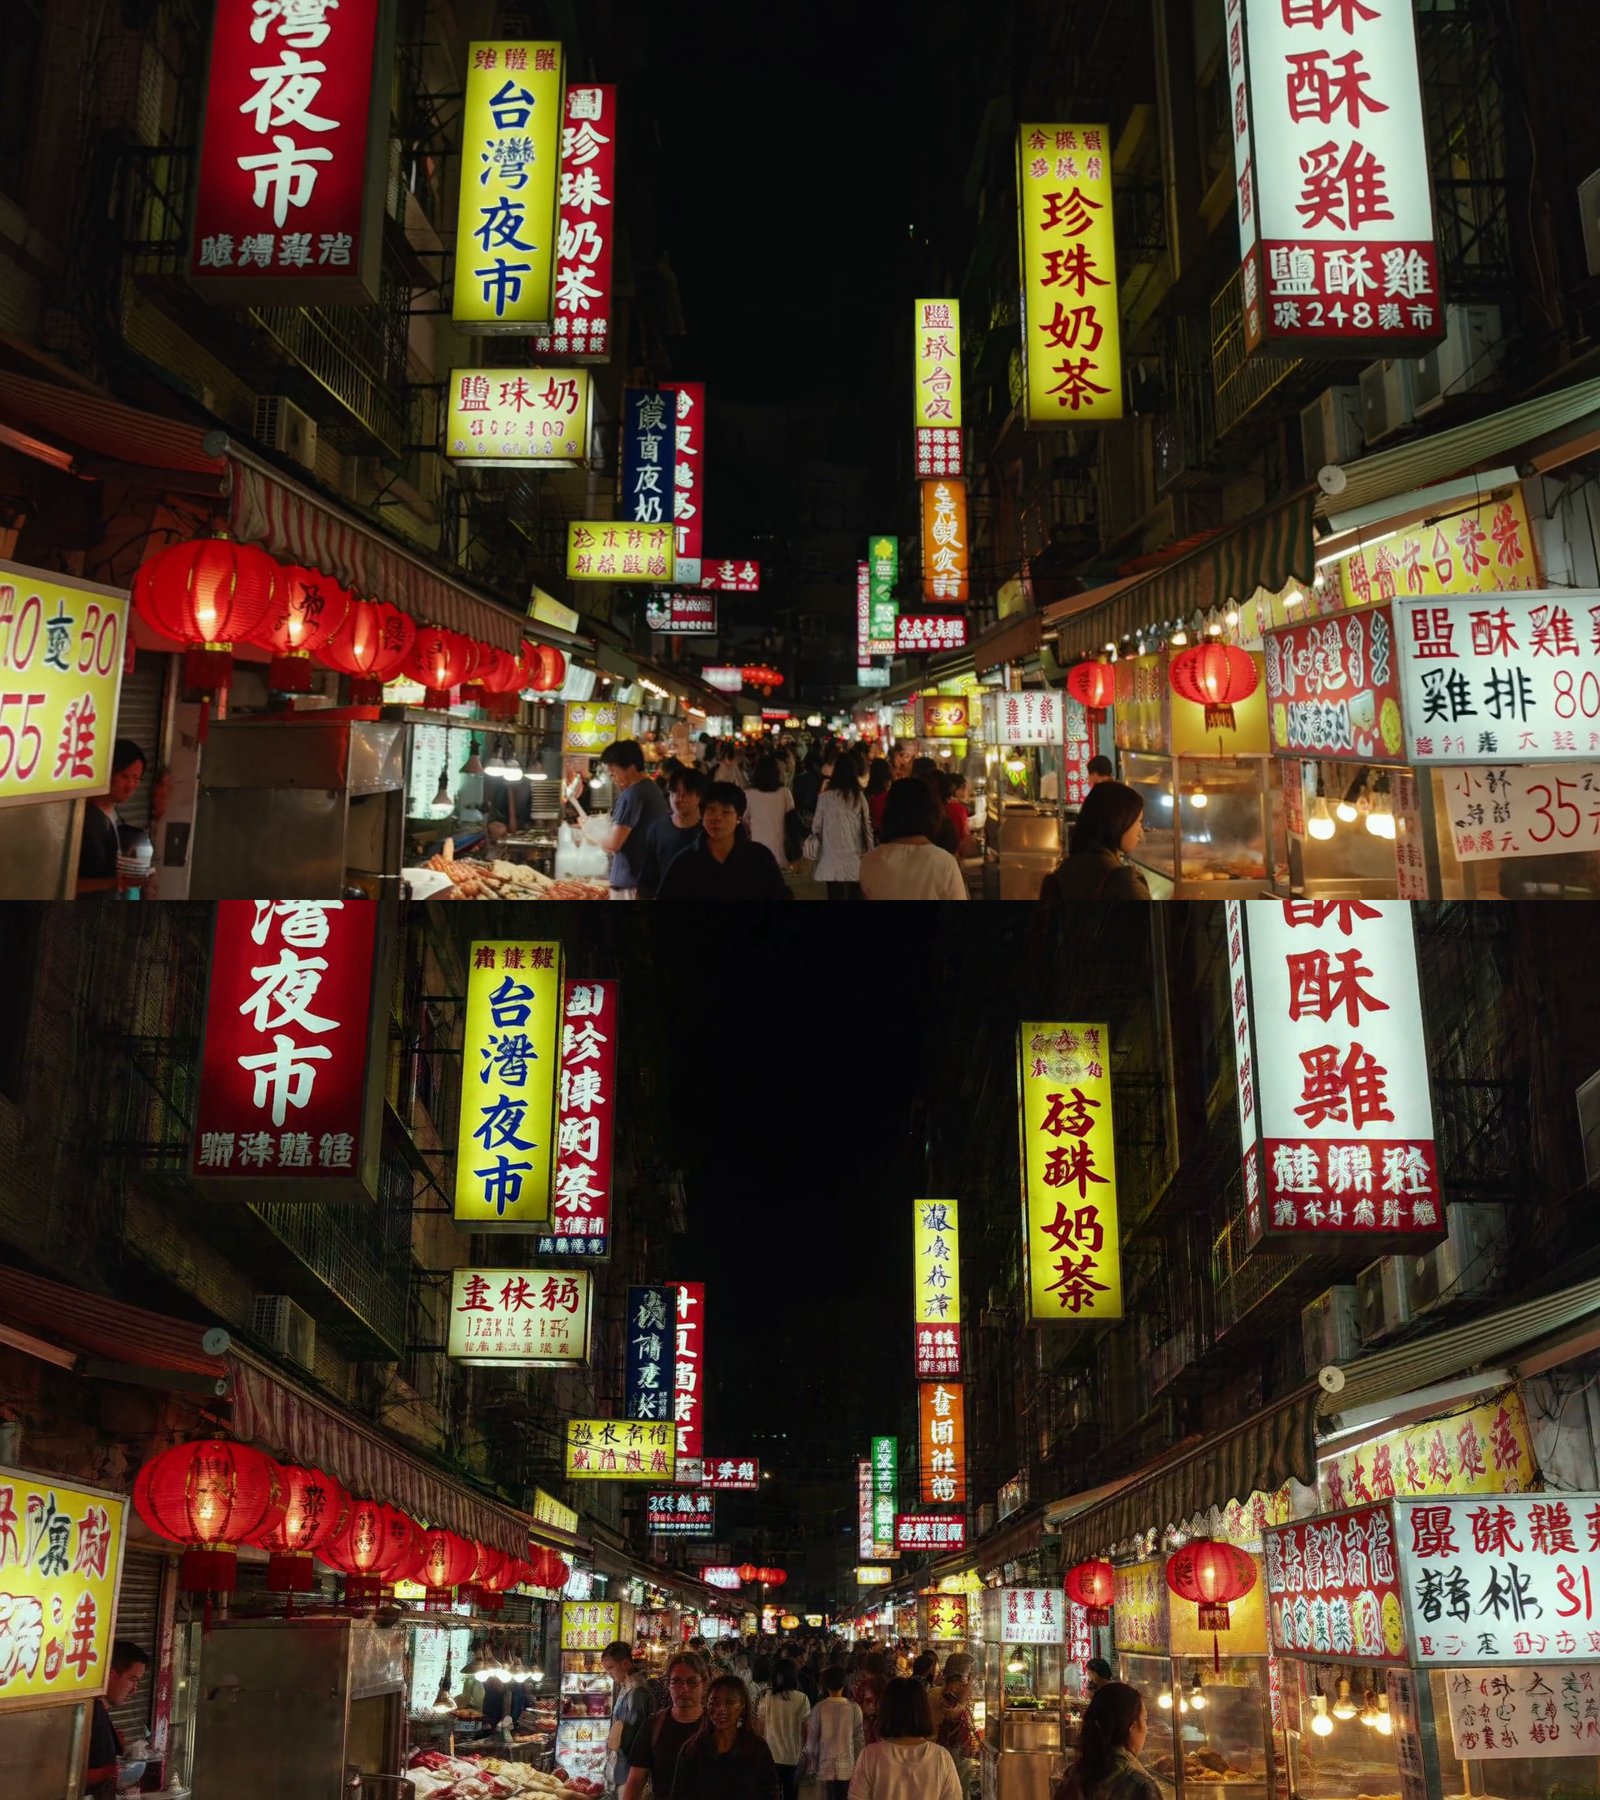
VSR 保住了「珍珠奶茶」「鹽酥雞」「雞排 80」「35 元」。重繪只保住「台灣夜市」這種大字,中小招牌全部變成看起來像中文、但查字典查不到的字:
- 「珍珠奶茶」前兩個字認不出來,只剩「奶茶」
- 「雞排 80元」變成兩個怪字加 31
- 「35元」消失
- 50 變成近似 59
原因在那 91%:模型只照著草稿的大概樣子重畫,大字的形狀夠明顯,中小字就變成一個長得很像的字。我一度懷疑是社群轉檔把權重接錯,對調之後重跑,字照樣被改(過程放在進階)。字多的鏡頭真的想用重繪,可以先用別的模型生好首幀再餵回去,做法放在後面進階那節。
該怎麼選:有字用 VSR,臉部特寫用 1 步重繪
照鏡頭類型挑,看第二欄:
| 鏡頭 | 用什麼 | 5 秒 2K 一支 |
|---|---|---|
| 有字、要對嘴、要接前後鏡 | RTX VSR 2K,內容跟草稿一樣 | 19 秒 |
| 臉與材質特寫 | 重繪 1 步(sigma 0.667 起跑) | 81 秒 |
| 臉一點都不能變 | RTX VSR 2K | 19 秒 |
臉部特寫為什麼不用官方 3 步?看這張同一幀的六欄:
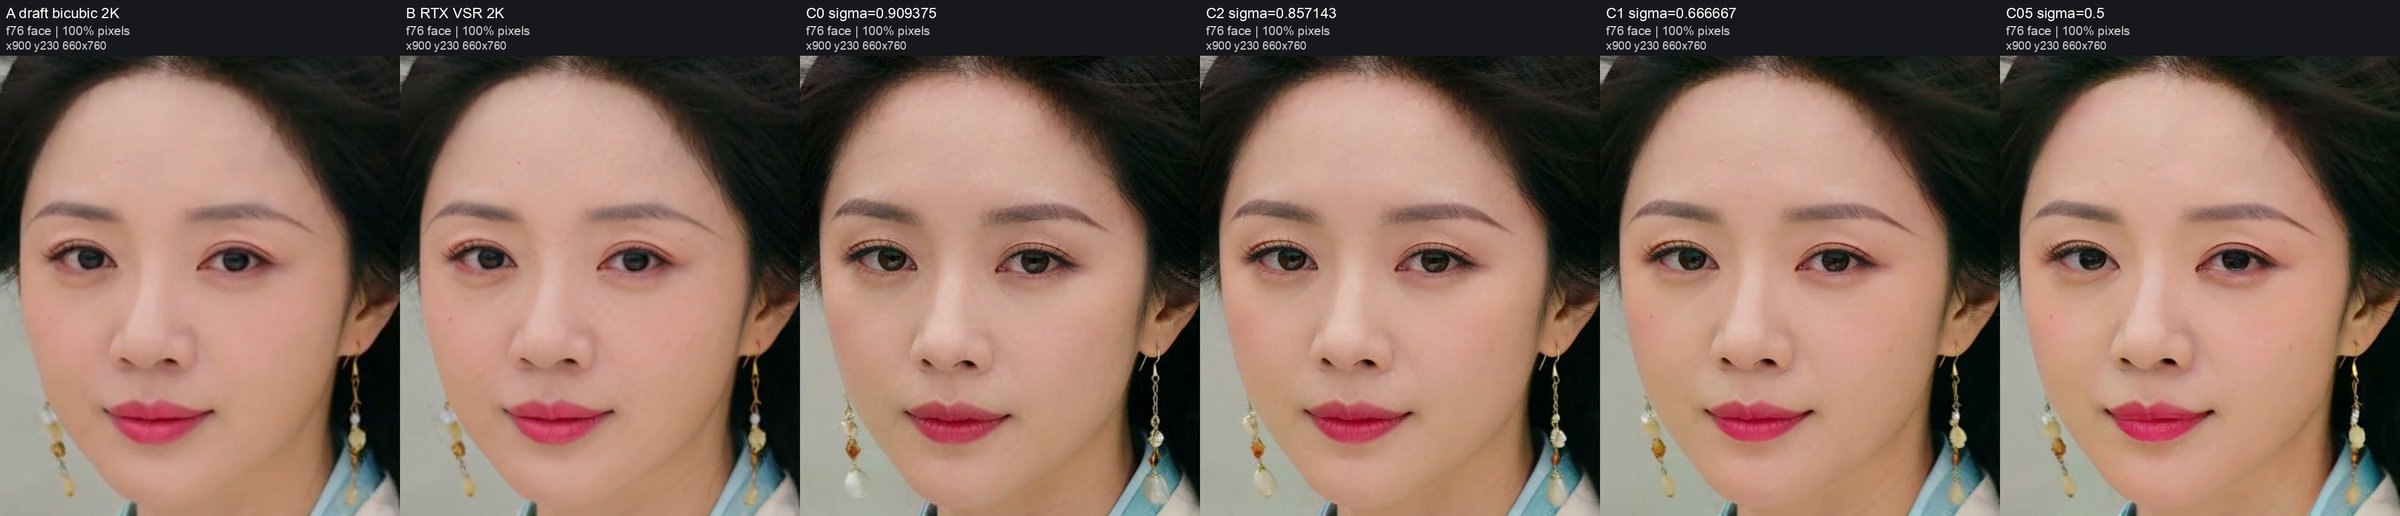
從第三欄(官方 3 步)往右,起跑的 sigma 越低,重畫的份量越少。第五欄的 1 步(0.667)臉頰、唇色、笑容最接近草稿,睫毛和膚質還是比第二欄的 VSR 細,時間 80.7 秒,官方 3 步是 132.8 秒。四種強度的完整數字放在進階。
解碼換 int8 VAE:42.7 秒變 19.6 秒,肉眼看不出差別
不論選哪一種,解碼都換成 int8 VAE(minimax_h3_video_vae_int8_convrot):
- 解碼 19.6 秒,原版 42.7 秒
- 峰值 7 GB
- 跟原版逐像素比(PSNR,越高越像)58.2 dB(S1)/ 51.0 dB(S2),SSIM 0.9995 / 0.9991,我肉眼看不出差別
3 步重繪加 int8 VAE 我沒有整支串起來跑過,依上面的分段推算約 110 秒(133 − 43 + 19.6)。1 步加 int8 VAE 推算約 58 秒;workflow 預設就是這個組合,整條從提示詞跑到 2K mp4 實測 173.8 秒,扣掉 103–123 秒的草稿,跟推算對得上。
進階:重繪強度、量化提速、有字鏡頭的繞法
不讀這節不影響使用。這裡放完整數字和幾個查證,給想深追、或要把整篇丟給 AI 參考的人。
重繪強度掃描:1 步最像草稿,0.5 起跑細節反而少
S1、2K、同一個 noise seed,只改起跑的 sigma。SSIM 是取兩幀,各拿臉部跟草稿比:
| 起跑 sigma | sigma 路徑 | 時間 | 臉部 SSIM(對草稿) |
|---|---|---|---|
| 0.909(官方 3 步) | 0.909375 → 0.857143 → 0.666667 → 0 | 133 秒 | 0.846 / 0.859 |
| 0.857(2 步) | 0.857143 → 0.666667 → 0 | 114.8 秒 | 0.872 / 0.877 |
| 0.667(1 步) | 0.666667 → 0 | 80.7 秒 | 0.895 / 0.894 |
| 0.5 | 0.5 → 0.25 → 0 | 104.0 秒 | 0.893 / 0.891 |
| RTX VSR 2K | — | 18.3 秒 | 0.956 / 0.955 |
- 0.5 起跑多走一步,SSIM 跟 1 步差不多,細節反而比 1 步少,時間還多。
- 0.895 跟 0.846 的差,代表的是臉被改的程度,不代表「像不像同一個人」。
量化提速:只有 int8 VAE 留下來
完整數字;S1、S2 都量過的,兩個數字並列:
| 做法 | 改哪一段 | 時間 | PSNR(對照) | 峰值 | 結論 |
|---|---|---|---|---|---|
| int8 VAE | 解碼 | 19.6 秒(原版 42.7) | 58.2 / 51.0 dB(對原版),SSIM 0.9995 / 0.9991 | 7 GB | 採用 |
| TensorRT VAE 引擎 | 解碼 | 35.0 秒 | 61.6 / 54.9 dB | 18 GB | 比 int8 慢 |
| NVFP4 底模 | 3 步重繪 | 76.0 → 65.2 秒(快 14%) | 25.8 / 18.5 dB(對 int8 底模) | — | 畫面壞掉,不能用 |
| 快速解碼器,CPU 串流分塊 | 解碼 | 154.4 秒(原版 41.2) | — | — | 比原版慢 |
| 快速解碼器,全留 GPU 分塊 | 解碼 | 24.8 / 27.3 秒 | 36.2 / 28.2 dB | 18.7 GB | 細節被抹平,不用 |
NVFP4 底模(minimax_h3_fl2va_pruned_nvfp4)不是 LoRA 套不上,208/208 個位置都套得上。問題是畫面:眼瞼出現重邊、膚質變平、金飾和刺繡被重畫,S2 的燈籠、建築、人物都有多重輪廓。NVFP4 加 int8 VAE 是最快的完整組合,98.8 秒,但這個畫質不能用。
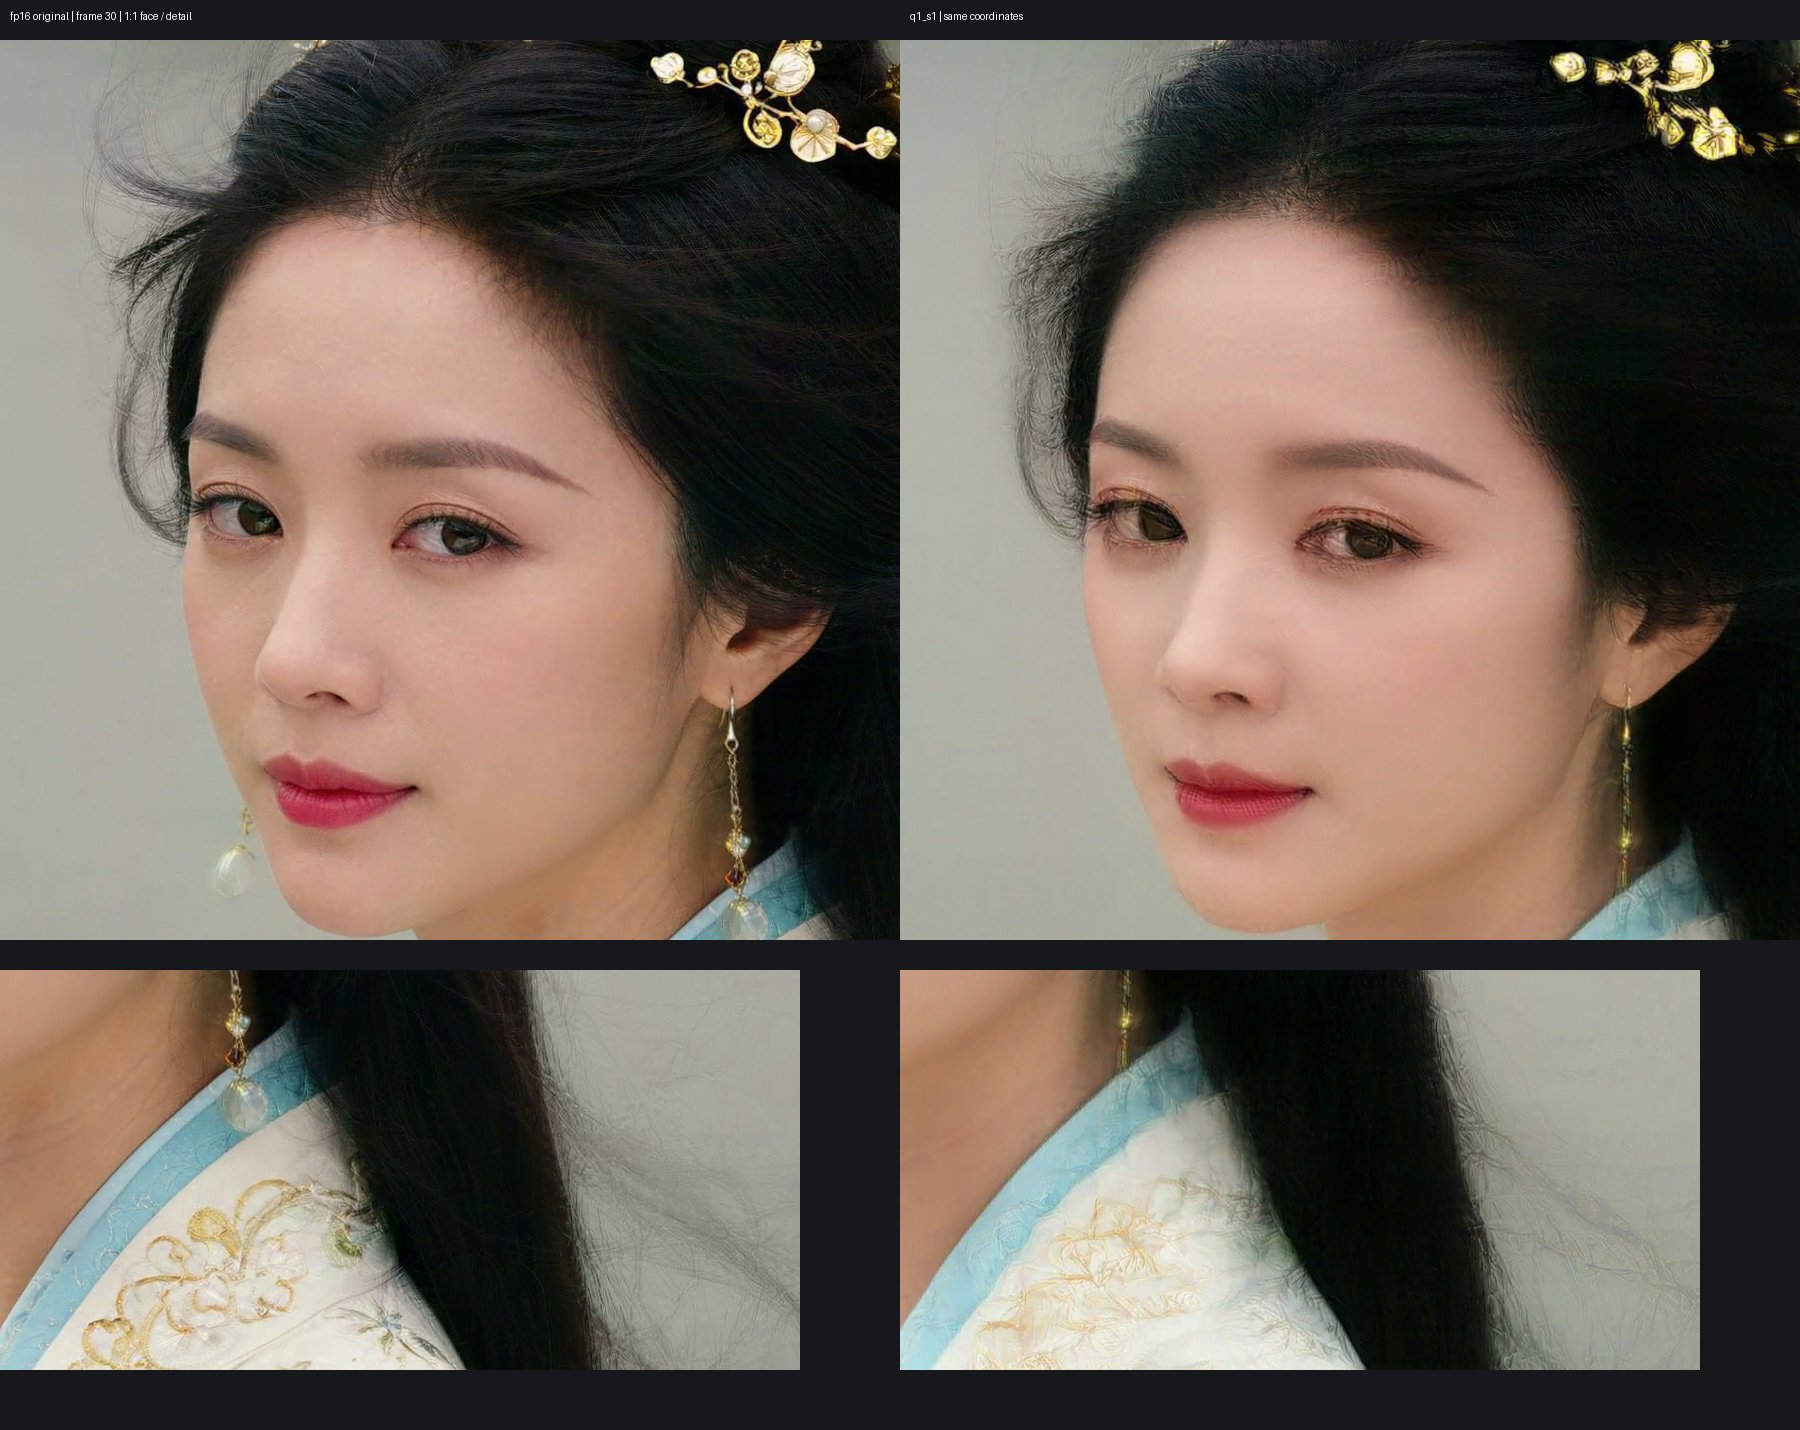
別被圖上的英文標籤誤導:左邊寫 fp16 original,其實是 int8 底模的重繪結果;右邊 q1_s1 是 NVFP4 底模。
為什麼官方 B200 的 1.6 秒解碼在 5090 上做不到
官方 B200 的數字(5 秒 2K 一支,warm,3 次中位數):
| 組態 | 時間 |
|---|---|
| dense BF16 | 87.26 秒 |
| Sol-Attn + MXFP8 + CUDA graphs | 37.39 秒 |
| 再換快速 VAE 解碼器 | 22.45 秒(3.89×) |
快速解碼器(fast_h3_vae_noncausal_24l,6.47 GB、24 層、1.62B 參數)在 B200 上 1.6 秒解完,原版要 15 秒。官方寫它需要 FlashAttention-4 和 quack。
我先查 FA4 是不是硬需求:官方程式本身有一份純 PyTorch SDPA 的參考實作,不一定要裝 FA4。FA4 上游 3 月就合併了 SM120(RTX 50 系列)的 forward 支援,10 月的 beta release notes 也列了 SM120 的更新。我沒有裝 FA4。
真正卡住的是記憶體:整段不分塊解 2K,估算要 42 GiB 以上,32 GB 放不下。只能分塊:
- CPU 串流分塊:154.4 秒,比原版的 41.2 秒還慢。
- 全留 GPU 分塊:24.8 秒(S1)/ 27.3 秒(S2),峰值 18.7 GB,速度有了,但 PSNR 36.2 dB(S1)/ 28.2 dB(S2),皮膚毛孔、睫毛、細髮、招牌細字都被抹平。
所以 5090 上留 int8 VAE。
SwiGLU 半部順序:對調後照樣改字,問題不在轉檔
看到招牌字被改,我第一個懷疑的是社群轉檔。H3 FFN 的 swiglu 線性輸出,Diffusers 的排法是 [up | gate],ComfyUI 的 _swiglu_eager 是 [gate | up];社群轉檔腳本直接對應,沒有對調,作者的 README 自己也寫「沒確認」。如果真的接反,fc1 那一層的 LoRA 等於加錯半邊。
我把 r128 的 fc1 lora_B 半部對調另存一份,重跑 S2:
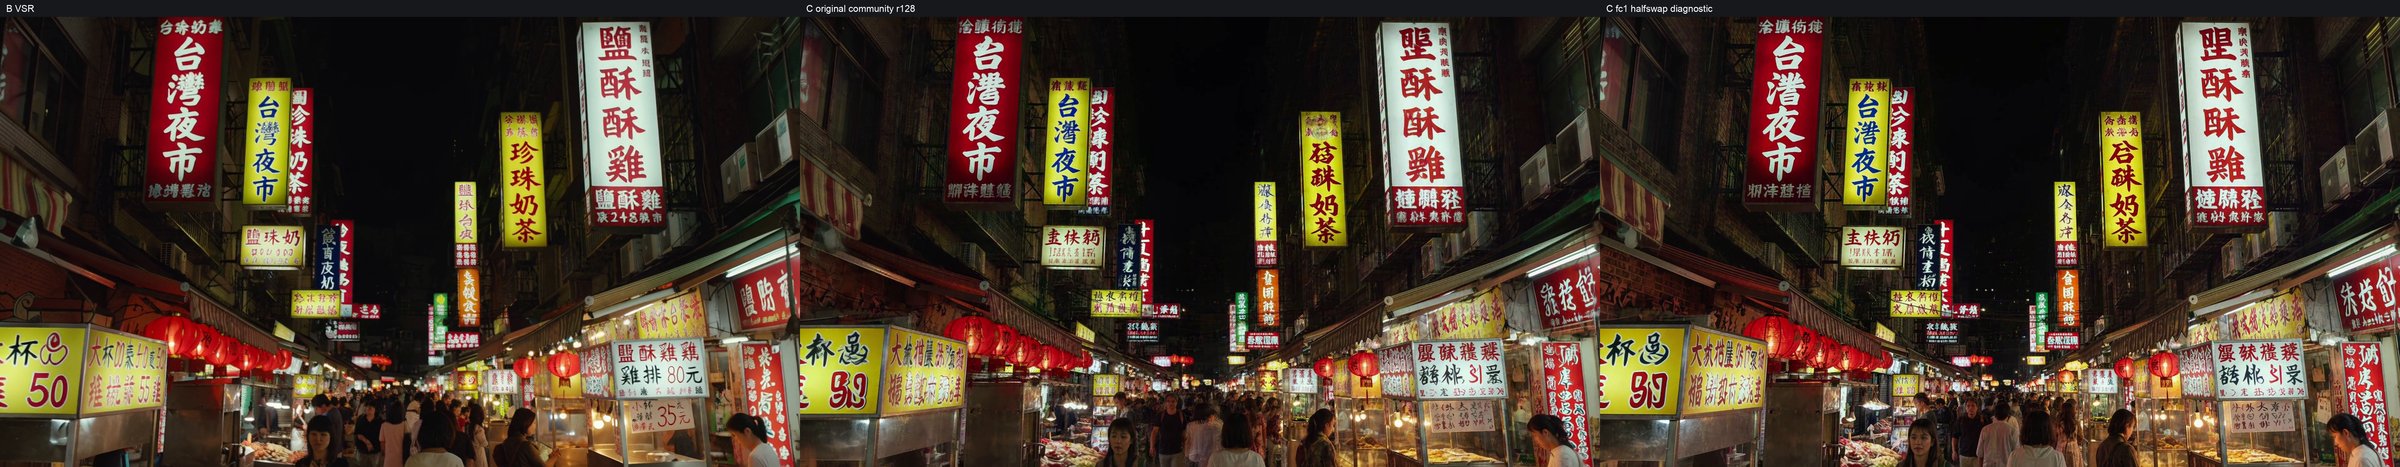
對調版的前景人群重影略少,但「珍珠奶茶」「雞排 80元」「35元」照樣被改,50 照樣變 59。字被改的原因是 91% 雜訊重新畫,不是轉檔接錯。
字多的鏡頭:MOSS 生首幀,重繪時也餵首幀,六塊招牌 6/6
這段跟 2K 畫質無關,是做有字鏡頭時的繞法。既然 H3 自己寫字不可靠、重繪又會再改一次,我的想法是:字讓會寫字的生圖模型負責,H3 只負責動。
步驟一:用 MOSS-Image 生一張字全對的首幀
我用 MOSS-Image(moss_image_sft_int8_convrot,加 qwen3.5 9b 文字編碼器和 4 步 LoRA)生了 3 張 1344×768 的夜市首幀,一張約 1.2–5.4 秒,挑第 3 張(1.3 秒)。六塊招牌 26 個字全對:台灣夜市、珍珠奶茶、鹽酥雞、雞排 80元、大杯 55元、小杯 35元。
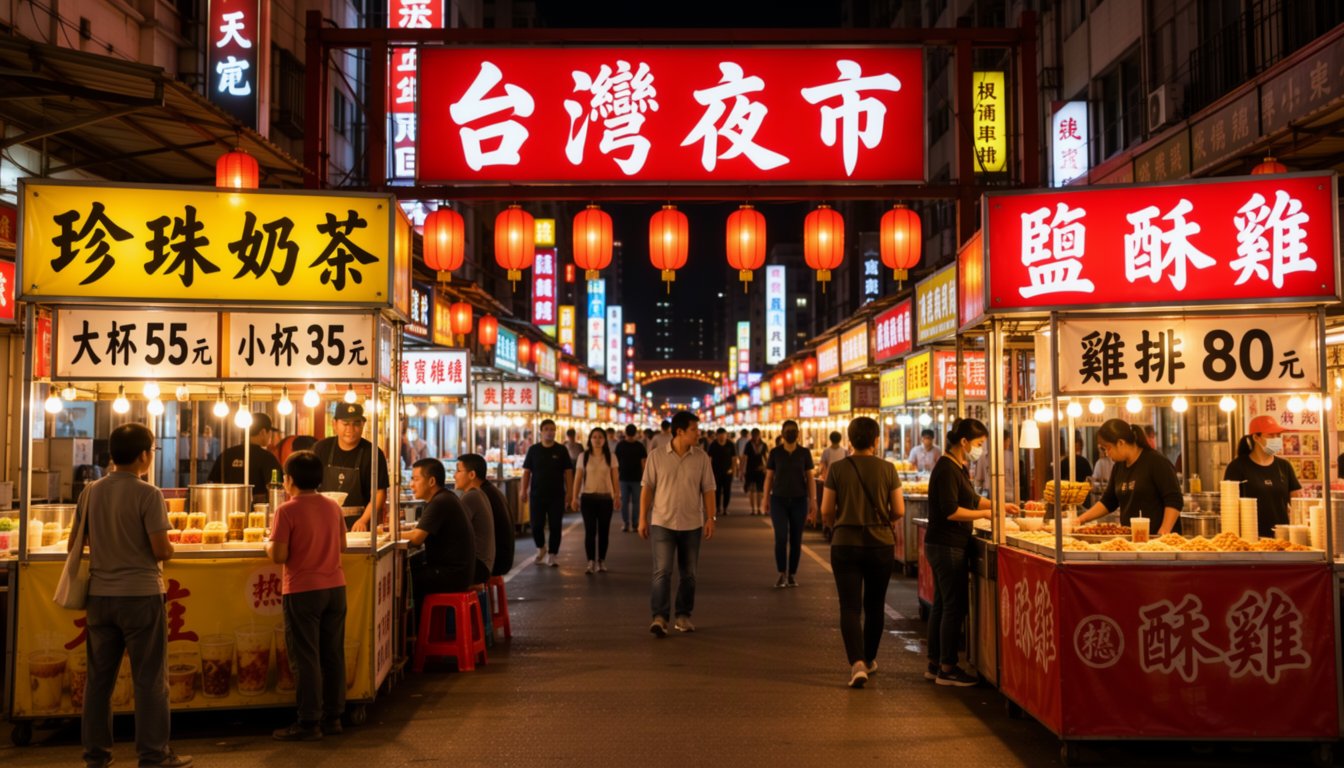
字多的場景,先把這張圖看過一遍、確定每個字都對,再往下走。
步驟二:H3 從首幀生影片,重繪時把首幀再餵一次
H3 從這張圖生影片(圖生影片,I2V)當草稿,122.7 秒,第 0、30 幀六塊招牌全對。
接著重繪。關鍵是重繪階段也把這張首幀接進 ComfyUI 的 MiniMaxH3ImageToVideo 的 keyframe 輸入,我叫它「首幀條件」。官方的 refine 程式用的是 build_t2va_layout,沒有首幀入口,這是我自己改的變體,workflow 裡已經留好接點。
結果看第 0、30 幀六塊招牌有幾塊完整正確:
| 做法 | 六塊招牌全對幾塊 | 時間 |
|---|---|---|
| RTX VSR 2K | 6/6 | 19.0 秒 |
| 重繪 2K | 2/6 | 133.6 秒 |
| 重繪 2K + 首幀條件 | 6/6 | 152.0 秒 |
單純重繪只剩珍珠奶茶和大杯 55元是對的:「灣」變假字、「鹽酥雞」頭尾兩字變假字、「雞排」的「雞」變假字、「小杯」變「个杯」。加了首幀條件就全部回來,只比單純重繪多 18.4 秒,筆畫還比 VSR 銳利。
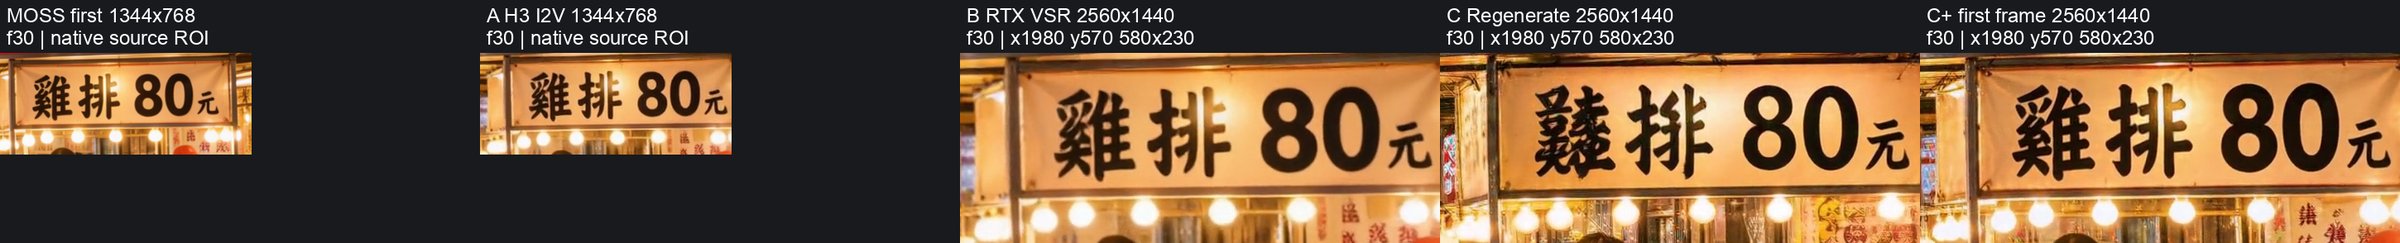
看第四欄的「雞」,左半邊變成一個不存在的字;第五欄加了首幀條件,寫回正確的「雞」,邊緣比第三欄的 VSR 還乾淨。
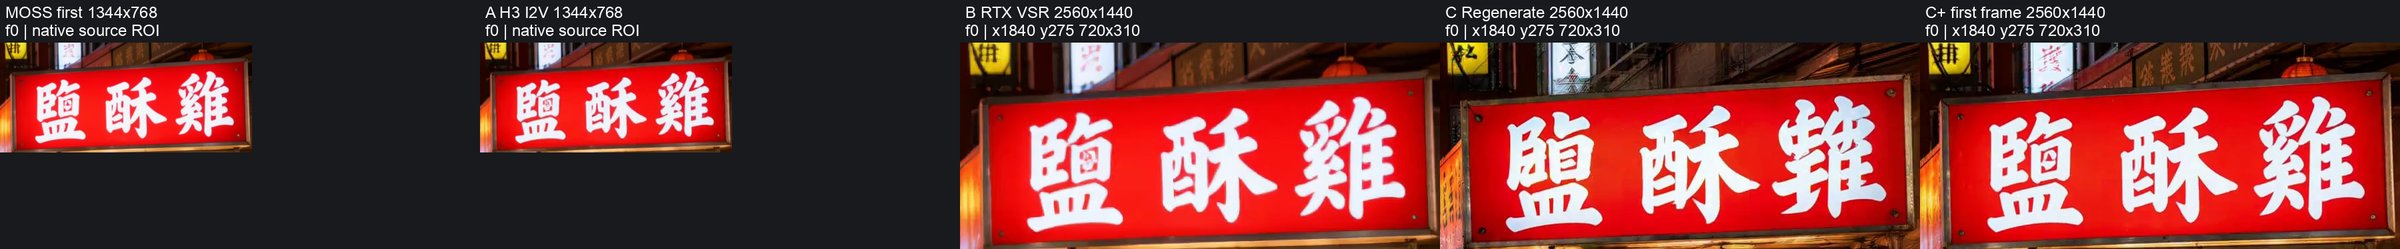
三種做法同步播放:
MOSS 首幀夜市招牌 1:1 裁切,三欄同步:左 RTX VSR 2K、中重繪 2K、右重繪 2K 加首幀條件
有一個要先講的限制:首幀條件管的是開頭。到第 94 幀鏡頭推近,四塊招牌出框或被行人擋住,只剩 2 塊可以驗,VSR 2/6、重繪加首幀 2/6、單純重繪 0/6。所以我只能說第 0、30 幀全對,不能說整支 121 幀都保得住字。
這次測試的邊界
- 社群 r128 不是官方。 它是 rank 576 合併版 SVD 壓到 rank 128 的轉檔,平均誤差約 4.5%,blocks 19–24 的 mlp.fc2 約 12–15%。官方完整版在 5090 上跑不了,所以我沒有官方版的對照。
- 每個場景每種做法只跑一次(N=1)。 秒數和畫質判斷都是單發。
- 3 步重繪加 int8 VAE 的 110 秒是依分段推算,沒有整支實跑;1 步加 int8 VAE 只有連草稿一起量的 173.8 秒。
相關
常見問題
- Open-H3-Regenerate-2K 在 RTX 5090 32 GB 上跑得動嗎?
- 官方 diffusers 版跑不動,程式 README 寫一張卡約需 150 GB(B200/GB200)。我改用社群轉的 ComfyUI 版 father558 r128:SVD 壓到 rank 128、1.96 GB BF16,掛在 int8 的 H3 底模上,5 秒 2K 一支峰值 31.7 GB,32 GB 的卡剛好塞得下,三個場景各 132.6 到 134.4 秒。這個版本不是官方、也不是原作者發布的。
- 2K 重繪跟 RTX VSR 放大比,差在哪?
- VSR 2K 一支 5 秒片 18.3 到 19.1 秒,只把草稿原有的東西銳化;重繪 2K 要 132.6 到 134.4 秒,但會把睫毛一根根分開、畫出眼睛反光和耳環的珠鏈。代價是臉型略瘦、耳環和髮飾造型被改,中小招牌字也會變成不存在的字。
- 重繪後招牌上的中文字為什麼變成假字?
- 重繪起跑時是 9% 放大後的草稿加 91% 雜訊,等於整張重畫一遍。H3 直接文生影片的夜市裡,重繪只保住「台灣夜市」這類大字,「珍珠奶茶」「雞排 80元」這些中小字變成像中文、但不存在的字,VSR 都保住了。我把轉檔裡 SwiGLU 的半部對調重跑,字照樣被改,所以是重繪方法本身,不是轉檔接錯。
- 字多的鏡頭想用 2K 重繪,怎麼保住招牌字?
- 先用 MOSS-Image 生一張字全對的首幀,讓 H3 從這張圖生影片,重繪時也把首幀圖餵給 ComfyUI 的 MiniMaxH3ImageToVideo(keyframe 輸入)。第 0、30 幀六塊招牌:單純重繪 2/6,重繪加首幀條件 6/6,152.0 秒,比單純重繪多 18.4 秒。官方 refine 程式沒有首幀入口,這是我自己的變體;第 94 幀鏡頭推近後只剩 2 塊招牌可驗。
- 只想加細節、不想讓臉被改太多,要怎麼設?
- 改成 1 步重繪,sigma 從 0.666667 直接到 0。S1 古風美女 2K 一支 80.7 秒,臉部 SSIM(對草稿)0.895/0.894,官方 3 步是 0.846/0.859;臉頰、唇色、笑容最接近草稿,睫毛和膚質仍比 VSR 細。臉一點都不能變就用 VSR。
- 重繪 2K 在 5090 上能怎麼加速?
- 解碼換 int8 VAE:42.7 秒變 19.6 秒,峰值 7 GB,跟原版比 PSNR 58.2 dB(S1)/ 51.0 dB(S2),肉眼看不出差別。整支 3 步重繪加 int8 VAE 我沒有串起來跑過,依分段推算約 110 秒;1 步加 int8 VAE 推算約 58 秒。NVFP4 底模讓 3 步重繪從 76.0 秒變 65.2 秒,但畫面壞掉;官方快速解碼器在 32 GB 上要分塊,最快 24.8 秒,但 PSNR 掉到 36.2 dB,毛孔睫毛被抹平。
接著讀
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-10-25[MiniMax-H3] 用 16 格分鏡讓本地 H3 演出場景可行嗎?分鏡管構圖、角色圖管長相、時間軸管順序
本地 MiniMax-H3 能不能像線上 Seedance 2.0 全能參考那樣,照一張 16 格分鏡表拍片?丟分鏡表加一句話只對上 3/16 格;把分鏡照官方鏡頭表格式改寫成逐格時間軸、再配角色圖,RTX 5090 一發 339.9 秒拍出 10 秒片、13/16 格對上。含分鏡表與角色圖怎麼生、Ref2VA 接法和坑。
- 2026-10-19[AI Workflow] 真人舞蹈轉成深度影片,讓 MiniMax-H3 的古風角色在宮殿跳同一段舞:768 直接生成
看到有人用真人舞蹈帶 AI 角色跟著跳,我想試試 MiniMax-H3 能不能也做得出來,就用本機的一張 RTX 5090 跑了一次:Video Depth Anything 轉深度、Qwen-Image 把角色放進宮殿當第一格、Ref2VA 只給這一張場景圖,768×1376 直接生成再補幀到 48fps。含節點設定、首幀接法、背景跑回白棚的原因和換 seed 的坑。
- 2026-10-18[AI Workflow] 拿掉霧轉場:把下一個地標藏在鏡頭背後,MiniMax-H3 一鏡飛完 25 秒台灣 FPV
上一篇的台灣 FPV 靠霧遮接縫,這篇改成轉頭才露出下一個地標:下一個地標藏在右後方,鏡頭轉過去、畫面只剩天空時換段。用 ComfyUI-H3-Continuum 在 RTX 5090 上連續生五段 25 秒,四個接點的畫面變化只有平常的 0.15 到 1.28 倍。含白模改法、接點對齊、逐段提示詞、結尾重做和還沒做到的地方。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。