[影片生成] FastH3 在 RTX 5090 實測:同一支 768p 有聲片不到一分鐘,比原版 H3 快 2.9 倍
❯ cat --toc
TL;DR
FastH3 是 Hao AI Lab 從 MiniMax-H3 蒸餾出來的 8 步版本,一樣一次生出畫面和聲音。我在 RTX 5090 用 ComfyUI 官方範本實測:同一張首幀、1344×768、5 秒有聲片,FastH3 V2 是 57.4–59.8 秒,原版 H3 用範本預設的 20 步是 166.3–168.2 秒,約快 2.9 倍。480p 一支 18.7 秒,中文台詞只有 Muninn 念錯。2080 Ti 也跑得動,但加速用的 VSA 在那張卡上不會生效。
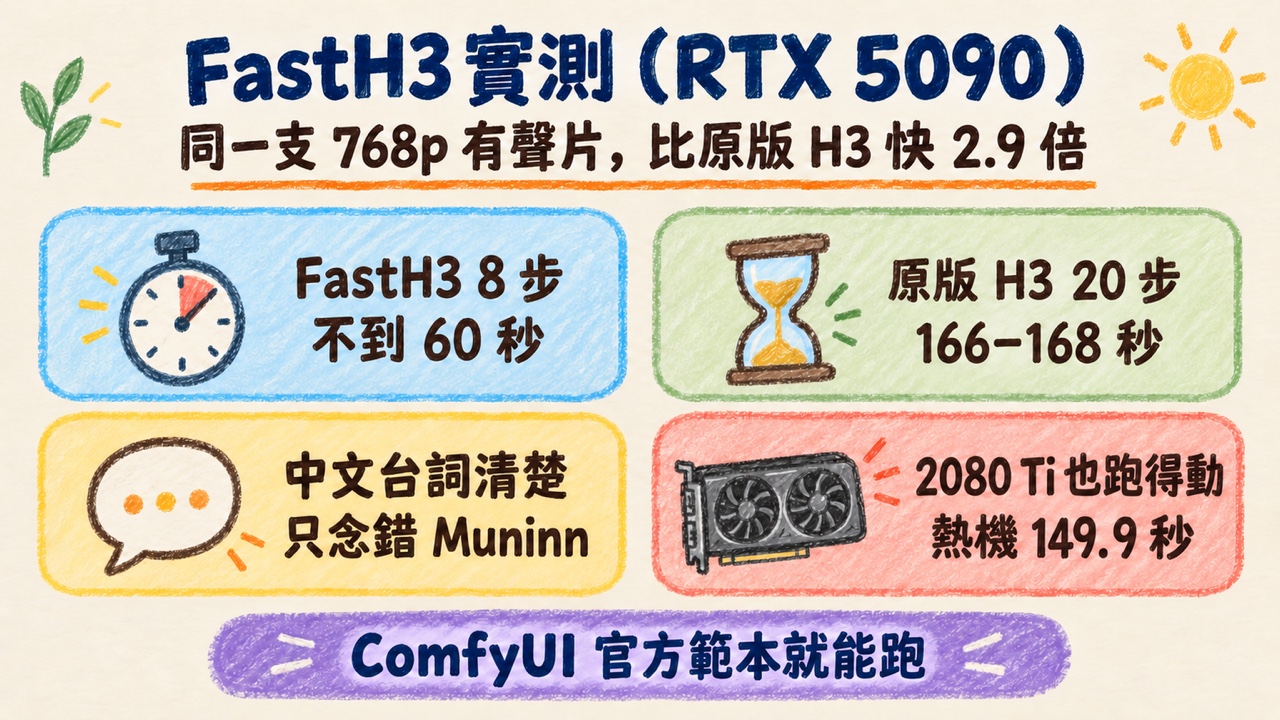
短片版:FastH3 生一支會說話的影片要多久
前言
MiniMax-H3 是我平常拿來做短片的模型,給它一張圖和一段台詞,它會一起生出畫面和聲音,人物會開口講你寫的那句話。缺點是慢:我的 RTX 5090 跑一支 480p 的 5 秒片要 72 到 82 秒,所以平常只開 10 步,官方範本的 20 步要等更久。
最近 Hao AI Lab 放出 FastH3,宣稱 RTX 5090 上 5 秒有聲片 14.8 秒。我想知道兩件事:在我現在用的 ComfyUI 裡是不是真的這麼快,以及中文台詞會不會因為步數砍掉而變糊。順便也拿家裡那張魔改 22 GB 的 2080 Ti 試了一下。
FastH3 是什麼:把 MiniMax-H3 蒸餾成 8 步
FastH3 是 UCSD Hao AI Lab 做的,底下就是 MiniMax-H3。它快的原因有兩個。
第一個是步數變少。這類模型生影片,是從一團雜訊開始,一步一步把畫面「洗」乾淨,每洗一步就要把整個模型跑一次。原版 H3 要洗 20 步,FastH3 只要 8 步,模型少跑 12 次,時間自然省下來。做法叫蒸餾:拿原版當老師,訓練一個學生用 8 步洗出跟老師 20 步差不多的結果(他們用的方法叫 DMD2)。
第二個是 VSA(Video Sparse Attention,稀疏注意力)。模型在每一步裡,要讓畫面的每一小塊去看其他所有小塊,才知道整張畫面怎麼搭,這是最花時間的部分。VSA 只讓每一小塊去看跟它最相關的那一部分,ComfyUI 範本設的是 10%。
FastH3 有兩個版本:
| 版本 | 區塊數 | ComfyUI 的 NVFP4 檔(4 位元壓縮格式) | 官方建議 |
|---|---|---|---|
| V2 | 完整 50 個 | 13.6 GB | 在意畫質用這個 |
| Trim | 砍掉影響最小的 8 個,剩 42 個 | 11.9 GB | 畫面元素多的場景細節會少一點 |
FastH3 支援文生影片和首尾幀圖生影片(給第一格,或第一格加最後一格)。這次測的 V2 和 Trim 不含 Ref2VA(拿參考圖保持角色長相)的蒸餾版,FastVideo 另外有做一個 Ref2VA 的蒸餾模型,這篇沒測。授權沿用 MiniMax H3 Community License,有地區限制,商用前要自己讀一遍。
在 ComfyUI 跑起來:一份官方範本、一個模型檔
這節是給要自己跑的人看的,只想看結果可以直接跳到下一節。
ComfyUI 是一個開源介面,把模型的每個步驟做成方塊(節點),連起來就能生圖、生影片。FastH3 不用裝自訂節點,ComfyUI 官方範本裡就有:video_fastvideo_fasth3_t2v.json(文生影片)和 video_fastvideo_fasth3_i2v.json(首尾幀圖生影片)。
我的環境是 RTX 5090(32 GB)、Windows、ComfyUI 0.37.0,平常跑原版 H3 的同一份。要準備的東西:
- ComfyUI 夠新。 範本用到
BlockSparseAttention和MiniMaxH3SigmaShift兩個節點,我在 0.37.0 跑,另一台的 0.31 沒有BlockSparseAttention。 - FastH3 的模型檔。 這是 FastH3 本體,也是唯一要新下載的檔。V2 下載 FastVideo/FastVideo-FastH3-8-Step-V2-NVFP4-Comfy,Trim 下載 FastVideo/FastVideo-FastH3-Trim-Comfy,放進
models/diffusion_models/。 - 文字編碼器和 VAE 跟原版 H3 共用。 文字編碼器負責把你寫的提示詞變成模型看得懂的東西,VAE 負責把模型算完的結果還原成畫面和聲音。已經在跑 H3 的話不用再下載;我用的是
qwen3vl_32b_minimax_h3_nvfp4_awq、minimax_h3_video_vae_fp16、minimax_h3_audio_vae_fp32。
範本的設定我沒改:
步數            8
sampler         res_multistep
scheduler       simple
SigmaShift      影像 10 / 聲音 3
VSA             BlockSparseAttention, vsa, keep 10%
注意力後端      comfy kitchen
台詞寫在畫面描述裡,例如 says in clear standard Mandarin Chinese, "欢迎来到 AI Muninn,今天带你看最新的 AI 消息。"。中文台詞用簡體,這是 H3 一直以來的習慣,FastH3 照舊。
同一張首幀、同一個 768p:FastH3 約快 2.9 倍
速度我只拿 FastH3 跟原版 H3 自己比。條件:同一張 1344×768 的首幀圖、同一段中文台詞、5 秒(124 格)、都是熱機,每種設定換兩個 seed 各跑一發。原版 H3 用範本預設的 20 步,也就是 ComfyUI 官方 H3 文生影片範本的步數;我平常用的 10 步列在下面當參考。
FastH3 兩發 59.8、57.4 秒,原版 H3 20 步兩發 166.3、168.2 秒,平均下來快 2.85 倍,四捨五入是 2.9 倍。跟我平常的 10 步比(90.1、83.6 秒),大約快 1.5 倍。
這 2.9 倍是兩件事加起來的:步數從 20 降到 8,再加上 VSA。原版 H3 那邊沒有 VSA 可以開。
兩支片放在一起,左邊 FastH3、右邊原版 H3 20 步,都是同一張首幀和同一句台詞:
FastH3 V2,8 步,1344×768,57.4 秒(預設靜音,開聲音聽)
原版 MiniMax-H3,20 步,1344×768,168.2 秒(預設靜音,開聲音聽)
畫質我只做了看片比對,沒有分數。兩支我都覺得能用,你可以自己開聲音聽。
480p 一支 18.7 秒;V2 和 Trim 怎麼選
做短片我更常用 480p。這張表看 480p 那兩行:
| 解析度(124 格,約 5 秒) | V2 | Trim |
|---|---|---|
| 832×480 文生影片 | 18.7 / 18.7 秒 | 16.8 / 16.8 秒 |
| 1344×768 文生影片 | 52.8 / 50.8 秒 | 45.6 / 45.5 秒 |
| 剛開 ComfyUI 的第一支(480p) | 28.0 秒 |
Trim 在 480p 快 2 秒,768p 快 5 到 7 秒。我做短片會用 V2,2 秒換完整的 50 個區塊,划算。
官方部落格的數字是 832×480 V2 14.8 秒、Trim 13.4 秒,1344×768 V2 38.6 秒、Trim 35.4 秒。他們用的是自家的 FastVideo 推論引擎(官方支援 Linux 和 WSL),量法一樣是熱機、從文字編碼算到輸出 MP4。我在 ComfyUI 量到的 480p 慢 3 到 4 秒,768p 慢 10 到 14 秒。
中文台詞:Whisper 轉回來只有 Muninn 念錯
台詞準不準,我用 Whisper(OpenAI 開源的語音轉文字模型)把聲音轉成文字,跟寫的台詞比:
| 版本 | Whisper 轉回來 |
|---|---|
| 寫的台詞 | 欢迎来到 AI Muninn,今天带你看最新的 AI 消息。 |
| V2 文生影片 480p | 欢迎来到AI Money,今天带你看最新的AI消息 |
| Trim 文生影片 480p | 同 V2 |
| V2 看板娘圖生影片 | 欢迎来到AI Mooning⋯(後面全對) |
Muninn 是我部落格的名字,本來就不是一般的字,被聽成 Money 和 Mooning。其他字全對,只跑 8 步,中文也沒變糊。
看板娘那一版是給一張 480×832 的直式插畫當首幀。角色的畫風沒跑掉,會眨眼、會開口,V2 一支 24.0 秒、Trim 19.0 秒(這兩個時間包含切換模型)。
FastH3 V2 圖生影片,看板娘當首幀,480×832(預設靜音,開聲音聽)
2080 Ti 也跑得動,但 VSA 不會生效
家裡另一台機器插著魔改 22 GB 的 RTX 2080 Ti,ComfyUI 是 0.31。我放的是 Trim 的 int8 檔(18.9 GB;NVFP4 是給新顯卡用的格式,舊卡我改用 8 位元的 int8 版),832×480、124 格:
| 秒數 | |
|---|---|
| 冷機第一支 | 189.4 |
| 熱機 | 149.9 |
跑得動,中文台詞偶爾錯一兩個字。
要注意的是 VSA 在 2080 Ti 上不能用。它的底層程式用到只有較新顯卡才有的指令,要 sm_80 以上(sm 是 NVIDIA 標顯卡世代的編號,sm_80 大約是 RTX 30 系列那一代),2080 Ti 是更早的 sm_75。ComfyUI 0.37 的 BlockSparseAttention 節點遇到這種卡不會報錯,會默默改用一般注意力,影片照樣生得出來。所以在舊卡上看到這個節點,別以為加速有開。
進階:量測細節與踩過的坑
不讀這節不影響使用。這裡是給想重現、或要把整篇丟給 AI 幫你排錯的人看的。
量法
我沒有用 ComfyUI 的網頁介面按,是照官方範本組了一份 API 版的 workflow,用一支 Python 腳本送進 ComfyUI,從送出(POST /prompt)開始計時,輪詢 /history 到狀態完成為止。所以秒數包含文字編碼、8 步去噪、影像和聲音解碼、存成 MP4,不包含下載檔案。每一發的秒數和參數都存成一份 JSON。
workflow 的主要節點(V2 圖生影片):
UNETLoader            fastvideo_fasth3_8step_v2_pruned_nvfp4.safetensors
MiniMaxH3SigmaShift   shift_video 10.0, shift_audio 3.0
ModelAttentionBackend comfy kitchen attention
BlockSparseAttention  selection vsa, keep_percent 10.0, start_percent 0.2, end_percent 1.0
CLIPLoader            qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors (type minimax)
MiniMaxH3ImageToVideo 1344x768, length 124, first_frame = LoadImage
KSamplerSelect        res_multistep
BasicScheduler        simple, steps 8
SamplerCustomAdvanced → VAEDecode + VAEDecodeAudio → CreateVideo 24 fps → SaveVideo
原版 H3 的對照組,把模型換成 minimax_h3_fl2va_pruned_nvfp4.safetensors,拿掉 SigmaShift、注意力後端和 BlockSparseAttention 三個節點,步數改 20(或 10),其他一樣。原版 H3 不掛 SigmaShift 等於用預設值。
768p 圖生影片對照的全部秒數:
| 設定 | seed | 秒數 |
|---|---|---|
| FastH3 V2,8 步 | 51 | 59.8 |
| FastH3 V2,8 步 | 52 | 57.4 |
| 原版 H3,20 步 | 61 | 166.3 |
| 原版 H3,20 步 | 62 | 168.2 |
| 原版 H3,10 步 | 51 | 90.1 |
| 原版 H3,10 步 | 52 | 83.6 |
換注意力後端,差不到 2 秒
V2、832×480 文生影片,只換注意力後端:
| 注意力後端 | 秒數 |
|---|---|
| comfy kitchen(範本預設) | 19.7 / 18.8 |
| SageAttention | 18.7 / 18.8 |
| PyTorch | 20.9 |
差距都在 2 秒內,範本預設就好。我的推測是 VSA 從去噪 20% 之後接手(start_percent 0.2),一般注意力只跑前面那一小段,換後端能省的本來就不多。
5090 上把 VSA 關掉
Trim、832×480,把 BlockSparseAttention 拿掉改跑一般注意力:開 VSA 兩發 17.7、17.6 秒,關掉是 19.3、17.9 秒。480p 下 VSA 省的時間很少,畫面越大省得越多是合理的推測,768p 我沒量。
為什麼 ComfyUI 比官方慢
官方 14.8 秒用的是 FastVideo 引擎,我用的是 ComfyUI,兩邊的節點實作、記憶體搬移、解碼方式都不一樣,這不是設定錯。要追到官方的數字得換 FastVideo,那要 Linux 或 WSL,我這次沒裝。
2080 Ti:VSA 默默改回一般注意力,證據是輸出一模一樣
ai-lab 那台 2080 Ti 上,我另外開了一份 ComfyUI 0.37.0 想試 VSA。BlockSparseAttention 節點在 0.37.0 存在,送出工作也不報錯,但 log 裡只有一行:
VSA: extra_tokens ignored
這行只代表節點有套上去,不代表底層 kernel 有跑。查 comfy-kitchen 的檢查條件:
torch.cuda.get_device_capability(0)            # (7, 5)
comfy_kitchen.sol_attn_is_available("cuda:0")   # False
底層的錯誤條件原文是 sol_attn: requires sm_80+ (cp.async, INT8 MMA)。nodes_sparse_attention.py 在 sol_attn_is_available() 回 False 時直接改走一般注意力,verbose=False 所以不印任何警告。
最直接的證據:同一個 seed,開 VSA 和不開 VSA 生出來的影片,解碼後每一格畫面的 MD5 完全一樣(240f06206ad0da4a33981c5051351705)。
2080 Ti 換 ComfyUI 0.37,反而更慢
為了試 VSA 開的那份 0.37.0:
- torch 2.6.0 起不來,comfy-kitchen 0.2.35 報
ValueError: infer_schema(func): Parameter stride has unsupported type list[int],改用支援 sm_75 的 torch 2.7.1+cu126、triton 3.3.1。 - SageAttention 1.0.6 在 triton 3.3.1、sm_75 上編譯失敗:
Error running sage attention: PassManager::run failed, using pytorch attention instead. - 結果是跑 PyTorch 注意力,480p 一支 595.0、570.0 秒,比 0.31 加 SageAttention 的 149.9 秒慢了快四倍。
所以 2080 Ti 留在 0.31,FastH3 Trim 照樣能跑,只是沒有 VSA。在 0.31 上開關 SageAttention 我都看過片,畫面都正常;0.31 關掉 SageAttention 一支是 212.3、194.9 秒。
常見問題
- FastH3 比原版 MiniMax-H3 快多少?
- 我在 RTX 5090 上用同一張首幀生 1344×768、5 秒的有聲片,FastH3 V2 兩發是 59.8 和 57.4 秒,原版 H3 用 ComfyUI 官方範本預設的 20 步,兩發是 166.3 和 168.2 秒,大約快 2.9 倍。原版 H3 降到 10 步是 90.1 和 83.6 秒。時間都含文字編碼和影音解碼。
- FastH3 在 ComfyUI 生一支 480p 影片要多久?
- RTX 5090、ComfyUI 0.37.0、熱機,832×480、124 格(約 5 秒)的文生影片:V2 兩發都是 18.7 秒,Trim 是 16.8 秒;剛開機第一支 V2 是 28 秒。官方部落格的 14.8 秒是用他們自家的 FastVideo 引擎量的,ComfyUI 慢 3 到 4 秒。
- FastH3 的 V2 和 Trim 差在哪?
- V2 保留完整 50 個區塊,Trim 砍掉影響最小的 8 個剩 42 個。ComfyUI 的 NVFP4 檔 V2 是 13.6 GB、Trim 是 11.9 GB。我量到 Trim 在 480p 快約 2 秒、768p 快 5 到 7 秒;官方說 Trim 在畫面元素多的場景細節較少,在意畫質用 V2。
- RTX 2080 Ti 可以跑 FastH3 嗎?
- 可以。我在魔改 22 GB 的 2080 Ti 上用 ComfyUI 0.31 跑 Trim 的 int8 檔,480p 一支冷機 189.4 秒、熱機 149.9 秒。但 FastH3 用來加速的稀疏注意力 VSA 在 2080 Ti 上不能用,節點不會報錯,會默默改用一般注意力。
- FastH3 講中文台詞準嗎?
- 準。我寫「欢迎来到 AI Muninn,今天带你看最新的 AI 消息。」,V2 和 Trim 生出來的聲音用 Whisper 轉回文字,只有自造詞 Muninn 被聽成 Money,其他字全對。看板娘圖生影片那一版被聽成 Mooning,其餘也全對。
接著讀
- 2026-09-03[Benchmark] MiniMax-H3 在 RTX 5090 上的加速組態:換成 cu130 省 32%,注意力 kernel 只值 3%
同一張 5090、同樣 14 步、同樣品質設定,六個加速組態各值幾 %。原生 768p 的 15 秒片從 OOM 變成 8.6 分鐘。chunk 參數切越細越快、torch 換成 cu130 省 32%,而 SageAttention 跟 Sol-Attn 這兩個單看 kernel 快 4 倍的東西,端到端只值 2-3%。
- 2026-10-08[Benchmark] Kandinsky 6.0 Pro 對嘴實測:英文台詞一字不差,中文還差點意思(RTX 5090)
Kandinsky 6.0 Pro 一次生 5 秒影片加聲音,人物照台詞對嘴。我在 RTX 5090 實測:英文台詞 Whisper 逐字正確,中文聽得懂但有口音、錯幾個字;NVFP4 版一支片 141.5 秒。
- 2026-08-31[Benchmark] MiniMax-H3 十個效果 embedding 實測:放在提示詞開頭會靜默失效
RTX 5090 一張卡跑完 MiniMax-H3 的十個效果 embedding。最大的坑是位置:放在提示詞開頭會靜默失效,畫面卻照樣會變,所以「產物不一樣」不能當生效證據。它們也不是關鍵字,是 50 到 142 個預先編好的向量。附十支實測影片與速查表。
- 2026-08-04[Benchmark] 一張 5090 跑會說話的 33B 影片模型:MiniMax-H3 從下載到生出第一支片
MiniMax-H3 影音同步生成新手教學。完整版 115 GiB 要四張卡,量化後 31.7 GiB 一張 RTX 5090 就夠。要下載哪些檔、放哪、怎麼設、提示詞怎麼寫。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。