[Benchmark] Kandinsky 6.0 Pro 對嘴實測:英文台詞一字不差,中文還差點意思(RTX 5090)
❯ cat --toc
TL;DR
Kandinsky 6.0 是 10 月 6 日開源的影音模型,一次生出 5 秒影片和 44 kHz 聲音,畫面裡的人會照你寫的台詞對嘴。我在 RTX 5090 跑 29B 的 Pro 蒸餾版:英文台詞 Whisper 轉回來逐字正確,只有自造詞 Muninn 被聽錯;中文聽得懂,但帶外國口音、錯幾個字。順手轉了一份 NVFP4,一支片 141.5 秒,畫面跟原版幾乎一樣,權重放在 Hugging Face。
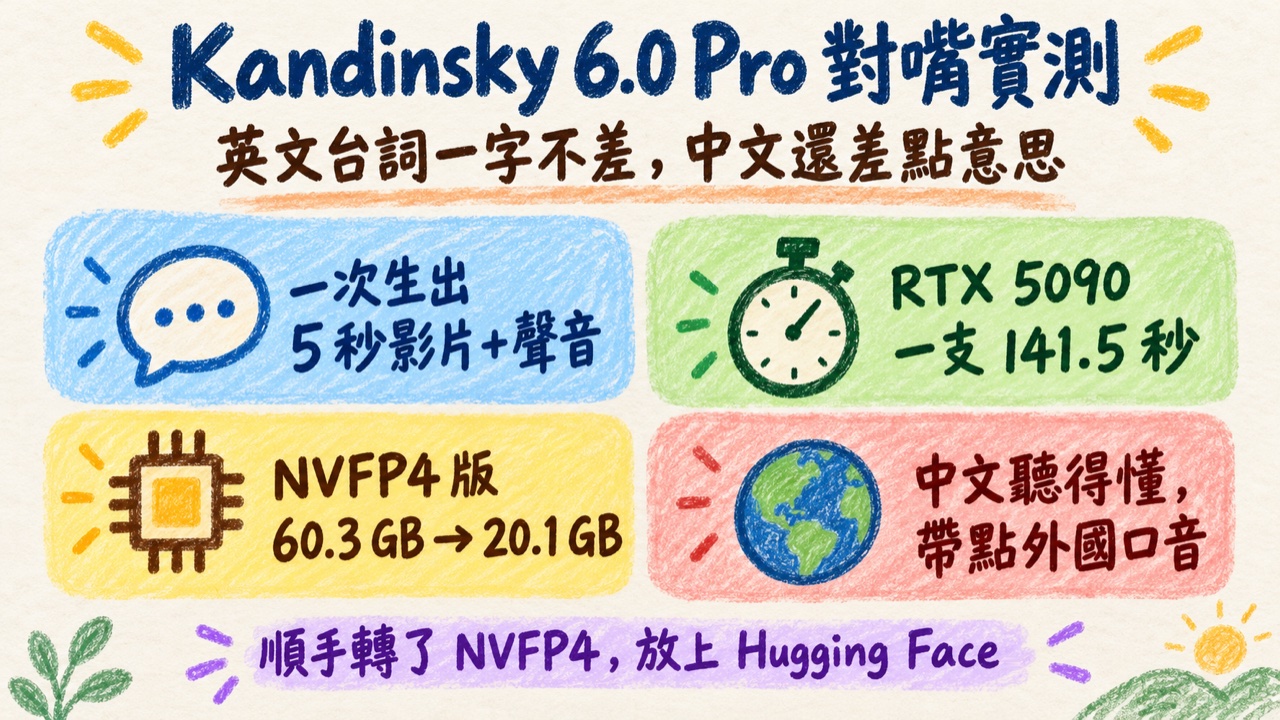
短片版:Kandinsky 6.0 Pro 講中文和英文台詞
前言
10 月 6 日看到 Kandinsky 6.0 開源的消息,我就簡單測了一下。吸引我的是它會對嘴:你在提示詞裡寫一句台詞,它生出來的影片裡,人物會開口把那句話講出來,嘴型跟聲音一起出來,不用另外配音再對嘴。
我最想知道兩件事:台詞講得準不準,以及一張 RTX 5090 跑一支要等多久。測的過程中順手把 Pro 轉成了 NVFP4(一種 4 位元的壓縮格式,檔案小很多,RTX 5090 可以直接拿來算),省下不少時間,權重也放上 Hugging Face,給後面想跑的人用。
Kandinsky 6.0 是什麼:一次生出畫面、聲音和嘴型
Kandinsky 6.0 是 Kandinsky Lab 在 2026-10-06 開源的模型,MIT 授權。有兩種大小:Lite 3B、Pro 29B。兩個都是一次生 5 秒影片,連同 44 kHz 的聲音,可以從文字生,也可以給一張圖加文字生。另外有一顆超解析模型,可以把畫面放大到 1920×1080。
它跟一般影片模型不一樣的地方,是畫面和聲音在同一個模型裡一起生。模型裡有兩條線,一條處理畫面、一條處理聲音,兩條線在生成過程中一直互相參考,嘴巴張開的時間點才會對上聲音。官方的論文拿它跟 Kling 2.6、Veo 3.1 Fast、MiniMax H3 等模型做人工評比,論文特別強調它講話的表現不輸這些模型;勝率數字我沒從 PDF 核對到,這裡不引用。
台詞的寫法很直接:在畫面描述裡把要講的話用 <S> 和 <E> 包起來,聲音另外一欄描述是誰在講、什麼語氣、背景有什麼聲音。我這次用的畫面描述是這樣:
Medium close-up of a beautiful young Chinese woman in traditional Hanfu, pale blue silk with
embroidered sleeves, hair in an elegant bun with a jade hairpin, standing in a quiet classical
garden courtyard with a wooden pavilion behind her. The camera is static. She looks straight
into the camera, smiles gently and says: <S>Welcome to AI Muninn. Here's today's AI news.<E>
Soft afternoon light, photorealistic, shallow depth of field.
聲音欄:
A clear, warm young female voice speaking English at a calm pace, quiet garden ambience with soft birdsong.
中文那一發,只把 <S> 裡換成「歡迎來到 AI Muninn,今天帶你看最新的 AI 消息。」,聲音欄的 English 換成 Mandarin Chinese,其他都一樣。
英文台詞一字不差,中文聽得懂、帶點口音
台詞準不準,我用 Whisper(OpenAI 開源的語音轉文字模型,用 large-v3-turbo 這個版本)把生出來的聲音轉成文字,跟原本寫的台詞比。嘴型對得好不好 Whisper 量不到,那部分是我自己看片的判斷:英文那幾支,嘴型跟聲音的時間點很自然,看起來就是她在講話。
先看英文。Pro 蒸餾版原版(bf16,也就是官方發布的 16 位元原始精度)和我轉的 NVFP4 版都轉回「Welcome to AI Muninn. Here's today's AI news.」,只有 Muninn 這個自造的字被聽成 Munnin 或 Manin,其他字都對。
Pro 蒸餾版 NVFP4,英文台詞,seed 42(預設靜音,開聲音聽)
中文是另一個樣子。聽起來像一個中文講得不錯的外國人,意思聽得懂,有口音,有幾個字咬不準:
| 版本 | 台詞(寫的) | Whisper 轉回來 |
|---|---|---|
| Pro bf16 | 歡迎來到 AI Muninn,今天帶你看最新的 AI 消息。 | 欢迎来到AI慕您,请演带您看最起的AI消息 |
| Pro NVFP4 | 同上 | 欢迎来到AI母您,今天带你看最起的AI消息 |
這張表看右邊那欄:「歡迎來到 AI」都對,「最新」兩版都被聽成「最起」。NVFP4 那發「今天帶你看」比原版準,但每種只跑一發,這不能拿來說量化讓中文變好,同一個設定換個 seed 就可能反過來。Whisper 輸出的是簡體,是轉寫工具的預設,跟模型無關。
Pro 蒸餾版 NVFP4,中文台詞,seed 42(預設靜音,開聲音聽)
論文寫訓練資料的描述是俄文和英文雙語,強化學習階段的提示詞也是俄文、英文各一半機率,整篇沒提到中文。它還是講得出聽得懂的中文,但要拿來做中文旁白或中文角色,現在還差點意思。
在 RTX 5090 上跑起來要準備的東西
我的環境是 RTX 5090(32 GB)、61.6 GB 記憶體、Windows。我用 ComfyUI 跑,它是一個開源的介面,把模型的每個步驟做成方塊(節點),連起來就能生圖、生影片;Kandinsky 官方有出一套自己的節點。
準備工作就是四件事:新版的 ComfyUI、官方節點、模型檔、一個加速套件。照順序來:
- ComfyUI 0.38.0 以上。 官方節點寫明要 0.38.0+。我平常跑 MiniMax-H3 的那份 ComfyUI 是 0.37,裝著一整套 H3 節點,所以我另外用
git worktree開了一份 0.38.2,配一個獨立的 Python 環境,兩邊互不影響。 - 官方節點
kandinsky6。 ComfyUI Manager 搜kandinsky6安裝,或是把 kandinsky-6 repo 裡的comfyui/複製到custom_nodes/kandinsky6/。 - 模型檔。 工作流裡有 Download models 按鈕,會自動下載;要手動的話,官方節點 README 有一張表,列出每個檔放在哪個資料夾。核心是 Pro 蒸餾版本體(60.3 GB)、兩個文字編碼器(Qwen2.5-VL 7B、CLIP-L)、HunyuanVideo 的影像 VAE、MMAudio 的聲音 VAE 和 BigVGAN 聲碼器。
- SageAttention。 加速套件,讓模型裡最花時間的那一段(attention)算得比較快,裝了之後 ComfyUI 會自動用。我第一輪沒裝,同一支片從 277 秒變 206.7 秒,差很多,建議一開始就裝。
取樣參數照官方建議:Pro 蒸餾版用 10 步、CFG 1.0、聲音 VAE 的 scaling 0.417。沒蒸餾的一般版要 50 步、CFG 5.0,慢很多。
官方工作流預設會先用 Qwen3.5 把你的短提示詞擴寫成一大段,再丟給模型。我是自己寫完整的英文描述,所以把擴寫關掉,直接送。我用的是自己寫的 API 版工作流,節點和上面的設定都一樣,解析度 864×480、121 格(24 fps,約 5 秒)、seed 42。
一支片要多久:bf16 是 206.7 秒,NVFP4 是 141.5 秒
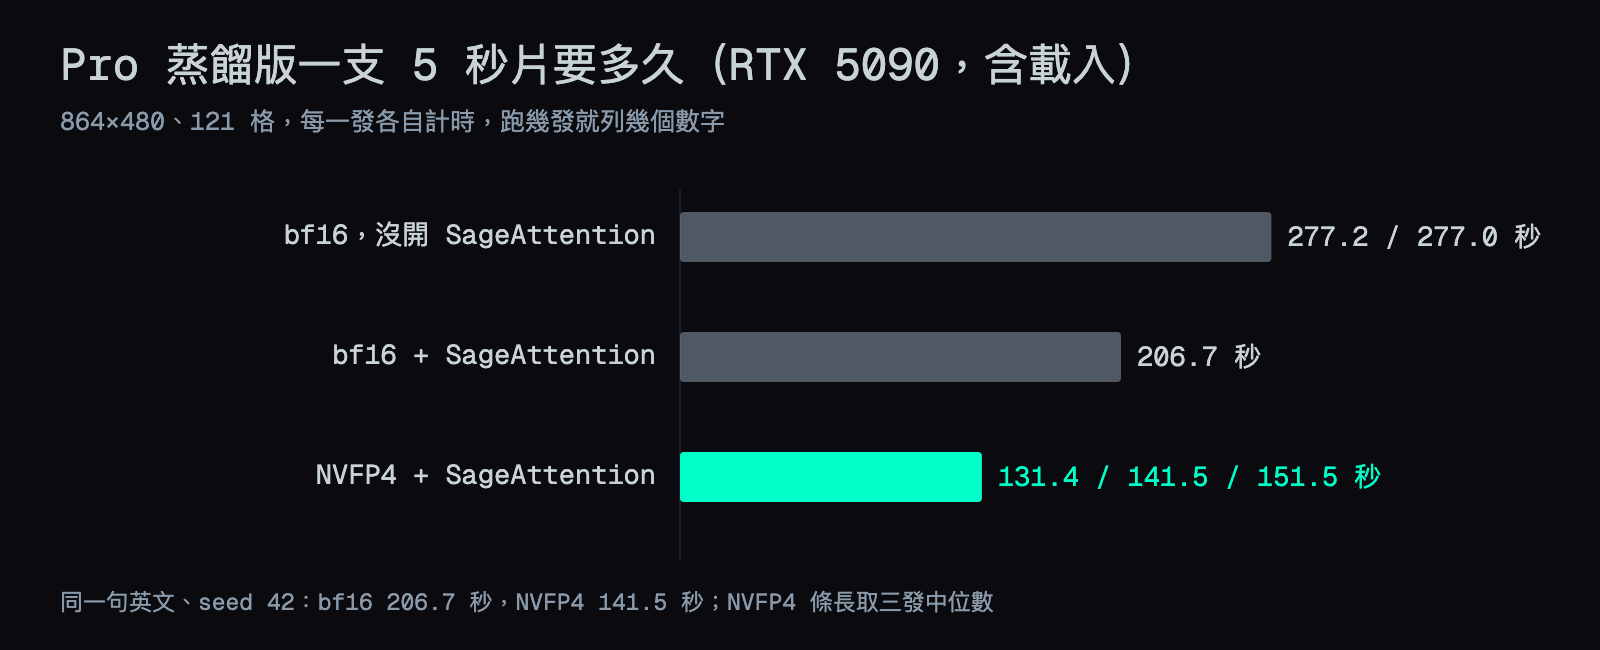
所有時間都是從送出工作算到影片存好,包含載入模型。速度我只拿同一顆 Pro 蒸餾版的原版和 NVFP4 版互相比:同一句英文台詞、同一個 seed 42、都開 SageAttention,bf16 是 206.7 秒,NVFP4 是 141.5 秒。最上面那條 277 秒是我還沒裝 SageAttention 時的 bf16,留著當參考。
60.3 GB 的 bf16 原版放不進 32 GB 的顯卡,但照樣跑得動:ComfyUI 0.38 會把權重分批搬進顯卡,算到哪搬到哪。log 裡那行 57486MB Staged 就是它在做這件事。代價是每次都要花時間搬權重。
轉成 NVFP4 之後檔案剩 20.1 GB,要搬的權重少很多。我一共跑了三發 NVFP4:英文 seed 42 是 141.5 秒、中文 seed 42 是 131.4 秒、英文 seed 7 是 151.5 秒,台詞和 seed 不同,時間落在 131.4 到 151.5 秒之間。
順手轉了一份 NVFP4,畫面幾乎一樣
NVFP4 是 NVIDIA 新一代顯卡支援的 4 位元格式,權重存得更小,RTX 5090 可以直接算。我測的時候發現 bf16 每次都要搬 60 GB 權重,就先轉一份 NVFP4 再繼續測,轉檔本身花了 59 秒。
同一句英文台詞、同一個 seed,原版和 NVFP4 版放在一起:
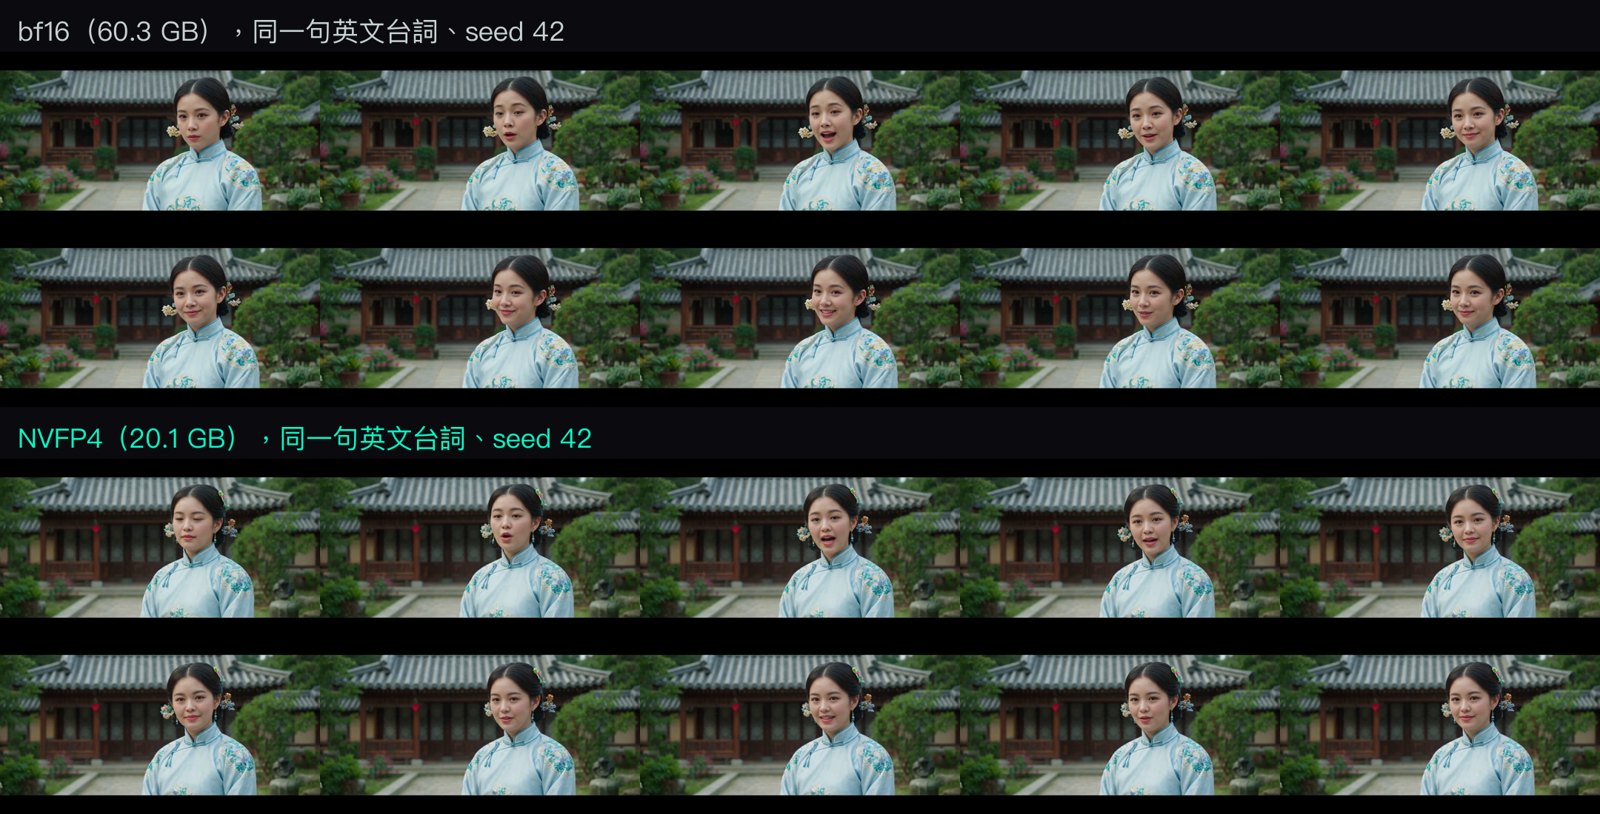
構圖、服裝、背景、嘴巴張開的時間點幾乎一樣,臉的細節有一點差別,畫面沒有變髒。之前我轉 Qwen-Image 2.1 的 NVFP4,畫面會偏髒,這次沒有。
檔案放在 coolthor/Kandinsky-6.0-Pro-distill-5s-NVFP4。ComfyUI 0.38.2 原生就能載入,節點不用改:把檔案放進 models/diffusion_models/,在 Load Diffusion Model 節點選它,其他設定照舊。在我之前,Hugging Face 上已經有 kabachuha 轉的 int8 版(要搭配 ComfyUI PR #16825),NVFP4、fp8、GGUF 版我在 10-08 查的時候還沒看到有人放。
Lite 版:英文可以,中文會走樣
Lite 只有 3B,我也試了一下。官方節點目前擋掉 Lite 的蒸餾版,所以我跑的是一般版 50 步(沒開 SageAttention),一支片 488.7 到 498.7 秒。
Lite 的英文台詞也是對的。中文就真的走樣了,Whisper 轉回來是「微信来就爱一门呢 今天大家试试AAI什么系」,聽不出原本那句話。
Lite 一般版,中文台詞(預設靜音,開聲音聽)
要做對嘴影片,我會直接用 Pro 蒸餾版。
進階:踩過的坑與 NVFP4 轉檔紀錄
不讀這節不影響使用。這裡是給想重現、或是要把整篇丟給 AI 幫你排錯的人看的。
官方節點要 ComfyUI 0.38,我另開一份環境
官方節點要 0.38.0 以上,直接把我那份 0.37.0 升級,有可能把 H3 那套節點弄壞,所以用 worktree 另開:
git -C C:\Users\coolt\ComfyUI fetch --tags origin
git -C C:\Users\coolt\ComfyUI worktree add --detach C:\Users\coolt\ComfyUI-k6 v0.38.2
# 獨立 venv,torch 用 cu130
python -m venv C:\Users\coolt\venv-k6
C:\Users\coolt\venv-k6\Scripts\python.exe -m pip install torch==2.13.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/cu130
git clone --depth 1 https://github.com/kandinskylab/kandinsky-6 C:\Users\coolt\k6-src
Copy-Item -Recurse C:\Users\coolt\k6-src\comfyui C:\Users\coolt\ComfyUI-k6\custom_nodes\kandinsky6
新的那份開在 8189 port,舊的 8188 照常跑。要拆掉的話 git worktree remove 加刪掉 venv 就乾淨了。
官方節點擋掉 Lite 蒸餾版
想試 Lite 蒸餾版時,節點直接報錯。原因寫在官方節點的 register.py:
Distilled K6 Lite checkpoints are not supported.
所以 Lite 我只能跑一般版 50 步、CFG 5.0、聲音 scaling 0.5302。這是節點的限制,不是模型壞掉。
Windows 上 pip 下大檔卡死
在 5090 那台 Windows 上,pip 從 PyPI 下載大的 wheel 兩次卡在 0 bytes 不動,同一台機器用 curl 下載正常。我改用 uv 安裝,SageAttention 用離線的 wheel:
uv pip install --python C:\Users\coolt\venv-k6\Scripts\python.exe `
  sageattention-2.2.0+cu130torch2.10.0andhigher.post6-cp310-abi3-win_amd64.whl triton-windows==3.7.1.post27
裝完用一小段程式確認能跑:
import torch, sageattention
q = torch.randn(1, 8, 256, 128, dtype=torch.float16, device="cuda")
print(sageattention.sageattn(q, q, q).shape)
第一輪慢,主因之一是漏裝 SageAttention
第一輪 bf16 兩發都是 277 秒(277.2、277.0),裝上 SageAttention 後同一個設定是 206.7 秒,省了 70 秒。
我還有一發 NVFP4 的 smoke test 是 211.9 秒,當時有沒有已經裝好 SageAttention 我沒記下來,所以沒放進上面的圖。
NVFP4 怎麼轉的
工具是 Comfy-Org/comfy-quants 的量化工具,我用的是 kabachuha 加上 Kandinsky 6 支援的 kand6 分支,commit 4b96626。設定檔:
model:
  family: kandinsky6
  dtype: bf16
  components:
    transformer: quantize
    text_encoder: keep_bf16
    vae: keep_bf16
    audio_vae: keep_bf16
quant:
  algorithm: nvfp4
  target_dtype: nvfp4
  scale:
    granularity: block
    axis: in_features
    method: amax
  rounding: nearest_even
  modules:
    include:
      - "visual_transformer_blocks.*"
      - "video_text_transformer_blocks.*"
      - "audio_text_transformer_blocks.*"
    exclude:
      - "visual_transformer_blocks.0.*"
      - "visual_transformer_blocks.1.*"
      - "visual_transformer_blocks.58.*"
      - "visual_transformer_blocks.59.*"
  fallback:
    on_error: keep_bf16
量化的是三組 transformer block 裡的 Linear 層,共 1,840 個(畫面 1,792、影片文字 24、聲音文字 24)。畫面那組頭尾各兩個 block(0、1、58、59)留 bf16,這是照 LTX-2 官方 NVFP4 版的做法:第一層和最後幾層對精度比較敏感。norm 和 bias 原樣複製。
結果:
| 項目 | 數字 |
|---|---|
| 來源 | 60,344,993,576 bytes,4,471 個 tensor |
| 輸出 | 20,094,169,424 bytes(18.71 GiB),9,991 個 tensor |
| 量化的 Linear | 1,840 個,每個多一組 weight_scale 和 weight_scale_2 |
| 轉檔時間 | 59.26 秒 |
| 轉檔 process 的記憶體峰值 | 49.33 GiB(Windows working set) |
exporter 是一張一張 tensor 從硬碟讀(safe_open(..., device="cpu")),不會先把 60 GB 整份讀進記憶體,所以 61.6 GB 的機器轉得動。
第一次轉到最後 save_file 時失敗,原因是 venv 沒裝 NumPy,沒有產生輸出檔;用 uv 補裝 NumPy 後第二次成功。
輸出檔的 key 名稱跟 ComfyUI 官方節點用的一樣,不用轉換。smoke test 的影片 ffprobe 出來是 121 格畫面加 44,100 Hz 聲音,ComfyUI log 顯示用的是原生的 nvfp4 混合精度運算。
常見問題
- Kandinsky 6.0 Pro 可以講中文台詞嗎?
- 可以講,聽得懂,但還不太自然。我寫「歡迎來到 AI Muninn,今天帶你看最新的 AI 消息。」,Whisper 轉回來是「欢迎来到AI慕您,请演带您看最起的AI消息」,帶外國口音、錯幾個字。論文寫訓練資料的描述是俄文和英文雙語,整篇沒有提到中文。英文台詞同一套設定逐字正確。
- RTX 5090 跑 Kandinsky 6.0 Pro 生一支 5 秒影片要多久?
- 864×480、121 格、Pro 蒸餾版 10 步,含載入模型:bf16 原版沒開 SageAttention 是 277 秒,開了是 206.7 秒;換成 NVFP4 版加 SageAttention,三發是 131.4、141.5、151.5 秒。
- 32 GB 的 RTX 5090 放得下 60 GB 的 Kandinsky 6.0 Pro 嗎?
- 放不下也跑得動。ComfyUI 0.38 會把權重分批搬進顯卡,邊跑邊搬,bf16 原版一支片 206.7 秒(開 SageAttention)。轉成 NVFP4 後檔案是 20.1 GB,一支片 141.5 秒。
- Kandinsky 6.0 的台詞要怎麼寫?
- 台詞寫在畫面描述裡,用 <S> 和 <E> 包起來,例如 says: <S>Welcome to AI Muninn.<E>;聲音那一欄另外描述說話的人和背景音。官方 ComfyUI 工作流預設會先用 Qwen3.5 把短提示詞擴寫,自己寫完整描述的話可以把它關掉。
接著讀
- 2026-09-03[Benchmark] MiniMax-H3 在 RTX 5090 上的加速組態:換成 cu130 省 32%,注意力 kernel 只值 3%
同一張 5090、同樣 14 步、同樣品質設定,六個加速組態各值幾 %。原生 768p 的 15 秒片從 OOM 變成 8.6 分鐘。chunk 參數切越細越快、torch 換成 cu130 省 32%,而 SageAttention 跟 Sol-Attn 這兩個單看 kernel 快 4 倍的東西,端到端只值 2-3%。
- 2026-08-31[Benchmark] MiniMax-H3 十個效果 embedding 實測:放在提示詞開頭會靜默失效
RTX 5090 一張卡跑完 MiniMax-H3 的十個效果 embedding。最大的坑是位置:放在提示詞開頭會靜默失效,畫面卻照樣會變,所以「產物不一樣」不能當生效證據。它們也不是關鍵字,是 50 到 142 個預先編好的向量。附十支實測影片與速查表。
- 2026-08-06[Benchmark] 625 秒砍到 314 秒,快了整整一倍:MiniMax-H3 在 RTX 5090 上該開的三個開關
同一支 15 秒 1080p 有聲影片,出片時間對半砍,畫面沒有變差。步數 20 改 14、SageAttention 2.2.0、放大器換成 RTX Video Super Resolution,三個開關各省多少、怎麼開、坑在哪。
- 2026-08-04[Benchmark] 一張 5090 跑會說話的 33B 影片模型:MiniMax-H3 從下載到生出第一支片
MiniMax-H3 影音同步生成新手教學。完整版 115 GiB 要四張卡,量化後 31.7 GiB 一張 RTX 5090 就夠。要下載哪些檔、放哪、怎麼設、提示詞怎麼寫。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。