MiniMax-H3 on RTX 5090 · part 18
[MiniMax-H3] Viggle Remake 換角教學:RTX 5090 跑 int8,真人舞蹈換成虛構角色
❯ cat --toc
- 前言
- Viggle Remake 是什麼:一段影片加兩張畫好的關鍵幀,人就換掉
- 盲比:Remake 89 分,SAM 遮罩加 H3 手工換角 74 分
- 照著做:在 RTX 5090 上把舞者換成你的角色
- 步驟一:裝 node pack,下載 int8 權重
- 步驟二:影片轉 24 fps,幀數切成 17n+5
- 步驟三:人太小就先放大裁切成直式
- 步驟四:先生一張角色圖,再畫兩張 painted frame
- 步驟五:寫六段式 prompt
- 步驟六:接線與參數
- 實拍換阿嬤:短邊 736 一段約 10 分鐘,評審 80 分
- 換場景:先換角再 edit 比較穩,雨天騎樓 82 分
- 進階:完整數字、評審方法與失敗紀錄
- 評審是誰、怎麼評的
- 盲比的素材條件
- 耗時與 VRAM 全表
- 實拍兩段的缺陷原文
- 換場景四版的缺陷原文
- 這次測試的邊界
- 來源與相關
TL;DR
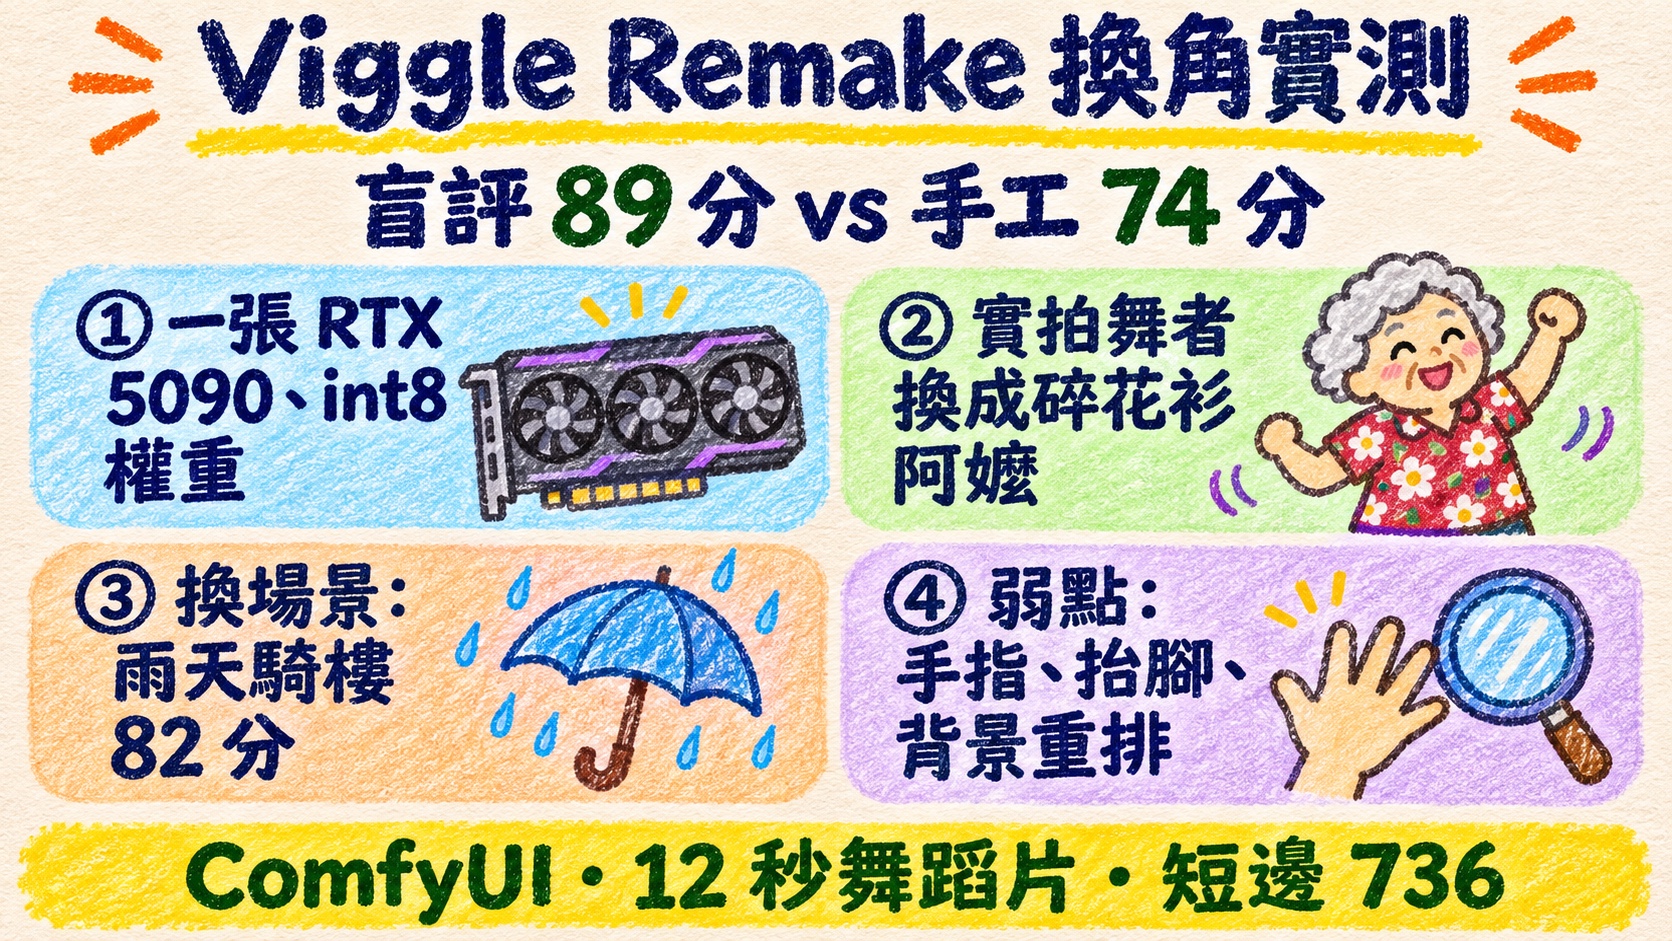
Viggle Remake 是掛在 MiniMax-H3 上的換角模型:給一段影片和兩張畫好目標的關鍵幀,就把畫面裡的人換掉。我在一張 RTX 5090 用 ComfyUI 跑官方 int8 權重,把真人舞蹈換成虛構的碎花衫阿嬤。跟我們原本用 SAM 遮罩加 H3 的手工換角盲比,本地視覺評審給 Remake 89、手工 74,我自己盲選也選 Remake。短邊 736、12 秒一段約 10 分鐘。再搬到雨天騎樓做得到,但背景每幾秒會重排,手指和抬腳的鞋也還會壞。
左邊是原舞者,右邊是 Viggle Remake 換成的虛構阿嬤,短邊 736、294 幀、12.25 秒,一張 RTX 5090 跑約 10 分鐘。原舞蹈影片出自 YouTube 頻道 JD Dance Tutorial 的〈DAME HOMBRO Give Me a ShoulderDance Trend tutorial〉,阿嬤是生成的虛構角色。這裡拿掉了聲音
前言
我一直想讓自己做的虛構角色跳真人的舞。網路上一段跳得好的舞,換成我的角色來跳,動作、節奏都不用自己編。
之前的做法是手工拼的:先用 SAM 把舞者遮罩出來,再交給 MiniMax-H3 的 Character Swap 換成角色。換是換得過去,但人物周圍會留一圈灰色的補景,臉跳著跳著也會漂。上一個相關的嘗試是把真人舞蹈轉成深度影片給 H3 跳,動作跟得上,但不是一格一格照跳。
Viggle 放出 Viggle Remake 之後,我拿同一個阿嬤跟手工版盲比。結果分數 Remake 比較高,連我自己盲選也挑它。接著發現兩件事:人在畫面裡太小,動作會糊;成片全都是白棚空場景。所以又補了人放大和換場景兩組測試。
一句話講完這篇:一張 RTX 5090,把一段跳舞影片的人換成碎花衫阿嬤,再把她搬到廟口夜市或雨天騎樓。
Viggle Remake 是什麼:一段影片加兩張畫好的關鍵幀,人就換掉
Remake 不是全新的模型,是 Viggle 在 MiniMax-H3 上訓練的兩組權重,分兩種模式:
- swap:換掉畫面裡的人物或角色,例如把舞者換成阿嬤。
- edit:改畫面其他部分,例如人不動、把背景換成騎樓。
它吃三樣東西:原影片、一到四張 painted frame、一段六段式 prompt。painted frame 就是從原影片挑一格,用修圖模型把目標畫上去(人換成阿嬤、背景換成夜市),再告訴 Remake 這張是第幾格。這幾格會被釘在時間軸上當關鍵幀,長相和造型由它們決定,動作和時間由原影片決定。
官方給小顯卡的版本是把 LoRA 先合進底模、再量化成 int8 的單一檔案,一個模式一個檔,每個約 21 GB。32 GB 的 5090 用 int8 就好,不用另外掛 LoRA。
盲比:Remake 89 分,SAM 遮罩加 H3 手工換角 74 分
同一段 12.25 秒的舞、同一個虛構阿嬤,兩種做法各跑一支,左右並排交給本地的視覺評審模型打分。評審只看得到角色參考圖和抽出來的 11 個時間點,不知道哪邊是哪個做法。
盲比用的 A/B 片:A(左)是 Viggle Remake,B(右)是 SAM 遮罩加 MiniMax-H3 Character Swap 的手工版。來源是灰色人偶跳舞再環繞一圈,兩邊吃同一段來源。B 的人物周圍那圈灰色就是手工版的補景
這張表看最右欄和背景那欄:
| 做法 | 長相一致 /40 | 輪廓與腳 /35 | 背景殘影 /25 | 總分 |
|---|---|---|---|---|
| Viggle Remake | 37 | 31 | 21 | 89 |
| SAM + H3 手工 | 33 | 27 | 14 | 74 |
差 15 分。我們事先定好差距小於 10 分算平手,所以這次算 Remake 勝出。左右對調再評一次,還是選 Remake。兩回合的成對比較裡,長相一致和腳的輪廓都判平手,拉開分數的是背景:手工版那圈灰色補景在 Remake 裡消失了。
我自己也盲選了一次,挑的是 Remake。
照著做:在 RTX 5090 上把舞者換成你的角色
ComfyUI 是一個開源程式,用節點把生成流程一格一格拼起來。這節照順序做完,會拿到一支換好角色的跳舞影片。這節是寫給已經有 5090、也裝過 ComfyUI 的人;第一次碰的話,可以先跳到後面看結果。
我的環境是一張 RTX 5090(32 GB)、ComfyUI 0.37.0、PyTorch 2.13.0+cu130。整條流程是六步,前四步在準備材料,真正跑 Remake 只有最後一步。
步驟一:裝 node pack,下載 int8 權重
Remake 要一個小的 node pack ComfyUI-Viggle-Remake,其餘都是 ComfyUI 內建節點。權重只要下載 swap 的 int8 檔;要換場景再加 edit 的那個。
cd ComfyUI
pip install -U "huggingface_hub>=1.0"

# node pack 和官方 workflow
hf download Viggle/Viggle-Remake --include "comfyui/*" --local-dir ./Viggle-Remake
cp -r Viggle-Remake/comfyui/ComfyUI-Viggle-Remake custom_nodes/

# swap int8(約 21 GB),要換場景再加 edit 那個
hf download Viggle/Viggle-Remake --include "int8/viggle_remake_swap_pruned_int8_convrot.safetensors" --local-dir ./Viggle-Remake
hf download Viggle/Viggle-Remake --include "int8/viggle_remake_edit_pruned_int8_convrot.safetensors" --local-dir ./Viggle-Remake
mv Viggle-Remake/int8/*.safetensors models/diffusion_models/
文字編碼器和兩個 VAE 跟 MiniMax-H3 共用,已經裝過 H3 就有。我用的是:
- 文字編碼器:
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(Load CLIP,type 選minimax) - VAE:
minimax_h3_video_vae_fp16.safetensors、minimax_h3_audio_vae_fp32.safetensors
⚠️ 官方是用 ComfyUI 0.42.0 測的。我的 0.37.0 沒有 node pack 引用的 comfy.audio,一載入就會出錯;我在 pack 裡補了一段改用 torchaudio 重取樣的備案才跑得起來。ComfyUI 版本夠新的話應該碰不到。
步驟二:影片轉 24 fps,幀數切成 17n+5
Remake 的幀數只吃 17n+5,範圍 90 到 345。我用 294 幀(17×17+5),24 fps 下剛好 12.25 秒。節點不會幫你轉幀率,要先自己轉:
ffmpeg -i dance.mp4 -r 24 dance-24fps.mp4
# 從第 0 格起取 294 格
ffmpeg -i dance-24fps.mp4 -frames:v 294 source.mp4
解析度看 short_edge:官方文件列的兩個標準設定是 480 和 736,節點其實接受 480 到 736 之間、每次加 32 的值。我只用過 480 和 736。
步驟三:人太小就先放大裁切成直式
這步是第一輪踩到才補的。原影片是 832×480 的橫片,舞者在畫面裡不大,換出來的手腳動作很容易糊成一團。所以正式跑之前,我先把人裁大:
- 每一格找出舞者的範圍框(固定機位,拿背景差異去抓),前後 21 格做平滑,畫面才不會跟著抖。
- 裁成直式,人物高度目標是畫面的 78%,最高不超過 85%,四邊至少留 3%。
- 輸出 736×1280,對應 Remake 的
short_edge736。
裁完人物高度平均約 78%。要注意原片只有 480 高,裁大之後臉和手看得比較清楚,但不會多出原本沒有的細節。不裁的話,節點會把影片等比縮放後置中裁到畫布上。
步驟四:先生一張角色圖,再畫兩張 painted frame
阿嬤是先用 Qwen-Image 2.1 生的一張全身參考圖(int8 加 4 步 Turbo LoRA Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors,768×1152):七十歲左右、灰白短捲髮、紅色碎花短袖上衣、深色長褲、白布鞋,白底。
接著從裁好的影片取第 73 格和第 144 格,各配上這張角色圖,用 Qwen-Image 2.1 int8 的編輯模式改畫成阿嬤(40 步、CFG 1)。prompt 重點是「只換人,姿勢、手腳位置、房間全部照原圖」,我用的長這樣:
Edit <image1>. Replace only the single dancer with the exact same completely fictional
70-year-old Taiwanese grandmother in <image2>: identical kind elderly face, short permed
gray-white hair, fitted red small floral-print short-sleeved blouse, fitted dark trousers
and white canvas sneakers. Match exactly the source dancer pose, hand, elbow, knee and foot
locations, body size and position and face direction, including side view where present.
Retain the exact portrait canvas, camera, cream-white wall, dark wooden door, switches,
wood floor, light and shadow from <image1>. ...
不用照抄,講清楚「換誰、換成什麼、哪些不能動」就好。這兩張圖會直接決定成片長什麼樣,也會把它多畫的東西帶進成片(後面會講多出來的門)。選哪兩格,我挑的是正面和轉身的時刻,讓阿嬤的正反兩面都有參考。
步驟五:寫六段式 prompt
Remake 讀的是 MiniMax-H3 的六段式 prompt,順序固定:subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_music。<Video 1> 指原影片,<Picture 1>、<Picture 2> 是兩張 painted frame,<Subject 1> 是阿嬤。
官方提醒最有用的一條:要寫成「成片長什麼樣」,不是寫指令。retention_analysis 會被照字面執行,寫了什麼要保留,它就保留。我實拍那段的開頭:
subject_definitions:
<Video 1> is a 12.25-second 294-frame continuous portrait live-action dance at 24fps in a
room with a cream-white wall, wall corner and switches, dark wooden door, wood floor and a
cast shadow. <Picture 1> and <Picture 2> are painted target frames at output frames 73 and
144. <Subject 1> is the same completely fictional 70-year-old Taiwanese grandmother from
both pictures, ...

summary:
[video editing + character replacement] The sole performer is <Subject 1>, the same
fictional grandmother, performing the exact dance poses of <Video 1>. ...
detailed_description 裡的時間點要跟 pin 的幀對上:第 73 格是 00:03.042,第 144 格是 00:06.000。
步驟六:接線與參數
官方 workflow comfyui/workflows/remake_swap_ui.json 拖進 ComfyUI,把 Load Diffusion Model 和 LoRA 那兩個節點換成一個載入 int8 檔的 Load Diffusion Model,接到 Viggle Remake Keyframe Until。我用的參數:
| 設定 | 值 |
|---|---|
| frames / short_edge | 294 / 480 或 736 |
| pins | 73, 144 |
| keyframe_until | 0.9 |
| 取樣 | euler 6 步,seed 904239 |
| swap sigmas | 1.0, 0.990476, 0.965243, 0.923077, 0.8, 0.631579, 0.0 |
換場景用 edit 檔時,sigmas 換成 1.0, 0.983607, 0.96, 0.923077, 0.857143, 0.705882, 0.0。int8 檔已經合好 LoRA,別再疊一次。
跑 736 時,我另外接了 H3 Relay 這個 node pack 裡的 H3RelaySamplingMemory 節點(GPL-3.0),把取樣工作區估成 30 GiB,讓 ComfyUI 提早把權重卸到系統記憶體。官方的顯卡對照表寫 32 GB 卡用 int8 跑 1280×736 最多 175 幀,但那是他們在 B200 上限制可用記憶體、模擬 32 GB 卡,走 CUDA 12.8 備用路徑量的。同一份文件也寫,CUDA 13 加上專用 worker,單張 5090 可以跑到 345 幀(約 28 分鐘)。我這台是 CUDA 13 的 PyTorch,294 幀跑完沒有爆,整卡峰值 31,776 MiB。不想多裝這個 pack,就把 short_edge 改成 480:官方表上 32 GB 卡跑 832×480 用 int8 不用加任何旗標(他們量的是 226 幀,一樣是 B200 模擬、CUDA 12.8 的條件)。我這次 480 的幾支其實也接著這個節點(估 24 GiB),整卡峰值約 30.6 GB,所以「480 不接 Relay 跑 294 幀」這組我沒有實測過。
實拍換阿嬤:短邊 736 一段約 10 分鐘,評審 80 分
文章頂端那支就是成品。原影片 30 秒,我取兩段不重疊的 12.25 秒,第二段特地挑快速側轉、交叉腿和抬膝的部分。兩段都用 736 一次跑完,各約 603 秒,評審單片各給 80 分。
做得好的部分:兩段抽看 25 個時間點,全程都是灰髮、紅花上衣、深褲白鞋的阿嬤,原舞者的粉紅洋裝和黑靴沒有殘留。抬手、側伸腿、蹲、抬膝這些大動作都跟得上。
還不行的部分有三個:
- 手指:手指偏長、張開時指節黏在一起,快速甩手時糊成一團。
- 抬腳的鞋:抬起來那隻腳的白鞋,有時縮成腿後面一條細長的白色碎片。
- 背景多了東西:原畫面左邊是一整面牆,成片多了深色門框和幾個開關。牆上哪來的門?對回去看,是 painted frame 自己畫上去的,Remake 照著保留下來。
另外阿嬤比較常抬臉微笑,原舞者低頭甩頭髮的那幾格沒有照做。
換場景:先換角再 edit 比較穩,雨天騎樓 82 分
白棚空場景看久了很單調,所以拿第一段實拍來換場景,試兩種做法:
- 兩段式:先 swap 換成阿嬤,再用 edit 模式把背景換掉,prompt 寫「人物、動作、服裝不變,只換背景與光線」。
- 一次 swap:從原舞者直接 swap,painted frame 一次畫好阿嬤和新場景。
場景兩個:雨天的老街騎樓、晚上的廟口夜市。四版都用短邊 480。
兩段式:左邊是已經換好的阿嬤,右邊用 edit 模式搬到雨天騎樓,評審 82 分。短邊 480、12.25 秒。舞蹈動作出自 YouTube 頻道 JD Dance Tutorial 的〈DAME HOMBRO Give Me a ShoulderDance Trend tutorial〉
一次 swap:左邊是原舞者,右邊直接換成阿嬤加廟口夜市,評審 79 分。注意背景的攤位和燈籠每幾秒就重排一次。舞蹈動作出自 YouTube 頻道 JD Dance Tutorial 的〈DAME HOMBRO Give Me a ShoulderDance Trend tutorial〉
這表看總分那欄:
| 做法 | 雨天騎樓 | 廟口夜市 |
|---|---|---|
| 兩段式(換角→edit) | 82 | 78 |
| 一次 swap | 65 | 79 |
夜市差 1 分,算平手。騎樓差很多:一次 swap 的騎樓視角在 12 秒裡跳了好幾次,柱子和店面左右對調,11 秒之後左邊還浮出一根半透明的柱子鬼影。
四版共同的毛病是背景每幾秒會重排一次。夜市的燈籠、攤位、地磚,騎樓的招牌和柱子紋理,都不是固定的。原因之一是兩張 painted frame 分開畫,兩張的廟宇角度和攤位位置本來就不一樣,Remake 只好在中間自己補。人物的部分倒是穩,動作分數四版都在 30 到 33(滿分 35)。
時間上,edit 和一次 swap 在 480 都是約 160 秒一支;兩段式要再加上先換角那一次,所以總時間比較長。
進階:完整數字、評審方法與失敗紀錄
不讀這節不影響使用。這裡收的是評分怎麼做、每一步的耗時與 VRAM、每支片的缺陷原文,以及這次測試沒涵蓋到的地方。
評審是誰、怎麼評的
評審是 Shio,一顆我放在家裡另一台機器上的本地視覺模型,專門拿來看畫面打分。它不聽聲音,也不知道片子是怎麼做的。
- 盲比(89 vs 74):4 個全新獨立請求,兩輪左右對調的成對比較,加兩支單片各 100 分。只給共同角色圖和 11 個同步時間點的抽幀(第 0、36、72、96、120、156、192、216、240、264、288 格),不給製作方法、模型名、檔名、耗時。pin 住的第 73、144 格不當評分樣本。送評前先存了答案表和影片的 SHA256,評完核對沒變。
- 實拍兩段(80/80):每段一個獨立請求,temperature 0,只給角色圖和這支片抽出來的畫面:平常每 18 格抽一張,第 48 到 80 格改成每 4 格抽一張。沒有給跟原片並排的對照。
- 換場景四版:每版 13 張結果抽幀加 5 張左輸入右結果的並排抽幀,四個分項是人物動作 /35、背景穩定 /25、交界殘影 /20、光線場景 /20。
評審自己也會錯,有幾處我沒採信:盲比的 Remake 單片評語提到 13、14 秒,片子只有 12.25 秒;實拍第二段的回答太長被截掉,背景那段只寫到一半,分數 35+24+21=80 是完整輸出的部分,沒有重評;它說第 293 格在抬腳,實際畫面是雙腳著地。
盲比的素材條件
盲比那組的來源不是真人實拍,是一段灰色人偶跳舞的影片,中間有 6 秒凍結、相機繞人一圈(bullet time),來源取第 288 到 581 格,832×480。兩邊吃同一段灰人來源。
- 阿嬤角色圖是這次新生的(Qwen-Image 2.1 int8 + 4 步 Turbo,768×1152,seed 904239,兩張候選挑正面比較對稱的那張),完全虛構,沒用真人肖像。
- 手工版:MiniMax-H3 Ref2VA int8 + Character Swap V1.5 LoRA + Turbo,8 步、CFG 1、er_sde/normal、shift 12/3、SAM 取最大物件並外擴 64 像素,固定 seed 904239,294 幀分兩段跑。
- Remake:swap int8、6 步 euler、官方 swap sigmas、短邊 480、294 幀。正面和背面的 painted frame 釘在第 73、144 格。Qwen 編輯時會把人物放大,所以我再把它等比縮回來源的高度、對齊水平中心和白棚背景。
兩邊用的是各自官方的用法:Remake 吃兩張 painted frame,手工版直接吃角色圖。
官方的鳳梨吉祥物範例在 5090 上先跑過一次確認環境沒問題:226 幀、832×480,執行 131.3 秒,整卡峰值 31,707 MiB,披薩師傅全程換成鳳梨頭吉祥物。
耗時與 VRAM 全表
秒數取 ComfyUI history 的 execution_start 到 success,含載入、編碼、取樣、輸出。VRAM 是每秒一次 nvidia-smi 的整卡用量,不是 PyTorch 實際配置的量,可能漏掉瞬間峰值。
盲比那組(短邊 480,294 幀):
| 階段 | 秒 | 峰值 MiB |
|---|---|---|
| 官方鳳梨範例 | 131.3 | 31,707 |
| 角色圖兩張 | 5.7 / 0.9 | 14,039 |
| painted frame 第 73 / 144 格 | 13.3 / 11.4 | 20,288 |
| SAM 遮罩 | 23.8 | 5,224 |
| 手工 H3 換角 | 211.9 | 27,443 |
| Remake 換角 | 156.4 | 30,556 |
手工版 SAM 加 H3 合計 235.6 秒;Remake 加上兩張 painted frame 和對齊約 181.3 秒。各只跑一回合,載入和快取條件不一樣,這組秒數只能參考,不能說誰一定比較快。
實拍兩段(短邊 736,294 幀):
| 工作 | 秒 | 峰值 MiB |
|---|---|---|
| 第一段 Remake | 603.0 | 31,749 |
| 第二段 Remake | 602.1 | 31,776 |
| painted frame(四張) | 11.3–14.2 | 19,723–20,971 |
換場景四版(短邊 480,294 幀):
| 工作 | 秒 | 峰值 MiB |
|---|---|---|
| edit 夜市 | 166.6 | 30,592 |
| edit 騎樓 | 156.5 | 30,593 |
| swap 夜市 | 161.6 | 30,587 |
| swap 騎樓 | 161.9 | 30,588 |
| painted frame(八張) | 15.4–15.5 | 19,694–20,398 |
三組合計 26 次 GPU 生成,失敗 0 次,沒有因為品質重跑。兩個 int8 檔各 20,970,379,616 bytes,下載加 SHA256 核對各約 5 到 6 分鐘,是一次性的成本。
實拍兩段的缺陷原文
第一段(第 0–293 格):長相一致 35、手腳 22、背景 23。
- 手指:第 18 格雙手手指偏長;第 108、126、162 格張開時指節黏在一起;第 72–80 格垂下的右手邊界糊掉;第 270–293 格頭頂交疊的手指黏在一起。
- 腳:第 252 格抬腳的鞋掌和腳踝邊界模糊。我放大看第 234 格,抬起的白鞋在支撐腿後面變成窄長的白色碎片,評審把這格判成大致合理,兩種看法都留著。
- 背景:評審說門框、開關、踢腳線都穩定,但那是單片內的穩定。跟來源並排才看得出,左邊整面牆變成深木門邊和幾個開關,對得上 painted frame 多畫的門和開關。
第二段(第 426–719 格,快速側轉、交叉腿、抬膝):長相一致 35、手腳 24、背景 21。
- 側轉時(第 60–68 格)鼻樑和下顎線變平滑,但沒有換臉。原舞者第 64 格側臉比較多,阿嬤比較朝鏡頭。
- 第 54 格右手糊成一團;第 72、90 格擺手時手指糊掉、拖影。
- 第 60 格彎起的腿,白鞋縮成腿後面一條細白線。
- 右邊的門有一部分是裁切追蹤本來就帶進來的,不能全算生成時突然變出來的;左邊第 180、234 格出現的門框和多出來的開關,對照來源才確認是改景。
兩段底部都有原片的窄黑邊,裁切超出原片時用邊緣複製延伸,沒有補畫,也沒事後裁掉。
換場景四版的缺陷原文
- edit 夜市(78):背景穩定只拿 11/25。11 秒和 12.2 秒廟宇立面、燈籠排列、攤位、地磚(變成六角磚)都跟前段不同;前 10 秒的燈籠和攤位也有小幅位移。
- edit 騎樓(82):3、5、10 秒的手出現穿模和手指融化;4 到 6 秒的鏡頭比前後拉得近、角度不同;腳下的濕地反射偏弱,人物打光偏平。
- swap 夜市(79):部分格的紅上衣從短袖變七分袖;背景攤位出現額外的人,違反 prompt 寫的 no additional foreground people;抬腳時的接觸陰影不明確。
- swap 騎樓(65):0–3、4–7、8–10、11–12 秒之間視角跳掉好幾次,柱子和店面左右鏡像;11 秒起左側出現半透明柱狀鬼影;光照方向和濕地反射前後矛盾。
兩種做法的 painted frame 是各自從對應輸入畫的,不是共用同一組圖,所以分差也包含關鍵幀畫得好不好。
這次測試的邊界
- 每種做法每個場景只跑一支、一個 seed(904239)。 夜市 78 比 79 不能說誰比較好;騎樓 82 比 65 也只代表這一段。
- 盲比和實拍的分數不能互相比。 89/74 是灰人來源加白棚,80/80 是真人實拍直式近拍,構圖、場景、抽樣都不同。實拍那組沒有同來源的手工版對照。
- 評分全是抽幀。 沒有逐格排除腳滑、手指黏在一起或背景閃動,也沒有動作捕捉的真值可以對。
- 換場景只測 480,沒測 736。
- 這次只換了一個角色、一支舞。
來源與相關
- 原舞蹈影片:YouTube 頻道 JD Dance Tutorial 的〈DAME HOMBRO Give Me a ShoulderDance Trend tutorial〉 https://www.youtube.com/watch?v=-BI2vTrxAqc
- 文中的阿嬤是用 Qwen-Image 2.1 生成的虛構角色,不是真人。
- 模型與官方文件:Viggle/Viggle-Remake
- 同系列 Part 12:真人舞蹈轉成深度影片,讓 H3 的古風角色在宮殿跳同一段舞
- 同系列 Part 16:Pika-H3-Flex 在 RTX 5090 實測
常見問題
- Viggle Remake 跟用 SAM 遮罩加 MiniMax-H3 手工換角比,差在哪?
- 同一段 12.25 秒的舞、同一個虛構阿嬤,本地視覺評審盲評 Remake 89 分、手工 74 分,左右互換兩次都選 Remake,我自己盲選也選 Remake。主要差在背景:手工版人物周圍會留一圈灰色補景,Remake 沒有。長相一致和腳的輪廓兩版分數接近。
- RTX 5090 跑得動 Viggle Remake 嗎?要用哪個權重?
- 跑得動。我用官方的 int8 合併檔 viggle_remake_swap_pruned_int8_convrot.safetensors(約 21 GB),已經把 swap LoRA 合進去,不用再掛 LoRA。294 幀、短邊 480 一支約 156 秒;短邊 736 一支約 603 秒,整卡 VRAM 峰值 31,776 MiB。
- Viggle Remake 的幀數和解析度怎麼設?
- 幀數要是 17n+5,範圍 90 到 345,例如 294 幀(17×17+5)是 24 fps 下 12.25 秒。short_edge 官方文件列的兩個標準設定是 480 和 736,節點本身接受 480 到 736、每次加 32 的值。影片要先轉成 24 fps,prompt 裡的時間點要對得上幀數。
- 換角後想換背景,要一次做完還是分兩段?
- 我這次測的結果,先換角、再用 edit 模式換場景比較穩:雨天騎樓 82 比 65,廟口夜市 78 比 79 算平手。一次 swap 的雨天騎樓視角跳了好幾次,11 秒之後還有半透明的柱子鬼影。兩種做法都有背景每幾秒重排的問題。
- Viggle Remake 換出來的影片還有哪些毛病?
- 手指會變長或黏在一起,抬起來的那隻腳鞋子會縮成細長的白色碎片。painted 關鍵幀如果多畫了門或開關,成片也會跟著多出來。換場景時背景每幾秒會重新排一次,招牌和柱子位置不固定。
接著讀
- 2026-10-19[AI Workflow] 真人舞蹈轉成深度影片,讓 MiniMax-H3 的古風角色在宮殿跳同一段舞:768 直接生成
看到有人用真人舞蹈帶 AI 角色跟著跳,我想試試 MiniMax-H3 能不能也做得出來,就用本機的一張 RTX 5090 跑了一次:Video Depth Anything 轉深度、Qwen-Image 把角色放進宮殿當第一格、Ref2VA 只給這一張場景圖,768×1376 直接生成再補幀到 48fps。含節點設定、首幀接法、背景跑回白棚的原因和換 seed 的坑。
- 2026-10-16[AI Workflow] 用 Blender 白模畫路線,MiniMax-H3 飛出 22 秒台灣 FPV 一鏡到底
先在 Blender 用方塊把無人機路線飛一遍,拆三段、段尾衝進霧,再交給 MiniMax-H3 Ref2VA 把方塊畫成玉山、太魯閣、101、日月潭。RTX 5090 上 1344×768 三段合計約 17 分 41 秒,霧裡接片後用 RTX VSR 放大到 2688×1536,成片 22 秒一鏡到底。含作法、每段耗時與還沒做到的地方。
- 2026-11-04[MiniMax-H3] Pika-H3-Flex 在 RTX 5090 實測:快一倍,加 Blender 灰模後 180° 環繞 6 發全中
Pika 出的 MiniMax-H3 官方 LoRA Pika-H3-Flex 6 步生成影片,另有 4 步的 Turbo 版。我在 RTX 5090 用 ComfyUI 實測:5 秒片原版 H3 38 秒、Flex 20.8 秒、Turbo 16.3 秒;只靠文字寫 180° 環繞不穩,餵 Blender 灰模當參考影片後 6/6 繞到對面,Turbo 一支 34 秒。
- 2026-10-30[MiniMax-H3] 開源 2K 重繪在 RTX 5090 實測:細節比 VSR 多,一支 5 秒片 133 秒
NVIDIA 研究團隊放出的 Open-H3-Regenerate-2K 能把 MiniMax-H3 草稿重畫成 2K。我在 RTX 5090 上用 ComfyUI 實測:睫毛、耳環、刺繡都重新畫出來,一支 5 秒片重繪 133 秒,VSR 只要 19 秒;代價是臉被改、中小招牌字變假字。附 workflow。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。