AI Workflow · part 26
[Dev Workflow] 一張 2080 Ti 撐起每天所有新聞短片的配音:VoxCPM2 GGUF Q4,一句兩秒
❯ cat --toc
- 前言
- 準備三樣東西:一張 2080 Ti、兩個 GGUF 檔、一段自己的錄音
- 編 llama.cpp-omni:Linux 上先補一行 F_NOCACHE
- 一行指令念出你的聲音:prompt-wav 和 reference 給同一段錄音
- 每次呼叫要載入 3.4 秒,所以包成常駐服務
- 念錯專名:先重抽,還錯才用拼音或 CMU 大括號標
- 用 whisper 當關卡:先把專名餵給它,中文比拼音
- 語氣停在「夠用」,等下一顆模型
- 進階
- 五個 TTS 盲聽:錯誤率最低的不是最好聽的
- 速度:快的是引擎,不是位寬
- Q4_K_M 怎麼做出來的、品質差多少
- 語氣控制:括號指令被整句念出來
- whisper 為什麼冤枉人:40 句黃金樣本
- 走錯的路:數字展開、音譯、堆規則檔
- 還沒解的
TL;DR
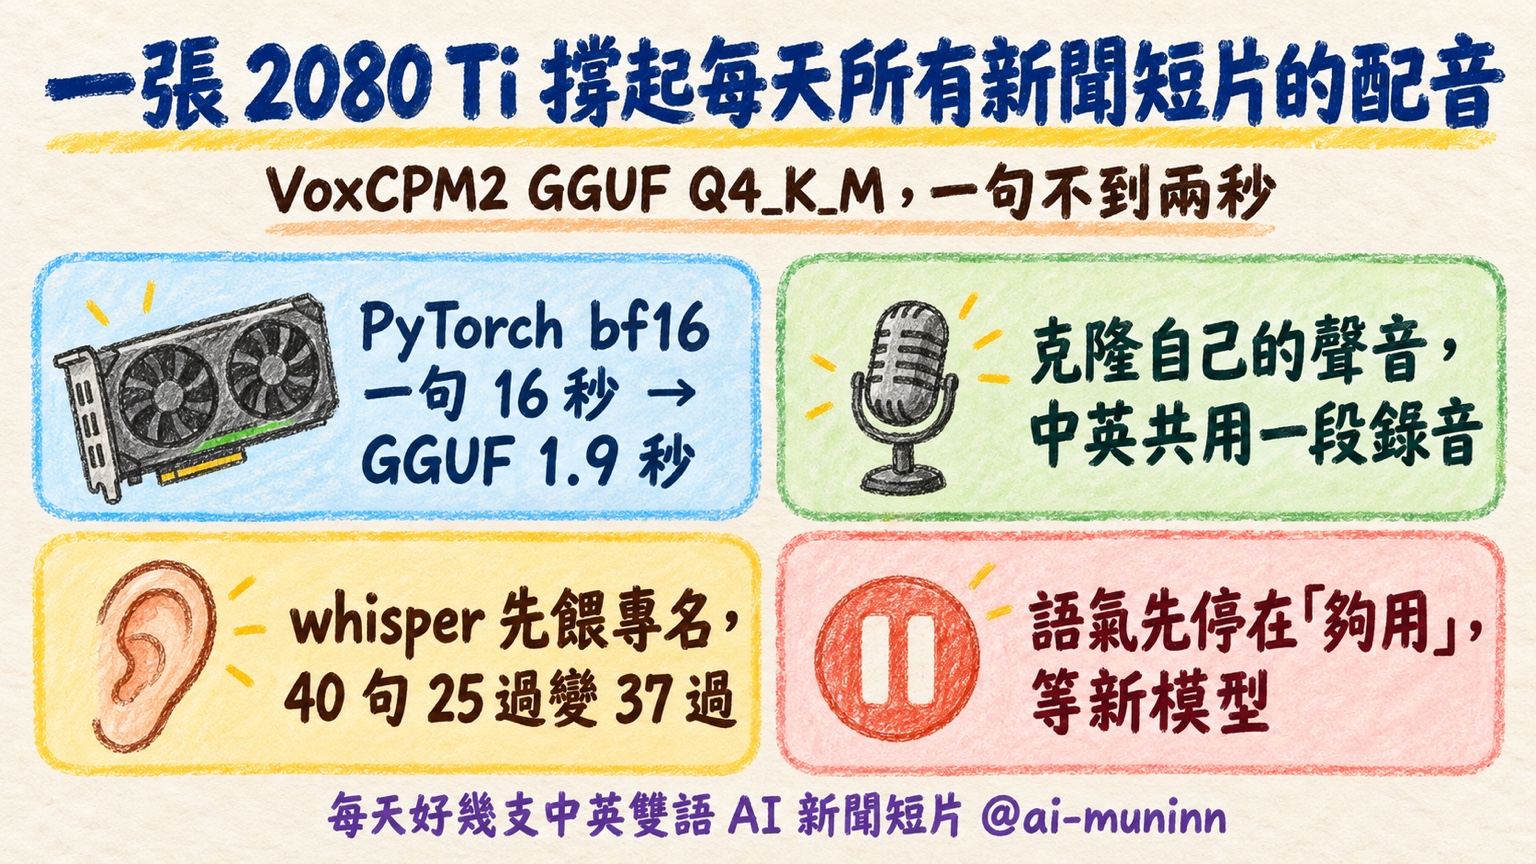
每天好幾支中英雙語新聞短片的配音,現在全靠一張 RTX 2080 Ti:VoxCPM2 複製我自己的聲音,BaseLM 量化成 GGUF Q4_K_M、Acoustic 留 F16,用 llama.cpp-omni 跑,一句不到兩秒,常駐只占 5,248 MiB。同一張卡跑 PyTorch bf16 一句要 16 秒,快的是引擎不是位寬。配音關卡曾一晚擋掉 8 支裡的 4 支,4 支都是 whisper 聽不懂專名;把專名塞進 initial_prompt 後,40 句從 25 句過變 37 句過。語氣還不完美,我試過的開源 TTS 都卡在這裡。
前言
一句話念出來只要兩秒,為什麼一支短片的配音要等 38 分鐘?
我每天會全自動產出好幾支 AI 新聞短片,每兩到四小時跑一輪,一輪一個題目,中文版和英文版各做一支,放在 YouTube 頻道 @ai-muninn。整條線從選題、寫稿到上傳都是機器在跑,配音是唯一每一句都要過的環節,一支片八、九句,一句卡住整支就停。
所以我對配音的要求很具體:免費、本地跑、念的是我自己的聲音、中英文都行,還要塞得進一張 RTX 2080 Ti。
到 10-18 那晚,狀況都還離這個很遠。GPU 被別的工作占著時只能退回 CPU,中文那支在 CPU 上配了 38 分鐘,同一時間英文那支在 MacBook 上跟另一支重配搶資源,配了 51 分鐘。另一個坑更煩:配音後面有一關 whisper 聽寫比對,有一晚 8 支片裡 4 支死在這一關,我一句一句聽,4 支都念得好好的。
現在的架構很簡單:一張 2080 Ti 跑 4-bit 的 VoxCPM2,一句兩秒,念的是我的聲音。之前以為是模型念不好,結果大半是 whisper 聽不懂專名。
成品就在頻道上,想聽這個聲音念起新聞來怎樣,隨便點幾支來聽就知道:
https://www.youtube.com/@ai-muninn
這篇前半是照著做就能跑起來的教學,後半是評比、速度表跟我走錯的路。
準備三樣東西:一張 2080 Ti、兩個 GGUF 檔、一段自己的錄音
顯卡:我的是一張 RTX 2080 Ti 22GB 改裝卡。常駐服務掛著 Q4_K_M 的時候占 5,248 MiB,剩下的空間還能讓別的工作一起用。要注意的是 2080 Ti 是 Turing 架構,硬體不支援 bf16,PyTorch 預設的 bf16 在這張卡上是模擬的,這就是為什麼這篇不走 PyTorch。
資源用量:要判斷自己的卡放不放得下,看這張。常駐那一列是服務掛著、穩定時的用量;其他列是速度量測時的峰值。
| 跑法 | 記憶體 |
|---|---|
| GGUF Q4_K_M,常駐穩定時 | 5,248 MiB |
| GGUF Q8_0,量測峰值 | 8,352 MiB |
| PyTorch fp16,量測峰值 | 7,484 MiB |
| PyTorch bf16,量測峰值 | 7,434 MiB |
| MLX int8(MacBook),量測峰值 | 7,593 MiB |
同一次量測裡,Q4_K_M 的峰值比 Q8_0 少 620 MiB。
模型:VoxCPM2 拆成兩顆,一顆 BaseLM、一顆 Acoustic,GGUF 版要兩個檔一起用。
| 檔案 | 大小 | 去哪拿 |
|---|---|---|
VoxCPM2-BaseLM-Q4_K_M.gguf | 1.00 GB | https://huggingface.co/coolthor/VoxCPM2-Q4_K_M-GGUF |
VoxCPM2-Acoustic-F16.gguf | 1.83 GB | https://huggingface.co/DennisHuang648/VoxCPM2-GGUF |
Q4_K_M 那份是我自己量化上傳的。第二個 repo 裡也有 VoxCPM2-BaseLM-Q8_0.gguf(1.73 GB),想要多一點餘裕可以拿那份,我兩個都聽過,後半會講差多少。
參考錄音:一段 20 到 30 秒的乾淨錄音,加上一字不差的逐字稿。我用的那份是 23.9 秒、24 kHz 單聲道。怎麼錄,第 21 篇講過,同一份錄音直接沿用。
為什麼是 VoxCPM2?我把五個公開權重的 TTS 放在同一張 2080 Ti 上盲聽,耳朵選中它,授權是 Apache-2.0,英文也能用同一段中文錄音複製。比較細節放在後半。
編 llama.cpp-omni:Linux 上先補一行 F_NOCACHE
VoxCPM2 的 GGUF 推論引擎在 tc-mb/llama.cpp-omni,裡面有一支 voxcpm2-cli。我用的是 commit 88bd37e。
git clone https://github.com/tc-mb/llama.cpp-omni
cd llama.cpp-omni
git checkout 88bd37e
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=75
cmake --build build -j
CMAKE_CUDA_ARCHITECTURES=75 就是 Turing。在 Linux 上第一次編會卡在 src/llama-moe-slot.cpp,那裡有兩處用到 macOS 才有的 F_NOCACHE,兩處都用 #ifdef F_NOCACHE … #endif 包起來再編一次就過。
Mac 不用改,-DGGML_METAL=ON 一次就編起來。只是 MacBook 上的 GGUF Q8 一句要 11 秒左右,比 2080 Ti 慢很多。
一行指令念出你的聲音:prompt-wav 和 reference 給同一段錄音
編好之後先用 CLI 念一句,確認模型檔、錄音、顯卡三樣接得起來,再談常駐服務。整個流程就是:把你的錄音和逐字稿交給它,它用你的聲音念出一段新文字。
CUDA_VISIBLE_DEVICES=0 ./build/bin/voxcpm2-cli \
  -t "今天要講的是一張舊顯卡怎麼撐起每天的配音。" \
  --prompt-wav my_ref.wav \
  --prompt-text "$(cat my_ref.txt)" \
  -r my_ref.wav \
  --seed 42 \
  -o out.wav \
  VoxCPM2-BaseLM-Q4_K_M.gguf VoxCPM2-Acoustic-F16.gguf
--prompt-wav、--prompt-text、-r 三個一起給,就是官方說的 Ultimate Cloning:同一段錄音同時當提示和參考音色,再附上逐字稿。我的配音全程都用這個模式。只給 -r 是另一種 clone 模式,後半講語氣那節會看到兩種模式差在哪。
CUDA_VISIBLE_DEVICES 指定你要用哪張卡。機器上不只一張卡的話每次都要帶,沒帶的話程式會直接跑到第一張卡上。
--seed 換一個數字就是重抽一次。要自己寫迴圈重抽的話別用 0:這個 runtime 看到 0 不會重設亂數種子,在常駐服務裡等於接著上一次的狀態往下滾,你分不出這次到底換了沒有。
每次呼叫要載入 3.4 秒,所以包成常駐服務
voxcpm2-cli 是一次性的,每呼叫一次就重新載入模型,光載入就要 3.4 秒左右,比念一句還久。一支片八、九句,每個題目又分中文版和英文版,一天跑好幾輪,這個時間是白燒的。
所以值得寫一個很小的常駐服務:模型載入一次就一直掛著,外面包一層 HTTP,只聽本機 127.0.0.1。兩個端點就夠:
GET /health:回傳模型有沒有載好,還有實際載入的是哪個檔。要確認現在跑的是 Q4 還是 Q8,看這裡回的檔名。POST /synthesize:文字送進去,WAV 拿回來。
Q4_K_M 常駐掛著占 5,248 MiB。
有一個坑讀者很可能會踩到:卡跟別的工作共用時,服務啟動那一刻要等對方的工作做完再載入,不然會把對方擠到 OOM。服務載好之後,兩邊可以一起跑。
念錯專名:先重抽,還錯才用拼音或 CMU 大括號標
英文專名照英文原字送進去。 我曾經把 Beam、Hugging Face、token 先轉成「比姆」「哈金費斯」「偷肯」再送,結果 whisper 聽得出來是那幾個中文字,關卡過了,我自己一聽,蛤?整句怪到不行。
順序是:照原字念 → 重抽 → 都不行才標讀音。 不要一開始就把專名跟數字預先寫好讀音。數字也一樣,12B、1M、V4.1-Flash-1017 直接送,VoxCPM2 自己念得出來。
真的要標的時候,用 VoxCPM2 官方的讀音標記,用大括號把那幾個字換掉:
中文帶調拼音:我們今天在沙箱裡{xun4}{lian4}模型。
英文 CMU 音標:採 {AH0 P AE1 CH IY0} 二點零授權。
標記是取代原字,不是加在旁邊,模型不會念兩次。NVIDIA 是我這邊最常出事的字,句首的 N 常常不見,改標 {EH1 N V IY1 D IY0 AH0} 再試。
幾個試過沒用的招,省你時間:
- 語言標籤
[en]、<en>:VoxCPM2 沒有這個機制,<en>會直接刪掉,[en]會當成雜音念出來。 - 多打幾個空格想讓它停頓:程式會把連續空白壓成一格。
- 括號裡寫「(slightly faster)」:管的是語速或情緒,管不到單一個字怎麼念。
GGUF 這條路有一個要注意的:我的常駐服務一開始對大括號的切法跟 PyTorch 版不一樣,修過之後標記才真的送得進模型。你自己接的話,先拿一句帶標記的試聽一次。
我現在的產線把這套做成自動的「兩次規則」:第一次照原字念,whisper 聽寫回來,只有聽起來不一樣的那幾個字自動換成拼音或 CMU,重念那一句;第二次念完直接採用,不再檢查。例如「而開頭的較快成績,只是短生成測試。」第一次 whisper 聽到的是「較快層級」「短深層測試」,第二次送進去的是 而開頭的較快{cheng2 ji4},只是短{sheng1 cheng2}測試。
用 whisper 當關卡:先把專名餵給它,中文比拼音
第 22 篇那把 whisper 尺我一直在用,但拿來當全自動產線的關卡之後,它開始冤枉人。mlx-whisper large-v3-turbo 會把 NVIDIA 寫成 NVDA,Nemotron 寫成 Memotron,Bolt 寫成 BOT。TTS 明明念對了,關卡判它漏字。
解法是把這一句裡的英文專名和數字塞進 initial_prompt,門檻跟比對邏輯都不動:
import mlx_whisper

result = mlx_whisper.transcribe(
    "line_07.wav",
    path_or_hf_repo="mlx-community/whisper-large-v3-turbo",
    language="zh",
    initial_prompt="NVIDIA Nemotron Hugging Face",  # 只放這一句的專名和數字
)
只放專名就好。我試過「中文前言 + 專名」一起塞,whisper 在每個停頓都幻聽出一個全形的「7」。
比對方式也要換。中文直接比字,同音字會被算錯:「部署」聽成「不屬」、「沙箱」聽成「沙香」,其實念得沒問題。我改成先轉無聲調拼音再算錯誤率,門檻 0.15;英文用 WER,門檻 0.2。舊門檻是字元 CER 0.1,我拿參考錄音本身去比它自己的逐字稿,就有 0.128,連我的原聲都過不了。
整句分數放寬之後,真的念錯靠另一關抓:易錯詞(訓練、詞、沙箱、部署)、稿子裡的關鍵詞和英文專名逐一比對。「我們今天在沙箱裡訓練模型」念了三次,whisper 聽到的是「混練」「婚戀」「混練」,整句拼音錯誤率 0.083 在門檻內,但「訓練」不見了,三次全部擋下。
最後一個決定:關卡只警告,不擋片。 那一晚 8 支死 4 支、4 支全是 whisper 的問題之後,我把產線切成 trust 模式。數字、專名、錯誤率對不上都只寫進一份待聽清單,只有音檔根本沒生出來才擋。片子照樣往下走,我有空再翻清單聽。
語氣停在「夠用」,等下一顆模型
這套跑到現在,念錯字的問題大部分壓下來了,剩下的是語氣。VoxCPM2 念出來的情緒,基本上就是參考錄音裡的那個情緒,正式用的 clone 模式沒有參數可以調。
我的判斷是:配音這樣就夠了。不完美,但要 AI 把語氣念對本來就難,我試過的幾個都還卡在這裡。所以我不再為語氣開票修,等有新模型出來再換。
進階
不讀這節不影響使用。下面是選模型的評比、各種跑法的速度、跟我走錯的幾條路,給想繼續挖或要把整篇丟給 AI 參考的人。
五個 TTS 盲聽:錯誤率最低的不是最好聽的
2026-09-28 我把五個公開權重的 TTS 放在同一張 2080 Ti 上,用同一段 23.9 秒的參考錄音念同一份 16 句中文稿。錯誤率用 whisper large-v3-turbo 逐句算,seed 固定;盲聽的五個檔都對齊到 -16 LUFS,打散成 A 到 E。
| 引擎 | 平均 CER | 最高 CER | 16 句合成秒數 | VRAM 峰值 | 授權 |
|---|---|---|---|---|---|
| IndexTTS-2.5 | 0.035 | 0.125 | 83.2 | 8,662 MiB | bilibili 自訂授權,月活破 1 億或年營收破 10 億人民幣要另簽 |
| Qwen3-TTS 1.7B Base 8bit | 0.044 | 0.125 | 沿用舊檔 | — | Apache-2.0 |
| VoxCPM2 | 0.067 | 0.250 | 61.7 | 7,428 MiB | Apache-2.0 |
| Fun-CosyVoice3-0.5B | 0.127 | 0.588 | 75.4 | 6,582 MiB | Apache-2.0 |
| Breeze-TTS-2 | 0.127 | 0.278 | 159.5 | 8,608 MiB | 權重限研究、非商用 |
錯誤率排第一的是 IndexTTS-2.5,但它官方的推論介面沒有逐字稿參數,只能用純參考音模式跑,跟其他四個不是同一個比法。盲聽我選了 VoxCPM2,Breeze 第二,但 Breeze 的權重不能商用。
Qwen3-TTS 就是第 21 篇用的那個,錯誤率比 VoxCPM2 低,我還是換掉了,因為它的中文在斷句之後聲音會變怪。我做過能量分析,句尾沒有多出雜音,問題在音色跟語調,只有耳朵判得出來。
英文是 10-06 才換成同一個 VoxCPM2 clone,取代原本 Qwen3 的預設英文聲音 ryan,理由是用自己的聲音念比較有辨識度。跨語言 clone 在 09-28 試過,8 句裡有 2 句要重抽。
速度:快的是引擎,不是位寬
下面每張表是一套量測,數字不要跨表比。
第一套(10-18):同一組 3 句中文 + 2 句英文,同一段參考錄音,每句冷啟動,扣掉載入時間。
| 版本 | 跑在哪 | 中文每句(秒) | 英文每句(秒) | 記憶體峰值 |
|---|---|---|---|---|
| PyTorch bf16 | CPU(7 執行緒) | 197–315,平均 238 | — | — |
| PyTorch bf16 | 2080 Ti | 平均 16.2(12.4–20.1) | 16.7–21.0 | 7,434 MiB |
| PyTorch fp16 | 2080 Ti | 12.5 | 12.2 | 7,484 MiB |
| GGUF Q8_0 | 2080 Ti | 1.90 | 2.19 | 8,352 MiB |
| MLX int8 | MacBook | 14.7 | 28.5(含一次 45 秒) | 7,593 MiB |
同一張卡,bf16 換 fp16 只快 1.29 倍(中文);換成 llama.cpp-omni 跑 GGUF Q8 快 8.5 倍。光看位寬,Q8 解釋不了這麼大的差距;快主要是 llama.cpp 的 CUDA kernel。
量化省的也不是 VRAM。Q8 的權重檔加起來 3.56 GB,但加上引擎的運算緩衝,峰值反而到 8,352 MiB,比 bf16 的 7,434 MiB 還高。
還有一條路走不通:FP8 W8A8 版要 Ada 以後的卡,2080 Ti 跑不了。
第二套(10-18):Q4_K_M 對 Q8_0,同一次配對。
| Q4_K_M | Q8_0 | |
|---|---|---|
| 中文每句 | 1.76 秒 | 1.96 秒 |
| 英文每句 | 2.04 秒 | 2.40 秒 |
| BaseLM 檔案 | 1.00 GB | 1.73 GB |
第三套(10-18):6 句真實稿子。 Q4 平均 1.38 秒、Q8 1.54 秒,快 11%;VRAM 峰值少 620 MiB。
第四套(10-02):連續 20 句、單一 worker。 CPU 開 4 個 worker 各 7 執行緒,中位數 186.1 秒一句;MacBook MPS fp32 中位數 5.56 秒;2080 Ti PyTorch bf16 中位數 6.88 秒,錯誤率 0.1008,20 句有 7 句超過 0.1。那時候的結論是 2080 Ti 比閒著的 MacBook 還慢,判它不能用;同一張卡換成 GGUF 之後才翻過來。
第四套的 6.88 秒跟第一套的 16.2 秒都是「2080 Ti 跑 PyTorch bf16」,測的條件不同(連續 20 句對上冷啟動短句),我不把它們混成一個數字。
另外,MacBook Metal 跑 GGUF Q8 平均 11.0 秒一句。
Q4_K_M 怎麼做出來的、品質差多少
我只量化 BaseLM,Acoustic 留 F16。先轉 f32 的 GGUF,再用 llama.cpp 的量化工具壓成 Q4_K_M:
python tools/omni/voxcpm2/convert_voxcpm2_to_gguf.py --dtype f32 \
    --model model.safetensors --vae audiovae.pth --config config.json --output ./out
./build/bin/llama-quantize VoxCPM2-BaseLM-F32.gguf VoxCPM2-BaseLM-Q4_K_M.gguf Q4_K_M
llama-quantize 認得這個架構,沒報錯,6,188 MiB(32 BPW)壓到 953 MiB(4.93 BPW),11.3 秒做完。
品質用錯誤率看:中文平均 0.101 對 Q8 的 0.083,英文 0.090 對 0.095,錯誤率高的句子都卡在品牌名,whisper 把 Vera Rubin 聽成 Verobeam、NVIDIA 聽成 Venback。Q4 有一次把「Apache 2.0」念成「5.0」。最後是我自己聽六句試聽,判 Q4 過關,正式換成 Q4。
換 Q4 之前,10-18 那天我先把五個版本打散盲聽,只有一個片段不行:中文第一句的 GGUF Q8,錯誤率 0.163,其他 Q8 句子在 0.075 到 0.076。那句在產線上會被重抽掉,Q8 一次只要兩秒,重抽幾乎不花錢。
語氣控制:括號指令被整句念出來
10-04 我做過一輪語氣 A/B:6 句 × 4 種語氣(不加、輕鬆、沉穩、興奮)× 2 種 clone 模式,共 48 段,在 CPU 上跑了 78.3 分鐘。
正式用的 Ultimate Cloning 模式,在句子前面加括號語氣指令:18 段裡 18 段都把英文指令念出來,whisper 聽寫出「Calm, Steady and Reassuring Tone…」。有一段還把參考錄音的逐字稿也念了出來,錯誤率 1.35。
只給參考錄音的模式不會念出指令。量音高變化(F0 標準差):不加 28.2 Hz、輕鬆 33.8、沉穩 41.4、興奮 43.5。「沉穩」比「不加」起伏還大,加了指令聲音確實有變,但變的方向跟字面對不上。語速四種都在每秒 5.0 到 5.4 字。我盲聽的結論是情緒幾乎聽不出來,部分還變成機器人聲。
真要語氣,得換引擎,我當時列的備選是 IndexTTS-2.5(給情緒參考音加強度)跟 Step-Audio-EditX(生成後再編輯),都還沒做。
whisper 為什麼冤枉人:40 句黃金樣本
要改關卡又怕改壞,我先建了一份標好答案的樣本:真實稿子跟 whisper 聽寫的配對,含故意念錯的反例。用它量 initial_prompt 帶專名前後的差別:
| 樣本 | 不帶 prompt | 帶專名 prompt |
|---|---|---|
| 黃金樣本 40 句,通過 | 25 | 37 |
| 黃金樣本,判漏字 | 16 | 1 |
| 全部真實音檔 85 句,通過 | 39 | 57 |
| 全部真實音檔,判漏字 | 44 | 16 |
| 真的念錯卻放過 | 0 | 0 |
最後一列是重點:門檻放寬之後,真的念錯還是沒被放行,「Apache 2.0 念成 5.0」、14 個數字念錯的反例都還是擋得住。
我也試過把 whisper 換成 Qwen3-ASR-1.7B 加 hotword。帶 hotword 36/40、3 句判漏字,跟 whisper 加 prompt 的 37/40 很接近,但它把 3 句 whisper 原本對的弄錯(例如「23.8」念成「二至三點八」),還把一句真的念錯(「順練」)正規化成「訓練」放過去。所以留 whisper。
有些東西不是 ASR 的問題。稿子寫「開發者 DogukanUrker」,三次聽寫出來都是 Dogukhan Urker,沒有任何 ASR 會聽出一個黏在一起的帳號,那要改稿,不是改關卡。字母縮寫像 MoE 也一樣,whisper 聽成 Moei、M01,判不了。
走錯的路:數字展開、音譯、堆規則檔
數字展開成中文。 我一開始把 12B 先寫成「一百二十億」再送去念,結果 whisper 聽寫成 120E,關卡把它當成數字對不上,擋掉一句念對的。後來又有一句「上下文支援到 1M token」念成「一 M」,whisper 寫成「EM token」,數字不見了,也被擋。規則改成:ASR 聽到不同的數值或單位才算錯,數字消失只標記不擋。最後乾脆不展開,照原字念。
英文音譯成中文字。 Beam 那支片的第二句,用音譯後的字去比,錯誤率 0.094,過關;拿原稿去比是 0.673。兩邊都是同一套音譯,關卡當然看不出問題,耳朵一聽就知道。音譯現在全面禁用,只留我親耳確認過的三個台灣念法:知識、步驟、LINE(念「賴」)。
一條條堆發音規則。 之前配音常錯,一部分原因是發音修正一條一條堆成規則檔,模型照樣念錯。「步驟」的驟在台灣念 zòu,我 10-13 就加了修正,到 10-19 還是念錯。
拼音標記也不是萬靈丹。Beam 那支中文重配時,第 4 句「詞只」標了拼音,重抽到第 10 次,錯誤率在 0.206 到 0.647 之間,最好那次 whisper 還是聽成「持指」;第 5 句「部署」的拼音每次都對了,整句還是過不了。
還沒解的
- 「步驟」的台灣念法、句首 NVIDIA 的 N,目前都還會錯。
- trust 模式下,數字對不上只警告。Q4 念錯「Apache 2.0」那種錯,現在會直接放過,等我翻待聽清單才看得到。
- 「兩次規則」第二次有沒有比較好,目前只有單句測試,還沒有累積數字。
- 下一顆候選是 bosonai/higgs-tts-3-4b,4B,唯一沒進 09-28 那輪評比的中文候選,還沒測。
同系列:你的聲音,24 秒就能複製:MacBook 上的 Qwen3-TTS 教學 · 40 行讓 whisper 當裁判:AI 生出來的配音,咬字到底有沒有壞
常見問題
- RTX 2080 Ti 跑得動 VoxCPM2 嗎?多快?
- 跑得動,但別用 PyTorch。2080 Ti 是 Turing 架構,沒有 bf16 硬體,PyTorch bf16 一句中文平均要 16 秒。換成 llama.cpp-omni 跑 GGUF,Q8_0 一句 1.9 秒、Q4_K_M 一句 1.4 到 1.8 秒(看測法)。常駐服務掛著 Q4_K_M 只占 5,248 MiB。
- 為什麼選 Q4_K_M 不選 Q8_0?
- 我自己試聽了六句,Q4 的品質過關。BaseLM 檔案從 1.73 GB 降到 1.00 GB,VRAM 峰值少 620 MiB,速度還快一成左右。Acoustic 那個檔留 F16 沒動。
- VoxCPM2 念錯專有名詞怎麼辦?
- 先照原字送、重抽一次。還是錯,再把念錯的那幾個字換成官方的讀音標記:中文寫帶調拼音像 {xun4}{lian4},英文寫 CMU 音標像 {AH0 P AE1 CH IY0}。英文專名不要音譯成中文字,whisper 會放過,耳朵聽起來很怪。
- whisper 當配音關卡老是誤擋,怎麼辦?
- 大部分是 whisper 拼不出專名,不是 TTS 念錯。把那一句裡的英文專名和數字塞進 initial_prompt,40 句已標註的句子從 25 句通過變成 37 句通過,真的念錯的一句都沒放過。中文改比無聲調拼音,同音字算對。
- VoxCPM2 能用括號指令控制語氣嗎?
- 在用參考錄音加逐字稿的 clone 模式下不行。我試了 18 段帶括號語氣指令的,18 段都把指令整句念出來。只給參考錄音的模式不會念出來,但情緒幾乎聽不出差別,部分還變得像機器人。
接著讀
- 2026-09-11[Dev Workflow] 你的聲音,24 秒就能複製:MacBook 上的 Qwen3-TTS 教學
預設 TTS 的聲音不是你的聲音。24 秒錄音加十行 Python 就能 zero-shot clone,MacBook 本機跑得動,不用 GPU 機也不用訓練。
- 2026-10-12[Dev Workflow] 用免費的 REA + Ghidra 逆向自家 iOS App:從答「不知道」到還原出公式
只給 AI 編好的 iOS 執行檔和免費的 REA + Ghidra,問三題。前兩輪 Ghidra 起不來,AI 誠實答不知道;調好設定後 16 分鐘答完,最大虧損公式跟原始碼一致。附安裝、設定與盲測做法。
- 2026-10-07拿知識庫的資料實測 EmbeddingGemma 2:筆記搜尋 recall@5 從 50% 到 58.3%
Google 放出 EmbeddingGemma 2,文字、圖片、聲音進同一個 768 維空間。我拿知識庫 813 篇筆記和 424 個程式檔,在 M1 Max 上跟第一代同設定比:筆記搜尋 recall@5 50%→58.3%,程式碼第一名 1/10→4/10,記憶體 1.03→2.75 GiB。
- 2026-10-04[Claude Code] 六段 prompt 做出自己的資源儀表板:Claude Code mods 實作
Claude Code 2.1.287 起支援 mods,能在終端機裡畫面板、加按鈕、給 Claude 新工具。這篇給六段實測過的 prompt,一步步讓 Claude 幫你做出顯示 GPU、硬碟、Claude 額度、本地模型的儀表板。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。