AI Workflow · part 30
[AI Workflow] 讓家裡的 AI 每天自己做新聞短片:本地模型當導演,80.6 分鐘壓到 5–10 分鐘
❯ cat --toc
TL;DR
家裡兩台 DGX Spark 跑 DeepSeek V4.1 Flash(下稱 DS4.1),一天四輪自己選新聞、寫稿,交給另外兩顆模型查核,用我的聲音配音,做成動畫短片,中英兩版上 YouTube。只看畫面的盲評,火柴人和剪貼畫 84 分,舊的字幕新聞 61–68。DS4.1 當火柴人導演 89.3 分,Sonnet 84.0。改 harness、一次只消一類重複動作,白板導演從 80.6 分鐘壓到 5–10 分鐘。做了約 240 支之後發現產量拉高不會多人看,所以降到一天最多 4 則(中英共 8 支)。
前言
寫文章寫久了,總覺得差點意思。光靠文字跟截圖,有些東西就是講不清楚,所以我一直想做做看動畫。
動畫真的做完一支之後,下一個念頭很自然:能不能讓 AI 自己來做?挑新聞、寫稿、用我的聲音配音、出畫面,全部交給家裡的機器。
一開始的流程卡在三個地方。第一,每支片都要我看過才能上。第二,本地模型當導演,一支片要 80 分鐘,一天排不了幾支。第三,做得出來的字幕新聞畫面只在及格邊緣。
現在家裡兩台 AI 電腦每天自己挑新聞、寫稿、用我的聲音配音、做成動畫短片上 YouTube 頻道「AI-Muninn」。我不用逐支看過才放行。
這篇前半講產線長什麼樣、版型和導演怎麼選、80 分鐘怎麼壓到 10 分鐘以內,還有做了 240 支之後為什麼決定降量。後半是踩過的坑,不讀不影響理解前半。
一天跑四輪:選題到上傳全自動,審稿和寫稿用不同的模型
產線一天跑四輪,時間是 09:36、13:36、17:36、21:36。每一輪做的事一樣:
選題(RSS / 官方部落格 / X / Hacker News)
 → 找資料
 → 寫稿(DS4.1)
 → 事實查核(MiniCPM-V 4.7 + Qwen3.8-Flash-Next)
 → 外行人讀得懂檢查
 → 翻成英文
 → 用我的聲音配音(VoxCPM2)
 → 依版型導演出畫面
 → 上傳 YouTube,中文、英文各一支
寫稿的是 DS4.1,跑在兩台 DGX Spark 上。DGX Spark 是 NVIDIA 出的桌上型 AI 電腦,我這兩台各有 128GB 記憶體;DS4.1 太大,一台裝不下,所以把模型拆成兩半、兩台各跑一半(安裝過程寫在兩台 DGX Spark 跑 DeepSeek V4.1 Flash)。配音用 VoxCPM2 加我的聲音,細節在一張 2080 Ti 撐起每天所有新聞短片的配音。
事實查核刻意交給另外兩顆模型:MiniCPM-V 4.7 和 Qwen3.8-Flash-Next。原因很直接:作者不能審自己。我在導演那一步試過讓 DS4.1 審自己做的片,它看到省略號開頭,自己說「可接受」就放過去了。換成另一顆模型審,實際跑一輪就抓到開場和結尾吐槽張冠李戴。同一顆模型寫的東西,它審的時候會覺得每一句都很合理。
全自動之後,最怕的是「出錯的片自己上架」。我的做法是硬關卡只留兩道:事實錯、成人內容,碰到就整支不做。其他問題(畫面、字幕、念法)一律自動修,修完附一行警告,不擋片。關卡越多,產線越容易整天交不出東西。
五種版型輪流用,只看畫面的盲評:動畫版 84 分,字幕新聞 61–68
每支片隨機抽一種版型,不會連續兩支同款:字幕新聞、火柴人動態、剪貼畫、白板,11-09 再加分層扁平動畫。
要知道哪種版型做得好,我不想每支自己看,所以讓 Qwen3.8-Flash-Next 當評審,只看畫面、不知道是誰做的,四項加總 75 分,換算成 100 分。同一支片請它重評一次,分數會差 4–6 分,所以我定了一條規則:差距小於 10 分,不算誰比較好。
這張表看最右欄:動畫類版型都在 80 分以上,字幕新聞落在 61–68。
| 版型 | 只看畫面的分數(100 分制) |
|---|---|
| 字幕新聞 | 61–68 |
| 火柴人動態 | 84 |
| 剪貼畫 | 84 |
| 白板 | 舊版 74.7 / 新版 81.3(成對比較平手,沒換) |
| 分層扁平動畫(試作) | 84.0 |
所以 11-09 起字幕新聞不再參加輪替,只當失敗時的退路。
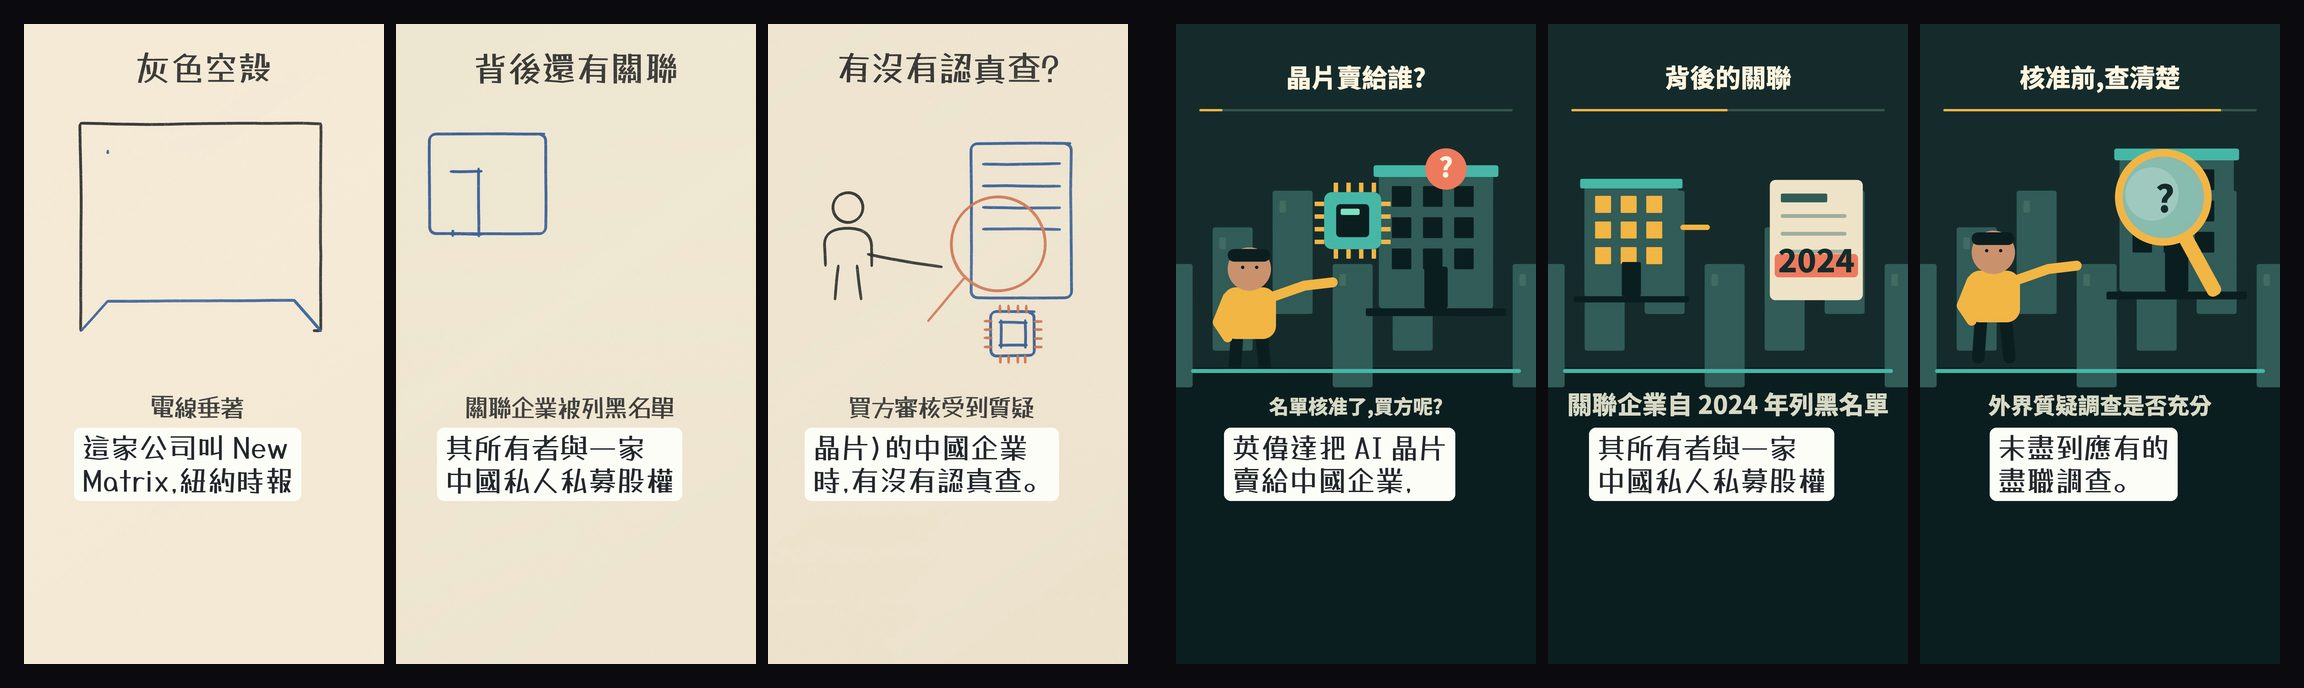
火柴人、剪貼畫、字幕新聞都有已經公開的片,可以直接看成品:
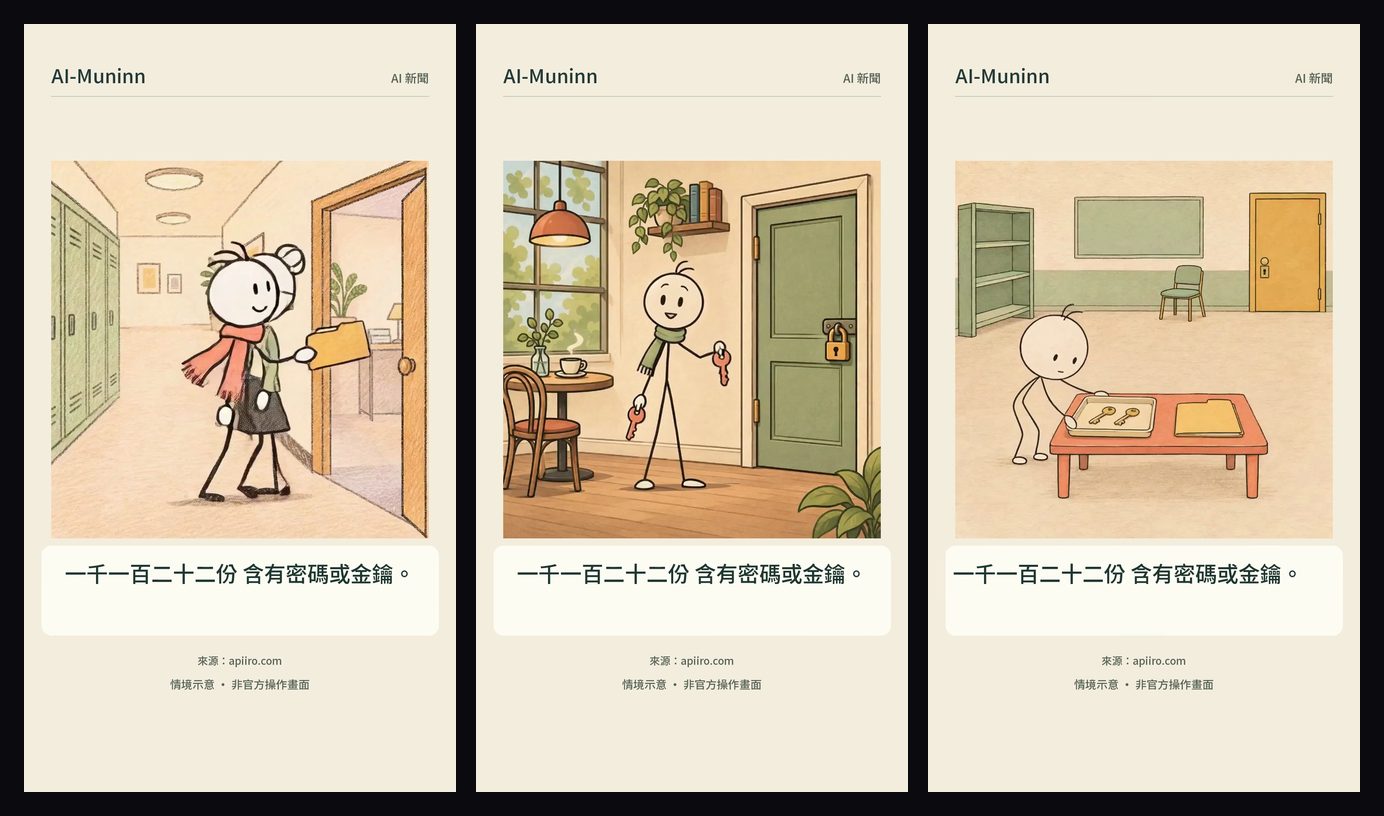
火柴人動態版:OpenAI 資料中心保密協議那則。
剪貼畫版:H200 獲准賣中國、買方被爆是空殼公司那則。
字幕新聞版:SoundCloud 和 ElevenLabs 合作那則,現在只當退路。
「定稿就一定交片」是另一條規則。任何版型整支失敗,就退回字幕新聞照常交;只有某一個場景的動畫失敗,那一鏡改成靜態圖慢慢推近,其他鏡頭照用,不整支退。稿子都查核過了,不該因為畫面出問題就丟掉。
本地模型當導演:火柴人那組分數最高,字幕新聞小輸 Opus
「導演」這一步是讓模型決定每一鏡要畫什麼、字卡怎麼放、動畫怎麼接。我拿同一份稿、同一段配音,讓不同模型各導一支來比。
火柴人那組,7 鏡全部是動畫鏡:
| 導演 | 分數 | 耗時 |
|---|---|---|
| DS4.1 | 89.3 | 24 分 56 秒 |
| Sonnet | 84.0 | 19 分 31 秒 |
| Codex | 82.7 | — |
89.3 和 84.0 差 5.3 分,評審重評本來就會差這麼多,光看分數分不出誰好。所以我另外做了成對比較:把兩支片並排給評審,問它哪支比較好,再把左右對調問一次,兩次都挑同一支才算數。結果兩次一致:DS4.1 贏過 Sonnet,Sonnet 贏過 Codex。本地模型慢了五分多鐘,但做出來的片比較好。
字幕新聞那組換成 Opus 對 DS4.1,三題,一樣同稿同配音。評審分數 Opus 77.8、DS4.1 72.0,差不到 6 分,也在雜訊內;成對比較 Opus 2 勝 1 平。我自己盲選三題都選了 Opus,但兩邊其實很接近。耗時平均 Opus 632 秒、DS4.1 820 秒;回合數 Opus 42–61 回、DS4.1 16–24 回,Opus 改得比較多次,總時間反而短。
結論是字幕新聞改由 Opus 導,Opus 失敗再退給 DS4.1。火柴人留給 DS4.1。
harness 把白板導演從 80.6 分鐘壓到 5–10 分鐘:一輪只消一類重複動作
DS4.1 一開始當白板導演,一支片要 80.6 分鐘,中間跟工具來回 116 次(每次是「想一下、做一個動作、看結果」)。同類片 Sonnet 只要 7.4 分鐘。
這裡的 harness,是我替模型準備的工作環境:給它的工作說明、一張「這個動畫引擎能做什麼」的速查表、可以呼叫的小工具(例如算秒數的計算機)、做完之後自動挑錯的檢查程式,還有每個階段准它用哪些工具。模型本身不變,換的是這一圈。
看起來很像本地模型能力不夠,但我覺得不是。我把它每一步做了什麼的紀錄攤開來看,時間幾乎全花在重複動作上:在思考裡手算秒數、反覆讀同一個檔、一次只看一張圖、同一處改好幾次。
舉一個最具體的例子。白板片的每張字卡要停幾秒、整支片在第幾秒結束,都要照配音算出來。DS4.1 一開始是在自己的思考裡一筆一筆加減,算完不放心再算一次,改一個地方又全部重算。我給它一個專門算這件事的小工具、規定不准自己心算之後,一支片從 51.9 分鐘掉到 13.6 分鐘。模型還是同一顆,只是不用再自己按計算機。
做法很像幫新同事抓工作習慣:
- 先寫下「理想上它應該怎麼做」:讀一次速查表、想好企劃、一口氣做完、檢查一次、修一輪、交件。
- 對照它實際做了什麼,列出哪一類多餘動作最多、最花時間。
- 一輪只解決一類,先解最花時間的那類。解法通常是補一個工具或一條資訊,讓它不用再那樣做。
- 每一版都存一份可以退回的版本,記下改了什麼、快了多少。
- 事先定好什麼時候停,到了就收手。
每一輪消掉的東西都很具體。第一版把程式收成單一檔、資料直接內嵌、補一張速查表、檢查一次列出所有缺陷,降到 51.9 分鐘。第二版給它一個算停留和完稿時間的工具,禁止在思考裡手算,直接掉到 13.6 分鐘。之後收掉規劃階段的工具權限、把座標和字框交給程式算、讓檢查報告直接說「哪個字卡要縮到幾個字」,最後一版 5.4 分鐘、16 回合。中間有一版反而回升到 10.9 分鐘,所以我寫的是 5–10 分鐘,不是 5 分鐘。
有一條邊界我一直守著:harness 只砍浪費、抓明確的缺陷,畫什麼留給模型自己。
完整的版本表和這段過程踩到的坑,放在後半的「進階」。
一天做 20 支沒有比較多人看,所以降到一天最多 4 則
產線穩定之後,我用 YouTube API 把 10 月底以來約 240 支新聞短片的數字拉出來看(11-09 讀)。
日產量從 1 支到 20 支都有,但每支片的觀看數沒有跟著產量變:一天做 20 支,每支被看的次數跟一天做幾支的時候差不多,多做的片沒有多換到人看。同一段時間觀看最多的,反而是我自己做的硬體實驗長片。
所以我把產量降到每輪 1 則、一天最多 4 則,省下來的力氣拿去顧品質。產線能自己跑之後,下一個要解的問題變成「什麼樣的片有人看」,那就不是多做幾支能回答的了。
進階
不讀這節不影響理解前半。下面是 harness 的完整版本表,以及產線上線後遇到的幾個問題:每一條講發生什麼、怎麼發現、怎麼修。
harness 每一版改了什麼
同一題(PaperPilot),每版打 tag。
| 版本 | 改了什麼 | 分鐘 | 回合 |
|---|---|---|---|
| 舊做法 | — | 80.6 | 116 |
| h1 | 單一程式檔、資料內嵌、速查表、檢查一次列全部缺陷 | 51.9 | 91 |
| h2 | 停留/完稿時限計算工具,禁止思考內手算 | 13.6 | 26 |
| h3 | 用 agent 框架的擴充,在規劃階段收掉工具權限 | 9.5 | 21 |
| h4 | 座標/字框交給程式 | 10.9 | 33 |
| h5 | 檢查報告直接說哪個字卡縮到幾字 | 5.4 | 16 |
對照:Sonnet 用舊 harness 做同類片 7.4 分鐘。
這段過程裡幾件會重複遇到的事:
- 提示裡寫「只檢查兩次」沒用。 h1 的模型自稱檢查了 2 次,事件紀錄裡是 7 次。要限制次數,得從工具權限硬擋,光在 prompt 裡要求它沒用。
- 為了壓時間,把品質也砍掉了。 h3 禁止讀引擎原始碼,速查表又太短,DS4.1 根本不知道白板筆、板擦、磁鐵這些功能存在。Sonnet 的片用到 6–9 類功能,DS4.1 只用 2 類。h6 把速查表補齊之後,它才開始用斜線填色和虛線。
- 用數字逼構圖,模型會玩弄數字。 h7 加了「可畫高度小於 50% 就警告」,模型就加一條裝飾底線,把高度撐上去。
- 同題重跑會吃到伺服器的前綴快取,時間不可比。之後每次測都換新題。
- 測試材料不能讓執行者自己挑、自己寫。 那樣稿子會越來越沒料,片子越做越空洞。一律用正式產線的稿。
- 思考等級我自己盲選過。 開 high、而且確實做完一輪修改的最好;同樣開 high、10 回合就交件的比較差。
中間 5.875 秒黑畫面:公開後才被抓到
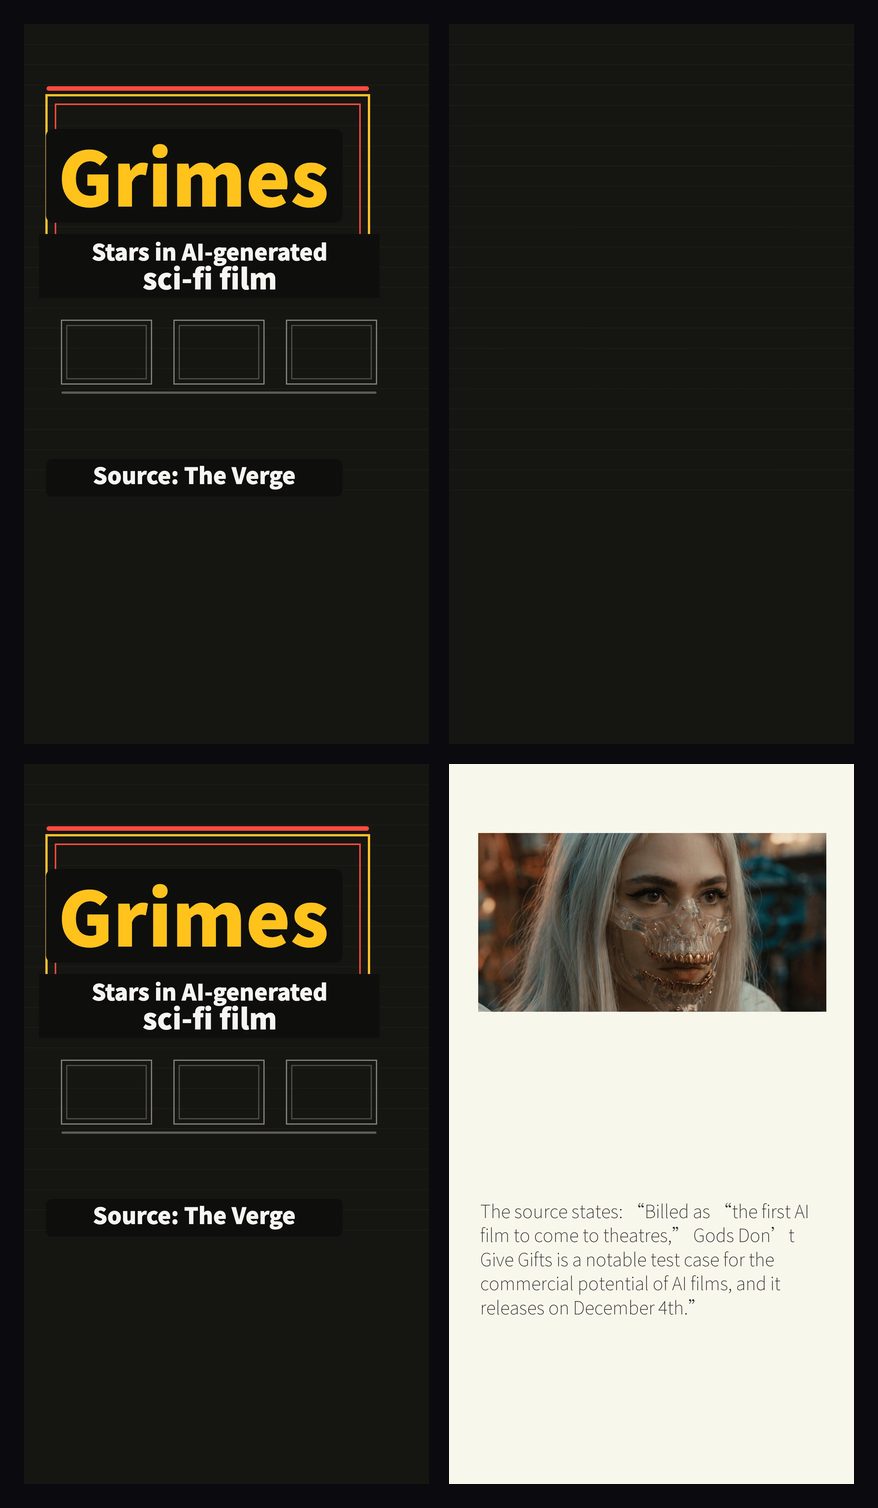
發生什麼: 一支講 Grimes 的英文版,中間有 5.875 秒幾乎全黑,佔全片 51.88 秒的 11%。
怎麼發現: 片子已經公開,是每天自動跑的回顧檢查抓到的。
怎麼修: 加一道黑畫面自動檢查,偵測到就只重做那一鏡,不整支重做;這支片重做後換掉。
為了修字幕重疊,把整個主畫面縮小
發生什麼: 有一版字幕跟畫面重疊,我為了讓位,把整個主畫面縮小。結果字幕新聞和白板兩個版型的版面都壞了。
怎麼發現: 我自己看片看到的。
怎麼修: 字幕設定改成綁在版型上,每個版型各管各的,不再一改全部跟著動。
念錯字:「擴張」和「空殼」
發生什麼: 配音把「擴張」的擴、「空殼」的殼念錯。
怎麼發現: 我聽出來的。
怎麼修: 念法表補上兩條:「擴張」標成「闊張」、「空殼」標成「空咳」。
吐槽結尾改成可選,結果 55 支裡 0 支有吐槽
發生什麼: 每支片原本用一句吐槽收尾。我把它改成「可選」,想讓模型自己判斷哪些題目適合。結果接下來 55 支裡,0 支有吐槽。可選,到模型手上就變成永遠不選。
怎麼修: 改成非敏感題預設要吐槽。重跑 10 支,10 支都有,而且都過了來源查核。
事實查核擋下「她就是間諜」
發生什麼: 一則 Nvidia 調查執行長與一名女性關係的新聞。原始資料寫的是「備忘錄指稱她可能被招募來監視他」,稿子寫成了「她就是間諜」。
怎麼發現: 事實查核那一關擋下來的。
怎麼修: 這支直接不做。這是兩道硬關卡之一,碰到就整支丟掉,不嘗試自動修。
選題限時 35 秒,太短
發生什麼: 選題那一步的時間上限設成 35 秒,設的時候沒有回頭看過去每輪實際花多久。
怎麼修: 查歷史紀錄,最長一次是 420 秒,上限改成 600 秒,大約是歷史最長的 1.4 倍。限時要從實際跑過的數字算,不能憑感覺填。
常見問題
- 為什麼審稿不能跟寫稿用同一顆模型?
- 我在導演那一步試過讓 DS4.1 審自己做的片,它看到省略號開頭,自己說「可接受」就放過去。換成另一顆模型審,實際跑一輪就抓到開場和吐槽張冠李戴。所以現在事實查核交給 MiniCPM-V 4.7 和 Qwen3.8-Flash-Next,寫稿的 DS4.1 不審自己。
- 本地模型當短片導演,比得上 Claude 嗎?
- 看版型。火柴人版同稿同配音,DS4.1 導的拿 89.3 分,Sonnet 84.0、Codex 82.7,成對比較左右互換兩次都是 DS4.1 > Sonnet > Codex。字幕新聞版 Opus 77.8、DS4.1 72.0,差不到 6 分,在雜訊內,我自己盲選三題都選 Opus,但兩邊很接近。
- 本地模型當導演做太久,要怎麼加速?
- 拆事件紀錄,看時間花在哪一類重複動作上,一輪只消一類。DS4.1 當白板導演,時間主要花在思考裡手算秒數、反覆讀同一個檔、一次看一張圖、同一處改好幾次。補計算工具、收掉規劃階段的工具權限、讓檢查報告直接講要改什麼之後,從 80.6 分鐘降到 5–10 分鐘。
- AI 新聞短片每天出越多支,觀看會越多嗎?
- 我的頻道沒有。10 月底起做了約 240 支,日產量從 1 支到 20 支,每支片的觀看數都沒跟著產量變多。所以我把產量降到每輪 1 則、一天最多 4 則,省下來的力氣拿去顧品質。
接著讀
- 2026-11-04[AI Workflow] 讓 TTS 念對台灣讀音:念法表從 3 條長到 80 條,再讓 g2pW 自動抓破音字
VoxCPM2 配中文旁白常念成大陸音或念錯字。我用一張共用念法表,加上 g2pW 依上下文自動判讀台灣讀音,表從 3 條長到 80 條。前半教表怎麼建、破音字怎麼綁、萌典查注音、拼音沒用改同音字,後半是聲音變遠的調查。
- 2026-10-19[Dev Workflow] 一張 2080 Ti 撐起每天所有新聞短片的配音:VoxCPM2 GGUF Q4,一句兩秒
用一張 RTX 2080 Ti 跑 4-bit 的 VoxCPM2 GGUF,複製自己的聲音,幫每天好幾支中英雙語新聞短片配音,一句不到兩秒。從編 llama.cpp-omni、接成常駐服務、念錯專名怎麼標,到怎麼讓 whisper 當關卡又不冤枉人,一次講完。
- 2026-10-24[Dev Workflow] 會寫繁體中文的開源生圖模型:MOSS-Image 從測試到做出漫畫卡
MOSS-Image 繁中標題 4 題全對,Qwen-Image 2.1 同題把「全」寫成「佺」。在 RTX 5090 從一張 37 秒加速到 2.2 秒、在 2080 Ti 舊卡跟配音服務共用,最後做成四格漫畫社群卡,安裝、加速、踩坑一次講完。
- 2026-10-22[Claude Code] 把 AI 員工做成 JRPG 隊伍:Codex 一週 212 張工單一眼看出來
我用 Claude Code mods 把手上的 AI 席位畫成像素風 JRPG 隊伍:誰在工作就演工作動畫,點進去有力量、智力、敏捷、耐力、魔力。做完第一個發現是 Codex 一週接了 212 張工單。附開源 repo 與做法。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。