AI Workflow · part 28
[Dev Workflow] 會寫繁體中文的開源生圖模型:MOSS-Image 從測試到做出漫畫卡
❯ cat --toc
- 前言
- MOSS-Image 是什麼:5B 生圖模型,用 JSON 指定每段字放哪裡
- 繁中實測:MOSS 4 題全對,Qwen-Image 2.1 四題都把「全」寫成「佺」
- 在 5090 上裝起來:三個模型檔,外掛要補一個 fused qkv 修補
- 加速到 2.2 秒:4 步 LoRA 要用 fused loader 才真的接上
- 怎麼判斷 LoRA 有沒有真的生效
- 2080 Ti 舊卡:文字編碼放 CPU,一張 58 秒,配音照常
- 做成漫畫卡:一張 1.5 秒、147 字全對,但角色會跑進別格
- 限制:角色會跑進不該出現的格子
- 導讀漫畫
- 進階
- 378 行 key not loaded,為什麼還能出圖
- 融合 q/k/v:down 沿 rank 拼,up 做 block-diagonal
- 外掛的 fused qkv 修補,完整 diff
- W4A8 文字編碼器在 CPU 反而更慢
- 第一次上 2080 Ti:配音服務被擠到剩 477 MiB
- ConditioningZeroOut:拿掉負向編碼,逐像素相同
- 還沒解的
TL;DR
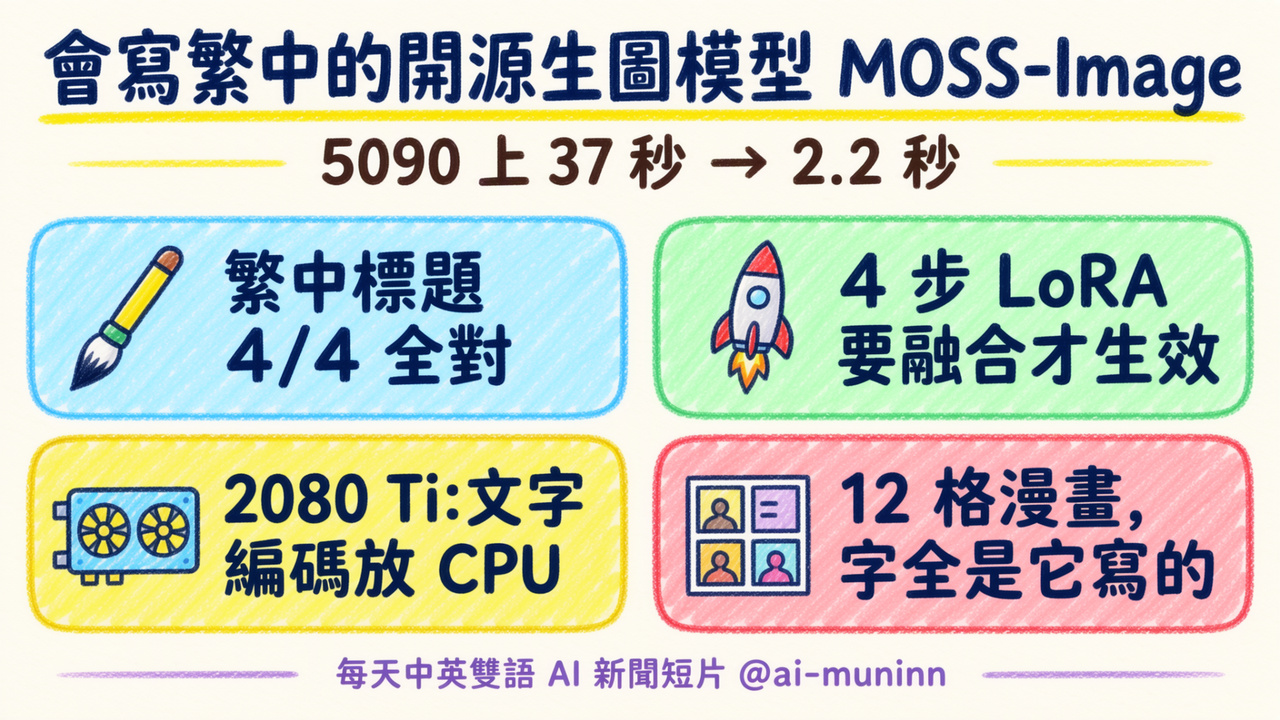
MOSS-Image 是 OpenMOSS 出的 5B 開源生圖模型,可以用 JSON 指定每段字放在哪裡。同一組繁中新聞標題,它 4 題全對,Qwen-Image 2.1 四題都把「全」寫成「佺」。原版 50 步在 RTX 5090 一張 37 秒,換 4 步 LoRA 後 2.2 秒,但 LoRA 的 q/k/v 要先融合才真的套上。舊的 2080 Ti 把文字編碼放 CPU,一張 58 秒,配音服務照常。拿它做四格漫畫卡,147 個字全對,缺點是角色會跑進別格。
前言
我每天會做好幾支影片和社群貼文,每一支都要一張縮圖,縮圖上幾乎都有一行繁中標題。
到目前為止的做法是:生圖模型畫底圖,字另外用網頁排版疊上去。可以用,但每張都多一道工,而且疊上去的字跟畫面總有點突兀。我想要的很簡單:一個開源、能在家裡跑的模型,直接把繁中標題寫對。
原本在用的 Qwen-Image 2.1 寫繁中已經算強,招牌類的字常常會對。但拿新聞標題測,同一個「全」字它四張都多寫了一個亻,變成「佺」。安全沙盒變安佺沙盒,這種縮圖能發嗎?
10-16 OpenMOSS 放出 MOSS-Image,主打的兩件事剛好是我要的:圖內文字寫得準,而且可以指定每段字放在畫面哪裡。我拿同一組題目測,繁中標題 4 題全對。問題換成另外兩個:原版一張要 37 秒,比 Qwen-Image 2.1 慢一倍多;家裡 AI Lab 那張 2080 Ti 22G 還同時掛著配音服務,記憶體不夠兩邊一起用。
這篇前半是照著做就能跑起來的教學:MOSS 是什麼、繁中實測、在 5090 上怎麼裝、怎麼從 37 秒加速到 2.2 秒、在 2080 Ti 舊卡上怎麼跑,最後是拿它做四格漫畫社群卡的做法跟限制。後半是除錯紀錄,不讀不影響使用。
MOSS-Image 是什麼:5B 生圖模型,用 JSON 指定每段字放哪裡
MOSS-Image 是 OpenMOSS 10-16 公開的生圖模型,骨幹 5B,分 Base 和 SFT 兩版,我用的是 SFT。ComfyUI 有 day-0 支援,Comfy-Org 把模型重新打包放在 Comfy-Org/MOSS-Image,授權條款是 Apache-2.0。
它跟一般生圖模型差最多的是 prompt 的寫法。照常寫一句話也行,但它更會吃一份 JSON:整張圖的描述放 summary,每一個元素放進 items,元素可以是人物、場景或一段文字,每個元素用一個 bbox(bounding box,位置框)框住位置。文字元素多一個 text 欄位,裡面就是要寫上去的字。
下面是我測縮圖用的那份(直式 1088×1920),拿掉了重複的描述:
{
  "summary": {
    "meta": ["news thumbnail", "professional graphic design"],
    "canvas": "single",
    "caption": "Professional technology news thumbnail, dark navy studio background ..."
  },
  "items": [
    {"label": "character", "caption": "An adult East Asian female news anchor ...", "bbox": [-634, -490, 730, -44]},
    {"label": "text", "caption": "Large bold clear white headline in the upper right ...", "bbox": [-730, -11, 38, 500], "text": "輝達發表 AI 安全沙盒"},
    {"label": "text", "caption": "Small bright yellow rectangular news badge ...", "bbox": [307, 65, 518, 490], "text": "本週新聞"},
    {"label": "text", "caption": "Small white channel name along the bottom margin ...", "bbox": [787, -413, 922, 435], "text": "AI-Muninn"}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
bbox 有兩個地方容易寫錯。第一,原點在畫布正中央,單位是像素,所以直式 1088×1920 的 x 範圍是 -544 到 544、y 是 -960 到 960。第二,順序是 [y_min, x_min, y_max, x_max],y 在前面。
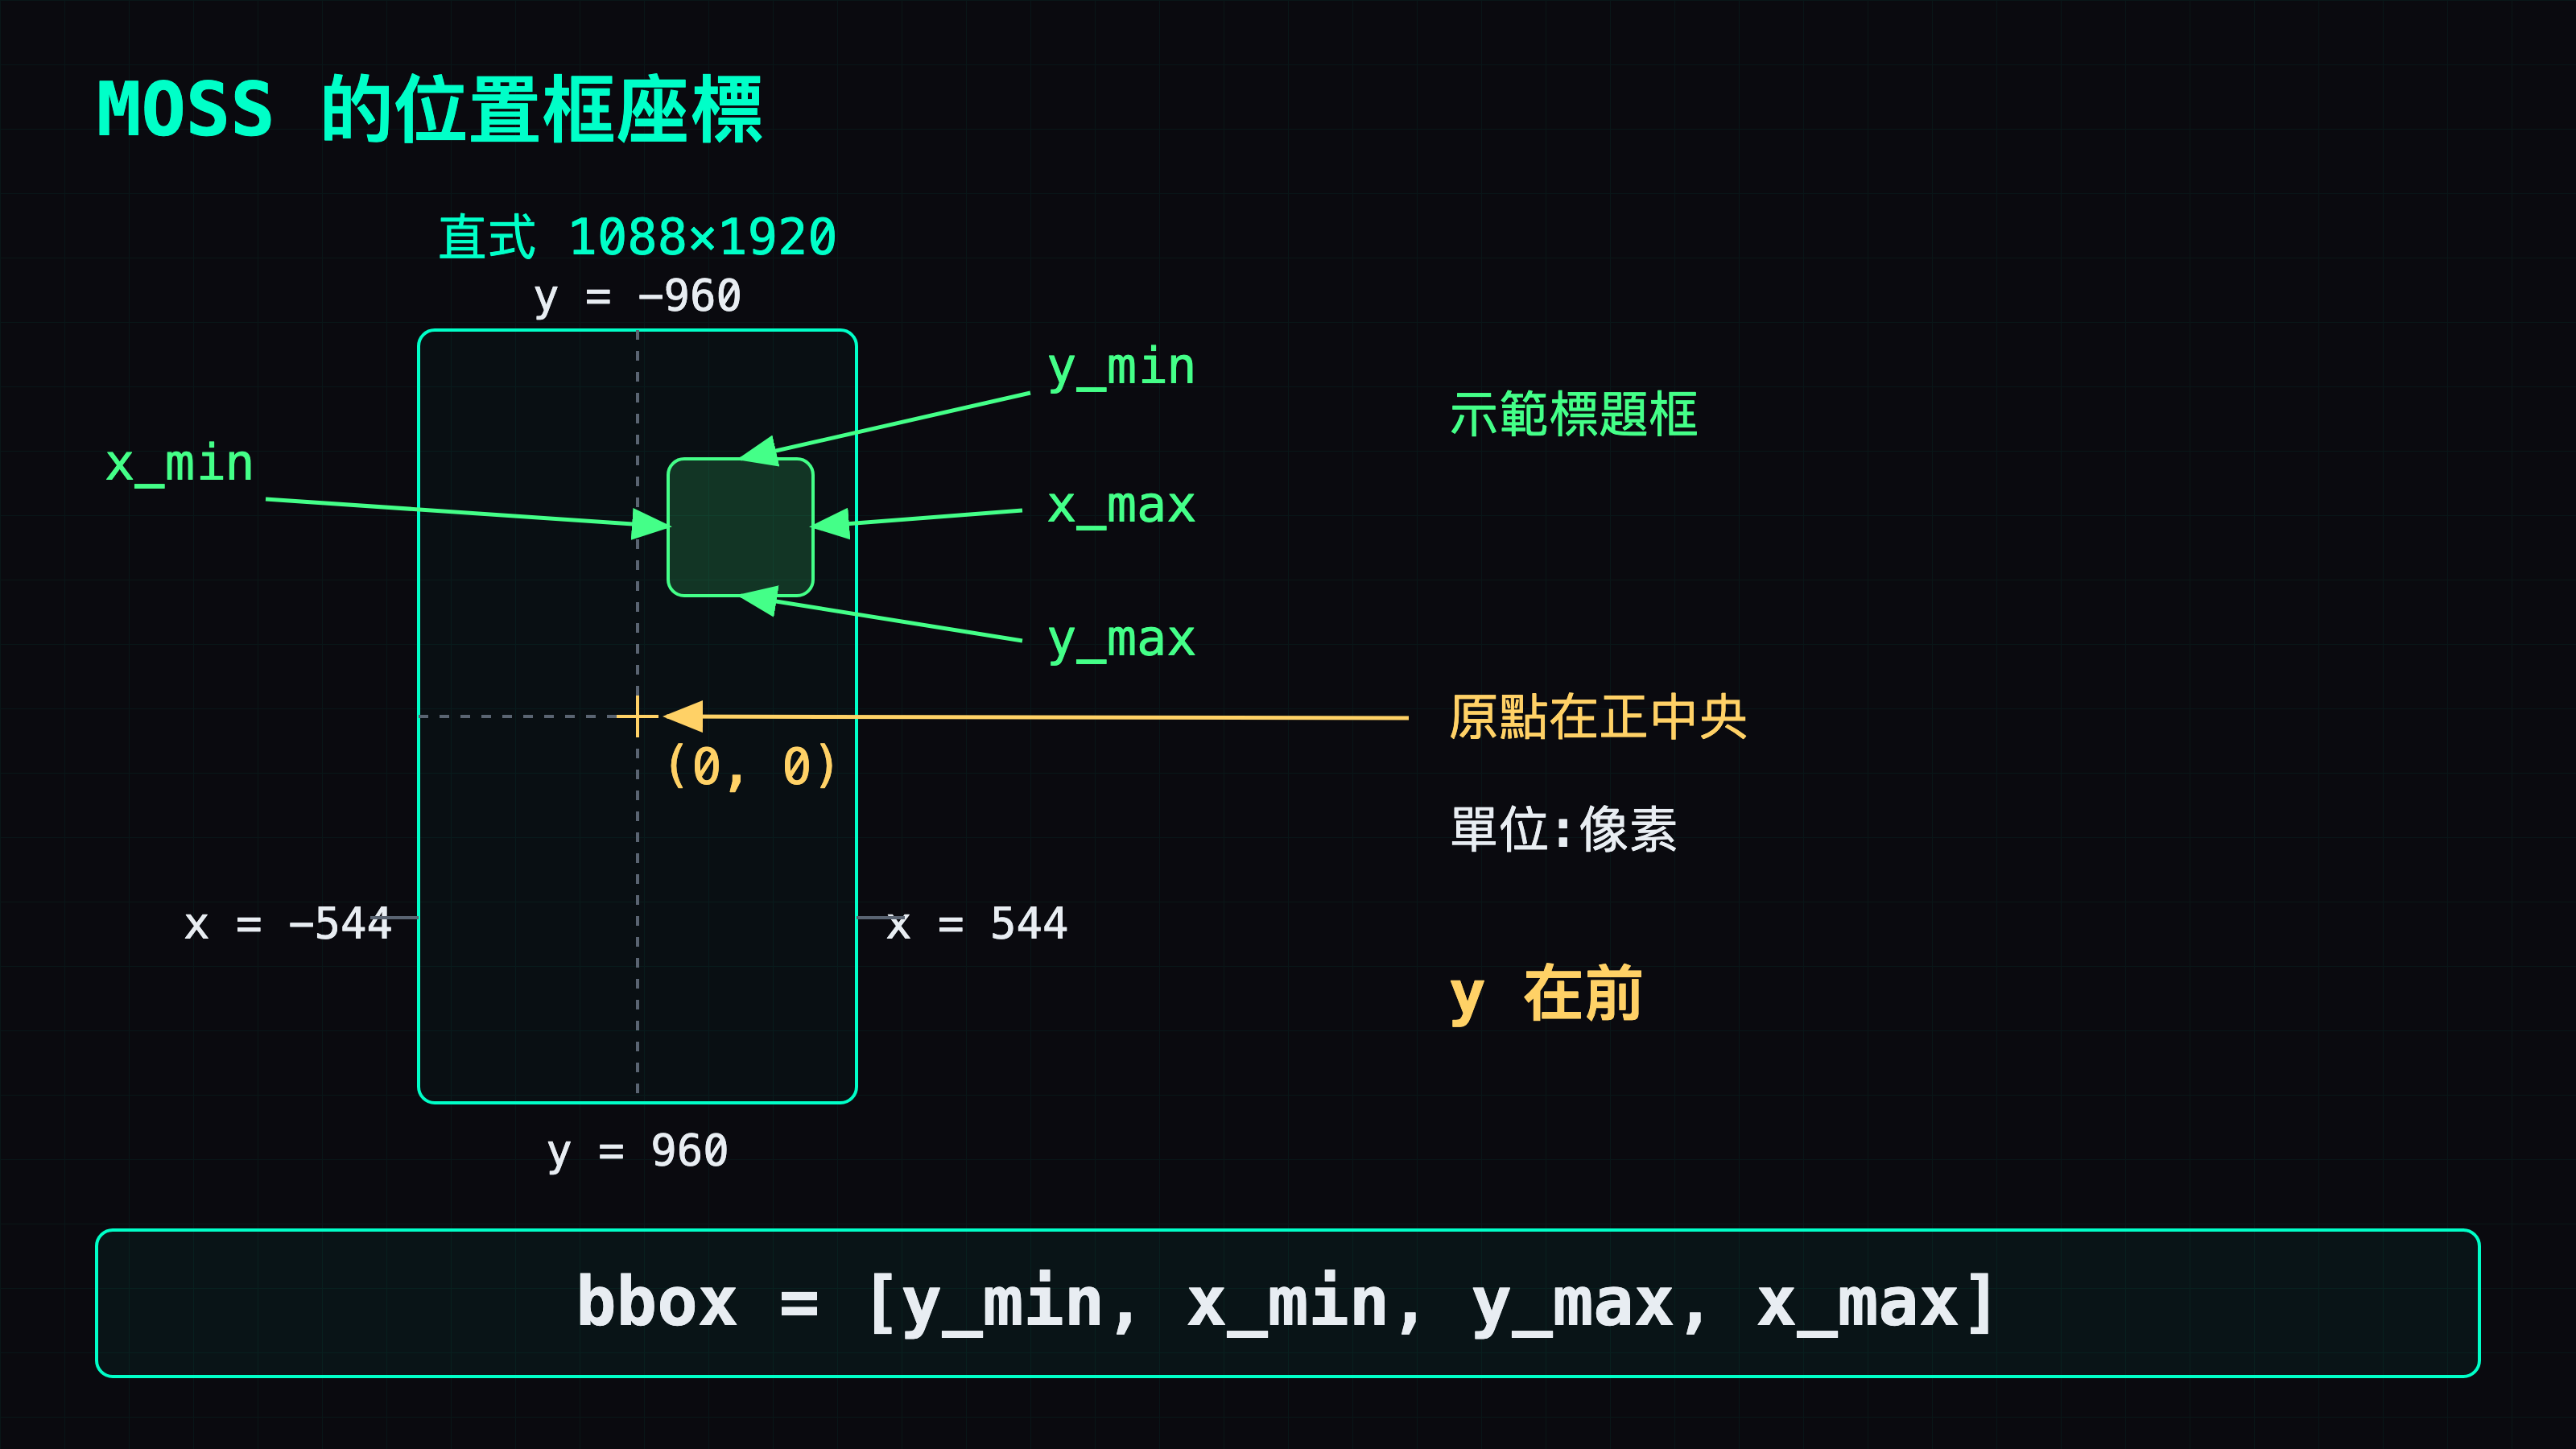
框是建議,不是硬裁切。文字大致都會乖乖待在框裡,人物常常超出去,我測的每一張人物幾乎都有越界。要拿它當精準排版引擎會失望,拿來決定「標題在右上、標籤在右下」這種程度剛好。
繁中實測:MOSS 4 題全對,Qwen-Image 2.1 四題都把「全」寫成「佺」
我做了一個固定的新聞縮圖版型:左邊主播、右上主標「輝達發表 AI 安全沙盒」、右下黃色標籤「本週新聞」、底部頻道名「AI-Muninn」。直式和橫式各一版,中文英文各一套,每種跑 seed 42 和 123,沒有挑圖換 seed。兩個模型都用各自官方建議的步數和 CFG:MOSS 50 步 CFG3,Qwen-Image 2.1 40 步 CFG1。
這張表看最後兩欄:繁中主標加標籤,還有整張三區文字都乾淨的張數。
| 模型 | 一張平均秒數(5090) | 繁中主標+標籤全對 | 三區文字全乾淨 |
|---|---|---|---|
| MOSS-Image SFT int8 | 37.25 | 4/4 | 4/8 |
| Qwen-Image 2.1 int8 | 15.12 | 0/4 | 2/8 |
Qwen 那四張繁中,錯的都是同一個位置:「安全沙盒」的「全」左邊長出一個亻。其中一張更接近「俭」,橫式 seed 42 另外把「發」寫成部件錯亂的偽字。其他字都對,就是這一個字每次都錯,所以沒辦法靠多抽幾次解決。
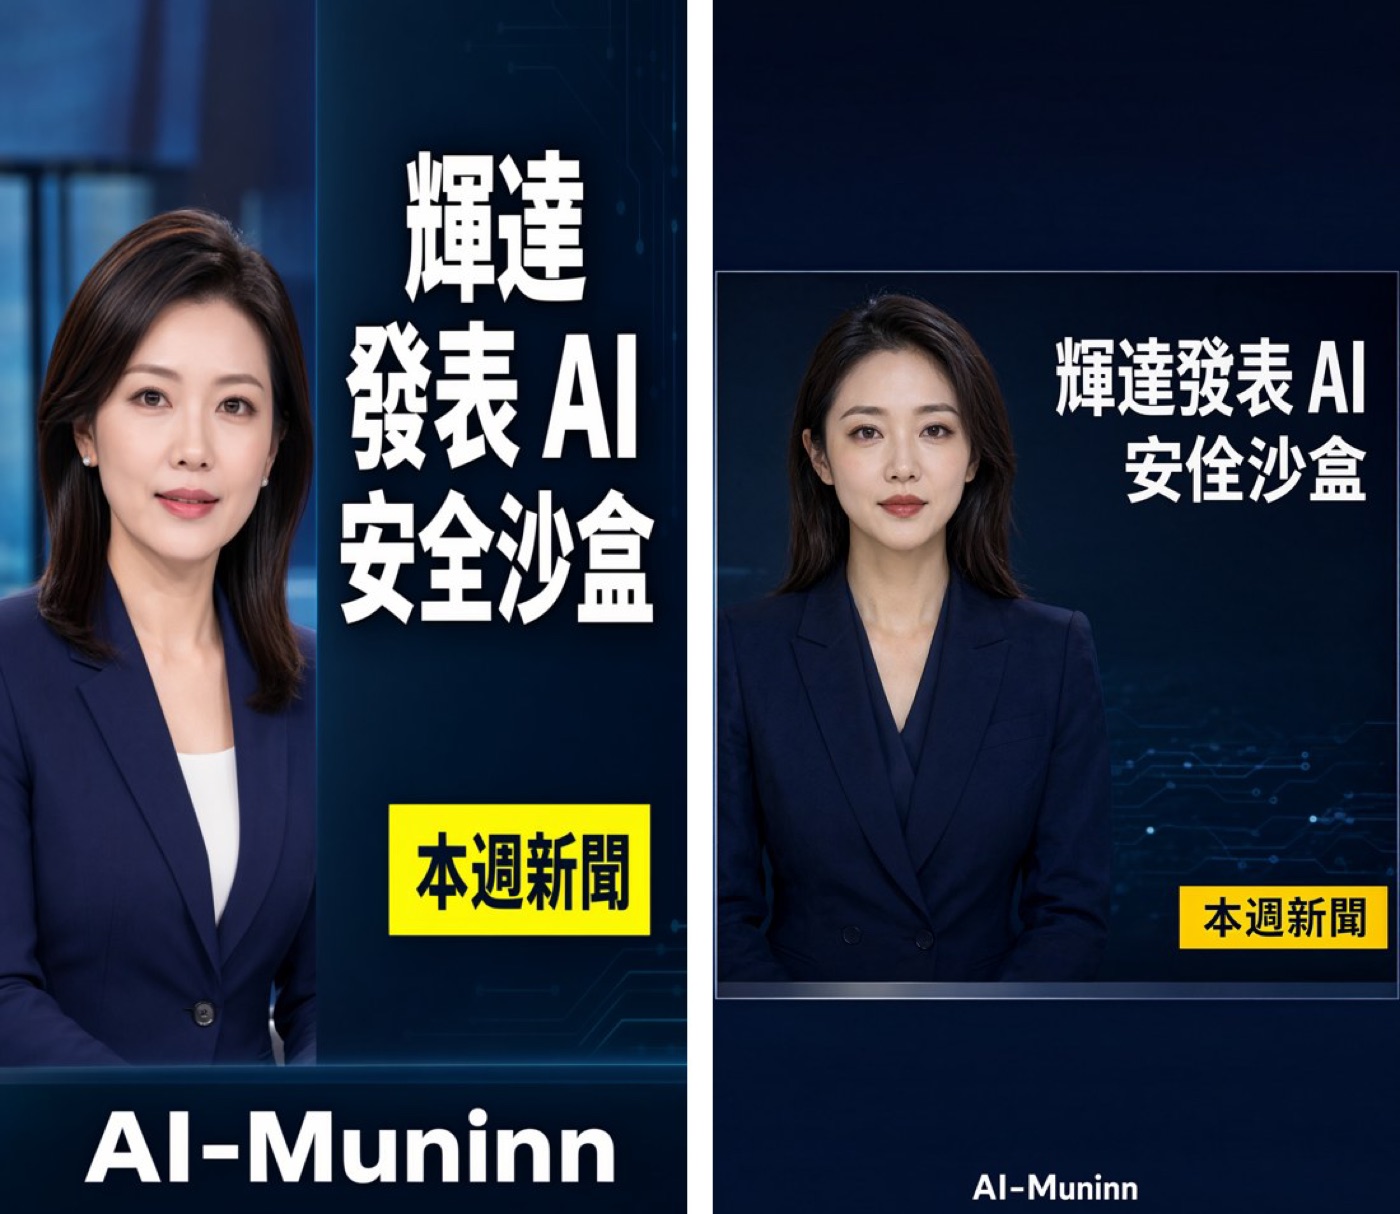
MOSS 的繁中主標和標籤四張都對,直式四張連頻道名都乾淨。它的問題出在橫式底部那條很寬的頻道名框:四張橫式都出事,兩張把「AI-Muninn」多寫一整組,一張變成「AI—Mungiicinn」,一張旁邊多了三條像字母的裝飾。
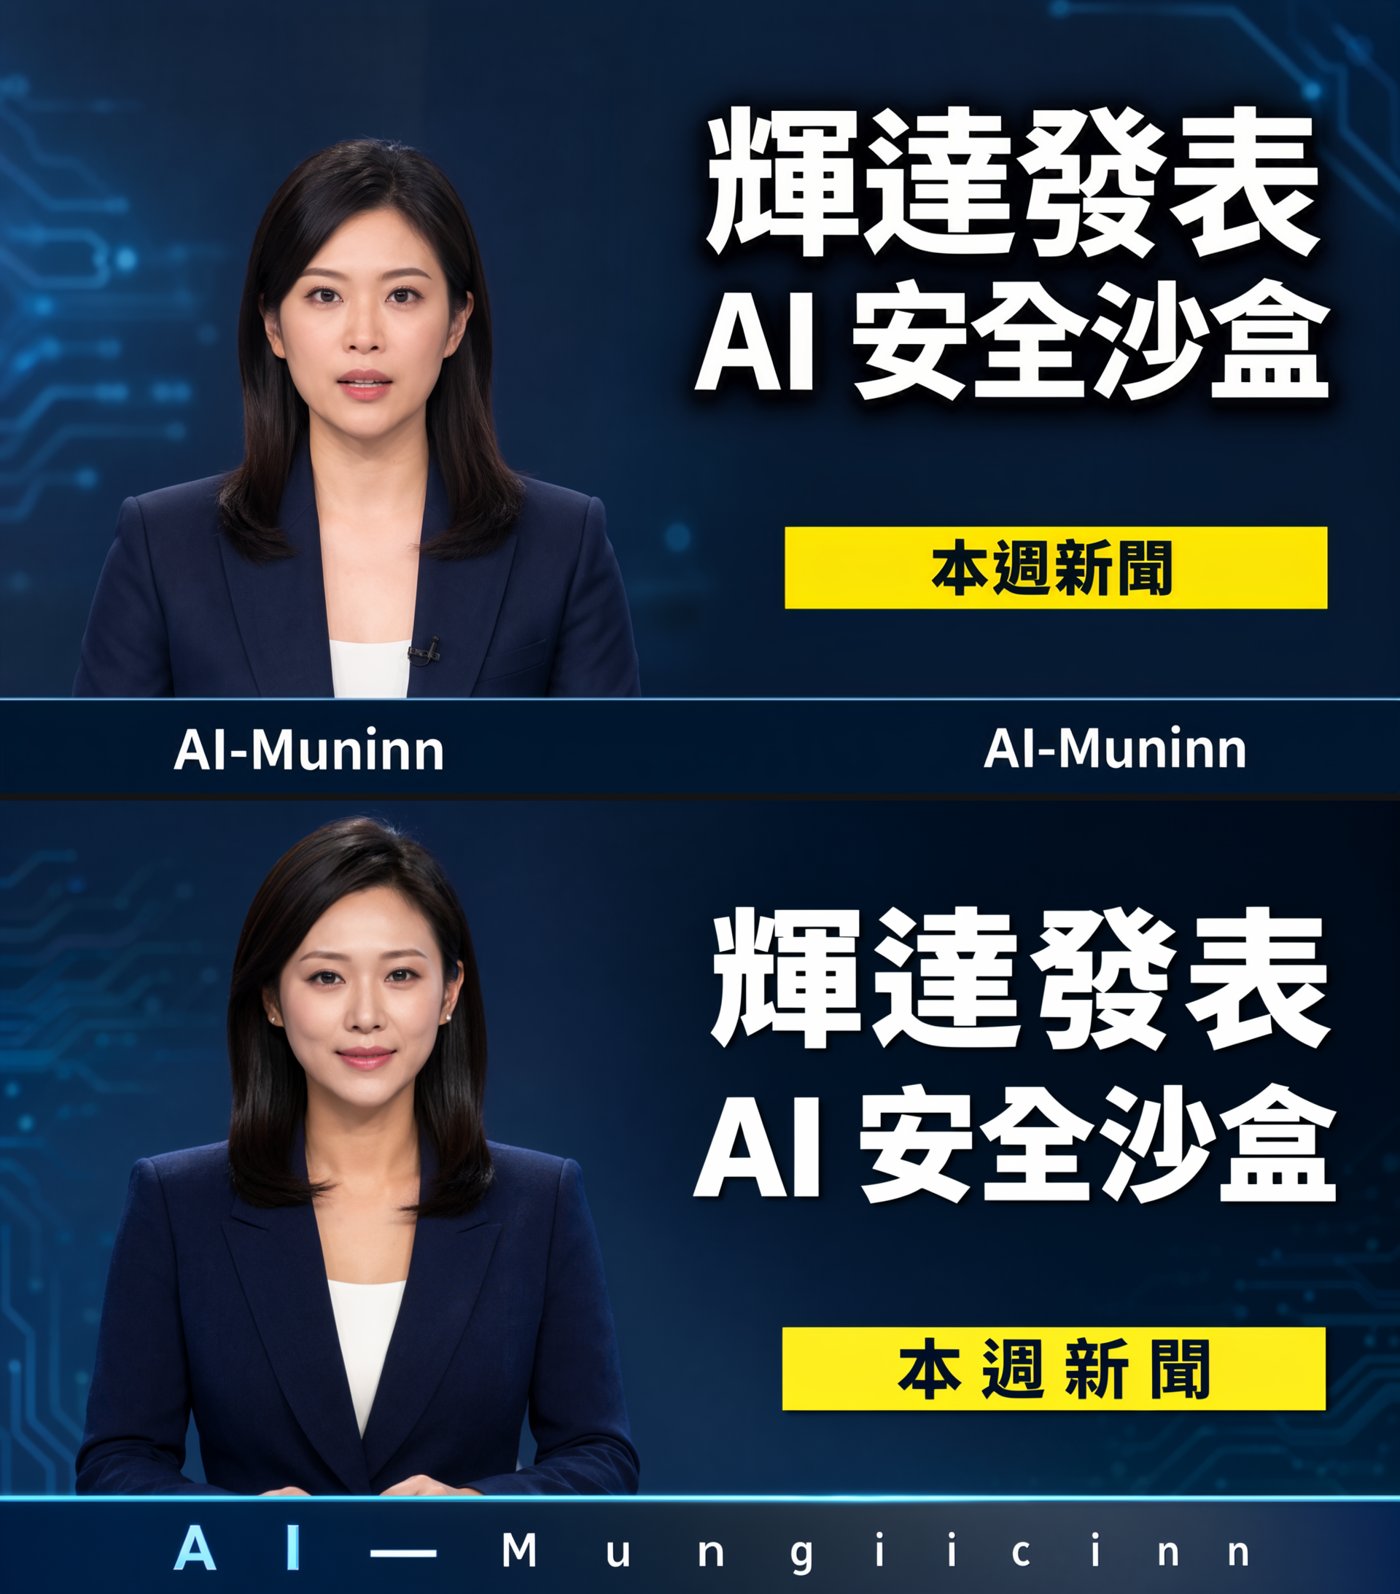
所以我現在的用法是:主標交給 MOSS 直接寫,頻道名這種每張都一樣的小字,還是後製疊上去。
速度是另一回事。37 秒一張,比 Qwen 慢 2.4 倍,每天要出好幾張縮圖的話太慢,這是下一節要解的。
在 5090 上裝起來:三個模型檔,外掛要補一個 fused qkv 修補
我的 5090 跑 ComfyUI 0.37.0、torch 2.13.0+cu130,裝的時候兩個都沒動。
外掛:MOSS 官方 repo 裡有一個 ComfyUI 外掛,在 comfyui/moss-image/,整個資料夾複製到 ComfyUI/custom_nodes/moss-image/ 就好,它的 pyproject.toml 寫 dependencies = [],不用 pip 裝任何東西。我用的是 commit 52b87fc。裝好重啟後會多出六個 MOSS 節點。
模型:從 Comfy-Org 那個 repo 拿三個檔,放進 ComfyUI 對應的資料夾。
| 放哪 | 檔名 | 大小 |
|---|---|---|
models/diffusion_models/ | moss_image_sft_int8_convrot.safetensors | 5.4 GB |
models/text_encoders/ | qwen3.5_9b_int8_convrot.safetensors | 9.7 GB |
models/vae/ | flux2-vae_small.safetensors | 250 MB |
VAE 用 small 版就夠,我沒有另外下完整版。
第一次跑會失敗。 原因是兩邊的檔案格式對不上:模型裡每一層有三組權重(簡稱 q、k、v),官方外掛預期這三組分開存成三份,Comfy-Org 打包的 int8 版(把權重壓成 8 位元、省一半記憶體的版本)卻把三組合併成一份。外掛照三份去找,找不到,一按生成就報錯:
AttributeError: 'NoneType' object has no attribute 'dtype'
看到這行就是這個問題。解法是替外掛打一個修補,讓它兩種存法都認得:合併成一份的就一次算完再切回三份,分開的照舊。修補只改外掛裡的兩個檔案,完整內容在後半「外掛的 fused qkv 修補」那一節,照著改或直接叫 Claude 照那段改都可以。改完之後我用官方範例工作流出了一張圖,再跑上面那 8 張比較,全部成功。
這個修補只動外掛自己的資料夾,ComfyUI 核心和其他外掛都沒碰。官方之後如果更新外掛或 ComfyUI 出原生節點,這段可能就不用了,裝之前先看一下官方 repo 的 ComfyUI README 有沒有更新。
加速到 2.2 秒:4 步 LoRA 要用 fused loader 才真的接上
社群已經有兩條加速路,我兩條都測了。條件跟上面一樣,只是步數、CFG 和 scheduler 照各自模型卡的規定改:
- 8 步 Turbo:toxicdog/MOSS-Image-SFT-Turbo-INT8-ConvRot,換掉主模型,8 步、CFG1、Euler/simple。
- 4 步 LoRA(LoRA 是掛在原模型上的小補丁檔,這一個的作用是讓模型 4 步就畫完):akhaliq/MOSS-Image-SFT-4-steps 的 v2.0,掛在原本的 SFT int8 上,strength 1、4 步、CFG1、Euler/simple。
這張表看暖機那一列,扣掉每版第一張的載入時間。
| 原版 50 步 | 8 步 Turbo | 4 步 LoRA | |
|---|---|---|---|
| 暖機平均(秒) | 37.31 | 3.86 | 2.22 |
| 第一張(含載入) | — | 6.96 | 5.17 |
| 三張繁中指定字全對 | — | 3/3 | 3/3 |
4 步 LoRA 一張 2.2 秒,比原版快 16.8 倍。這個倍數是少步數、CFG3 改 CFG1、換 scheduler 加起來的效果,不是單一一項的功勞。
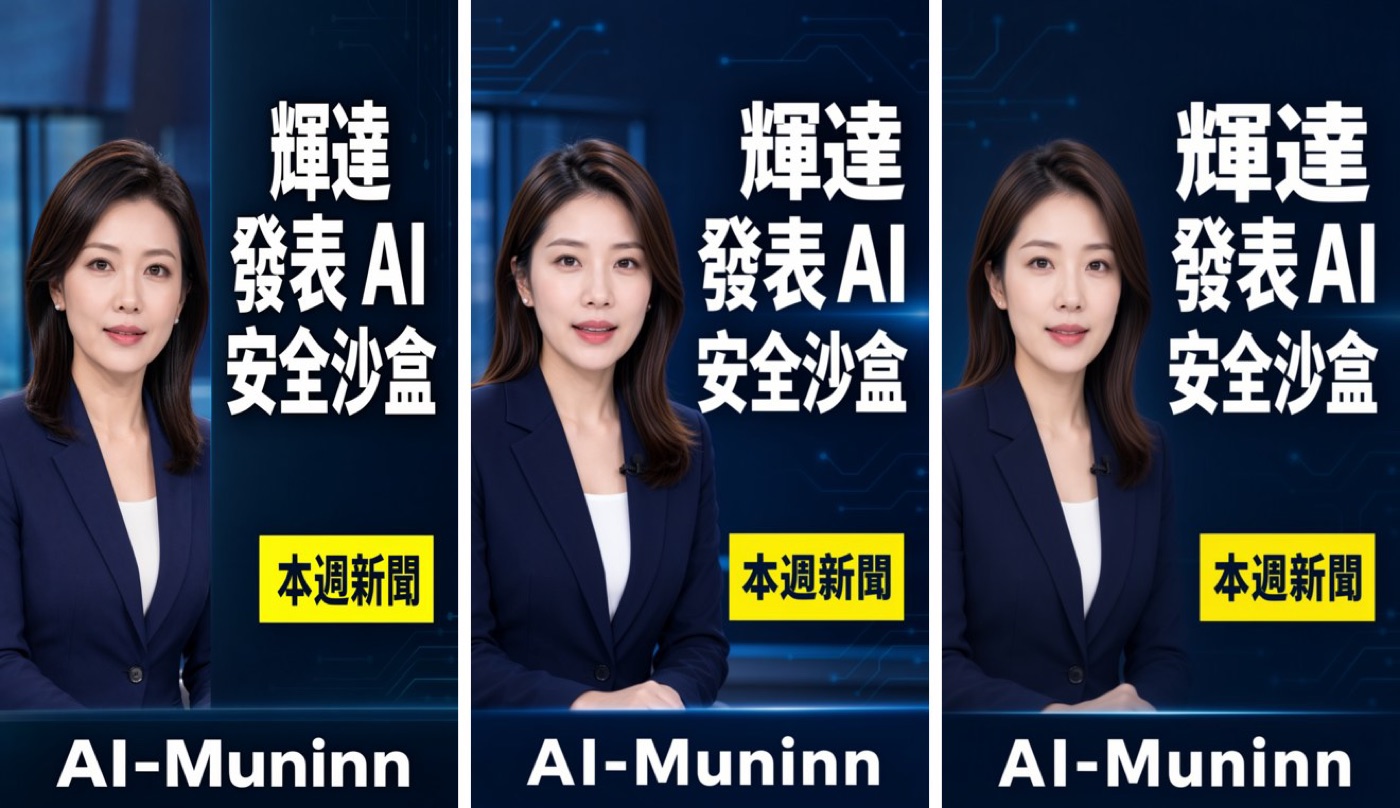
品質上,4 步的人臉比 50 步柔一點,字一樣清楚,拿來做縮圖夠用。兩個加速版在 seed 123 都在左上角背景多冒出一串模糊的假英文,那張不能直接用。橫式頻道名重複的問題,這次反而沒出現,但只有一個 seed,不敢說修好了。
怎麼判斷 LoRA 有沒有真的生效
這是整篇最容易踩的坑。4 步 LoRA 的 q、k、v 是分開存的,原 SFT int8 權重是 fused 的。用 ComfyUI 內建的 LoraLoaderModelOnly 直接套,它對不上那三組,就跳過,然後照樣出圖。
那怎麼知道它到底有沒有套上?出圖成功不能當證據,要看 ComfyUI 的 log:
grep -c "lora key not loaded" comfyui.log
我用內建 loader 那一次,數出來是 378 行,剛好是 42 層 × q/k/v × 三個張量。每一行長這樣:
lora key not loaded: diffusion_model.layers.0.proj.q.lora_down.weight
這個數字不是 0,就代表 LoRA 只套了一部分。只套到 o 和 FFN 的那張圖,看起來也很正常,所以用眼睛分不出來。
解法是自己寫一個 loader 節點,載入時把每一層的 q、k、v 三組 LoRA 融合成一組 qkv,形狀對上 fused 權重再套。我寫的叫 MOSSImageFusedLoraLoader,放在 MOSS 外掛的 nodes.py 裡,工作流裡用它取代 LoraLoaderModelOnly。融合怎麼算、為什麼不能偷懶,後半有完整推導和程式碼。
換成 fused loader 之後,判斷生效有三個訊號,三個都要對:
lora key not loaded變成 0 行。- 我在 loader 裡印了一行統計,正確時是
fused_blocks=42 targets=168 tensors=504 applied=168。 - 每次採樣前 log 有
168 patches attached。
最後做一次開關對照:同 seed、同 JSON、同樣 4 步,關掉 LoRA 那張臉和字都嚴重扭曲,開了才清楚。
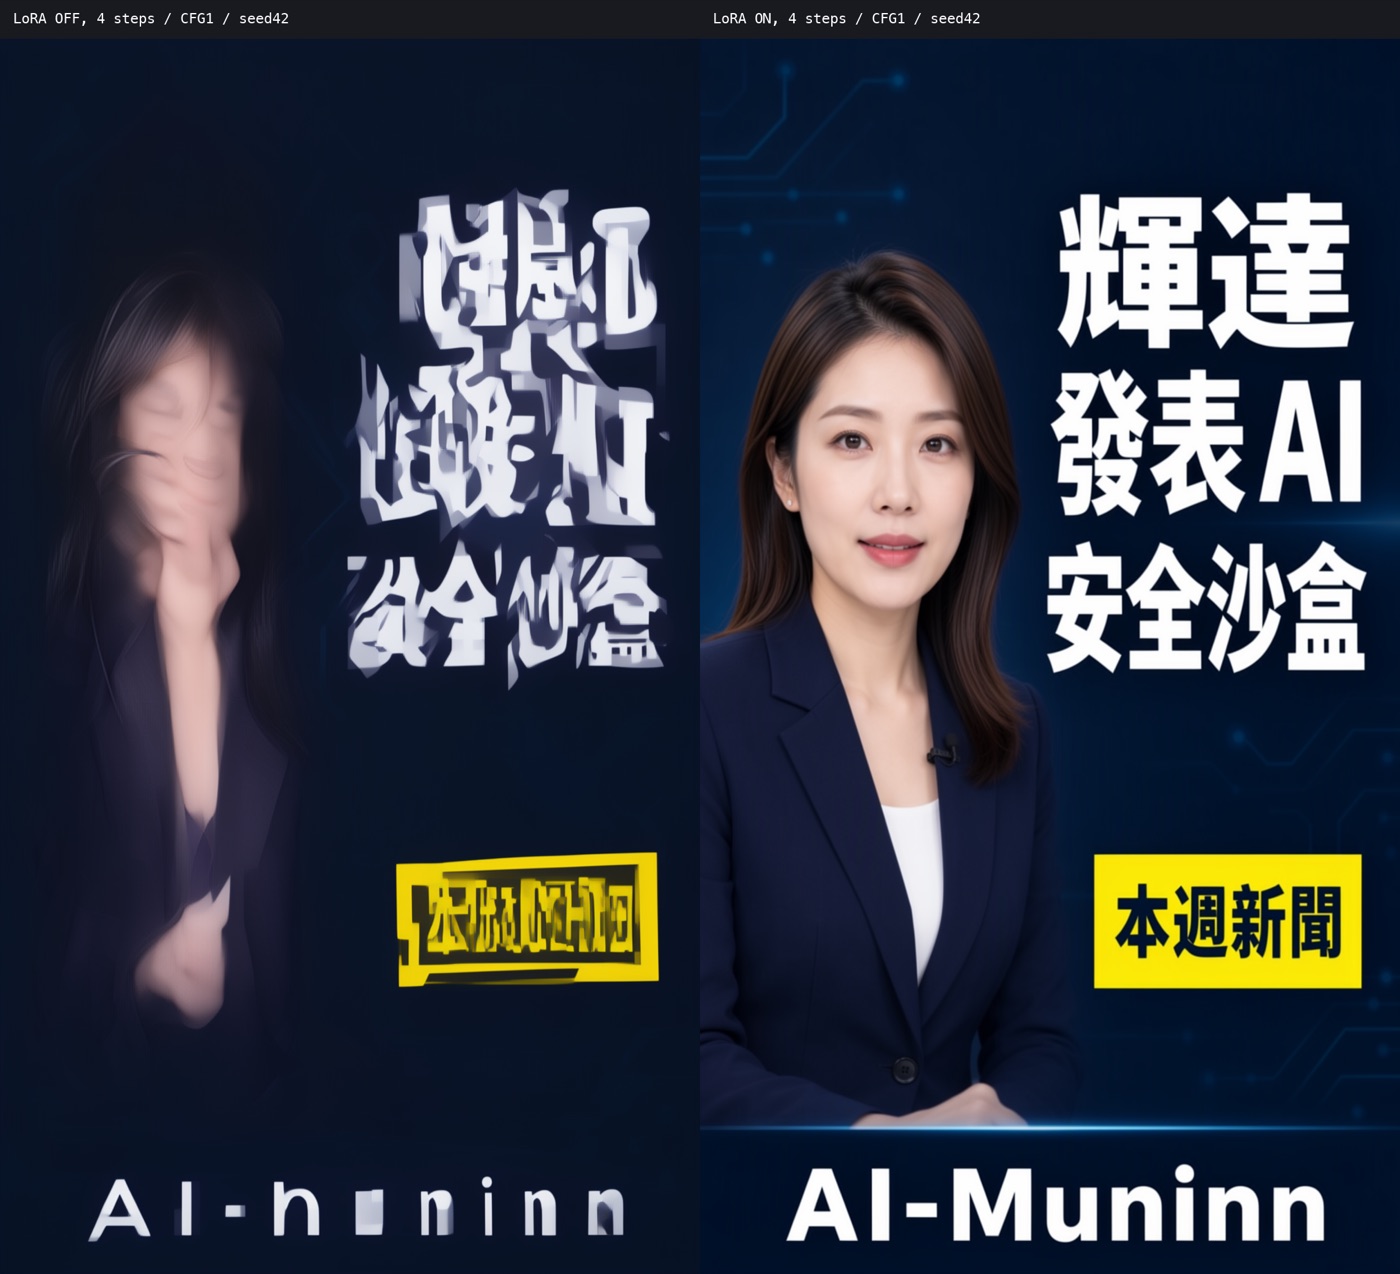
如果你的權重本身就是分開的 q/k/v(例如那個 8 步 Turbo 檔),內建 loader 就對得上,不用這一步。判斷方式一樣:看那個 grep 數字。
2080 Ti 舊卡:文字編碼放 CPU,一張 58 秒,配音照常
家裡 AI Lab 有一張 2080 Ti 22G,上面同時掛著三樣東西:一個 ComfyUI(約 8.4 GB)、配音服務(約 5.4 GB),還有我生圖用的另一個 ComfyUI。配音服務有一條規則:卡上剩不到 2048 MiB 就拒絕接工作,免得配到一半 OOM。
MOSS 在 5090 上跑的時候,整張卡用了 15.5 GiB,大頭是那顆 9.7 GB 的 Qwen3.5-9B 文字編碼器。在 2080 Ti 上要跟配音並存,做法是把文字編碼器整個搬到 CPU,GPU 只留生圖本體。
工作流只改一個地方:MOSSImageCLIPLoader 的 device 從 default 改成 cpu。其他沿用 5090 那份 4 步 LoRA 工作流,包括 fused loader。
"102": {"class_type": "MOSSImageCLIPLoader",
        "inputs": {"clip_name": "qwen3.5_9b_int8_convrot.safetensors", "device": "cpu"}}
結果:
| 一張(暖機) | CPU 文字編碼 | 配音服務 | |
|---|---|---|---|
| 5090,全部在 GPU | 2.2 秒 | — | — |
| 2080 Ti,文字編碼 CPU | 58.5 秒 | 約 26.8 秒 | 全程可用,最低剩 4,695 MiB |
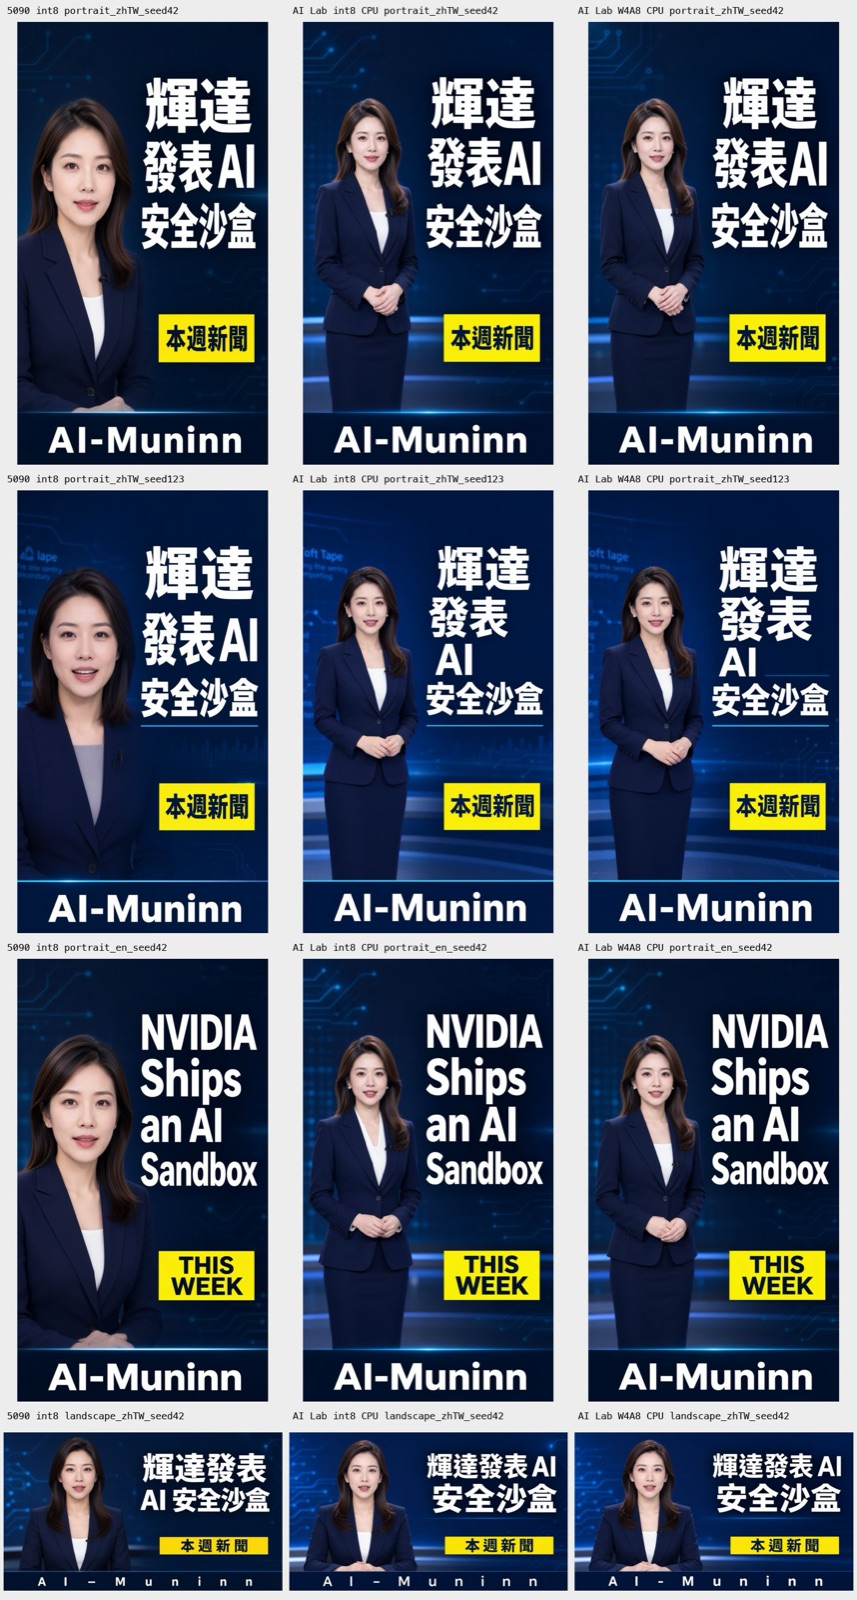
58 秒一張算慢嗎?比 5090 慢 26 倍,一半時間花在 CPU 編碼。但它跑在一台本來就 24 小時開著的機器上,不用叫醒 5090,配音服務全程都能接工作。繁中指定字四題全對,seed 123 那張背景多字的毛病也跟 5090 一樣。
開工前我會先看一眼 GPU2 的用量,這次開工時是 6,010 MiB。卡上已經被別的工作吃滿的時候,等它跑完再送,不要硬擠。
還有一個小優化:4 步 CFG1 根本不跑負向那條路,負向的空字串還是會在 CPU 上編碼一次,白花將近 27 秒。把負向那顆 CLIPTextEncode 換成 ConditioningZeroOut(輸入接正向的輸出),出來的圖逐像素相同,第一張從 89.7 秒降到 62.4 秒。驗證過程放在後半。
我也試了更小的 W4A8 文字編碼器,以為放 CPU 會比較快。結果更慢,一張 108 秒。數字放在後半。
做成漫畫卡:一張 1.5 秒、147 字全對,但角色會跑進別格
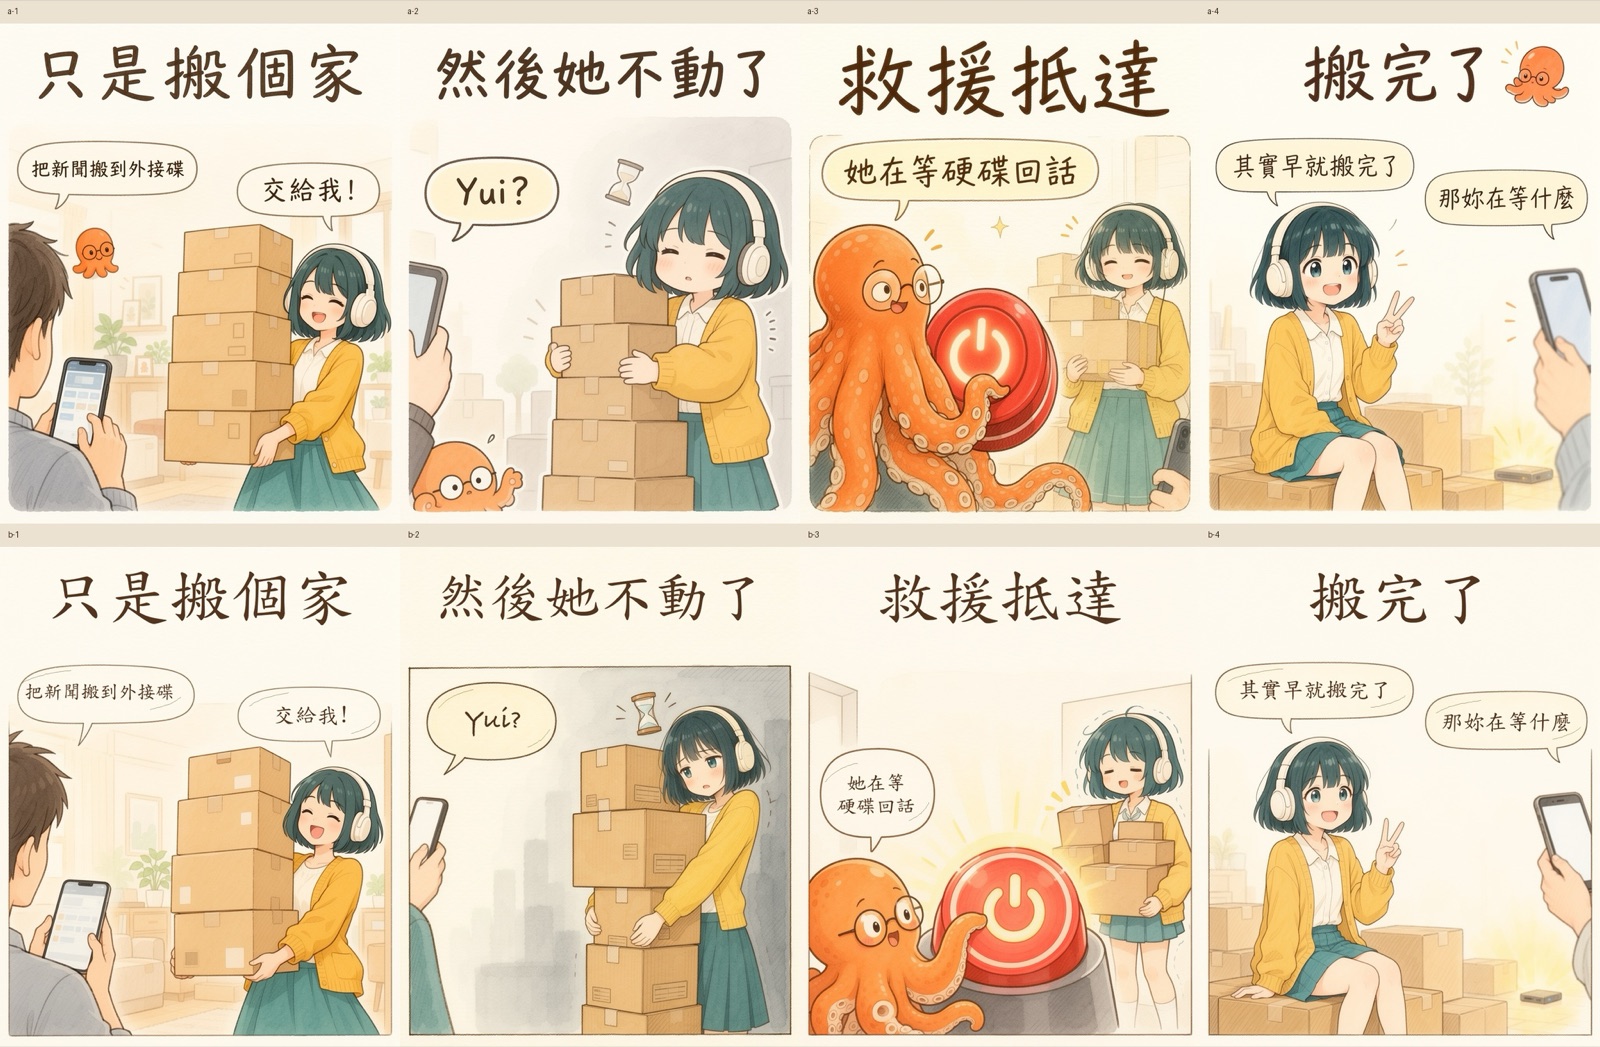
會寫字之後,我拿它做了一組四格漫畫社群卡:四張 1024×1280(4:5)的卡,一張一格,當輪播貼文發。故事是我的 AI 助手 Yui 幫我搬資料、搬完卻卡在那裡等硬碟回話,Claude(一隻戴圓眼鏡的橘色小章魚)來救援。
跑在 5090,用前面那套 4 步 LoRA,一張暖機約 1.5 秒。每格三個 seed,四格十二張,標題加對白一共 147 個漢字,147 個全對。
每張卡的 JSON 裡,各欄位這樣分工:
summary.caption:畫風(鉛筆、棕色墨線、淡水彩、米白紙)、角色外觀、「上方 18% 留給手寫標題,不要色塊」。- 一個
sceneitem:這格的畫面。 - 一個標題
textitem,框在上方 x 8–92%、y 4–15.5%。 - 一到兩個對白
textitem,caption 寫「手繪圓角對白框,尾巴指向某某」。
對白框和尾巴是模型自己畫的,不是後製。字直接寫在紙上,手寫感比後製疊字好很多,這也是我最後選這個版本的原因。
我也試了一版「無字底圖 + 程式疊字」:底圖叫 MOSS 留空白對白框,再用 PIL 和標楷體把字疊上去。好處是字一定對、可以隨時改台詞;缺點是字體太正經,少了手寫那股味道。要常改台詞的話選這版。
限制:角色會跑進不該出現的格子
第一版我在全域的 summary.caption 裡寫了一句:
Claude when present is a tiny orange octopus with round spectacles.
意思是「Claude 出場的時候長這樣」。模型懂「when present」嗎?它不管,四格裡有三格(第 1、2、4 格)都冒出章魚,第 3 格「救援抵達」的揭曉就變弱了。
做無字底圖那一版時,我改了三件事才乾淨:
- 全域描述只寫每一格都會出現的角色,不出場的角色整句拿掉。
- 每一格的
scene裡明寫這格有誰。 - 明寫「這格恰好一到兩個對白框,每個角色只出現一次」。
第二輪我把同一招用在 MOSS 直接寫字的版本:每格的提示詞只描述這格出場的角色,連全域角色表都不寫,角色外觀在每個出場格重複同一段描述。四個新故事加六種畫風跑了 88 張,選用的圖裡章魚沒有再提早出場,但水彩那套是重跑修了一輪才乾淨,扁平向量那套的窗口裡還混進一隻熊店長。另外 36 張選用圖裡還有 2 個錯字(「種」寫成「种」、「位子」寫成「位位」),水彩風格也常把台詞派給錯的角色。
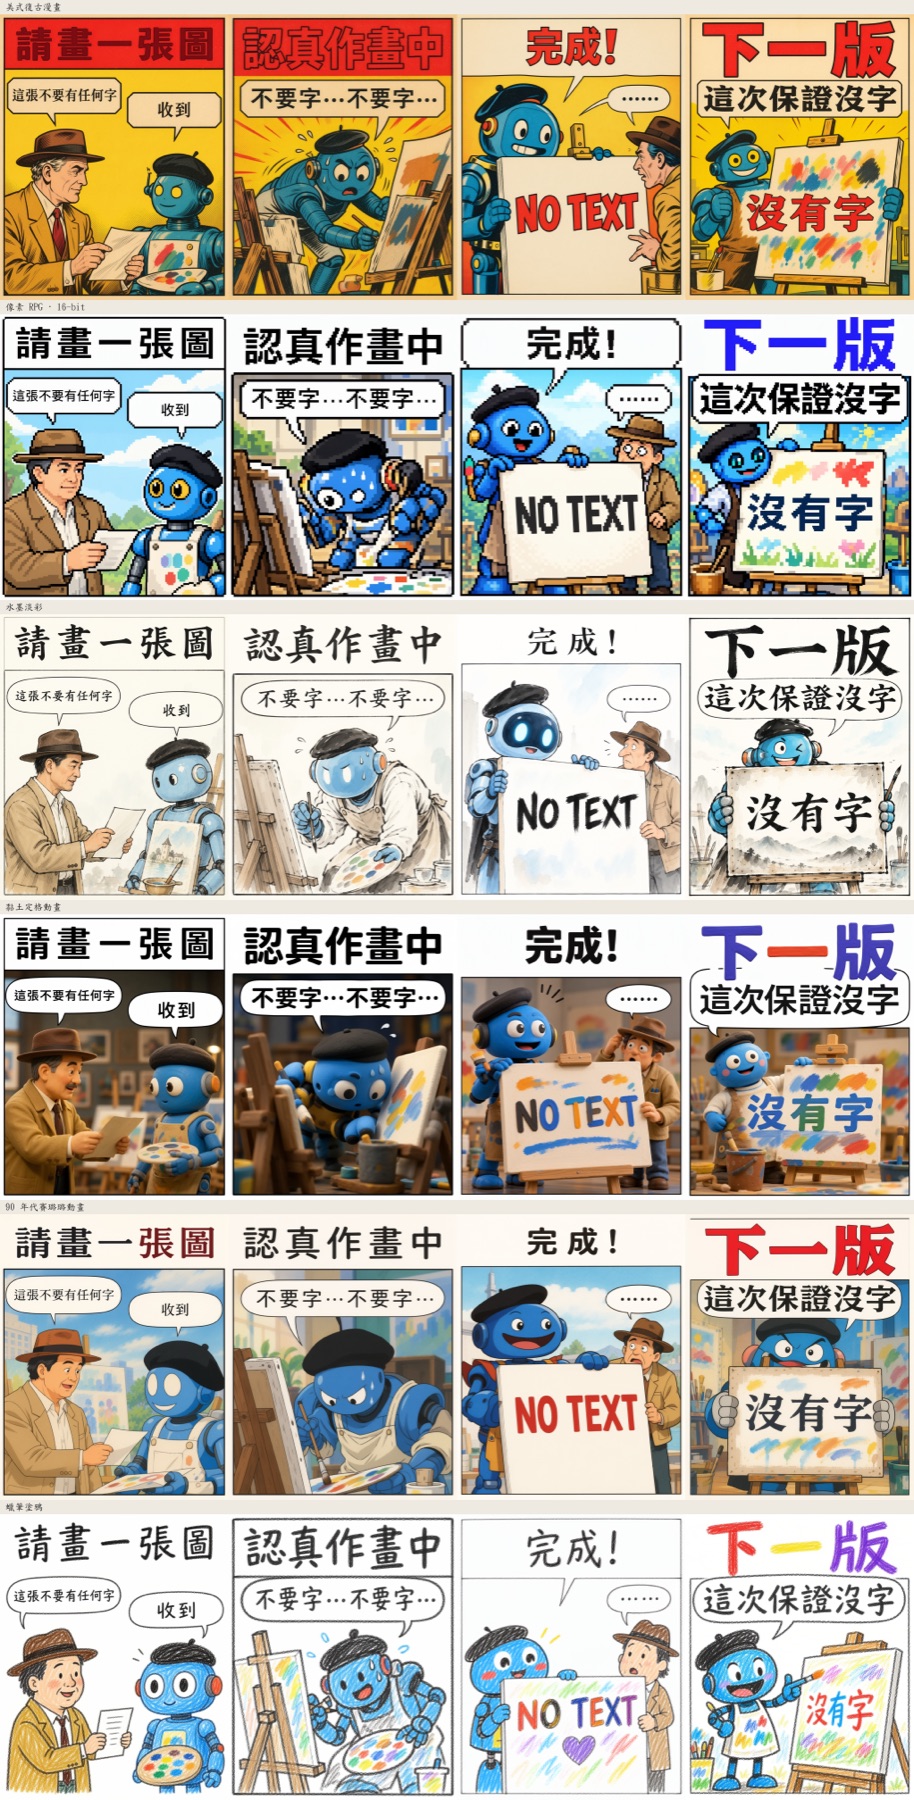
還有一個坑:叫它不要寫字的時候,別在 prompt 裡寫大寫的「NO TEXT」,它會把「NO TEXT」當標題真的印出來。
角色一致性只能算「看得出是同一個人」:髮型、耳機、外套顏色四格都對得上,但頭身比、髮長、紙箱數量每格會變,章魚的觸手數也不固定。沒有參考圖也沒有訓練角色 LoRA,這個程度就是文字描述的上限。
導讀漫畫
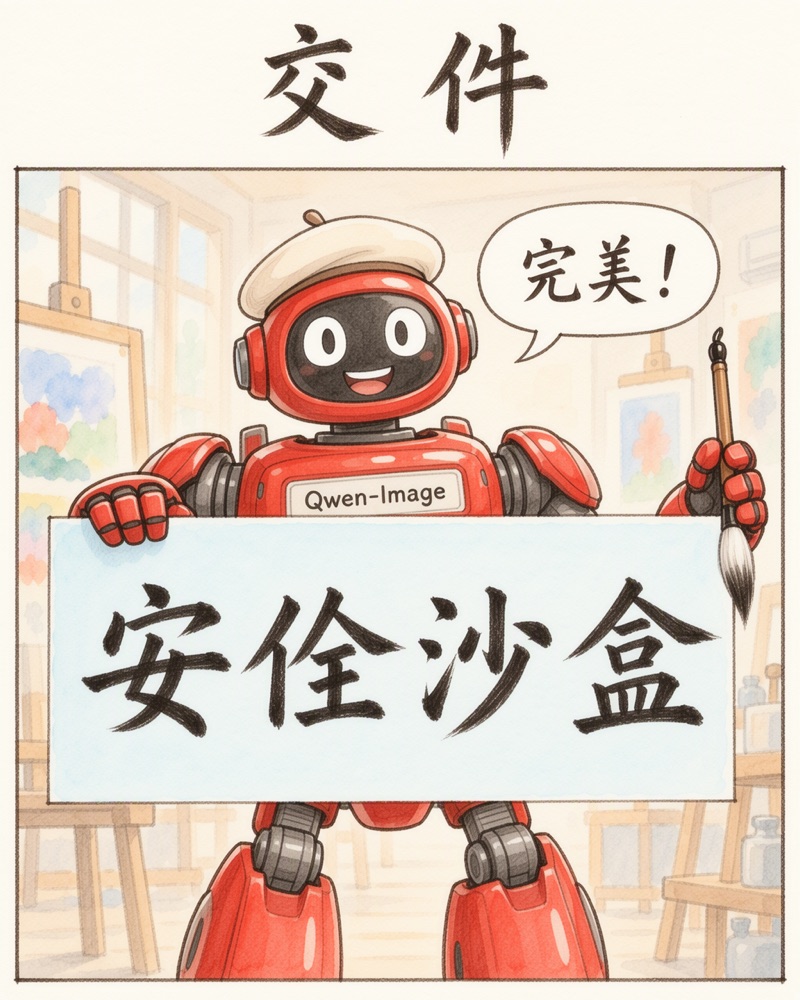
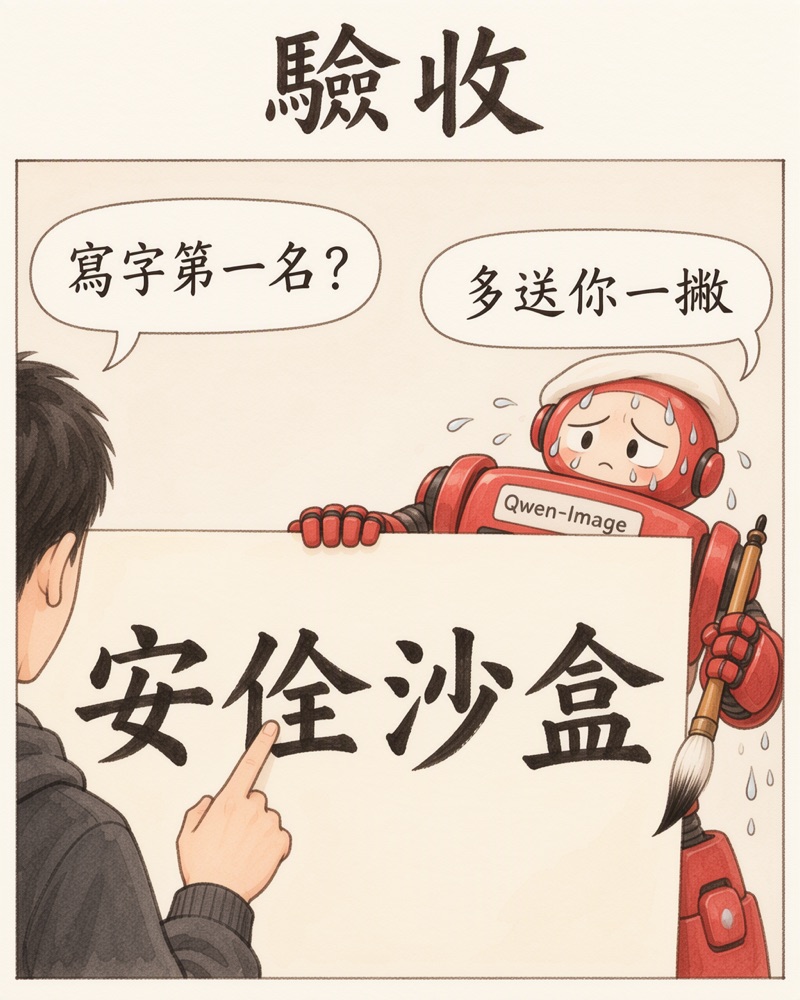
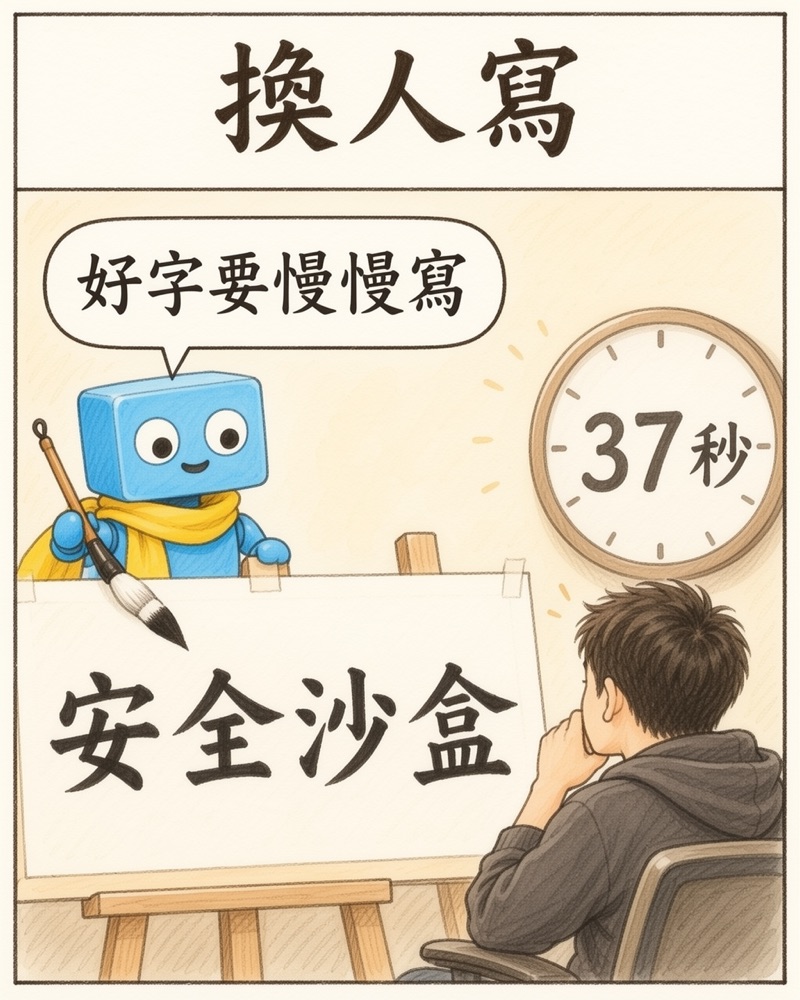
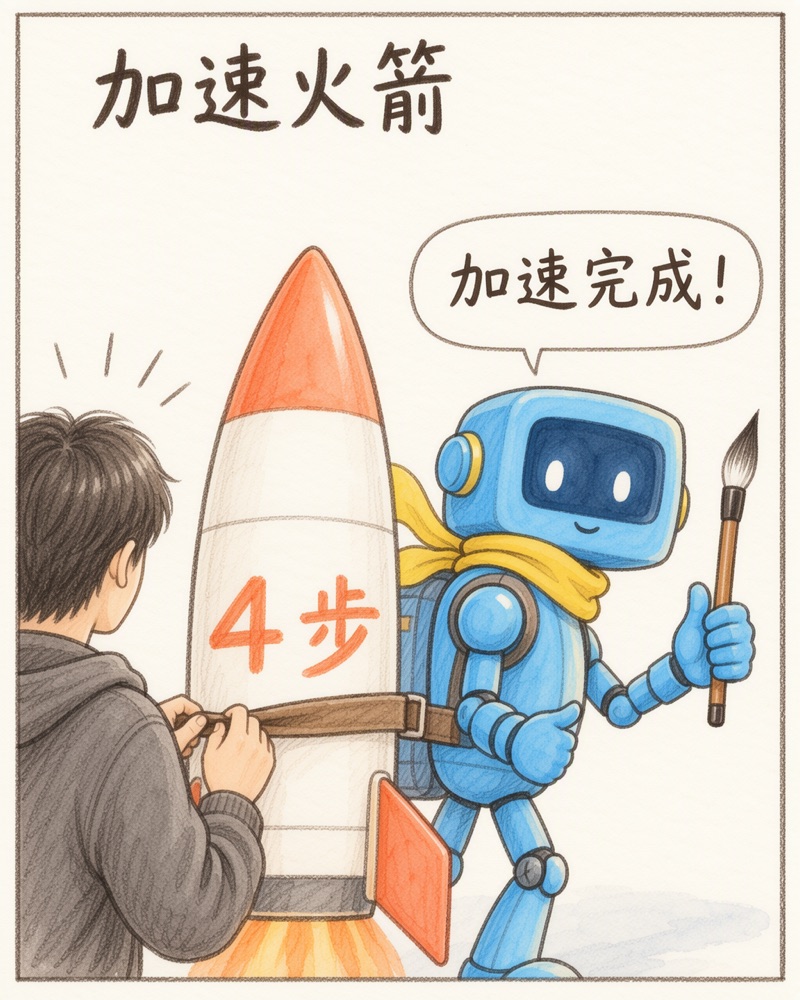
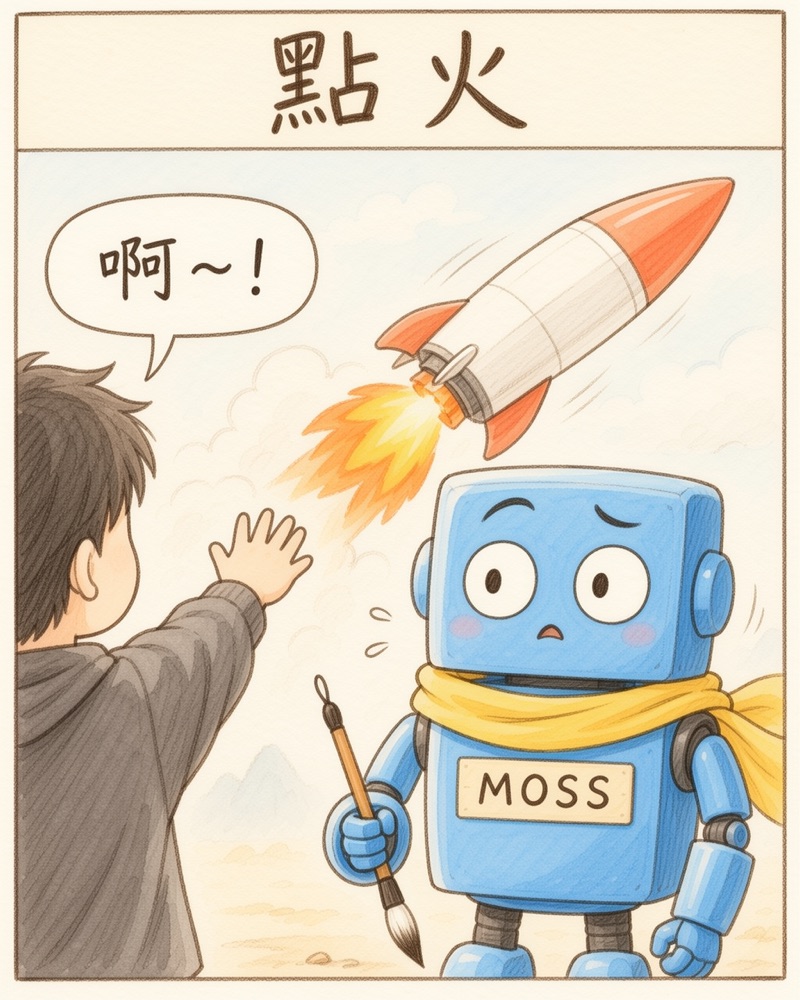
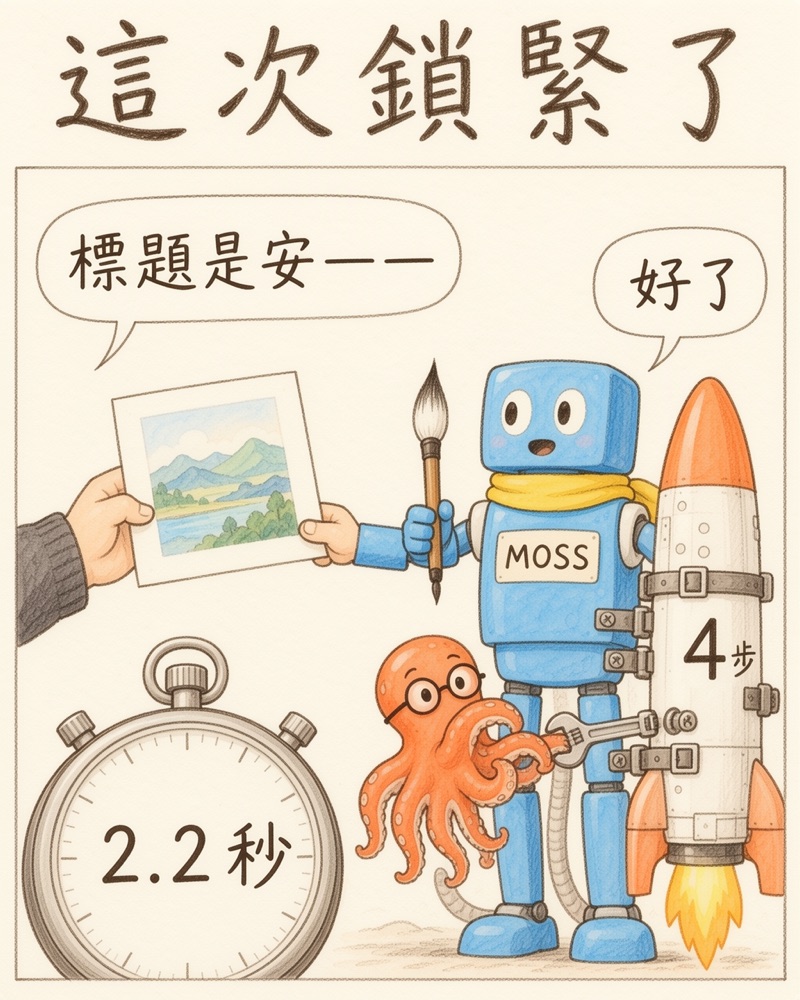
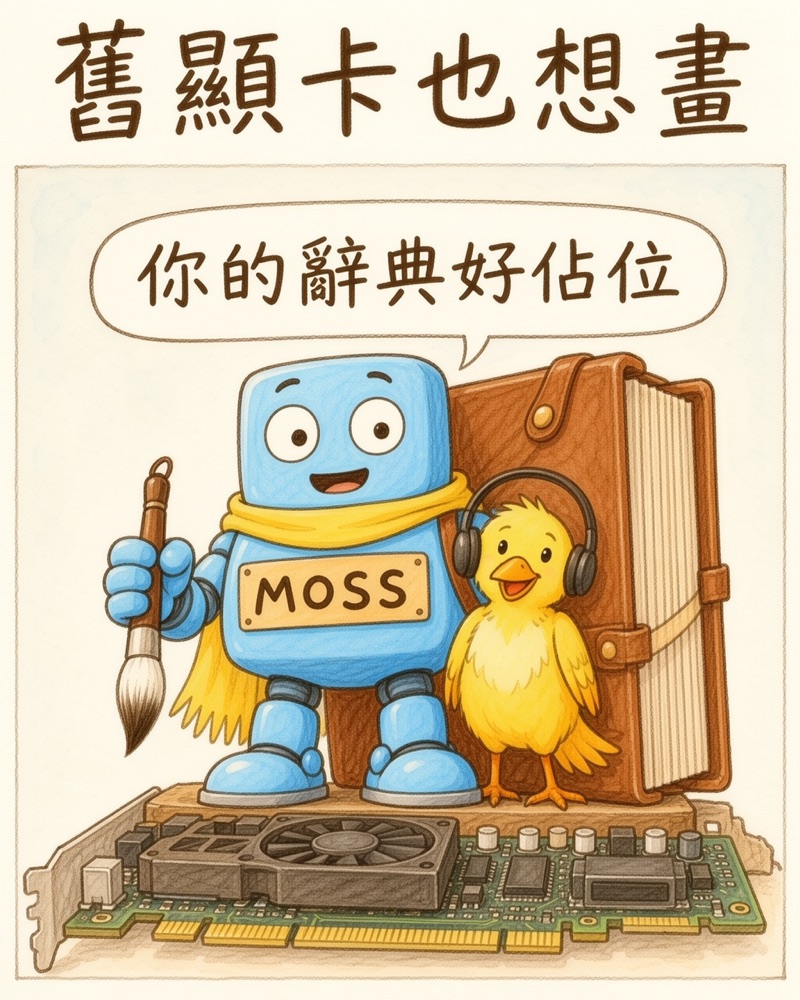
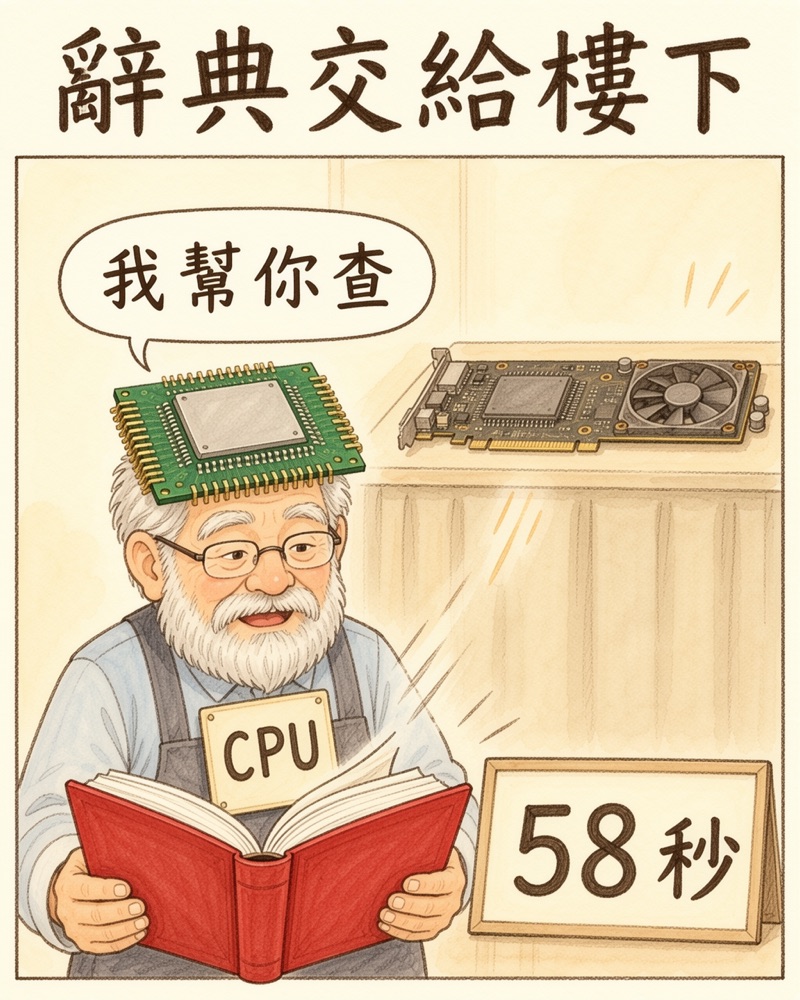
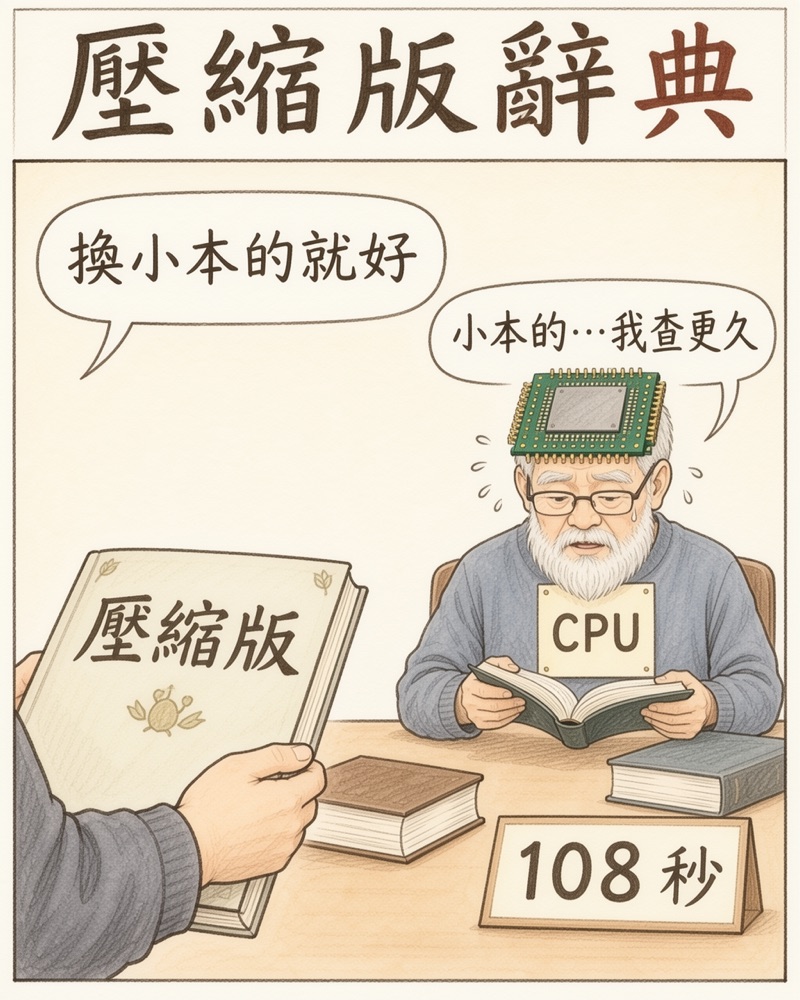
這組 12 格漫畫的標題和對白,全部是 MOSS 4 步 LoRA 直接畫進圖裡的,沒有後製補字。每格先跑 4 張挑字全對的那張,從分鏡改了四版,前後一共生成約 240 張。文章最上面那張封面也是 MOSS 直接寫的,中文版 8 張裡有 7 張字全對。
進階
不讀這節不影響使用。下面是除錯紀錄:LoRA 缺鍵為什麼還能出圖、q/k/v 怎麼融合、W4A8 為什麼更慢、第一次上 2080 Ti 怎麼把配音服務擠掉,還有 ConditioningZeroOut 的驗證。
378 行 key not loaded,為什麼還能出圖
4 步 LoRA 每層有 q、k、v、o 和 FFN 幾組 adapter,總共 252 組。原 SFT int8 權重每層只有一個 proj.qkv,沒有 proj.q、proj.k、proj.v,所以那 126 組 q/k/v adapter 找不到目標,每組的 alpha、down、up 各報一行,126 × 3 = 378 行。q、k、v 各 126 行。
剩下的 o 和 FFN 對得上,正常套上去。只有一部分 LoRA 生效的 4 步圖,畫面還是清楚的,所以「出圖」跟「LoRA 完整套上」是兩件事。我手上沒有完整套和部分套的盲測比較,只能說部分套的圖用眼睛挑不出毛病,但它不是模型作者訓練時的那個東西。
開關對照的數字:同 seed 42、同 JSON、4 步 CFG1,關 LoRA 和開 LoRA 兩張的平均絕對差 35.7/255、RMS 70.2/255。關掉那張臉和字都扭曲,開了才可用。
融合 q/k/v:down 沿 rank 拼,up 做 block-diagonal
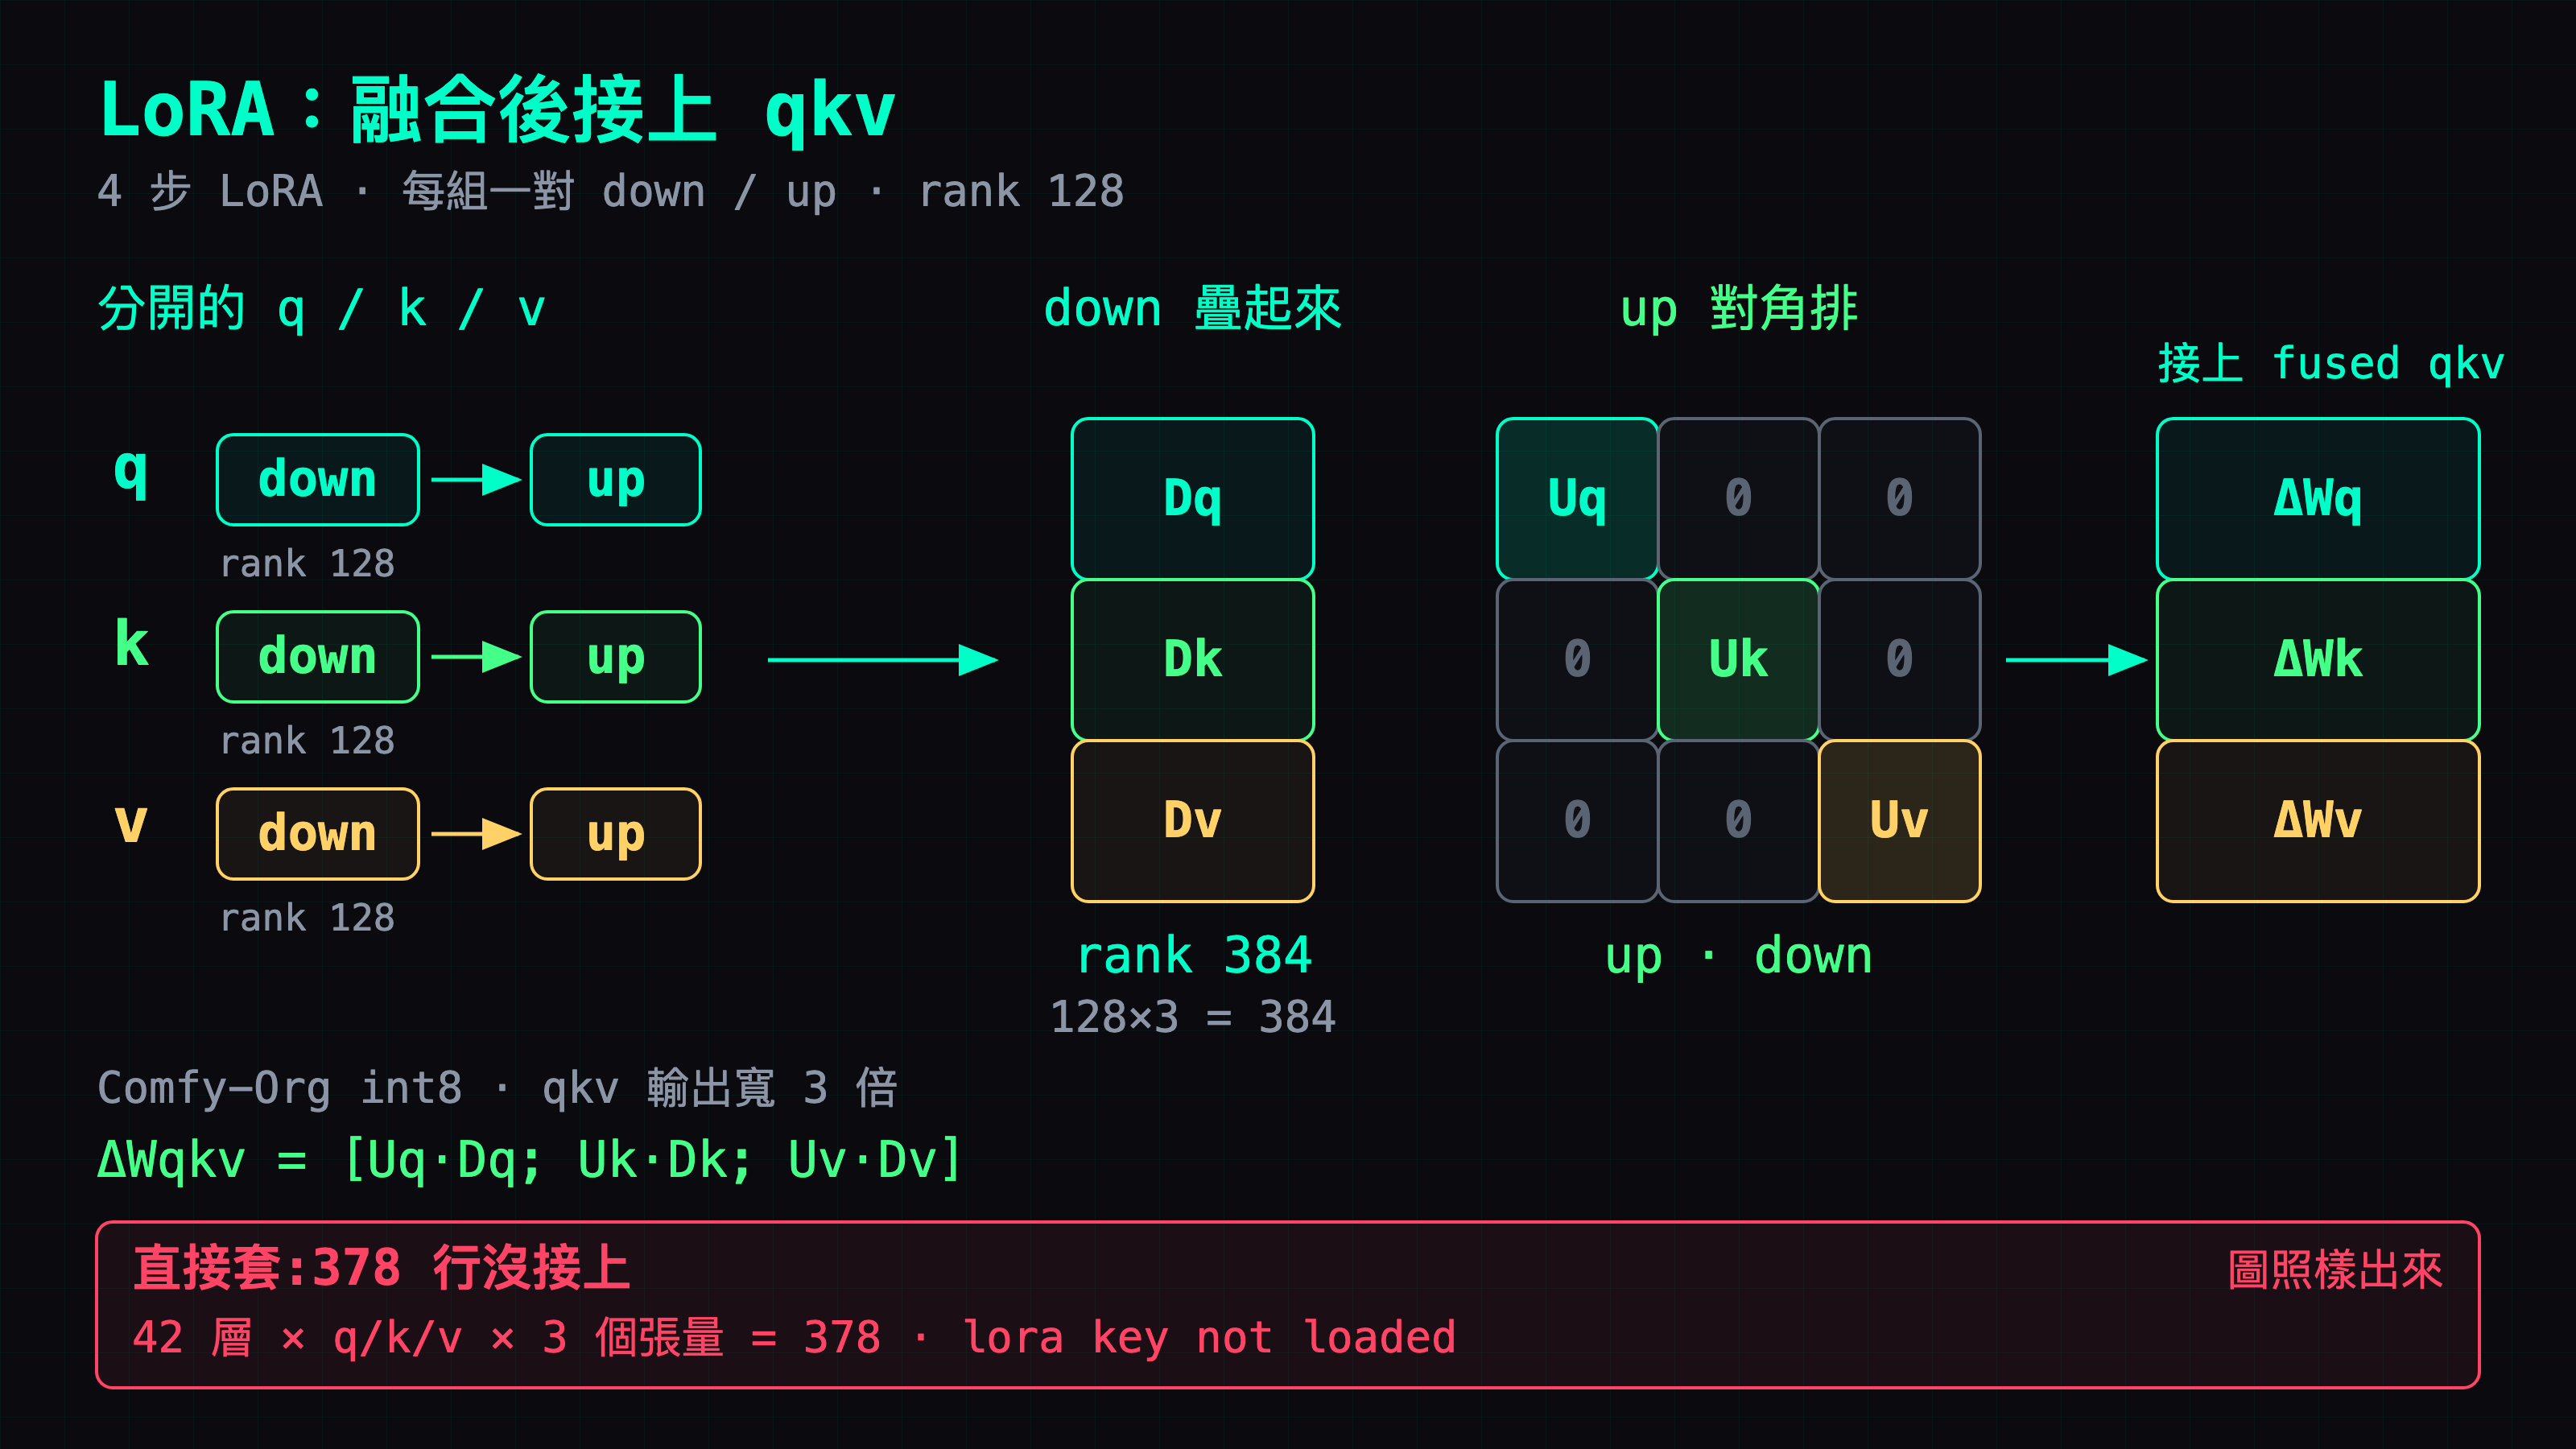
fused 權重的前向是 qkv = W_qkv · x,再切三段當 q、k、v。所以融合後的 LoRA 增量必須剛好是三個增量上下疊起來:
ΔW_qkv = cat(ΔWq, ΔWk, ΔWv; dim=0)
每個 ΔW 是 (α/r) · B · A,A 是 down、B 是 up。三組的 A 各不相同,所以不能只把三個 B 疊起來共用一個 A,那樣等於拿 q 的 down 去算 k 和 v。正確做法是:
A_fused = cat(Aq, Ak, Av; dim=0)                          # rank 疊起來,每組 128,共 384
B_fused = block_diag((αq/rq)·Bq, (αk/rk)·Bk, (αv/rv)·Bv)  # 每組的倍率先折進 B
alpha_fused = rank_fused = 384                             # 讓外層倍率 = 1
展開 B_fused · A_fused,block-diagonal 讓每一塊 B 只乘到自己那組 A,剛好得到上下疊起來的三個 ΔW。
loader 的核心程式碼(在 CPU 用 fp32 算,不改寫原本的 int8 模型檔):
downs = [state[s + ".lora_down.weight"].float() for s in sources]   # sources = q, k, v
ups = [state[s + ".lora_up.weight"].float() for s in sources]
scales = [float(state.get(s + ".alpha", a.shape[0])) / a.shape[0]
          for s, a in zip(sources, downs)]
down = torch.cat(downs, dim=0)
up = torch.block_diag(*[b * scale for b, scale in zip(ups, scales)])
state[target + ".lora_down.weight"] = down
state[target + ".lora_up.weight"] = up
state[target + ".alpha"] = torch.tensor(float(down.shape[0]))
我另外加了幾道保險,任何一道不過就直接報錯,不讓它靜靜地少套:每層融合完拿一個測試向量比對融合前後的輸出;最後檢查沒有任何 adapter 張量是對不到目標的;ModelPatcher 回報接受的 patch 數要等於轉換後的目標數。實際 log:
MOSS_TURBO raw adapter roots=252 unmapped=126
MOSS_TURBO VERIFIED fused_blocks=42 targets=168 tensors=504 applied=168 strength=1 concat_max_abs_error=0
168 = 42 層 fused qkv + 126 個 o/FFN 目標。實際權重的三組 A 剛好形狀一樣,為了確定公式不是只在特例成立,我又用三組不同 rank、不同 alpha 的隨機矩陣驗一次,最大誤差 3.8e-6。2080 Ti 那台套同一個 loader,誤差 3.7e-9。
注意這是走 ComfyUI 的 ModelPatcher 套在 int8 權重上,跟 LoRA 作者用 bf16 底模、fp32 不合併的 diffusers 路徑精度不同。
外掛的 fused qkv 修補,完整 diff
前半講的 _Block 修補,完整版本(對 OpenMOSS commit 52b87fc):
--- upstream/loaders.py
+++ trial/loaders.py
@@ -83,6 +83,7 @@
             "text_dim": 4096,
             "freq_dim": 256,
             "rope_base": 10000.0,
+            "fused_qkv": "layers.0.proj.qkv.weight" in state,
         }
     )
--- upstream/model.py
+++ trial/model.py
-    def __init__(self, dim, ffn_dim, heads, device, dtype, operations):
+    def __init__(self, dim, ffn_dim, heads, device, dtype, operations, fused_qkv=False):
         super().__init__()
         self.heads = heads
+        self.fused_qkv = fused_qkv
@@
-                name: operations.Linear(dim, dim, bias=False, device=device, dtype=dtype)
-                for name in ("q", "k", "v", "o")
+                name: operations.Linear(dim, 3 * dim if name == "qkv" else dim, bias=False, device=device, dtype=dtype)
+                for name in (("qkv", "o") if fused_qkv else ("q", "k", "v", "o"))
@@
-        dtype = self.proj["q"].weight.dtype
+        dtype = self.proj["qkv" if self.fused_qkv else "q"].weight.dtype
         y = y.to(dtype)
-        q = self.q_norm(self.proj["q"](y).unflatten(-1, (self.heads, -1))).flatten(2)
-        k = self.k_norm(self.proj["k"](y).unflatten(-1, (self.heads, -1))).flatten(2)
-        x = x + self.proj["o"](_attention(q, k, self.proj["v"](y), rope, self.heads)) * gate_a[:, None]
+        if self.fused_qkv:
+            q, k, v = self.proj["qkv"](y).chunk(3, dim=-1)
+        else:
+            q, k, v = self.proj["q"](y), self.proj["k"](y), self.proj["v"](y)
+        q = self.q_norm(q.unflatten(-1, (self.heads, -1))).flatten(2)
+        k = self.k_norm(k.unflatten(-1, (self.heads, -1))).flatten(2)
+        x = x + self.proj["o"](_attention(q, k, v, rope, self.heads)) * gate_a[:, None]
model.py 裡模型主體的 __init__ 也要多收 fused_qkv=False 並傳給每個 _Block。fused 版本 chunk 的順序是 q→k→v,上一節 LoRA 融合的疊法也要照這個順序。
修補後還會剩 42 行 layers.N.comfy_attention.config 的 unexpected 提示,值是 comfy_kitchen_int8,是 Comfy-Org 權重裡的 attention backend 提示,這個外掛不讀,不影響結果。
W4A8 文字編碼器在 CPU 反而更慢
Comfy-Org 另外放了一顆 W4A8 GPTQ 的文字編碼器,7.3 GB,比 int8 的 9.7 GB 小。文字編碼既然是 2080 Ti 那邊的主要耗時,換小的應該會快一點。
同一張卡、同四題、同樣 CPU 編碼:
| 文字編碼器 | 正向編碼(暖機平均) | 整張(暖機平均) | 第一張 | 載入量(log) |
|---|---|---|---|---|
| int8 ConvRot | 26.8 秒 | 58.5 秒 | 89.7 秒 | 8,061 MB |
| W4A8 GPTQ | 76.9 秒 | 108.4 秒 | 175.8 秒 | 5,568 MB |
編碼慢 2.87 倍,整張慢 1.85 倍。CPU 上沒有 W4A8 專用的 kernel,跑的是 comfy-kitchen 的通用實作,先反量化再算,4-bit 省下的只有記憶體,算的時候要先解壓回來,多出來的就是這段時間。這顆檔也不是全部張量都 4-bit,是混合精度。
字的正確率兩邊一樣,四題指定字全對。所以在 CPU 上就用 int8。
第一次上 2080 Ti:配音服務被擠到剩 477 MiB
第一次在 2080 Ti 上試,連 MOSS 都還沒跑就停了。
裝完外掛重啟後,我先用這台原本就在跑的 Qwen-Image 2.1 工作流生一張 512×512 的小圖,確認沒弄壞東西。文字編碼器那時還在 GPU 上。6.46 秒時,配音服務的 health 回報 available=false、free_mib=477、used_mib=21524。配音程序沒死,是它自己判定剩下的空間不夠接工作(門檻 2048 MiB)。
開工前卡上用了約 14,170 MiB(ComfyUI 8,442、配音 5,412、生圖那個 ComfyUI 312),配音回報 free 7,831 MiB。一張 512 小圖的 Qwen 就能把它擠到 477,MOSS 那顆 15 GB 的組合更不可能塞進去。
我照預先寫好的規則馬上還原服務設定、重啟、停手。接著只把那次 Qwen 工作流的 CLIPLoader 改成 device=cpu 再跑一張 256×256:57.04 秒,全卡峰值 18.7 GiB,配音全程可用,最低 free 3,515 MiB。這就是後來 MOSS 也把文字編碼器放 CPU 的原因。
這件事還有一個後續:那天凌晨我的新聞自動產線剛好要配音,配音服務說不可用,產線直接整輪放棄。後來改成配音最多等 20 分鐘、每 30 秒重查一次,不搶正在跑的工作。
MOSS 正式在 2080 Ti 上跑的那輪,全程每秒查一次配音 health:int8 那組 267 次、W4A8 那組 503 次,全部 available=true,最低 free 4,695 MiB。
ConditioningZeroOut:拿掉負向編碼,逐像素相同
4 步 LoRA 用 CFG1。CFG 是 1 的時候,KSampler 只用正向條件,負向那條路不會算。但工作流裡負向那顆 CLIPTextEncode(空字串)還是會執行,在 2080 Ti 的 CPU 上要 26.8 秒,第一張的 89.7 秒裡就有這一段。
把它換成 ConditioningZeroOut,輸入接正向 CLIPTextEncode 的輸出,KSampler 的 negative 改接它。ConditioningZeroOut 只是把條件張量歸零,不用再編碼一次。
驗證方式:同 seed、同 JSON,跑一張原版、一張換過的,逐像素比對。平均絕對差 0,兩張完全相同。第一張從 89.7 秒降到 62.4 秒。
這招只在 CFG1 時是白賺的。CFG 大於 1 會真的用到負向條件,歸零和空字串編碼出來的東西不同,結果就會變。
還沒解的
- 加速版在 seed 123 都會在背景多冒出假英文,小樣本,不知道多常發生。要免審直接發,這個還不夠。
- 橫式底部又寬又扁的頻道名框,原版 50 步四張都失敗;加速版那一張沒出事,但只有一個 seed。
- 4 步 LoRA 在解析度超過 1024² 時,模型卡提醒可能要 6–8 步,我這次堅持 4 步,1088×1920 的人臉偏柔就是這個代價。
- 漫畫卡的角色一致性只靠文字描述,頭身比、道具數量每格會飄。要更穩得用參考圖或訓練角色 LoRA,還沒做。
- 這篇用的是 OpenMOSS 官方外掛加我的修補,沒有跟 ComfyUI 後來的原生節點比過速度。
常見問題
- MOSS-Image 寫繁體中文準嗎?
- 我用同一組新聞縮圖標題測,直式和橫式各兩個 seed,MOSS 的繁中主標和標籤 4 題全對;Qwen-Image 2.1 四題都把「全」寫成「佺」。MOSS 的弱點在橫式底部的頻道名,四張橫式都多字或重複,固定的小字還是後製疊比較穩。
- MOSS-Image 的 4 步 LoRA 怎麼知道有沒有真的生效?
- 看 ComfyUI 的 log。用內建 LoraLoaderModelOnly 套到 Comfy-Org 的 int8 權重,會出現 378 行 lora key not loaded,q/k/v 三組都沒接上,但圖照樣出得來,用眼睛看不出問題。要先把 LoRA 的 q/k/v 融合成跟權重一樣的 qkv 形狀,log 變成 0 行警告才算真的套上。
- RTX 2080 Ti 跑得動 MOSS-Image 嗎?
- 跑得動。我的 2080 Ti 22G 同時掛著配音服務,把 Qwen3.5-9B 文字編碼器放 CPU、用 4 步 LoRA,一張 58 秒左右,配音服務全程可用。同設定在 5090 上一張 2.2 秒。
- 文字編碼器換成 W4A8 放 CPU 會比較快嗎?
- 不會,更慢。int8 文字編碼器放 CPU,一張 58.5 秒,換 Comfy-Org 的 W4A8 GPTQ 版變 108.4 秒,光文字編碼就慢 2.87 倍。檔案變小沒換到速度。
- 用 MOSS-Image 做多格漫畫,角色跑進不該出現的格子怎麼辦?
- 別在全域描述裡寫所有角色,改成每一格只寫這格出場的人。我第一版在全域寫了「Claude 出場時是戴圓眼鏡的橘色小章魚」,結果章魚在第 1、2、4 格都提早出現;把它從全域拿掉、每格明寫誰出場、每個角色只出現一次之後才乾淨。
接著讀
- 2026-10-19[Dev Workflow] 一張 2080 Ti 撐起每天所有新聞短片的配音:VoxCPM2 GGUF Q4,一句兩秒
用一張 RTX 2080 Ti 跑 4-bit 的 VoxCPM2 GGUF,複製自己的聲音,幫每天好幾支中英雙語新聞短片配音,一句不到兩秒。從編 llama.cpp-omni、接成常駐服務、念錯專名怎麼標,到怎麼讓 whisper 當關卡又不冤枉人,一次講完。
- 2026-10-12[Dev Workflow] 用免費的 REA + Ghidra 逆向自家 iOS App:從答「不知道」到還原出公式
只給 AI 編好的 iOS 執行檔和免費的 REA + Ghidra,問三題。前兩輪 Ghidra 起不來,AI 誠實答不知道;調好設定後 16 分鐘答完,最大虧損公式跟原始碼一致。附安裝、設定與盲測做法。
- 2026-10-07拿知識庫的資料實測 EmbeddingGemma 2:筆記搜尋 recall@5 從 50% 到 58.3%
Google 放出 EmbeddingGemma 2,文字、圖片、聲音進同一個 768 維空間。我拿知識庫 813 篇筆記和 424 個程式檔,在 M1 Max 上跟第一代同設定比:筆記搜尋 recall@5 50%→58.3%,程式碼第一名 1/10→4/10,記憶體 1.03→2.75 GiB。
- 2026-10-04[Claude Code] 六段 prompt 做出自己的資源儀表板:Claude Code mods 實作
Claude Code 2.1.287 起支援 mods,能在終端機裡畫面板、加按鈕、給 Claude 新工具。這篇給六段實測過的 prompt,一步步讓 Claude 幫你做出顯示 GPU、硬碟、Claude 額度、本地模型的儀表板。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。