AI Workflow · part 25
[Dev Workflow] 用免費的 REA + Ghidra 逆向自家 iOS App:從答「不知道」到還原出公式
❯ cat --toc
- 前言
- REA 是什麼:讓 AI 自己操作 Ghidra 的那座橋
- 盲測怎麼設計:AI 只拿到執行檔和 REA
- 結果:公式和資料來源答對,啟動流程漏了一段
- AI 還原的公式,跟我寫的那兩行一樣
- 它怎麼辦到的:函式名稱還在,這是簡單模式
- 想自己試:三節照著做
- 要準備的東西:Ghidra 12.1.4、Java 21、Node 24、REA 6.4.0
- 讓它跑得動:兩個環境變數
- 把自己的 App 編成執行檔
- 進階:三輪除錯紀錄
- 版本與時間
- 第一輪:Ghidra 沒起來,AI 三題都答「不知道」
- 卡在 Swift demangling 是怎麼看出來的?
- 沙盒裡為什麼還是 provider_timeout?
- 第三輪:拿掉沙盒,改成工具隔離
- 對答案時發現的兩件小事
- 這次沒驗到的
TL;DR
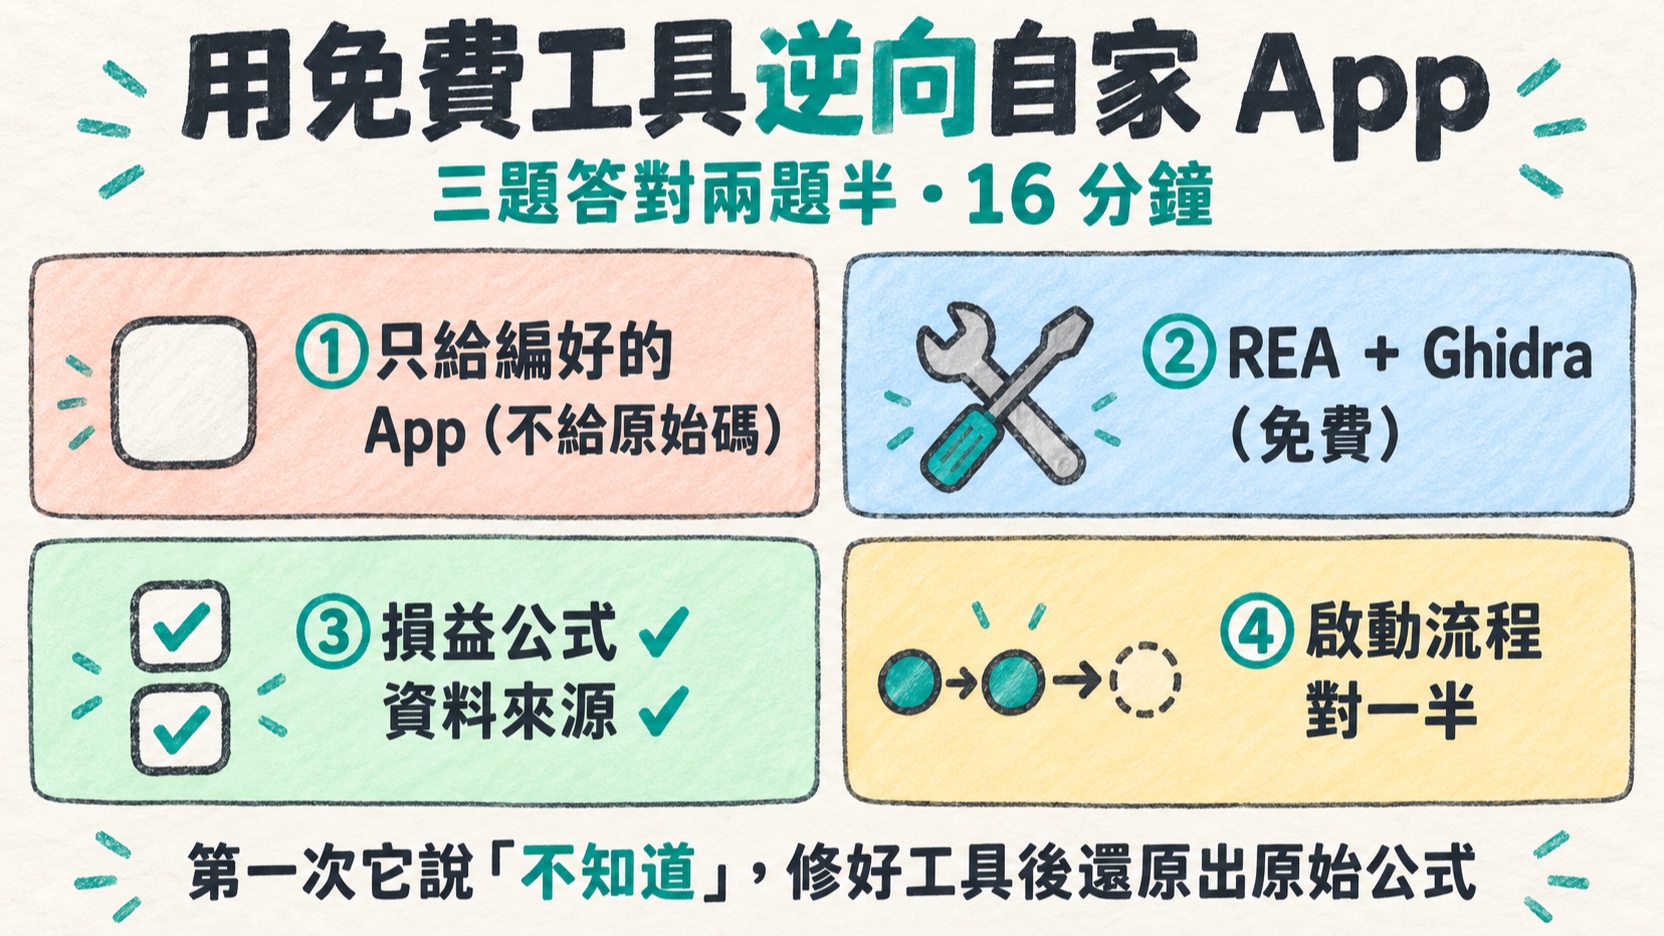
我把自己寫的 iOS App 編成執行檔,只給 AI 這一個檔案和免費的 REA + Ghidra,問三題。前兩輪 Ghidra 在沙盒裡起不來,AI 三題都答「不知道」,沒拿課本公式硬猜。調好兩個設定、改成只開 REA 一個工具之後,16 分鐘答完:最大虧損和損益平衡的公式跟我寫的原始碼一致,資料來源也對,啟動流程漏了部位頁打開後的背景更新。它靠 Ghidra 反編譯出來的函式和組語推,每題都附位址。限制:這個 App 還留著函式名稱,只測一個 App、三題。
前言
我看到 REA 的新聞時,它在 10 月 10 日破了 6 萬顆星。它做的事是讓 Claude Code、Codex 這類 AI agent 自己去操作逆向工具,打開一個編好的程式,一路查到裡面的函式。
我想知道的事很簡單:AI 不看原始碼,能不能讀懂一個 App?要驗這個,最好的材料是我自己寫的 App。原始碼在我手上,它答什麼我都對得出答案。
拿來拆的是我的 iOS App BPSTracker,一個記錄選擇權賣方部位(bull put spread)的工具。我只給 AI 編好的執行檔,問它三題:一筆部位的最大虧損和損益平衡怎麼算、資料從哪裡來、App 打開時依序做了哪些事。
REA 是什麼:讓 AI 自己操作 Ghidra 的那座橋
App 編好之後,原始碼就不見了,剩下的是一堆 CPU 指令。逆向工具做的事,是把這堆指令翻回人勉強讀得懂的樣子:組語(一行一個 CPU 指令),再往上一層是反編譯出來的虛擬碼(長得像 C,但變數名稱大多是機器取的)。
Ghidra 是美國國安局開源的逆向工具,免費。平常多半是人在介面上一個函式一個函式看。
REA 是一個 MCP server(MCP 是讓 AI agent 呼叫外部工具的一套規格)。它把 Ghidra 的能力包成一大串工具給 AI 用(這次我只開放其中 14 個):打開執行檔、列出概覽、搜函式名稱、搜字串、讀某個函式的虛擬碼和組語、查誰呼叫了誰。AI 自己決定要查哪裡,查到的每一段都附位址,可以回頭對。
REA 也支援 Hopper 和 IDA,這篇只用免費的 Ghidra。
盲測怎麼設計:AI 只拿到執行檔和 REA
平常用的話,setup 完直接在 Claude Code 或 Codex 裡叫它拆就好,不用像我這樣隔離。我要的是「AI 沒偷看原始碼」這件事站得住,所以多做了幾件事:
- 開一個全新的 Codex CLI session,不讀我的設定檔和規則,工作資料夾裡只有那個 arm64 執行檔。
- 只掛 REA 一個工具。 不能下 shell 指令、不能上網、不能讀檔。
- REA 的工具也再篩一次。 我在 REA 前面加了一層 guard,只放行 14 個分析工具,打開檔案的工具只准開那一個執行檔。REA 有幾個可以讀任意檔案的工具(讀 plist、讀封存檔之類),全部擋掉。
- 三個問題,每題要附 REA 查到的證據:函式位址、虛擬碼或組語片段。
原始碼在同一台電腦上,這個隔離是「AI 手上沒有能碰到它的工具」,不是作業系統層級把檔案鎖起來。後面的除錯紀錄還會碰到這個差別。
結果:公式和資料來源答對,啟動流程漏了一段
盲測從開始到交卷 16 分鐘,其中 3 分鐘是 Ghidra 第一次分析整個執行檔。我拿原始碼逐題對:
| 題目 | 判定 | 說明 |
|---|---|---|
| 最大虧損與損益平衡怎麼算 | 對 | 公式、單位、乘 100 都對 |
| 資料從哪裡來 | 對 | 這題先略過 |
| App 打開時做了哪些事 | 對一半 | 漏了部位頁打開後的背景更新 |
第三題它對的部分其實不少:資料庫是非同步載入、載完才顯示主畫面、先載商品再查權益、等 1.2 秒再用 0.4 秒動畫收掉開場畫面,這些順序都對。它也沒把幾條同時跑的工作硬排成一條線,寫明「這幾件事的完成順序沒有保證」,這點跟原始碼一致。
它漏的是部位頁那一段:頁面打開時會先更新篩選條件,抓完未平倉部位的價格之後,再啟動背景定時更新。它找到了抓價格那一步,漏了前面的更新篩選條件和最後的背景定時更新。
AI 還原的公式,跟我寫的那兩行一樣
這是盲測答案裡 AI 寫的公式(它標明這是從執行檔推回來的,不是原始碼):
width          = shortStrike - longStrike
最大虧損        = (width - credit) × contracts × 100
損益平衡股價     = shortStrike - credit
這是我寫在 PositionMetrics.swift 裡的兩行:
// Utils/PositionMetrics.swift:25  最大虧損
(width - position.creditValue) * Decimal(position.contractsValue) * 100
// Utils/PositionMetrics.swift:31  損益平衡
position.shortStrikeValue - position.creditValue
它不是只給公式。最大虧損那條,它找到算部位詳情的函式(位址 0x1000eac84),一行一行對出呼叫順序:讀 shortStrike、讀 longStrike、Decimal 減法、讀 credit、再減一次、讀合約數、乘起來、再乘 0x64,也就是 100。新增部位畫面的 calculatedMaxLoss(0x1000281c4)也是同一個算式。
單位它也講對了:credit 是每股的權利金,最大虧損要乘合約數和 100 才是整筆金額,損益平衡是股價,不乘。它還分出 credit(開倉收進來的錢)和另一個算未實現損益時用的買回成本是兩個不同的欄位。
最讓我在意的是它的措辭。算式裡沒有手續費,它的說法是「所查算式沒有手續費或佣金項」,後面接一句「不能據此宣稱整個 App 都不處理費用」。
它怎麼辦到的:函式名稱還在,這是簡單模式
這次能這麼順,很大一部分是因為函式名稱還在。AI 搜 maxLoss、breakeven 這種字就能直接找到函式,等於拿著目錄翻書。真正 strip 過的 App 大部分函式名稱都不在了,AI 得從字串和呼叫關係一點一點推,難度差很多,這次沒測。
另外兩個限制:
- 只有一個 App、三題。 這是一次實測,不是統計。
- 證據我逐段驗過。 AI 答案裡引用 REA 回傳的片段共 54 段,我拿 REA 的原始紀錄逐段比對,52 段逐字對上。另外 2 段是格式問題:一段函式名少打一個底線(它在下一句自己補了正確拼法),一段把換行的符號接到下一行。沒有一段是編出來的。
所以這篇能說的是:一個沒拿掉函式名稱的 Swift App,AI 只靠 REA + Ghidra,能把具體的商業邏輯推回來,而且推得對。 換成 strip 過的 App 或混淆過的程式,結果要另外測。
想自己試:三節照著做
要準備的東西:Ghidra 12.1.4、Java 21、Node 24、REA 6.4.0
要讓 AI 自己拆 App,需要三樣東西:負責拆的 Ghidra(它是 Java 寫的,所以要裝 Java)、讓 AI 能操作 Ghidra 的 REA(它是 Node 套件,所以要裝 Node),還有拿來編 App 的 Xcode。想自己跑一次的話,下面是我實際用的步驟。
我是在 MacBook 上跑的。這表看最後一欄,Node 那格最容易踩到:
| 東西 | 我用的版本 | 要注意的 |
|---|---|---|
| REA | 6.4.0(npm 套件 rea-agents) | 要 Node 22.19+、24.11+ 或 26+ |
| Ghidra | 12.1.4 PUBLIC | 從官方 GitHub release 下載 ZIP,對一下 SHA-256 |
| Java | OpenJDK 21 | brew install openjdk@21 |
| Node | 24.21.0 | 我系統上是 Node 25,不在 REA 支援範圍內 |
| Xcode | 27.0 | 編 App 用,順便借它的 swift-demangle |
Node 25 的問題我沒有去改系統預設。我另外下載 Node 24 的官方預編版放在旁邊,只在跑 REA 時把它放到 PATH 前面,其他東西照舊用 Node 25。
裝好之後跑 REA 的 setup,選你在用的 agent,analysis provider 選 Ghidra。它會問要不要裝 Hopper,不用的話拒絕就好:
npx rea-agents setup
npx rea-agents doctor   # 確認 Ghidra 找得到、準備好了
讓它跑得動:兩個環境變數
照預設設定,我的 App 分析到一半就卡住。差別在下面這段的最後兩行:
export GHIDRA_INSTALL_DIR=<你的 ghidra_12.1.4_PUBLIC 資料夾>
export JAVA_HOME=/opt/homebrew/opt/openjdk@21/libexec/openjdk.jdk/Contents/Home
export REA_ANALYSIS_PROVIDER=ghidra
export GHIDRA_HEADLESS_MAXMEM=4G

# Swift App 一定要設:讓 Ghidra 直接呼叫 Xcode 內建的 swift-demangle
export GHIDRA_SWIFT_DEMANGLER=/Applications/Xcode.app/Contents/Developer/Toolchains/XcodeDefault.xctoolchain/usr/bin/swift-demangle
# 第一次分析整個執行檔的時限;預設值對大型 App 太短
export REA_GHIDRA_STARTUP_TIMEOUT_MS=600000
Swift 編譯時會把函式名稱壓成一串亂碼似的字(像 $s10BPSTracker...),叫 mangled name。Ghidra 要把幾千個這種名字解回人看得懂的樣子,每個沒解過的名字都要叫一次外部的 demangle 程式。沒設 GHIDRA_SWIFT_DEMANGLER 的話,在 macOS 上它會退回 /usr/bin/swift,每次呼叫都要多繞一圈。我量過 20 次呼叫:預設那條路 0.92 秒,直接叫 Xcode 的 swift-demangle 0.079 秒,差 11.6 倍。
REA_GHIDRA_STARTUP_TIMEOUT_MS 是 REA 等 Ghidra 第一次分析完的時限,單位是毫秒。REA 的 README 也寫了大型執行檔要調這個。我在沒有任何限制的環境下單獨量過一次,Ghidra 第一次分析我的 App 花 237 秒,所以設 600 秒,留兩倍多的空間。
把自己的 App 編成執行檔
用 Release 組態編 iOS Simulator 版,不簽名:
xcodebuild -project BPSTracker.xcodeproj -scheme BPSTracker \
  -configuration Release -sdk iphonesimulator \
  -destination "generic/platform=iOS Simulator" \
  -derivedDataPath ./build \
  CODE_SIGNING_ALLOWED=NO CODE_SIGNING_REQUIRED=NO

# .app 裡的執行檔同時包了好幾種 CPU 架構,只抽 arm64 那一份給 AI
lipo <.app 裡的執行檔路徑> -thin arm64 -output BPSTracker-arm64
編好之後我檢查了一件事:符號有沒有被拿掉。Release 版照理會 strip,但我的專案設定沒有真的執行那一步,執行檔裡還留著 8,293 個 BPSTracker 自己的 Swift 符號,也就是函式和屬性的名稱都還在。這點會影響結果,後面講。
進階:三輪除錯紀錄
不讀這節不影響使用。這裡是前兩輪失敗的經過和完整參數,給想自己重跑、或卡在同一個地方的人和 AI 參考。
版本與時間
| 項目 | 值 |
|---|---|
| REA | 6.4.0(npm rea-agents) |
| Ghidra | 12.1.4 PUBLIC,官方 ZIP(20260921 build),SHA-256 與 GitHub release asset digest 相符 |
| Java | OpenJDK 21.0.10(Homebrew) |
| Node | 24.21.0 官方 darwin-arm64 預編版;系統 Node 25.2.1 未改 |
| Xcode | 27.0 |
| 盲測 agent | Codex CLI 0.162.1,codex exec,reasoning effort high |
| 執行檔 | Release、iOS Simulator、未簽名、arm64 slice;18,553 個 arm64 符號,其中 8,293 個是 App 自己的 Swift 符號 |
| strip 設定 | STRIP_INSTALLED_PRODUCT=YES,但 DEPLOYMENT_POSTPROCESSING=NO、COPY_PHASE_STRIP=NO,實際沒 strip |
時間(分鐘):
| 步驟 | 時間 | 備註 |
|---|---|---|
| 安裝 Ghidra / Node / REA | 29.7 | 跟 build 有重疊,不能相加 |
| xcodebuild | 1.5 | |
| Ghidra 首次分析(沙盒外單獨量) | 約 4.0(237 秒) | 已設 GHIDRA_SWIFT_DEMANGLER |
| 第三輪盲測總長 | 16.19 | 一次就過 |
其中第一個 binary_overview | 3.14 | 24.8 秒開始、213.4 秒回來 |
其中 close_binary 存證據 | 約 0.2 | 796.6→809.3 秒,存下 102 筆 Evidence |
第三輪的完整逾時參數:REA_GHIDRA_STARTUP_TIMEOUT_MS=600000、Codex 端 MCP tool_timeout_sec=660、Ghidra headless -analysisTimeoutPerFile 1200、GHIDRA_HEADLESS_MAXMEM=4G。其中 -analysisTimeoutPerFile 是我改 REA 的 Ghidra 啟動腳本加上去的,REA 預設沒有每個檔案的分析時限;加它是為了讓 Ghidra 的自動分析不會無限跑下去。另外盲測本身設了 28 分鐘自動中止,外面再包一層 29 分鐘強制結束,這輪都沒觸發。
第一輪:Ghidra 沒起來,AI 三題都答「不知道」
第一輪我把盲測的 Codex 包在 macOS 的 Seatbelt 沙盒(sandbox-exec)裡,讓它在作業系統層級讀不到原始碼資料夾。開跑前測過:沙盒內讀 Xcode 專案、讀 build 產物都被擋,讀那個 arm64 執行檔可以。
REA 成功打開執行檔、認出是 arm64 Mach-O,接著第一個要 Ghidra 出力的查詢 binary_overview 就失敗:
provider_timeout
operation: list_documents
timeout_ms: 600000
重試一次換成搜函式名稱,回的是 execution_failure、Ghidra client is already started。最後關閉時:
cleanup_incomplete
Ghidra process cleanup was incomplete:
process table could not be inspected: spawn EPERM
當時這台 MacBook 同時在算兩支 Remotion 影片,load average 大約 18,Java 只分到 1–3% 的 CPU。
AI 的三題答案全是「未知」。第一題它是這樣寫的(盲測答案原文):
最大虧損公式、損益平衡公式、金額單位、合約乘數、credit 如何計入,以及 credit 與成本的差別,均未取得二進位證據;因此不以標準金融公式代填。
這是分析工具失敗,不表示二進位沒有這些功能。
bull put spread 的最大虧損公式是任何選擇權教科書都有的東西,它要猜的話一定猜得中。它沒猜,把「工具壞了」和「答案是什麼」分開講。我差點以為 REA 這工具不能用,回頭看這兩句才確定問題在工具鏈,不在 AI。
卡在 Swift demangling 是怎麼看出來的?
第二輪先把沙盒拿掉,單獨跑一次 open_binary → binary_overview,看 Ghidra 到底要多久。
用預設設定,Ghidra 跑了好幾分鐘都還停在 Swift demangling 那一步,我手動停掉。Ghidra 的 SwiftDemangler README 寫明它先看 GHIDRA_SWIFT_DEMANGLER 環境變數,沒設就依序試 /usr/bin/swift-demangle、/usr/bin/swift。macOS 沒有前者,所以走到 /usr/bin/swift demangle,那是 Xcode 的轉接程式,比直接叫 swift-demangle 慢得多。
量 20 次呼叫:
| 呼叫方式 | 20 次耗時 |
|---|---|
/usr/bin/swift demangle | 0.9227 秒 |
Xcode toolchain 的 swift-demangle | 0.0795 秒 |
設好 GHIDRA_SWIFT_DEMANGLER 之後,同樣在沙盒外,binary_overview 237.3 秒完成。這個數字就是後面設 600 秒時限的依據。
沙盒裡為什麼還是 provider_timeout?
設好 demangler、把逾時調大(這輪 REA 啟動時限一度調到 1,500,000 毫秒),再放回 Seatbelt 沙盒跑盲測,還是 provider_timeout,關閉時一樣 spawn EPERM。其中一發跑到 37.24 分鐘被時限停掉,沒產出答案。
從 spawn EPERM 看得很清楚:REA 收尾時要開一個 child process 去查 process table,確認 Ghidra 有沒有關乾淨,這一步被沙盒擋下。另一個 stderr 訊息 failed to walk skills root ... Operation not permitted 也是沙盒擋的,跟分析失敗無關。
provider_timeout 我不敢說百分之百是沙盒害的。沙盒外 237 秒能完成、沙盒內 10 分鐘以上起不來,但第一輪同時還有機器滿載的因素。第三輪拿掉沙盒後,約 151 秒時抽樣 Java CPU 是 19.6%,這只是單一一次量測,不能當成因果證明。
第三輪:拿掉沙盒,改成工具隔離
既然盲測的 Codex 本來就沒有 shell、沒有網路、沒有讀檔工具,沙盒能多擋的東西其實有限,卻會擋到 REA 自己要做的事。第三輪改成在工具這一層隔離:
codex exec --ignore-user-config --ignore-rules --ephemeral \
  -C <只放 arm64 執行檔的資料夾> --json ...
Codex 設定:project_doc_max_bytes=0、web_search=disabled,關掉 shell_tool、unified_exec、apps、memories、hooks、multi_agent、browser_use、computer_use 等功能,MCP 只掛 REA,enabled_tools 列 14 個工具。
REA 前面那層 guard 在 tools/list 和 tools/call 兩邊都只放行白名單裡的工具:
open_binary, close_binary, binary_session, binary_overview,
search_procedures, search_strings, analyze_function,
read_function_instructions, procedure_references, xrefs,
find_xrefs_to_name, inspect_native_dispatch_metadata,
inspect_analysis_view, get_evidence_bundle
open_binary 只接受那一個執行檔,不准讀回先前存的分析快照;close_binary 只能寫到固定的檔名。inspect_plist、inspect_keyed_archive、inspect_binary_layout、import_evidence_bundle、compare_source_to_bundle 這類能讀任意檔案的工具全部拒絕。
這種隔離的限制要講清楚:它管的是 AI 能呼叫什麼,不是作業系統權限。REA、Ghidra 這些程式本身還是用我的使用者權限在跑。另外盲測的 Codex 是雲端模型,REA 查到的分析內容會送到 OpenAI 那邊推理,這不是完全離線的分析。
這輪沒有 provider_timeout,也沒有 spawn EPERM,16.19 分鐘、一次跑完。過程中有一次 analyze_function 的回覆太大,超過 MCP 的傳輸上限,AI 改讀已存下的分析結果,沒有重跑。
對答案時發現的兩件小事
反編譯出來的參數不一定可信。 Ghidra 對部位頁抓價格那一段顯示的是 _fetchPricesForOpenPositions(true,param_2),原始碼實際傳的是 forceRefresh: false。AI 的答案沒有根據這個值下結論,但如果你要拿虛擬碼裡的常數推斷程式行為,要先回頭看組語。
第一題漏講的部分。 原始碼另外有算已實現損益的公式,(credit − 平倉價) × 合約數 × 100。我問的是最大虧損和損益平衡,它沒去找這條,不算錯。
這次沒驗到的
- 沒有 strip 過的執行檔、沒有混淆過的程式。
- 沒有實際執行 App,只看靜態的執行檔。
- 沒有試 Hopper 和 IDA。
- 只有一個 App、三題、一次成功的盲測。
常見問題
- 不給原始碼,AI 真的看得懂一個 iOS App 嗎?
- 在我自己的 App 上,三題答對兩題半:最大虧損和損益平衡的公式跟原始碼一致,資料從哪裡來也答對,啟動流程對一半,漏了部位頁打開後的背景更新。這個 App 是沒拿掉函式名稱的 Release 版,屬於簡單模式;只測一個 App、三題。
- REA + Ghidra 要花錢嗎?要裝哪些東西?
- 不用錢。REA 是開源的 npm 套件(我用 6.4.0),Ghidra 是美國國安局開源的逆向工具(我用 12.1.4)。另外要 Java 21 和 Node 24;REA 支援 Node 22.19+、24.11+、26+,Node 25 不在範圍內。
- REA 回 provider_timeout,AI 一直答不知道怎麼辦?
- 代表 Ghidra 在時限內沒準備好(匯入、分析或跟 REA 接上線,其中一步超時)。先在沙盒外單獨跑一次量時間;Swift App 把 GHIDRA_SWIFT_DEMANGLER 指到 Xcode 內建的 swift-demangle,再把 REA_GHIDRA_STARTUP_TIMEOUT_MS 調到量到時間的兩倍以上。如果 agent 包在 macOS 的 sandbox-exec 裡,還會碰到 spawn EPERM。
- 整個流程要多久?
- 裝 Ghidra、Java、Node、REA 加編 App 大約 30 分鐘。調好之後的盲測一次 16 分鐘,其中 Ghidra 第一次分析整個執行檔佔 3 分鐘左右。
接著讀
- 2026-07-17[Dev Workflow] 幫 AI agent 的 skill 減肥:193 個塞爆 2% 預算,砍到剩 7 個
AI Workflow 系列第 15 篇。某天早上我讀 codex 紀錄,滑到一行:skill 描述被剪短,才塞得進 2% 的 context 預算。我共用的 root 累到 193 個 skill,全載進去撐爆上限,每條描述都被截斷——我天天在用的,被剪掉是為了替我從不碰的一百多個騰位子。這篇講怎麼用 per-agent allowlist(不是刪)砍到 7 個、薄殼配深引擎壓低每個 skill 的載入成本,再用一個閘門加稽核加可逆退場區守住,不讓它肥回去。
- 2026-07-16[Dev Workflow] 一群 AI 交接工作卻不用重講:原來是同一套系統的兩條軸
這是 AI Workflow 系列裡『兩軸合流』這一段的收尾。回頭看整段路,前面六篇其實在蓋同一套系統的兩條軸:持久知識(我知道什麼,長效、要用再查)和即時狀態(我現在做到哪,易逝、隨時寫)。這篇講清楚兩條軸為什麼互不代替、怎麼匯流到『多 AI 交接』、又受同一套哲學管——以及那條讓一群不完全信任的模型還能安全協作的中心律:沒有收據就不信。
- 2026-02-26[Dev Workflow] 讓兩個 AI 吵架。它們不同意的地方才是重點。
一個 /debate 指令讓 Codex CLI 和 Gemini CLI 對同一份程式碼互相辯論。訓練資料不同、盲點不同——它們的分歧通常是最有用的輸出。
- 2026-02-26[Claude Code] 用 Claude Code 測 iOS App:context 用量砍 81%
把截圖導向的 iOS 測試改成 ui_describe_all 優先,BPS Tracker 測試的 context 用量從 81,290 KB 降到 15,215 KB。外加 Fastlane 整合:截圖、App Store 上傳全自動。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。