AI Workflow · part 29
[AI Workflow] 讓 TTS 念對台灣讀音:念法表從 3 條長到 80 條,再讓 g2pW 自動抓破音字
❯ cat --toc
TL;DR
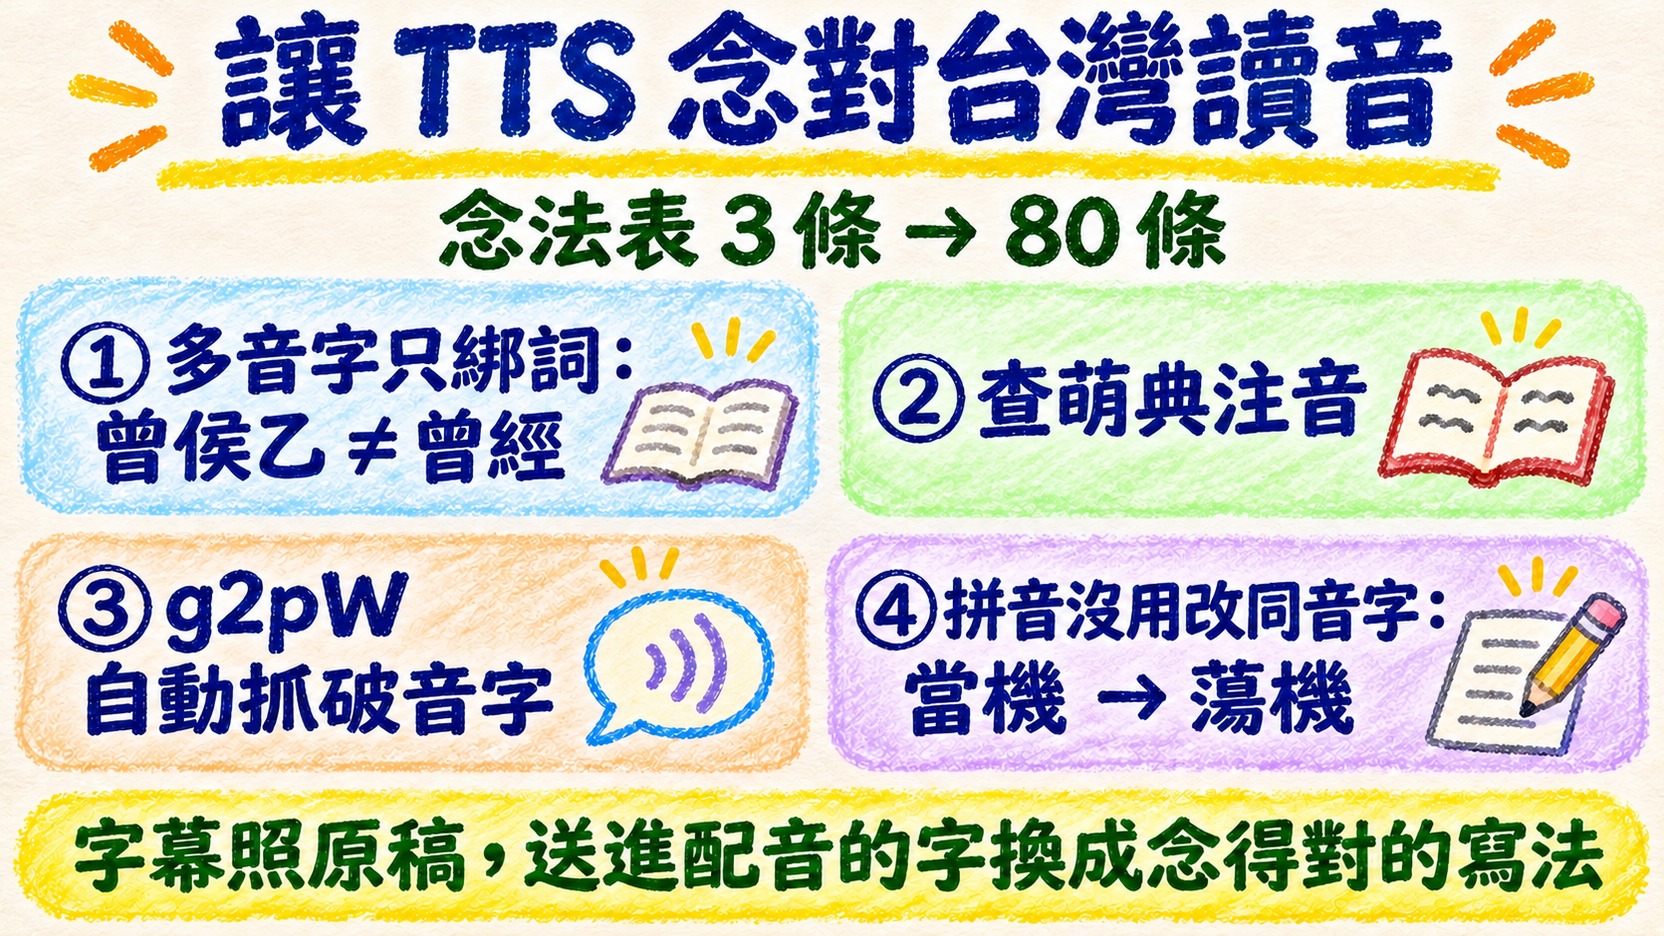
我用 VoxCPM2 配中文旁白,常念成大陸讀音或念錯字:模型庫念成「模型哭」、門檻的檻沒聲音。我的做法是一張所有配音流程共用的念法表,配音前再用 g2pW 自動判讀。念法表從 10-19 的 3 條長到 11-04 的 80 條。g2pW 依上下文預測台灣讀音,跟大陸讀音不同的字才自動標拼音;破音字只綁詞,拼音標了沒用就改同音字。拼音標記不保證有效,每條還是要親耳聽過。
前言
「模型庫」念成「模型哭」,「門檻」的檻整個沒聲音。
我每天用 VoxCPM2(一個開源的文字轉語音模型)幫新聞短片配中文旁白,念的是我自己的聲音。上一篇講怎麼把它裝在一張 2080 Ti 上、怎麼用 whisper 把配音轉回文字、跟原稿比對,抓漏字和念錯。那之後兩週每天配,最常出事的已經不是英文專名,是一般中文字:模型念得出聲音,只是念成大陸那邊的讀音,或乾脆念錯。觀眾一聽就出戲。
一開始的做法很笨:聽到念錯,記一條規則,重配。規則越堆越多,模型照樣錯。「步驟」我 10-13 就加了修正,到 10-19 還是念錯。
現在換成兩件事:一張所有配音流程共用的念法表,加上配音前用 g2pW 自動找出「台灣讀音跟大陸讀音不一樣」的字。念法表從 10-19 的 3 條長到 11-04 的 80 條。跟以前差在兩個地方:表只有一份,每條配音流程讀同一份;很多破音字在配音前就被標出來,不用等我耳朵聽到。
這篇前半是照著做就能用的做法,後半是一陣子聲音變遠的調查,還有現在的配音關卡。
念法表:一份 JSON,所有配音流程都讀它
格式就是「稿子裡的字 → 送進 TTS 的寫法」,存成一個 JSON 檔(純文字的資料格式,用任何文字編輯器都能改)。下面是我表上真的有的幾條:
{
  "entries": {
    "庫": "酷",
    "檻": "砍",
    "企業": "氣業",
    "發難": "發{nan4}",
    "帳本": "{zhang4}本",
    "當機": "蕩機",
    "曾侯乙": "{zeng1}侯乙",
    "儲存": "{chu2}{cun2}",
    "NVIDIA": "Nvidia",
    "AI": "A I"
  }
}
配音前,程式把稿子裡出現的詞換成右邊的寫法再送進 TTS。字幕永遠用原稿,觀眾看到的還是「模型庫」,TTS 拿到的是「模型酷」。
右邊只放三種東西:
- 親耳確認過的修正:「庫→酷」「企業→氣業」這種同音字,或「發難」寫成
發{nan4}這種只把錯的那個字換成拼音。 - VoxCPM 官方的讀音標記:中文寫帶調拼音
{xun4}{lian4},英文寫 CMU 音標{AH0 P AE1 CH IY0}。標記是取代原字,不是加在旁邊。寫法看官方文件。 - 數字和版本號的中文念法:「2.0→二點零」。
表要共用。 我的配音流程不只一條:新聞短片、說明動畫、單句重配各有一條。以前每條各抄一份修正,改一個字要同步好幾處,漏掉的那條就繼續念錯。現在只有一份 lexicon.json,每條流程執行時都讀它。
專名跟數字不要預先放。 順序是先照原字送、換 seed 重抽幾次,都不行才寫進表。上一篇講過,大部分英文專名和數字 VoxCPM2 自己念得出來;標記加太多本身也會出事,後面全形標點那節有例子。
表是這樣長起來的:
| 日期 | 條數 |
|---|---|
| 10-19 | 3 |
| 10-27 | 33 |
| 11-01 | 38 |
| 11-03 凌晨 | 42 |
| 11-03 晚上 | 80 |
10-19 那 3 條是知識、步驟、LINE(念「賴」)。11-03 開始查萌典之後,同一天就從 42 條長到 80 條,到 11-04 寫這篇時還是 80 條。
破音字只綁詞:寫「曾侯乙」,不寫「曾」
曾侯乙的「曾」念 zēng。如果表上寫的是單字 "曾": "{zeng1}",下一支片稿子裡出現「曾經」,也會跟著變成 zēng 經。所以表上寫的是整個詞 "曾侯乙": "{zeng1}侯乙",「曾經」不受影響。
同樣的道理,「嗆」有 qiāng、qiàng 兩個音,我的表上沒有單字「嗆」,有的是「嗆你」「被嗆」「嗆人」「嗆聲」「嗆回去」五條。
我表上最早那幾條是單字條目,像「檻→砍」。後來查萌典才知道檻還有一個 jiàn 的音(欄杆的意思),新聞稿很少碰到,我先留著。你自己建表的話,破音字一開始就綁詞,單字條目只留給只有一個音、模型卻常念歪的字。
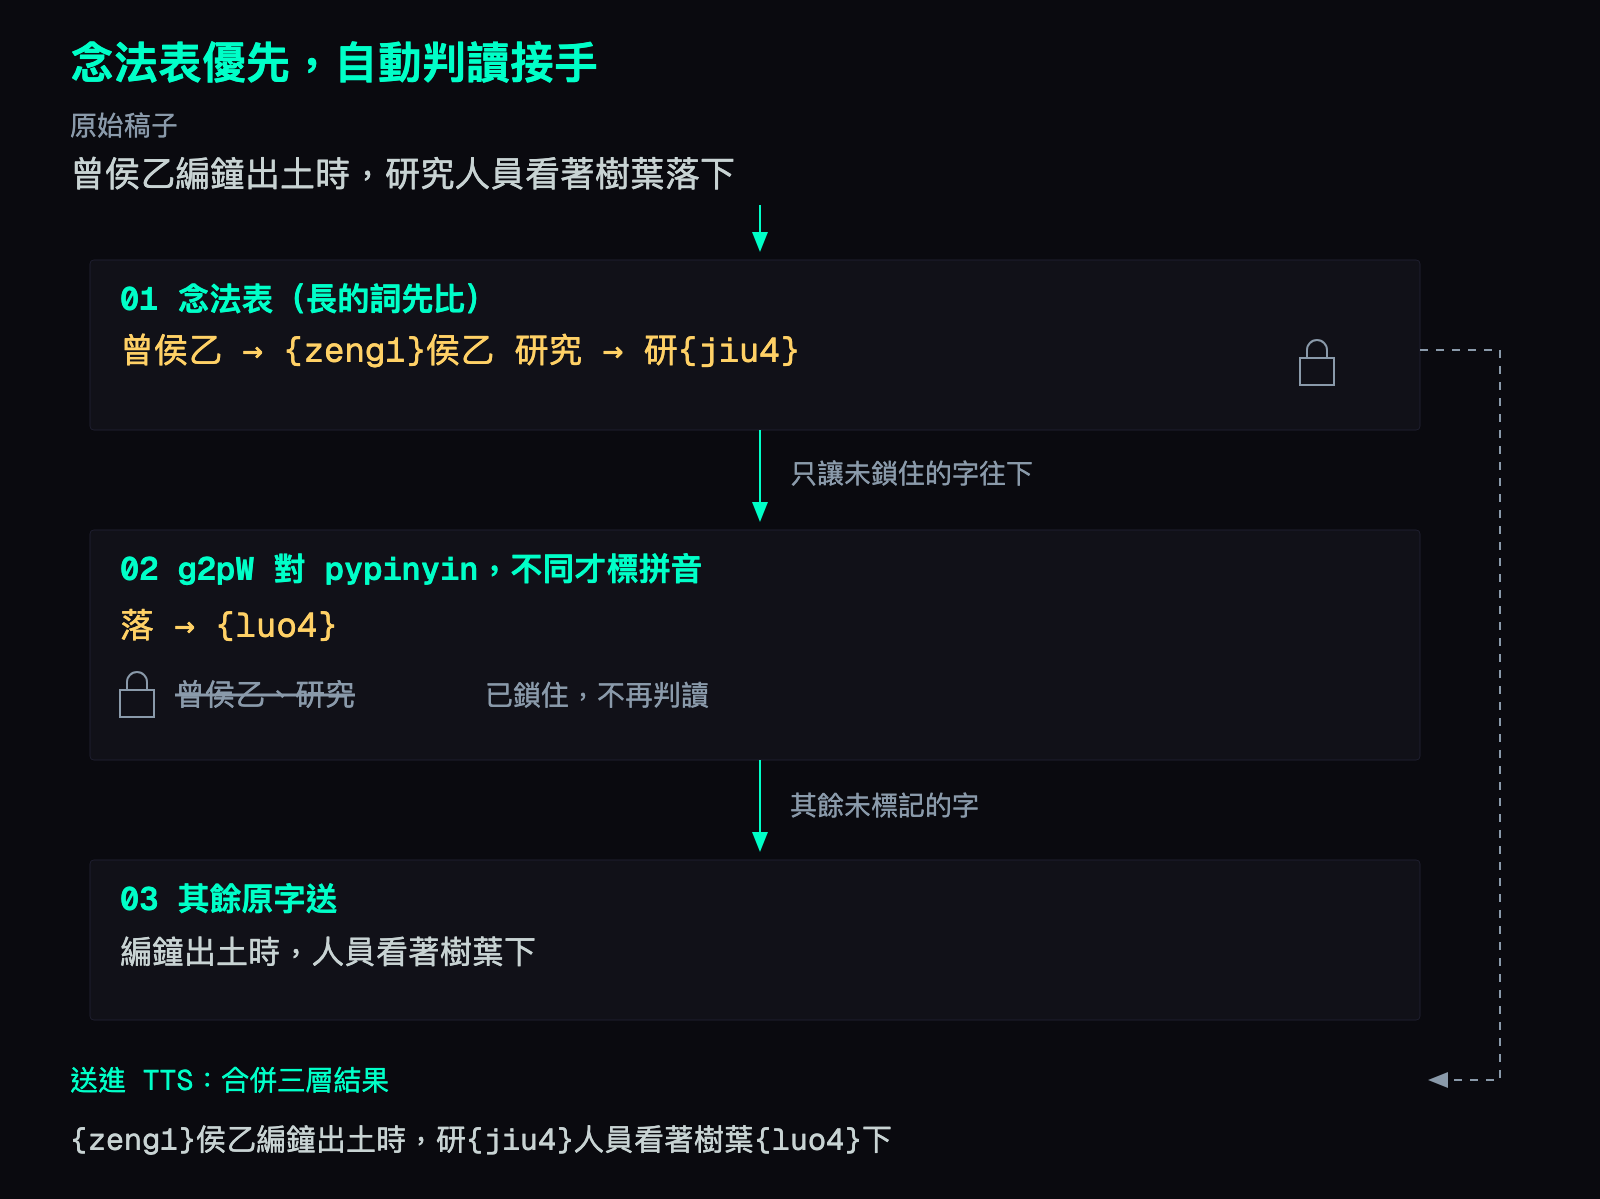
一句話裡如果同時對到好幾條,程式的比法是長的詞先比,比到就整段換掉,換過的字不會再被短的詞碰到。下面是那段程式,不寫程式的話記住這句規則就好:
def lexicon_spans(text):
    taken = [None] * len(text)
    for k in sorted(LEX, key=len, reverse=True):   # 長的詞先比
        start = text.find(k)
        while start != -1:
            if all(t is None for t in taken[start:start + len(k)]):   # 這段還沒被別的詞佔走
                for j in range(start, start + len(k)): taken[j] = (k, start)
            start = text.find(k, start + 1)
    return taken
被念法表換過的字,後面的 g2pW 也不會再碰。念法表永遠蓋過自動判讀。
拿不準的字,先查萌典
稿子裡有破音字或罕用字,配音前我先查教育部的辭典。萌典有一個免費的 JSON 介面,網址後面直接接字或詞:
curl -s "https://www.moedict.tw/uni/曾" \
  | python3 -c 'import json,sys; [print(h["bopomofo"], h["pinyin"]) for h in json.load(sys.stdin)["heteronyms"]]'
ㄗㄥ zēng
ㄘㄥˊ céng
heteronyms 就是這個字的每一個讀音。「曾侯乙」整個詞萌典查不到,查單字「曾」會列出兩個音,再看上下文挑對的那個,寫成 {zeng1}。
辭典的讀音我直接信,查到就可以寫進表,不用每條都先配出來聽。只有配出來還是念錯,才走後面的三版試聽。萌典網頁版也能查,一次查一兩個字用網頁比較快。
g2pW 自動判讀:台灣讀音跟大陸讀音不同的字才標
萌典要我自己想到去查。一支片八、九句,我不可能每個字都懷疑一遍,所以配音前加一層自動判讀,用的是 g2pW。
g2pW 是一個開源的中文讀音預測模型,用 Python 裝起來就能用:丟一句中文進去,它回你每個字的拼音,而且會看上下文決定破音字念哪個音。pypinyin 是另一個 Python 套件,做的事一樣,但它是查字典,給的是大陸讀音。
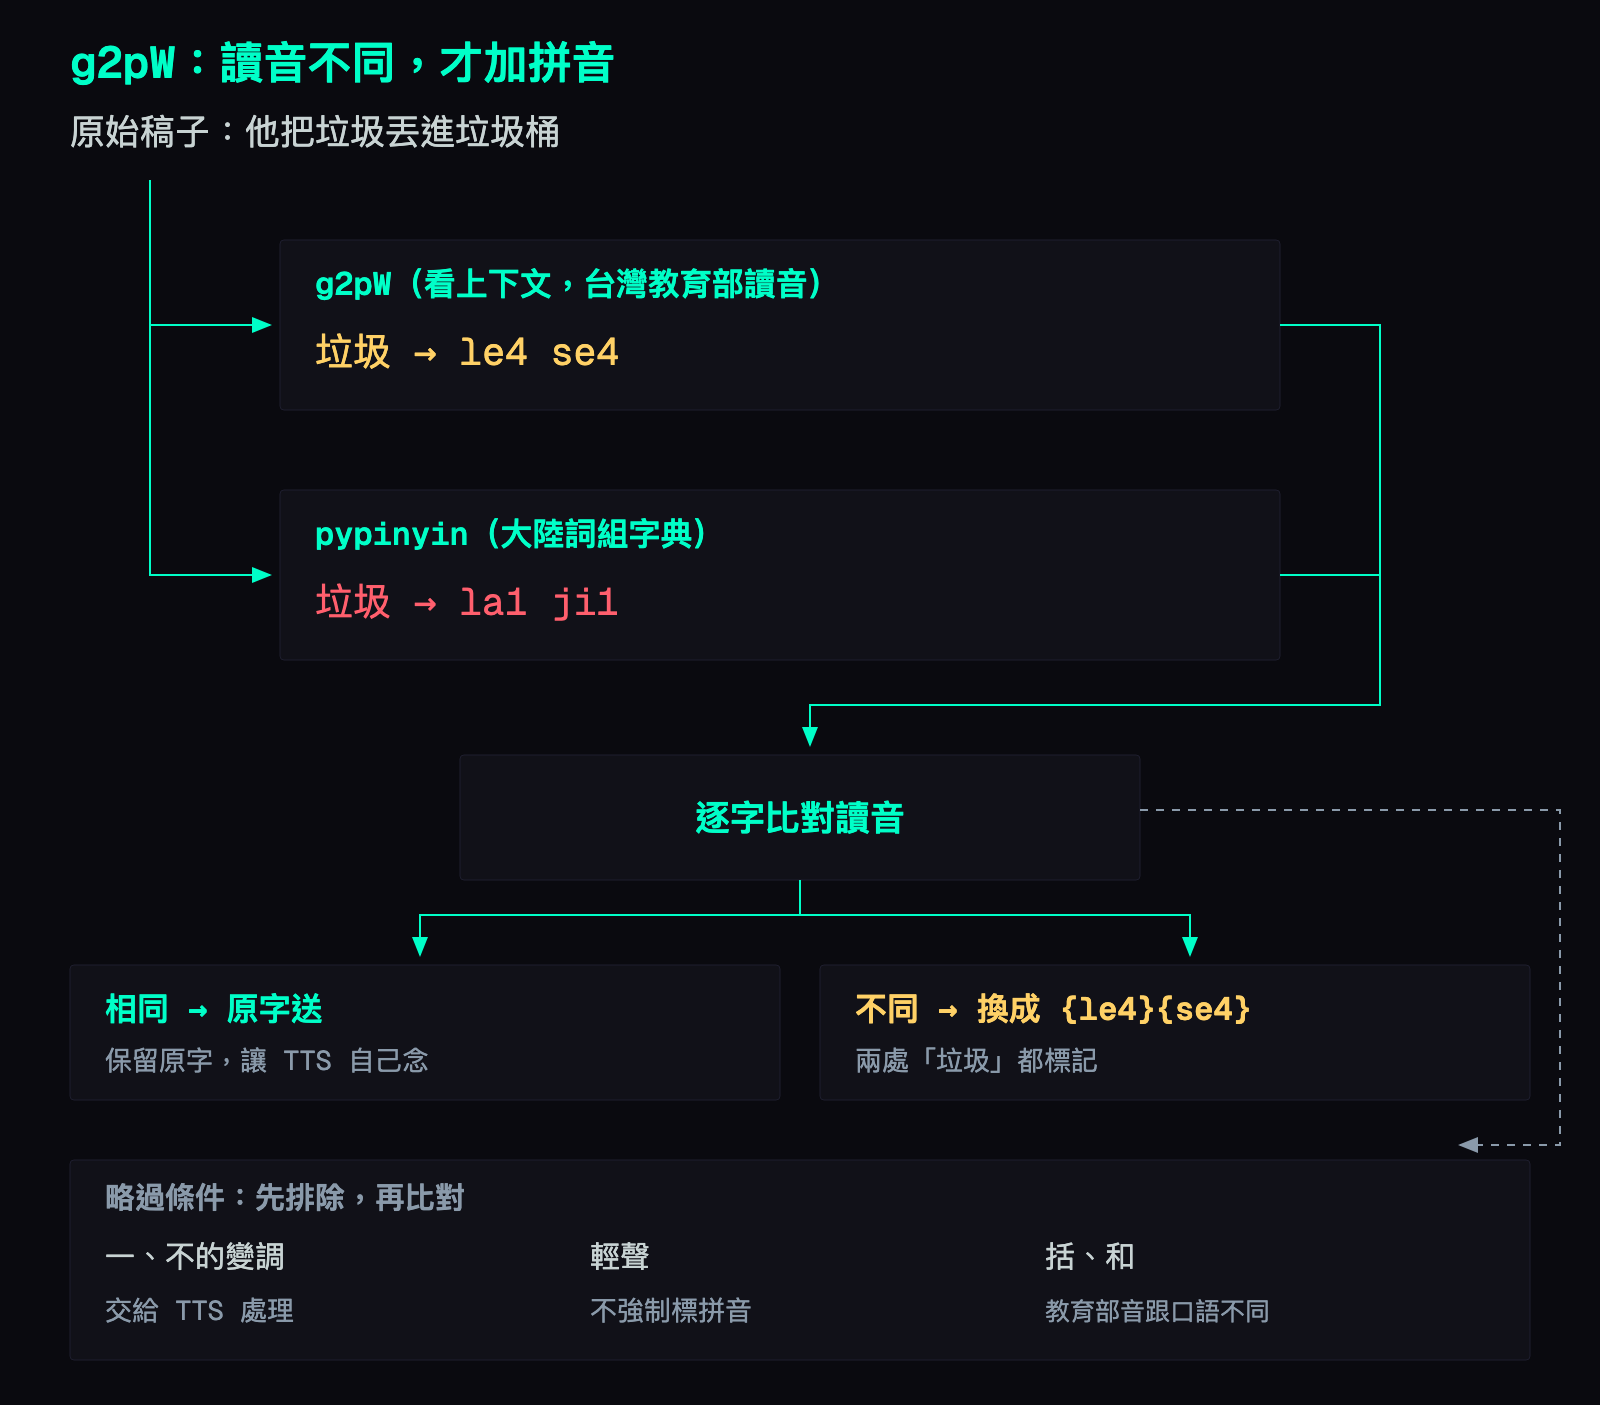
原理是拿兩個讀音比:
- g2pW 看整句上下文,預測每個字的台灣讀音(它是用台灣的語料訓練的)。
- pypinyin 查詞語字典,給的是大陸讀音。我拿它當「TTS 可能會猜的音」的基準。
兩邊一樣,就不標,讓 TTS 自己念;兩邊不一樣,才把那個字換成 {拼音}。只標「TTS 很可能猜錯」的那幾個字,不會整句塞滿拼音。
下面是核心程式,不寫程式的話可以跳過,它做的事就是上面那兩條比對(pypinyin 的詞語字典是簡體,所以先轉簡體再查):
simp = T2S.convert(text)
base = [x[0] for x in pinyin(simp, style=Style.TONE3, neutral_tone_with_five=True, errors=lambda s: list(s))]
# ...
ch, r = text[i], reading[i]   # r 是 g2pW 的台灣讀音
d = base[i]                   # d 是 pypinyin 的大陸讀音
if r and ch not in SANDHI | COLLOQUIAL and d and not r.endswith('5') and r != d:
    say.append('{' + r + '}'); tags.append([ch, r, d])
else:
    say.append(ch)
# 省略:轉簡體後長度變了、拼音對不齊時,整句不標
三種字刻意不標:
- 一、不:變調 TTS 自己會處理。
- 輕聲:
r.endswith('5')那個條件。 - 括、和:教育部的音(guā、hàn)跟日常口語不一樣,標了反而怪,交給 TTS。
實際跑一次。我把兩句丟進去,--show 會列出它標了哪些字、原本的大陸讀音是什麼:
echo '["曾侯乙編鐘出土時,我曾經在現場。","他把垃圾丟進垃圾桶,研究人員看著樹葉落下。"]' | ./g2pw_tag.py --show
2 垃:le4(預設la1) 圾:se4(預設ji1) 垃:le4(預設la1) 圾:se4(預設ji1) 落:luo4(預設la4) | 他把{le4}{se4}丟進{le4}{se4}桶,研{jiu4}人員看著樹葉{luo4}下。
第一句沒有印出來,因為曾侯乙已經被念法表換掉,「曾經」兩邊都是 céng,不用標。第二句的 研{jiu4} 也是念法表換的,不在 g2pW 的清單裡。
11-03 我拿幾個難字試過:曾侯乙的 zēng、落下的 luò、垃圾的 lèsè、薄 bó、微 wéi、研究的 jiù,g2pW 都判對;pypinyin 在曾、落兩個字給的是大陸那邊的音,這兩個字就是會被標出來的地方。
g2pW 的模型約 606 MiB,用 CPU 跑就好,不用跟 TTS 搶顯卡。它標錯或標了沒用的字,就照下面「改同音字」那節試出有效的寫法,再寫進念法表,下次表會先蓋過它。
為什麼在文字這頭判,不在聲音那頭聽?因為我試過的開源工具都聽不出配音的聲調,用 whisper 轉帶調拼音時,整個詞連聲調都判對的只有 4–5%,細節在進階那節。
標了拼音還念錯:改同音字,或乾脆寫原字
拼音標記不保證有效。我遇過三種狀況:
- 當機:標
{dang4}{ji1}配出來還是念錯,改寫同音字「蕩機」就對了。 - 倒鉤:拼音版一樣沒用,最後選同音字「到勾」。
- 炸:標
{zha2}的四次生成,四次都念成「抓」;直接寫原字「炸」,第一次就念對。
另外「橋」我做過盲聽,同音字「喬」聽起來最好。
所以要修一個字的時候,我做三版試聽:拼音標記、同音字、原字,打散成 A、B、C,聽完選一個再寫進表。我在手機上聽,手機打不開 wav,所以每版做成一張字卡加聲音的 mp4,只標「要聽哪個詞」。一個字從我說要改到寫進表、只重配那一句,大約 30 秒。
送進 TTS 的字:全形標點,常用字別亂標音
這條是踩到才知道的。11-03 有一支片的片尾句,稿子裡是半形的 , 和 ?,又在兩個常用字上加了 {hai2}、{wei4}。配出來前半句整段聽不懂,聽寫回來是「別在得去安的平安系」。
標點改成全形、把那兩個標音拿掉,一次就念對。
兩條規則:
- 送進 TTS 的字一律全形標點。
- 常用字不要亂加標音。g2pW 只標讀音有分歧的字,就是為了不在常用字上亂加。
同一個道理,聽寫抓不到某句時,別把整句都換成拼音。我試過一次整句補拼音,重配出來那句聲音變遠。現在一句最多補三個詞。
英文:全大寫的變數改小寫,逐字母念的縮寫留大寫,別放句首
稿子裡寫到程式的環境變數或旗標,常常是全大寫。原樣送進去會被一個字母一個字母念,或念爛:PARALLEL 實測聽寫回來是「PARLL」。改成小寫就照英文單字念。
這表看右欄就好:
| 稿子裡 | 送進 TTS |
|---|---|
PARALLEL | parallel |
ROUND_ROWS | round rows(底線換空格) |
DRY_RUN | dry run |
CUDA | cuda(念成一個字的縮寫也送小寫) |
GPU、TTFT | 不動(本來就逐字母念) |
字幕和畫面照原樣。念法表上的「NVIDIA→Nvidia」「AI→A I」也是同一類:前者讓它念成一個字,後者讓它拆開念兩個字母。
英文詞別放句首。 「overlay 要先登入⋯」我抽了 10 次,聽寫 10 次都是 Orly、AURAL;改成「這個 overlay 要先登入⋯」,4 次全對。
配音前照這個順序跑一遍
- 寫稿:英文詞別放句首,一句最多一個很長的型號名稱。
- 換念法表:長的詞先比,破音字只綁詞。
- g2pW 標剩下的字:台灣讀音跟大陸讀音不同才標。
- 標點換全形,常用字不加標音。
- 配完聽:念錯的做拼音、同音字、原字三版試聽,選定寫回念法表。
第 5 步寫回去的每一條,下一支片會先套上,不用再從頭找一次。
進階
不讀這節不影響使用。下面是一陣子聲音變遠的調查、配音關卡的一個漏洞、現在的語速關卡,還有試過沒用的兩條路。
字都念對,聲音卻變遠:Q4 那條路線偶發整句崩壞
10-20 我覺得配音的音調跑掉、聲音很遠。那陣子剛好換了跑配音流程的機器,我第一個懷疑是換機器。
我量了 10 支片、30 句,每句看三層:TTS 原始輸出、後處理(去頭尾靜音、響度正規化)之後、成片裡那一段。
離群最明顯的是 CopilotKit 那支的第 2 句:
| 第 2 句 | 前後句 | |
|---|---|---|
| 原始輸出響度 | -32.2 LUFS | 約 -17 LUFS |
| 頻譜質心 | 1717 Hz | 約 500 Hz |
| 音高(F0 中位數) | 159 Hz | 約 120–129 Hz |
LUFS 是響度單位;頻譜質心越高,聲音的能量越偏向高頻;F0 就是音高。這句一生出來就小聲、偏尖、偏高,後處理的響度正規化把它連同底噪一起拉大,聽起來就「很遠」。
而這句的字錯誤率是 0.083,照樣通過關卡。 字念對,不等於聲音對。
換機器這個嫌疑先排掉:兩台機器的參考錄音 sha256 一樣,送的確實是同一段;混音沒有改音量或播放速度,成片跟後處理那一段的 cosine 相似度 ≥0.9992。
真正的差別在配音路線。早期的片是 PyTorch 跑,同時送提示錄音和參考錄音(prompt + reference);後來換成 GGUF Q4(四位元量化版),生成方式也換成 continuation,讓模型接著參考錄音往下念。時間剛好跟換機器重疊。
接著盲聽 6 段,打亂順序、不先講預期:
- 判「很怪」的 2 段都是 Q4:CopilotKit 第 2 句(很遠)、GLM-Omni 第 2 句(音調跑掉,3 秒後聽不懂)。
- 另外 2 段 Q4、2 段 PyTorch 都判正常。
所以 Q4 路線不是整體變差,是偶發整句崩壞,而且這兩句都已經發布了。我把正式配音改回 Q8(八位元量化版),Q4 期公開的 14 支中文片用 Q8 重配,共 109 句,字錯誤率平均 0.076。
還沒確認問題有多少來自 Q4、有多少來自 continuation。要拿同一份稿子,一次只改其中一項來比,這個測試我還沒做。
現在正式在用的是用我自己的聲音微調過的 Q8 版。要確認跑的是哪一版,看配音服務 /health 回的檔名,我不在文章或規則裡寫死版本。前一篇連到 Hugging Face 的 Q4_K_M 檔,我已經換下來,改放另外幾種量化配方(保護層 4-bit、Q5_K_M、Q6_K),那幾版還沒進正式配音。
後來補了一條自動檢查:一句的高頻占比 ≥0.08,而且頻譜質心是同片其他句的 2 倍以上,就自動重配一次,還是離群就標成待聽,不擋片。校準時 118 句正常句誤判 0 句,但它漏掉一句音色變了、聲學數字卻正常的,樣本也少,還沒獨立驗證。
配音關卡的漏洞:聽寫混進參考錄音的原文,照樣判通過
10-28 做一支長片時,有一句的某次生成,聽寫回來混進了參考錄音的逐字稿(「這個詞聽不懂沒關係⋯我們開始」那段)。配音關卡照樣判它通過。
上一篇提過同類的事:語氣 A/B 時有一段把參考錄音的逐字稿也念了出來。這次是在正式產線上,關卡沒擋。
那支片最後 45 句,我另外用 whisper 全部重新轉錄一遍,再搜尋參考錄音裡的關鍵字,才放心。關卡該加的是兩條:聽寫比原稿長很多就擋,聽寫裡出現參考錄音的句子就擋。10-28 發現時這兩條還沒進關卡。如果你也用「參考錄音加逐字稿」的 clone 模式,自己的關卡記得補。
語速關卡:不准變速,每句跟本集中位數差 10% 以內
11-04 定下的規則:
- 禁止變速。不准用
atempo、rubberband或任何方式把聲音加速、減速去塞舊的時間格。畫面和字幕跟著聲音走,單句重配也要照新的長度重排。 - 每句量音節/秒:中文一字一音節,
{拼音}一個算一音節;英文按音節估,縮寫照字母念(W 算三音節)。用 10 ms 的 RMS ≥ -45 dBFS 找第一個和最後一個有聲的片段,去掉頭尾靜音,句中的停頓保留。 - 跟本集同語言所有句的中位數比,±10% 以內。超過就用完全相同的文字換 seed,最多再抽 4 次,選最接近中位數的那次。最後檢查時沿用挑版本當下鎖定的語速基準(11-04 那集是每秒 5.497382 音節);4 次都不過就停下來等我聽。
另外一關是標拼音的位置要逐字對:把 {拼音} 跟原字對齊,聽寫在那個位置必須是原字或同音同調的字。幫我{zha2} 聽成「幫我抓」一定要擋,就算整句粗篩和語速都過;聽成「炸」「閘」「札」「紮」「鍘」都算對。缺字、對不上位置,也判不合格。
一般沒有標記的句子,只粗篩整句是不是念得不知所云:忽略標點、簡繁統一之後,相似度 ≥ .48 才過,不為了英文專名的辨識細節去重抽。
試過沒用的:微調和聲調判讀工具
這次微調沒解決讀音。 我用自己 4.5 分鐘的錄音做過 LoRA 微調,三版盲聽 10 句沒有一致的贏家;「知識」只有一版念對,「步驟」三版都念成 zhou,我要的是 ㄗㄡˋ。後來在正式配音上做 A/B,8 句裡微調版勝 3、原版勝 1、差不多 4,正式配音後來換成了微調版,但「步驟」這類讀音沒有因此變對,還是靠念法表。
聲調判讀工具判不了配音。 我想過在聲音那頭自動抓聲調:
- MFA 強制對齊:這是把逐字稿跟錄音時間對齊的工具。我拿它分辨聲調,但它的中文模型沒有替不同聲調分開建模,聲調只判對 2/4,等於用猜的。聲母韻母的差別分得出來(垃圾、訓練、資安 4/4),步驟的 zòu/zhòu 沒過。這組的正向對照用的是 eSpeak 合成的音,不是 VoxCPM。
- whisper 轉帶調拼音做聲調 A/B:eSpeak 62.5%、VoxCPM 72%,自由解碼時整個詞聲調全對只有 4–5%。
- tonara:50–63%。
三個都沒接進產線。這就是為什麼這篇的做法全在文字那頭:配音之前把字換對,比配完再判聲調可靠。
同系列:一張 2080 Ti 撐起每天所有新聞短片的配音 · 40 行讓 whisper 當裁判:AI 生出來的配音,咬字到底有沒有壞
常見問題
- 中文 TTS 老是念成大陸讀音或念錯字,怎麼辦?
- 把念錯的詞整理成一張念法表,配音前先把稿子裡的詞換成表上的寫法再送進 TTS,字幕不動。表上只放三種東西:親耳確認過的修正、VoxCPM 官方的拼音或 CMU 讀音標記、數字的中文念法。我的表從 10-19 的 3 條長到 11-04 的 80 條。
- 破音字要怎麼寫進念法表?
- 只綁詞,不綁單字。曾侯乙的曾念 zēng,就寫「曾侯乙→{zeng1}侯乙」;如果綁單字「曾」,「曾經」也會跟著變成 zēng。拿不準的字先查萌典,教育部辭典的讀音可以直接當成確認過的念法寫進表。
- g2pW 怎麼幫 TTS 判斷台灣讀音?
- g2pW 會依上下文預測每個字的台灣讀音,我拿它跟 pypinyin 給的大陸讀音比,兩邊不同的字才自動換成 {拼音} 標記。一、不的變調和輕聲略過,念法表上已經有的詞優先。模型約 606 MiB,用 CPU 跑。
- 標了拼音 TTS 還是念錯,怎麼辦?
- 改寫同音字,或乾脆送原字。當機標 {dang4}{ji1} 還是念錯,改寫「蕩機」就對;炸標 {zha2} 四次都念成「抓」,直接寫「炸」第一次就對。我會做拼音、同音字、原字三版試聽,聽完選一版再寫進表。
- 全大寫的英文被一個字母一個字母念出來,怎麼辦?
- 環境變數、旗標這類全大寫單字送小寫,底線換空格,例如 PARALLEL 改 parallel、DRY_RUN 改 dry run。GPU、TTFT 這種逐字母念的縮寫維持大寫。CUDA 要念成一個字,也送小寫。字幕照原樣。
- 配音字都念對,聲音卻變遠、音調跑掉,是什麼問題?
- 我遇到的是 Q4 那條配音路線偶發整句崩壞。出問題的那一句,響度、頻譜質心、音高都跟前後句差很多,字錯誤率 0.083 卻照樣通過關卡。盲聽 6 段,判很怪的 2 段都是 Q4,所以我把正式配音改回 Q8。
接著讀
- 2026-10-19[Dev Workflow] 一張 2080 Ti 撐起每天所有新聞短片的配音:VoxCPM2 GGUF Q4,一句兩秒
用一張 RTX 2080 Ti 跑 4-bit 的 VoxCPM2 GGUF,複製自己的聲音,幫每天好幾支中英雙語新聞短片配音,一句不到兩秒。從編 llama.cpp-omni、接成常駐服務、念錯專名怎麼標,到怎麼讓 whisper 當關卡又不冤枉人,一次講完。
- 2026-09-11[Dev Workflow] 你的聲音,24 秒就能複製:MacBook 上的 Qwen3-TTS 教學
預設 TTS 的聲音不是你的聲音。24 秒錄音加十行 Python 就能 zero-shot clone,MacBook 本機跑得動,不用 GPU 機也不用訓練。
- 2026-10-24[Dev Workflow] 會寫繁體中文的開源生圖模型:MOSS-Image 從測試到做出漫畫卡
MOSS-Image 繁中標題 4 題全對,Qwen-Image 2.1 同題把「全」寫成「佺」。在 RTX 5090 從一張 37 秒加速到 2.2 秒、在 2080 Ti 舊卡跟配音服務共用,最後做成四格漫畫社群卡,安裝、加速、踩坑一次講完。
- 2026-10-22[Claude Code] 把 AI 員工做成 JRPG 隊伍:Codex 一週 212 張工單一眼看出來
我用 Claude Code mods 把手上的 AI 席位畫成像素風 JRPG 隊伍:誰在工作就演工作動畫,點進去有力量、智力、敏捷、耐力、魔力。做完第一個發現是 Codex 一週接了 212 張工單。附開源 repo 與做法。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。