AI Workflow · part 24
拿知識庫的資料實測 EmbeddingGemma 2:筆記搜尋 recall@5 從 50% 到 58.3%
❯ cat --toc
- 前言
- EmbeddingGemma 2 多了什麼:同一個 768 維空間放進圖片和聲音
- 我怎麼測:拿 LOG 的一行話,看它能不能找回對應筆記
- 想自己重跑:核心程式碼
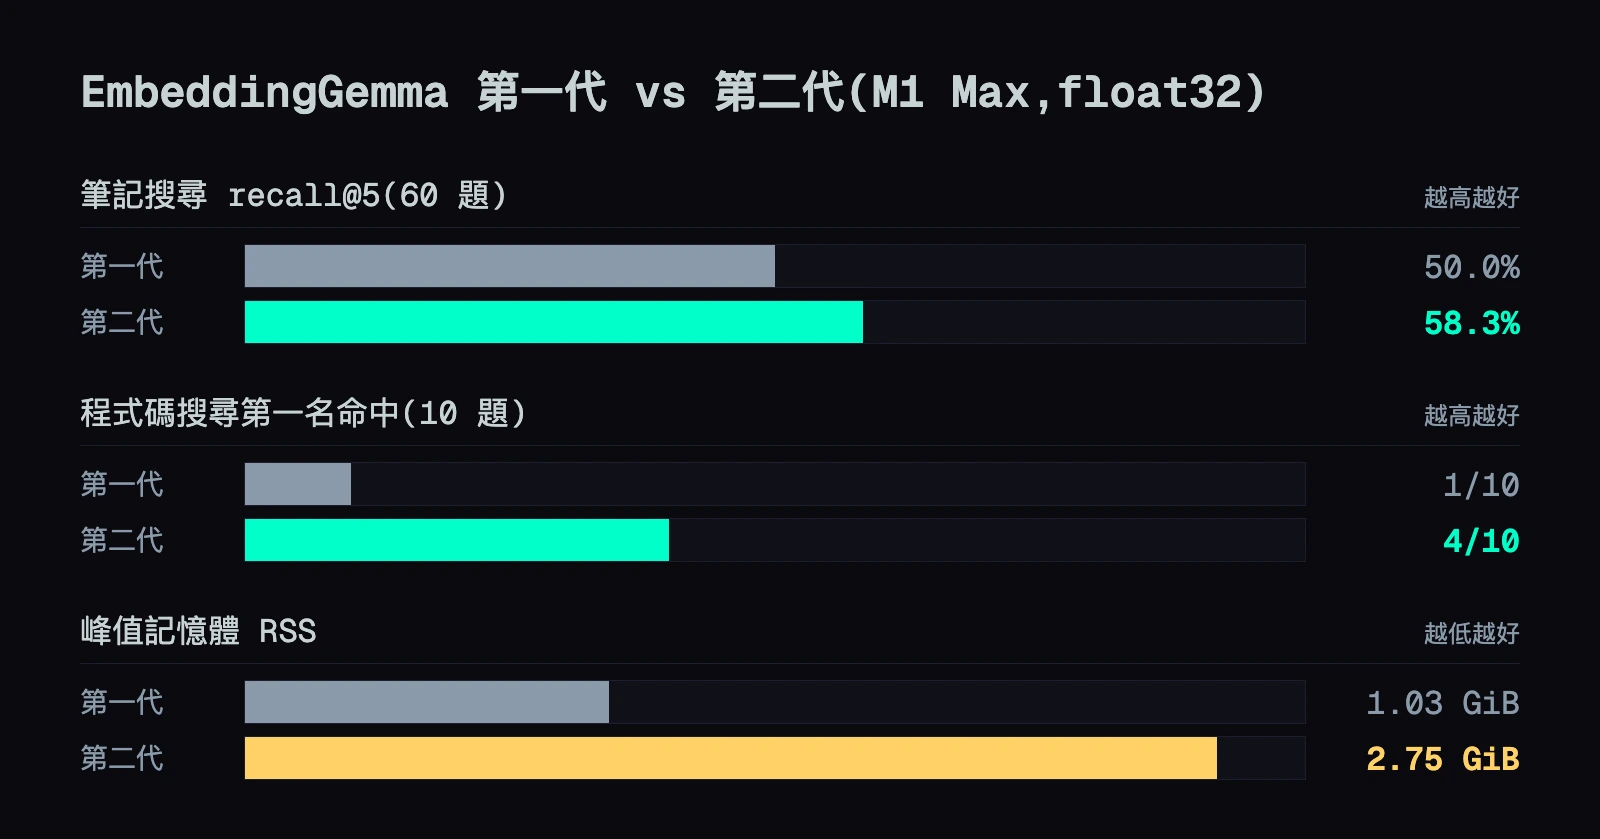
- 筆記搜尋 recall@5 從 50% 到 58.3%,沒有一題掉出前五名
- 程式碼搜尋第一名從 1/10 到 4/10
- 代價:建索引慢 1.7 倍,記憶體從 1.03 GiB 到 2.75 GiB
- 圖片和聲音:搜生活場景圖第一名多半對,搜音樂錯了
- 那知識庫換了嗎?還沒,llama.cpp 還載不了第二代
- 進階:逐題結果、截圖搜尋與踩到的坑
- 環境
- 測試 A 的出題方式
- 測試 B 逐題(正確檔的名次,0 = 第一名)
- 測試 B 在第二代上 MPS 記憶體爆掉
- 程式碼裡的 `<|image|>` 字串會讓第二代報錯
- 截圖搜尋(測試 C,僅第二代)
- 生活場景圖與聲音
- llama.cpp 那條路
TL;DR
Google 放出 EmbeddingGemma 2,我拿知識庫每天在用的第一代跟它同設定比(M1 Max、float32)。用 LOG 的一行話找對應筆記,60 題的 recall@5 從 50% 到 58.3%,沒有一題掉出前五名;用中文問程式碼在哪個檔,第一名命中從 1/10 到 4/10。代價是建索引慢 1.7 倍、記憶體 1.03→2.75 GiB。測試是另外跑的,正式知識庫仍用第一代,而且 llama.cpp 還載不了第二代,目前也換不了。
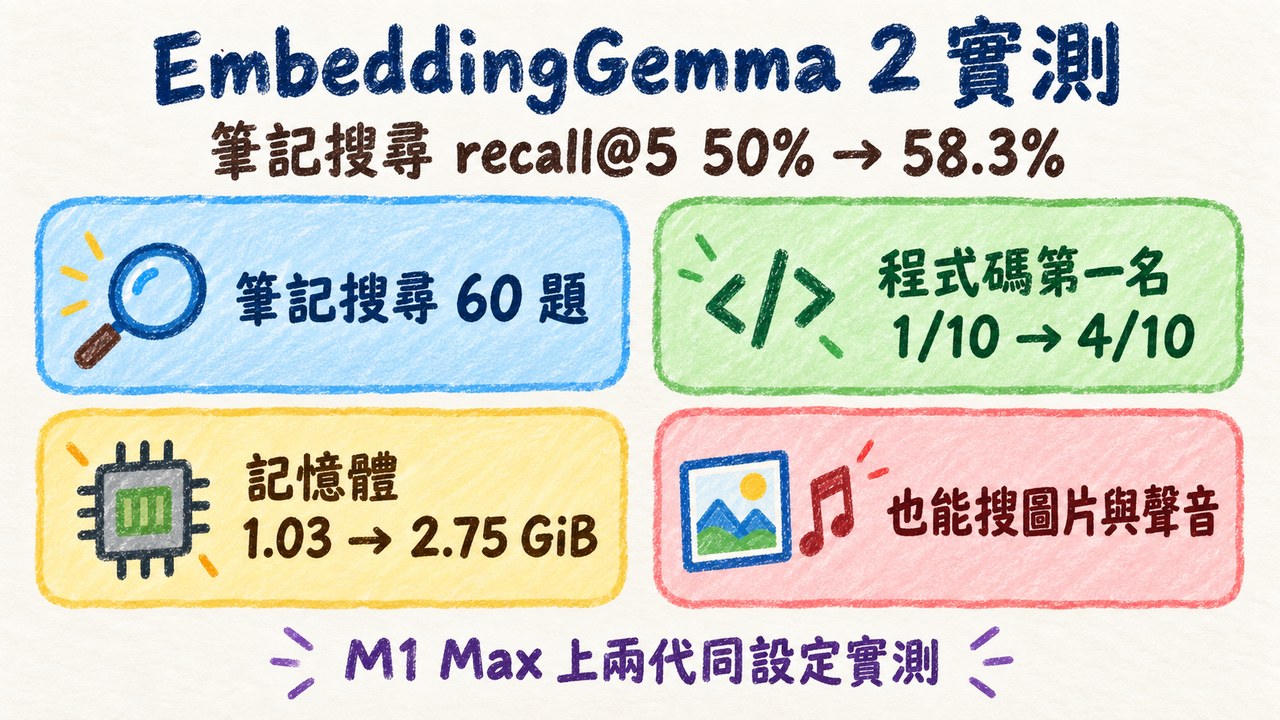
一分鐘版本:EmbeddingGemma 2 是什麼,我們拿自己的資料試了什麼。
前言
我的 AI 助理開工前會先查自己的筆記,查的工具叫 qmd,裡面負責「照意思找」(字面不同、意思相近也找得到)的那顆模型,就是 Google 的 EmbeddingGemma 第一代(embeddinggemma-300M-Q8_0)。它一天被叫幾十次,我平常根本不會想到它。
所以 Google 放出 EmbeddingGemma 2 的時候,我想知道的事很具體:換掉它,我的助理會不會比較常找到該找的那篇筆記?要多花多少記憶體和時間?
我讓兩代用同一台 MacBook、同一套程式、同一個精度,拿我自己的筆記和程式碼出題。
EmbeddingGemma 2 多了什麼:同一個 768 維空間放進圖片和聲音
embedding 模型做的事,是把一段文字壓成一串數字。意思接近的兩段話,算出來的數字也接近,所以拿問題的那串數字去比,就能找出意思最像的筆記,字面不一樣也找得到。EmbeddingGemma 的那串數字有 768 個,也就是常說的 768 維。
第一代只吃文字。第二代照官方模型卡的說法,把文字、圖片、影片、聲音放進同一個 768 維空間:你打一句話,可以拿去比一張照片或一段錄音。
| 第一代 | 第二代 | |
|---|---|---|
| 參數 | 約 300M,純文字 | 740M = 文字 270M + 圖片 170M + 聲音 300M |
| 能搜的東西 | 文字 | 文字、圖片、影片、聲音 |
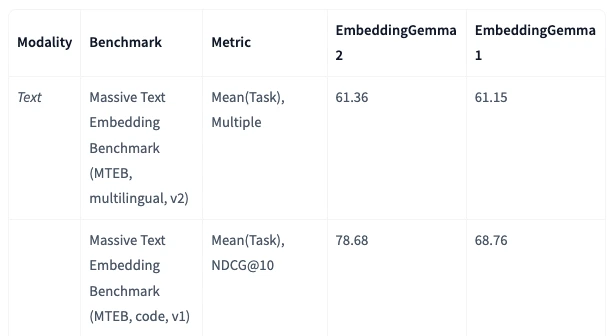
| MTEB 多語文字(官方) | 61.15 | 61.36 |
| MTEB 程式碼(官方) | 68.76 | 78.68 |
MTEB 是常用來比 embedding 模型的一套考題,包含搜尋、分類、分群等多種任務。這表看最後兩列:官方分數裡,多語文字幾乎沒動,程式碼漲了快 10 分。第二代的授權是 Apache 2.0(第一代是 Gemma 授權),支援 100 多種語言。圖片和聲音兩塊都關掉時,只載入 270M 的文字部分;我下面的程式碼只關了聲音,所以載的是文字加圖片。
我怎麼測:拿 LOG 的一行話,看它能不能找回對應筆記
簡單說,就是拿 LOG 裡的 60 句話當考題,每一題都有標準答案(它原本指向的那篇筆記),看兩代模型誰比較常把答案排進前五名。不寫程式的話,讀這一小段和下面的圖就夠了。
我的知識庫有一份 LOG,每做完一件事就記一行,行尾用 → [[筆記名]] 指向那件事寫進哪篇筆記。這剛好是現成的考卷:把行尾的連結拿掉,剩下那句話當問題,看模型在 813 篇筆記裡能不能把那篇排到前面。
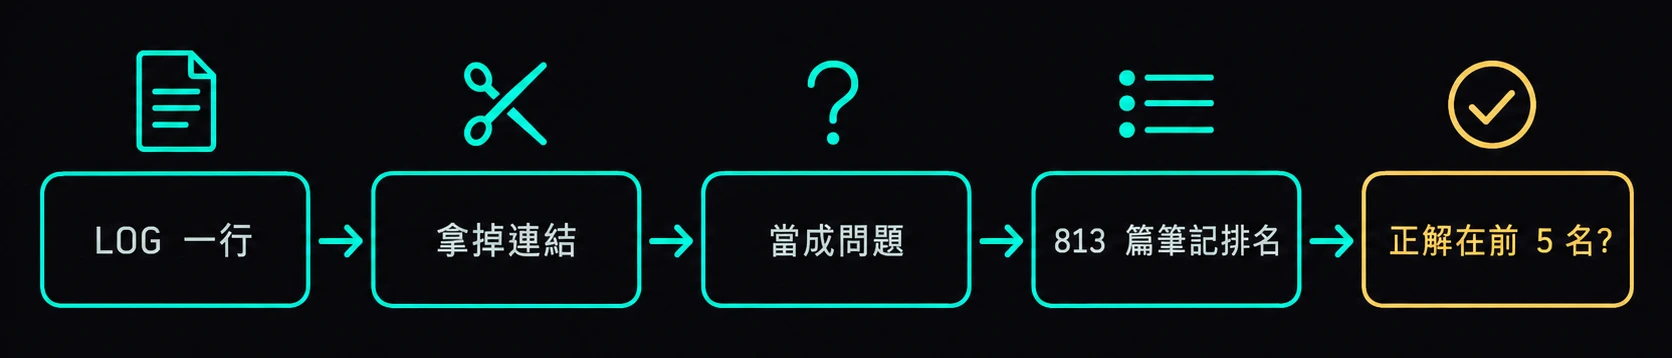
LOG 裡符合條件的有 1,547 行,我固定亂數種子抽 60 行。分數看三個:
- recall@1:正確那篇排第一名的比例
- recall@5:正確那篇在前五名的比例。助理查筆記時一次會拿好幾篇回來看,這個最接近實際用法
- MRR:正確那篇排第幾名取倒數再平均,排越前面越接近 1
另外加一組程式碼題:開源推理引擎 TensorFold 0.6.6 的原始碼有 424 個 .py / .cu 檔,我用中文出 10 個問題(像「遞迴狀態每一步怎麼捨入」),看模型能不能指到該打開的那個檔。
想自己重跑:核心程式碼
兩代都用 sentence-transformers 跑在 M1 Max 的 MPS 上,float32。核心就這幾行:
import torch
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "google/embeddinggemma-2",          # 第一代換成 google/embeddinggemma-300m
    device="mps",
    model_kwargs={"torch_dtype": torch.float32},
    config_kwargs={"audio_config": None},  # 只搜文字和圖片時,聲音那塊先不載
)

docs = model.encode(
    [f"title: {name} | text: {body[:1500]}" for name, body in notes],
    batch_size=16,
)
query = model.encode("task: search result | query: " + log_line)
前面那串 task: search result | query: 是兩代共用的查詢前綴,文件那邊用 title: … | text: …。兩代的前綴字串我逐字比對過是同一段,這樣兩邊不一樣的就只剩模型。
幾個會擋住你的地方:
- 別用 float16。 官方模型卡寫明會出 NaN。
- 第一代在 Hugging Face 要先按同意授權,沒登入下載會拿到 401。
- Mac 上記憶體會爆的話,把
batch_size調小,或把每組測試拆成獨立的 process 跑。我的 32GB M1 Max 在同一個 process 連跑兩組時爆過一次,細節在後面。
筆記搜尋 recall@5 從 50% 到 58.3%,沒有一題掉出前五名
| 60 題 LOG 找筆記 | 第一代 | 第二代 |
|---|---|---|
| recall@1 | 38.3%(23 題) | 41.7%(25 題) |
| recall@5 | 50.0%(30 題) | 58.3%(35 題) |
| MRR | 0.4406 | 0.4855 |
前五名裡找得到的題目從 30 題變 35 題,多出來的 5 題全是新擠進前五名的,沒有一題從前五名掉出去。第一名也一樣:第二代對、第一代錯的有 2 題,反過來的是 0 題。逐題看名次,60 題裡往前的 25 題、不變的 25 題、往後的 10 題。
那 2 題長得很像。一題講的是某個工作派給 A 失敗、改派 B 的決定,第一代挑到同一件事另一個面向的筆記(A 為什麼失敗),第二代挑到「改派」那篇。另一題也是同一個事件寫在兩篇筆記,第二代挑中 LOG 實際指向的那篇。
反過來看,兩代的 recall@5 都在五到六成,代表大約四成的 LOG 行,模型在前五名裡找不到它指的筆記。LOG 一行常是一句結論,筆記開頭寫的是背景,兩邊用字差很多,換模型能補一點,補不滿。
程式碼搜尋第一名從 1/10 到 4/10
| 10 題中文問程式碼 | 第一代 | 第二代 |
|---|---|---|
| 第一名就是正確檔 | 1 題 | 4 題 |
這跟官方 MTEB 程式碼那列(68.76→78.68)是同一個方向。第二代多答對的三題,是「遞迴狀態每步捨入」「DFlash2 在 CPU 上做最佳優先」「沿草稿樹找被接受的路徑」,三題都描述一段具體的運算邏輯。
兩代都錯得很遠的是「修剪孤兒節點」這題:這是題目用的比喻,程式碼裡沒有「孤兒」這個詞,第一代把正確檔排在第 91 名,第二代排在第 308 名。10 題的樣本很小,這組數字當方向看就好。
代價:建索引慢 1.7 倍,記憶體從 1.03 GiB 到 2.75 GiB
| M1 Max,float32 | 第一代 | 第二代 |
|---|---|---|
| 813 篇筆記建索引 | 81.8 秒 | 138.8 秒 |
| 單題查詢(中位數,70 題) | 50.3 ms | 48.3 ms |
| 峰值記憶體(RSS) | 1.03 GiB | 2.75 GiB |
查詢一樣快。多出來的是兩件事:整個知識庫重建一次要多等將近一分鐘,常駐的記憶體多將近 1.7 GiB。這裡的第二代有載圖片那塊、沒載聲音那塊;RSS 也不完整包含 MPS 在 GPU 那側的配置,實際佔用只會更多。
圖片和聲音:搜生活場景圖第一名多半對,搜音樂錯了
第二代的新東西是同一個空間能放圖片和聲音,所以我也試了。
圖庫是我做說明影片時生的 300 張動畫場景圖(隨機抽樣)。四個問題的前三名:
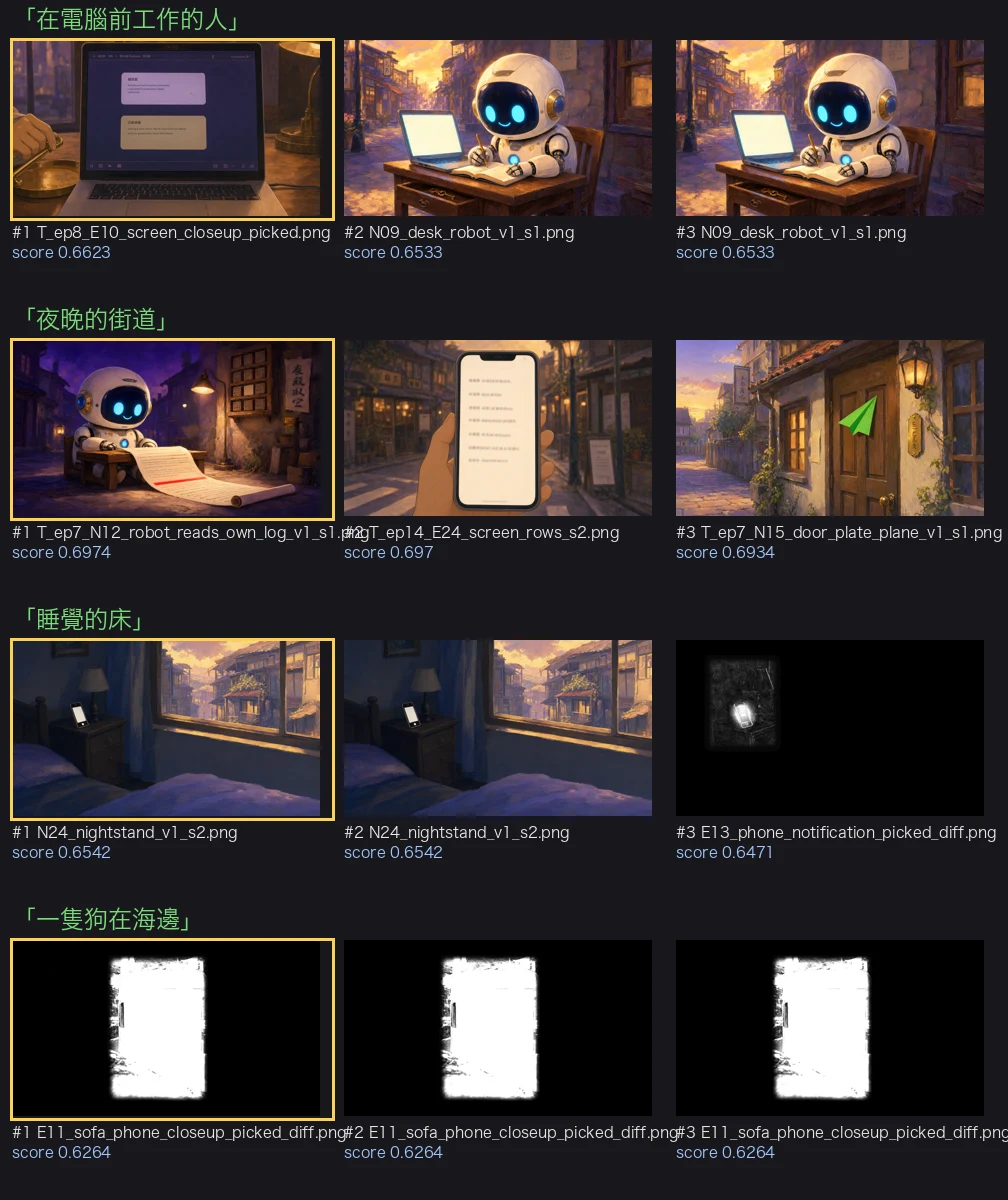
「夜晚的街道」和「睡覺的床」第一名都對。「在電腦前工作的人」挑到筆電螢幕特寫、旁邊有人的手,算大致對;更貼切的「機器人坐在桌前打字」排第二。「一隻狗在海邊」是對照句,圖庫裡沒有狗也沒有海,它的第一名分數 0.6264 比另外三句的第一名都低。圖庫裡有些圖在兩個資料夾各存了一份,所以同一張會連續出現兩次。
換成網站上的技術截圖就沒那麼好。200 張截圖、3 個問題,「有長條圖的截圖」第一名是一張手機對話截圖,錯了。三題的分數全擠在 0.66 到 0.70,第一名和第二名差不到 0.01,模型其實分不太出來。
聲音我拿了 40 段、每段 20 秒:22 段旁白、12 段音樂、6 段音效。「一個人在說話」前三名全是旁白。「輕快的音樂」前兩名卻是說話,第三名是一段帶旁白的混音,純音樂的片頭沒進前三,前三名分數擠在 0.6936 到 0.6991。我手上真正不同的音樂只有一首片頭曲,其他是它的副本和含旁白的混音,這組考題本身偏弱。
那知識庫換了嗎?還沒,llama.cpp 還載不了第二代
這次測試是在另一個資料夾另外跑的,正式的 qmd 沒有動。qmd 是透過 llama.cpp 跑模型,吃的是 GGUF 格式(llama.cpp 用的單一模型檔)。我拿 brew 裝的 llama.cpp v9750 載入第二代的 GGUF(ggml-org/embeddinggemma-2-GGUF Q8_0):
unknown model architecture: 'gemma-embedding2'
它還不認得這個架構。換模型也不能只換檔案:兩代算出來的數字不在同一個空間,整個知識庫要用新模型重建一次索引。
所以目前:第二代在我的筆記上找得比較準、沒有一題掉出前五名,程式碼進步最多;等 llama.cpp 支援,我會先在 qmd 旁邊另開一份索引並排比幾天,再決定要不要換掉每天在用的這一顆。
進階:逐題結果、截圖搜尋與踩到的坑
不讀這節不影響使用。這裡是給想重跑或想把整篇丟給 AI 參考的人看的完整紀錄。
環境
- Apple M1 Max(MacBookPro18,2)32GB,macOS 27.0.1
- sentence-transformers 6.1.0 / transformers 5.19.0 / torch 2.14.1,float32,MPS
- 第一代
google/embeddinggemma-300m,第二代google/embeddinggemma-2 - 載入時間:第一代 7.7 秒,第二代 7.6 秒
測試 A 的出題方式
候選是 LOG.md 和 LOG-2026-09.md 裡,行尾有 → [[X]] 而且 X 這篇筆記真的存在的行,共 1,547 行;seed=7 抽 60 行。筆記庫排除 LOG 本身、MEMORY.md、KB_MAP.md,剩 813 篇,每篇取前 1,500 字,前面加 title: 檔名 | text: 。查詢是那行去掉日期、標籤和連結之後的文字。
第一代的 sentence-transformers 預設 prompt 清單裡沒有 SearchQuery 這個名字,但它的 query 前綴文字跟第二代的 SearchQuery 一樣都是 task: search result | query: 。為了排除變因,兩代都手動拼接前綴,不靠函式庫的 prompt 名稱。
第二代對、第一代錯的兩題,完整版:
- 問題是一行派工決策:某個 coding agent 兩次沒動靜,改派給另一組。正解
feedback_dispatch_fallback_chain_2026-09-21.md;第一代第一名是discovery_agy_print_mode_kills_background_jobs_2026-09-21.md(同一事件,講的是前一個 agent 為什麼掛)。 - 問題是一行紀錄:「cc-dash-kit 推廣只做社群貼文、草稿放 blog-staging」。正解
reference_buffer_social_post_method.md;第一代第一名是project_goal_only_harness_rollout_2026-09-23.md。
測試 B 逐題(正確檔的名次,0 = 第一名)
| 題目(摘) | 正確檔 | 第一代 | 第二代 |
|---|---|---|---|
| 抽樣亂數由種子加位置決定 | engine/exact_sampling.py | 0 | 0 |
| 修剪孤兒節點 | engine/lane_engine.py | 90 | 307 |
| 從前文找重複段落當草稿 | engine/lane_engine.py | 11 | 31 |
| 這一輪用哪種草稿來源 | engine/lane_family.py | 143 | 14 |
| 開機逐位元比對驗幾列 | families/glm5_next/runtime.py | 227 | 116 |
| 4-bit 矩陣乘每列怎麼算 | cuda/kernels/qmm.py | 21 | 5 |
| 遞迴狀態每步捨入 | cuda/kernels/gdn.cu | 7 | 0 |
| DFlash2 CPU 最佳優先 | drafters/dflash_tree.py | 19 | 0 |
| 顯卡最低版本檢查 | cuda/build.py | 28 | 6 |
| 沿草稿樹找被接受路徑 | kernels/qwen/dense/v1/lane_tree.py | 3 | 0 |
查詢前綴用 task: code retrieval | query: 。recall@3 兩代分別是 0.10 和 0.40,跟 recall@1 一樣。沒進第一名、但名次往前很多的有三題:「這一輪用哪種草稿來源」第 144 名到第 15 名、「4-bit 矩陣乘」第 22 名到第 6 名、「顯卡最低版本檢查」第 29 名到第 7 名。往後掉的有兩題:「修剪孤兒節點」第 91 名到第 308 名、「從前文找重複段落」第 12 名到第 32 名。
測試 B 在第二代上 MPS 記憶體爆掉
第二代在同一個 process 跑完測試 A 再跑測試 B,MPS 回報的「other allocations」累積到 35–38GB,batch_size 16、4、2 都爆。第一代沒有這個問題。解法是測試 B 拆成獨立 process、每隔一段呼叫 torch.mps.empty_cache(),並把 max_seq_length 設成 2048,比照第一代原生的 2048 上限,兩代讀進去的長度也因此一致。這也是第二代測試 B 建索引時間(167.5 秒,第一代 102.5 秒)不能直接拿來比的原因:它多了一次獨立載入。
程式碼裡的 <|image|> 字串會讓第二代報錯
TensorFold 有一個檔案(vision/glm_processing.py)本身含有 <|image|> 這串字。第二代的多模態 processor 看到它,會以為你要傳圖片進來卻沒給,直接報錯。我在兩代的語料裡都把它改成 <| image |>,這只動到那一個檔,改完重跑指標沒變。如果你的語料是程式碼或聊天模板,先搜一下這類特殊 token。
截圖搜尋(測試 C,僅第二代)
200 張從這個部落格 public/ 底下隨機抽的圖(seed=7),建索引 80.4 秒,峰值 RSS 3.59 GiB。
| 問題 | 第 1 名 | 分數 | 判斷 |
|---|---|---|---|
| 有長條圖的截圖 | 手機對話截圖 | 0.6974 | 錯 |
| 終端機畫面 | 終端機面板截圖 | 0.6812 | 對 |
| 手機版網頁 | 手機版面截圖 | 0.6877 | 對 |
生活場景圖與聲音
場景圖:說明影片的關鍵影格共 2,553 張,random.seed(11) 抽 300 張,建索引 105.1 秒。四句第一名分數:在電腦前工作的人 0.6623、夜晚的街道 0.6974、睡覺的床 0.6542、一隻狗在海邊 0.6264。
聲音:40 段各截前 20 秒(16k mono wav),建索引 7.5 秒;要啟用聲音那塊得另外裝 librosa(sentence-transformers 的 audio 依賴),而且載入時不要傳 audio_config=None。編碼方式是 model.encode([{"audio": path} ...]),圖片是 {"image": PIL.Image}。「一個人在說話」前三名分數 0.754 / 0.751 / 0.750,全是旁白;「輕快的音樂」前三名是兩段旁白(0.6991、0.6952)和一段帶旁白的混音(0.6936),純音樂片頭沒進前三。
llama.cpp 那條路
ggml-org/embeddinggemma-2-GGUF 的 Q8_0(310MB)加 mmproj Q8_0(555MB)我都下載下來了,brew 的 llama.cpp v9750 載入時報 unknown model architecture: 'gemma-embedding2'。檔案留著,等新版 llama.cpp 再試。這次試跑全程沒有動到 qmd 的設定和正式索引。
短片版也放在 YouTube:EmbeddingGemma 2 一分鐘版本。
這個系列前一篇講知識庫的整體設計:搜尋找得到筆記、卻連不起來:幫 AI 記憶加一張知識圖譜。
常見問題
- EmbeddingGemma 2 跟第一代比,搜尋有變準嗎?
- 在我自己的 813 篇筆記上,60 題的 recall@5 從 50% 升到 58.3%,第一名命中從 23 題到 25 題,而且沒有任何一題從前五名掉出去。用中文問程式碼該看哪個檔,第一名命中從 10 題中 1 題到 4 題。M1 Max、float32、兩代同設定。
- EmbeddingGemma 2 可以用 llama.cpp 或 Ollama 跑嗎?
- 截至 2026-10-07,我用 brew 裝的 llama.cpp v9750 載入第二代的 GGUF 會報 unknown model architecture: 'gemma-embedding2'。我改用 sentence-transformers 跑,float32 在 Apple Silicon 的 MPS 上可以用。
- EmbeddingGemma 2 比第一代吃多少資源?
- M1 Max 上,813 篇筆記建索引從 81.8 秒變 138.8 秒,峰值記憶體(RSS)從 1.03 GiB 變 2.75 GiB,單題查詢都在 50 毫秒左右。官方模型卡另外提醒不要用 float16,會出 NaN。
- EmbeddingGemma 2 搜圖片和聲音準嗎?
- 我的小規模試跑結果分兩邊:300 張動畫場景圖裡,「夜晚的街道」「睡覺的床」第一名都對;40 段聲音裡,「一個人在說話」前三名全對。但「輕快的音樂」錯了,前三名沒有一段是純音樂;網站截圖 3 題錯 1 題,而且分數都擠在 0.66 到 0.70 之間。
接著讀
- 2026-07-14[Dev Workflow] 搜尋找得到筆記、卻連不起來:幫 AI 記憶加一張知識圖譜
我拿大約 600 篇 markdown 檔當 AI 的長期記憶,分成三層:檔案本身是唯一的真相源、一個搜尋引擎讓它們找得到、一張知識圖譜用概念把它們連起來。這篇先講清楚這個設計、每一層為什麼存在、換來什麼好處,最後才講我建它時走錯的那幾條路。
- 2026-07-15[Dev Workflow] 搜尋找得到,卻要每個 session 重推一遍:幫 AI 記憶加一層蒸餾層
我拿一批 markdown 檔當 AI 的長期記憶,在檢索(搜尋加知識圖譜)之上再疊一層蒸餾層。檢索撈回的是原始材料,每個 session、每個 agent 都得重讀重推一遍;蒸餾層把定案結論冶煉一次、存成一檔一個 claim,之後直接取用。這篇講清楚這層是什麼、為什麼它的目的是『少解釋一次』而不是『逼大家講一樣』、以及我怎麼學會真的去信它。
- 2026-09-11[Dev Workflow] 你的聲音,24 秒就能複製:MacBook 上的 Qwen3-TTS 教學
預設 TTS 的聲音不是你的聲音。24 秒錄音加十行 Python 就能 zero-shot clone,MacBook 本機跑得動,不用 GPU 機也不用訓練。
- 2026-07-27[Dev Workflow] agent 把自己講錯的話存進了長期記憶——連 /new 都殺不掉
一個有長期記憶的 AI agent,把自己答錯的結論自動寫進記憶,之後每個新對話都翻出來當事實。/new 清不掉,因為幻覺住進了記憶層。五回合探針加三刀解毒的完整病歷。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。