[Benchmark] Inkling 可調迴圈模型:24 層權重跑出 48 層深度,RTX 5090 實測 1/3/5 遍答對 39/46/46
❯ cat --toc
- Inkling 是什麼:Thinking Machines 做給本地跑的迴圈模型
- 它解決的問題:要更深的模型,不必多存一倍權重
- 研究版多一個旋鈕:遍數可以自己選
- 怎麼跑:啟動時改一個數字
- 實測:5090 上 1、3、5 遍,答對 39、46、46
- 實戰對照:難題比 MiniCPM-V 4.7 多對 7 題,速度只有它三分之一
- 量化:5090 用原生、2080 Ti 用 IQ4_NL,換更小的大概不會快多少
- 進階:啟動指令、真實工作題、評測台的兩個 bug、量測附註
- 兩張卡的啟動指令:vLLM 改 `--hf-overrides`,llama.cpp 改 `--override-kv`
- 預設思考吃光短上限:20 題裡 16–17 題頂到上限
- 工具呼叫回成文字:記「不可測」,不算 0 分
- 評測台的兩個 bug:都在我這邊,不在 Inkling
- 量測附註
TL;DR
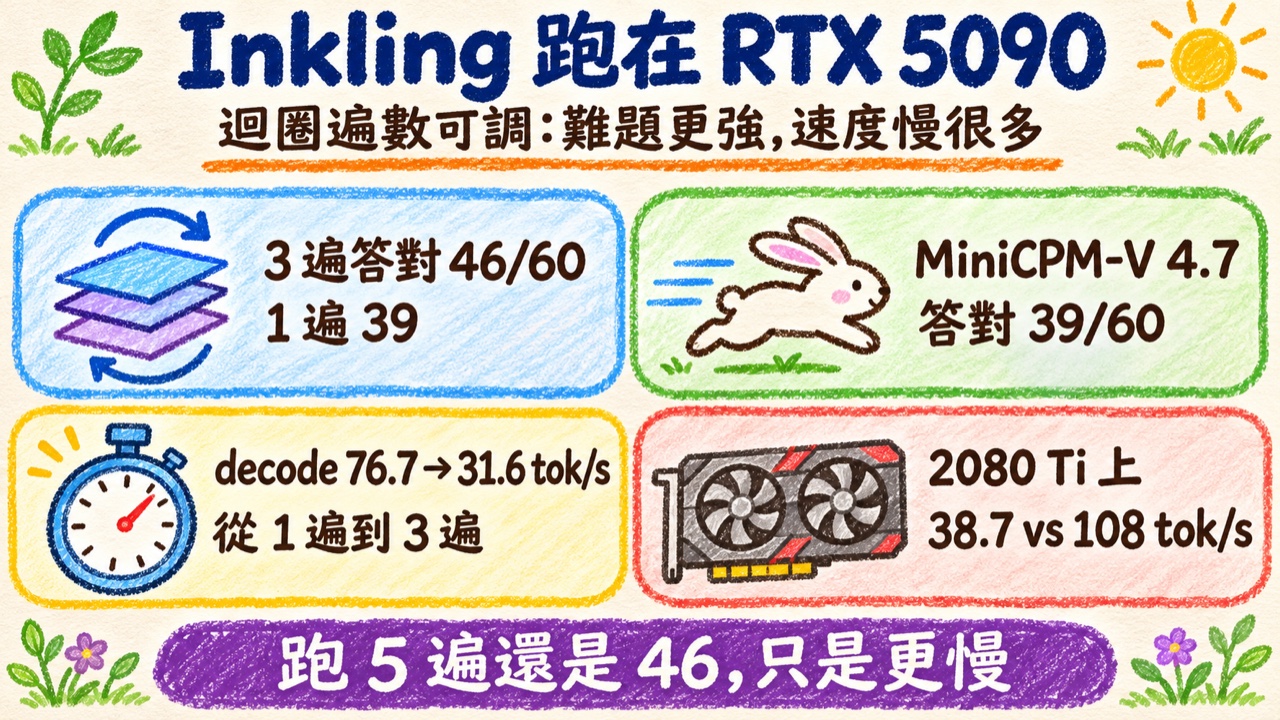
Thinking Machines 的 Inkling 2 Mini 實體只有 24 層,中間 12 層用同一份權重重複跑,每個 token 等於跑了 48 層,檔案約 20 GB,32 GB 的卡就放得下。研究版連遍數都能改。我在 RTX 5090 上跑 60 題難題:1 遍答對 39、3 遍 46、5 遍還是 46,跟官方多數評測一樣,到 3 遍就差不多持平。代價是速度:放到常駐 MiniCPM-V 4.7 的改裝 2080 Ti 上,3 遍吐字 38.7 tok/s,約它的三分之一。難題多對 7 題,但常駐卡不換。
Inkling 是什麼:Thinking Machines 做給本地跑的迴圈模型
11 月 20 日 Thinking Machines 放出 Inkling 2 Mini,Hugging Face 的介紹文說它是設計給本地 AI 環境用的。它是 MoE(mixture of experts)模型:每一層裡有 128 組「專家」,每個 token 只挑 8 組來算。整個模型有 26.4B(264 億)個參數,也就是模型裡的權重數字,官方標的 active 參數是 3.4B;因為中間那段跑 3 遍,模型卡把 Inkling 2 Mini 每個 token 的實際計算量算成約 5.4B。輸入可以是文字或圖片,輸出文字,context 最長 1M token,授權 Apache 2.0。
權重直接用訓練時的精度發佈(專家權重是 NVFP4 和 MXFP8,其他 BF16),約 20 GB,不用再量化,32 GB VRAM 的卡或 32 GB 的 Mac 就放得下。
它跟其他模型最不一樣的地方是「迴圈」。
它解決的問題:要更深的模型,不必多存一倍權重
模型是一層一層往下算的,每一層把上一層的結果再加工一次。層數越多通常越強,但每多一層就要多存一份權重,檔案和 VRAM 用量跟著變大。在自己的機器上跑模型,最先卡住的往往就是 VRAM。
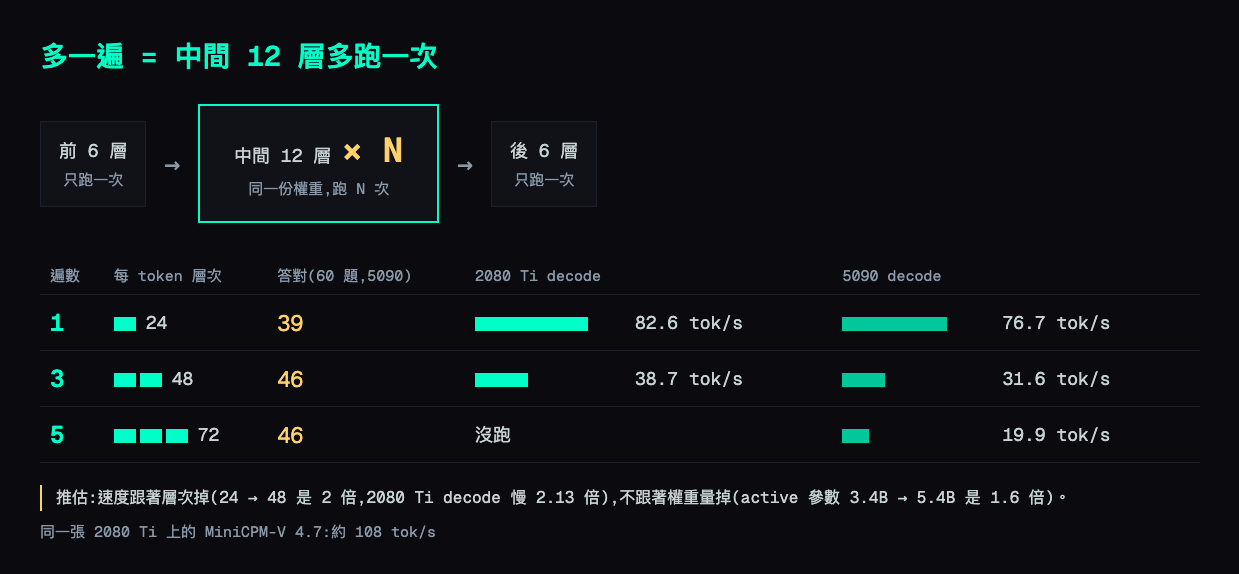
Inkling 2 Mini 的做法是讓中間 12 層重複使用。它實體上只有 24 層:前 6 層跑一次,中間 12 層用同一份權重連跑 3 次,最後 6 層跑一次,所以每個 token 一共跑 48 層,跟大一號的 Inkling 2 Small 一樣多。每一趟都從前 6 層的輸出出發,再讀上一趟留下的結果,由一個小開關決定保留多少、加進多少,等於每一趟都在修上一趟算出來的東西。
省下來的是權重,不是計算。48 層每一層還是要真的算一次,每一趟也各有自己的 KV 快取(模型記住前文用的暫存),權重共用讓檔案變小,但本身不會讓推論變快。
研究版多一個旋鈕:遍數可以自己選
同一天還放了研究版 TML-d24-varloop-research。架構一樣,但中間那段要跑幾遍可以在啟動時指定,1 到 5 遍都行。1 遍是每個 token 跑 24 層,3 遍是 48 層,5 遍是 72 層。遍數越多,每個 token 動到的參數也越多:1 遍 3.4B(34 億),每多一遍多約 1.0B,3 遍 5.4B,5 遍 7.4B。檔案大小不會變。
同一份模型檔,只改一個設定,就能選要答得好一點還是跑得快一點。研究版訓練時 1 到 5 遍都練過,但練得最多的是 3 遍,post-training 也用 3 遍。官方模型卡列了 1 到 5 遍的分數,多數評測都是 1 遍到 2 遍進步最多,3 遍之後漲得少或有升有降。也有例外,像 BrowseComp 從 3 遍的 65.7% 一路漲到 5 遍的 71.0%。以 SWE-bench Verified(讓模型修真實程式 bug 的評測)為例,依序是 56.3%、76.5%、78.7%、79.3%、79.6%。官方也提醒,訓練偏重 3 遍,其他遍數的分數可能被低估;正式版和研究版後段的訓練不同,不要直接拿來比。這篇測的全是研究版。
Hugging Face 的介紹文說,1、2 遍會快很多,品質可能稍差,但他們沒有深入評測。我想知道的就是這筆帳在自己的機器上怎麼算:多跑一遍能多答對幾題?又會慢多少?
怎麼跑:啟動時改一個數字
兩張卡用的軟體不一樣(vLLM 和 llama.cpp 都是把模型跑起來、提供服務的軟體)。5090 用 vLLM 直接跑原生精度的檔;2080 Ti 用 llama.cpp 跑 ggml-org 轉好的 IQ4_NL 檔,17.6 GB,22 GB 的卡整個放得下。遍數是啟動時的一個設定,填 1、3 或 5 就好,模型檔不用換。兩張卡的完整啟動指令放在文末「進階」那節,要自己跑可以照抄。
改完要確認真的生效。同一個問題(prompt)、同一個隨機種子(seed),1 遍和 3 遍的輸出不一樣,吐字(decode)速度從 81.6 掉到 37.9 tok/s。另外,它預設會先輸出一段思考再給答案,後面的真實工作題會碰到這點。
實測:5090 上 1、3、5 遍,答對 39、46、46
題目是 60 題難題:競賽數學 30 題、推理 30 題,temperature 0(每次都挑最可能的字,結果可以重現),每題最多輸出 32,768 個 token。5090 上三組遍數都整組跑完。先看「答對」那欄,再看它旁邊的速度跟總時間:
| 遍數 | 答對(/60) | 平均輸出 token | 單路吐字 | 逐題秒數加總 |
|---|---|---|---|---|
| 1 | 39 | 9,871 | 76.7 tok/s | 141 分 |
| 3 | 46 | 8,388 | 31.6 tok/s | 272 分 |
| 5 | 46 | 7,702 | 19.9 tok/s | 390 分 |
3 遍多對 7 題,輸出的 token 還少了 15%,但每個 token 慢了一倍多,總時間大約翻倍。5 遍分數跟 3 遍一樣,時間再多 43%。這跟官方多數評測一致:3 遍之後,分數就沒什麼增加了。
實戰對照:難題比 MiniCPM-V 4.7 多對 7 題,速度只有它三分之一
接著把它放進實際在用的位置比一比。我家那張改裝 2080 Ti 22G 常駐的是 MiniCPM-V 4.7 35B-A3B(#25 架起來,#30 剛升級過 llama.cpp),平常接的多半是短任務:分類、評分、改標題。這張卡要的是快,單路(一次只送一條請求)約 108 tok/s,也就是每秒產生約 108 個 token(模型一次吐出的一小段字)。
MiniCPM-V 4.7 之前在 2080 Ti 上跑同一組 60 題、同一個上限,答對 39。2080 Ti 上的單路吐字取 9 發中位數:
| 2080 Ti 22G 上的模型 | 難題答對(60 題) | 單路吐字 |
|---|---|---|
| Inkling 研究版 1 遍(IQ4_NL) | 39(5090 上量) | 82.6 tok/s |
| Inkling 研究版 3 遍(IQ4_NL) | 46(5090 上量) | 38.7 tok/s |
| MiniCPM-V 4.7 35B-A3B | 39 | 約 108 tok/s |
分數最好的是 3 遍,多對 7 題,但速度只剩 MiniCPM-V 4.7 的 36%。就算退回 1 遍也還慢 24%,分數卻一樣是 39。正式版 Inkling 2 Mini 固定 3 遍,每個 token 一樣跑 48 層,我推估速度差不多,但沒實測。
2080 Ti 那邊時間不夠,題目沒跑完:1 遍只跑完 41 題、3 遍只跑完 18 題,所以分數用 5090 的。3 遍跑完的那 18 題答對 14,跟 5090 在同樣 18 題上一樣,這 18 題看不出 IQ4_NL 讓答對率下降。
所以常駐的不換。短任務要的是馬上回,真的要拿它解難題時再另外開 Inkling 就好。
決定之前我也拿真實工作的小題庫試過,結果多半量到的是介面問題,不是能力,細節放在後面的進階。事故診斷那七題是照實際交出來的答案打分,Inkling 有三題卡在同一個介面問題、交不出能評的答案,這三題記 0 分,整組 Inkling 還是拿 10/21、MiniCPM-V 4.7 拿 9/21,每題中位數 202 秒對 102 秒。
量化:5090 用原生、2080 Ti 用 IQ4_NL,換更小的大概不會快多少
量化是把權重改用更少的位元存,檔案變小,通常也跑得比較快。5090 跑的是原生 checkpoint,沒有再量化。2080 Ti 用 IQ4_NL,17.6 GB 已經整個塞進 22 GB。
換更小的量化,檔案會變小,但我推估 2080 Ti 不會快多少。這是從實測數字推的,更小的檔我沒跑。看最右邊那欄,1 遍到 3 遍各項變成幾倍:
| 每個 token | 1 遍 | 3 遍 | 倍數 |
|---|---|---|---|
| 用到的參數 | 3.4B | 5.4B | 1.6 倍 |
| 要跑的層數 | 24 | 48 | 2 倍 |
| 2080 Ti 實測吐字 | 82.6 tok/s | 38.7 tok/s | 慢 2.13 倍 |
慢下來的幅度對得上層數,對不上權重的量。如果卡在讀權重,多讀 1.6 倍應該只慢 1.6 倍左右,實際卻超過 2 倍。我的解讀是時間大多花在跑每一層,不在讀權重;這要用 profiler(逐步記錄時間花在哪裡的工具)實際量才能確定,我沒做。
5090 的數字也是同一回事。它的記憶體頻寬(每秒能從 VRAM 讀多少資料)接近 2080 Ti 的三倍,1 遍卻比較慢(76.7 對 82.6 tok/s)。它還開了 --enforce-eager,這會關掉 CUDA graphs(把一連串 GPU 工作先錄好、再一次送出的功能),每一層的啟動成本變高。框架和量化都不一樣,只能當旁證。
3 遍要追上 MiniCPM-V 4.7,得快 2.8 倍。我推估只換量化達不到這麼多,這點沒有實測。
想自己試的話,Unsloth 有出 Inkling 2 Mini 的 GGUF,從 7.8 GB(UD-IQ1_S)到 22.9 GB(UD-Q8_K_XL)。UD-Q2_K_XL 9.1 GB,首選字跟 Q8 相同的比例是 91.6%;UD-IQ4_XS 15.7 GB 是 97.7%。他們 README 寫了兩件事要注意:
Mainline_Support資料夾裡保留 NVFP4 縮放係數的檔案,要用含 PR #32704 的 llama.cpp(11 月 21 日已合併進上游),不然第二、三遍會丟掉專家權重的縮放係數,輸出是錯的。- 這套 GGUF 附的 DSpark 草稿模型(0.4 GB,給推測解碼用)目前要用 Unsloth 自己的 llama.cpp 版本,上游的 PR #32218 還沒合併。
推測解碼(speculative decoding)會減少每個 token 要跑完整模型的步數,是我最想先試的加速方法,還沒測。
進階:啟動指令、真實工作題、評測台的兩個 bug、量測附註
不打算自己跑的話,不讀這節也沒關係。這裡放兩張卡的完整啟動指令、把 Inkling 丟進真實工作時壞在哪,還有前面每個數字背後的量法。
兩張卡的啟動指令:vLLM 改 --hf-overrides,llama.cpp 改 --override-kv
要改遍數只看每段指令的最後一行,把裡面的 3 換成 1 或 5。
RTX 5090,vLLM。 研究版直接放的就是原生精度:前 20 層的專家 NVFP4、最後四層的專家 MXFP8、其他 BF16,約 19.5 GB。不用再量化,32 GB 的卡放得下。image 用 vllm/vllm-openai:inkling-2-mini,遍數寫在最後一行的 --hf-overrides。我是在 WSL2 下跑,原生 Linux 把那兩行 WSL 掛載換成 --gpus all 就好:
docker run --rm --name inkling-trial-server --network host --ipc host \
  --device /dev/dxg -v /usr/lib/wsl:/usr/lib/wsl:ro \
  -e LD_LIBRARY_PATH=/usr/lib/wsl/lib:/usr/local/cuda/lib64 \
  -v /root/inkling-varloop-2026-11-22:/root/inkling-varloop-2026-11-22 \
  vllm/vllm-openai:inkling-2-mini /root/inkling-varloop-2026-11-22/weights \
  --served-model-name inkling-varloop --port 9498 \
  --max-model-len 36864 --max-num-seqs 32 --gpu-memory-utilization 0.93 \
  --reasoning-parser inkling --no-enable-prefix-caching --enforce-eager \
  --language-model-only \
  --hf-overrides '{"text_config":{"loop_num_passes":3}}'
RTX 2080 Ti 22G,llama.cpp。 用的是 ggml-org 的 GGUF 裡的 TML-d24-varloop-research-IQ4_NL.gguf,17.6 GB:前 20 層的專家是 IQ4_NL(一種 4-bit 量化格式),最後四層的專家和其他部分是 Q8_0,迴圈控制 F32。llama.cpp 用 master 的 afe77e18 自己編,架構指定 sm_75(2080 Ti 的代號)。遍數寫在 --override-kv:
llama-server -m TML-d24-varloop-research-IQ4_NL.gguf \
  --host 127.0.0.1 --port 18122 -ngl 99 -fa on -t 24 --jinja \
  -np 4 -c 147456 -ctk q8_0 -ctv q8_0 -b 1024 -ub 256 --fit off \
  --override-kv inkling2_loop.loop.count=int:3
-np 4 -c 147456 是開 4 路、每路 36,864 token,KV 用 q8_0。這樣 VRAM 用掉 21,296 MiB,全部塞得下,不用 offload(把一部分層搬到 CPU 那邊跑)。
除了前面那組同 seed 對照,5090 上我另外數了迴圈層被呼叫幾次,每個 token 分別是 1 次和 3 次,確認設定真的生效。
預設思考吃光短上限:20 題裡 16–17 題頂到上限
真實工作題庫裡有 20 題短任務,都從產線拿出來:分類、新聞評分、中翻英短標籤、資料抽取、改寫標題。每類用產線本來的輸出上限:分類 250、評分 850、改寫 900、翻譯 1,800、抽取 4,500 token。
對照答案來自現在做這份工作的模型,思考是關的。Inkling 開預設思考,同樣的提示、同樣的上限。思考和答案共用同一份 token 預算,結果 1 遍有 17/20、3 遍有 16/20 頂到上限。有一題分類,250 token 裡 248 個是推理,答案是空白。
| 短任務 20 題 | 機判通過 | 盲評可直接用 |
|---|---|---|
| Inkling 1 遍 | 3 | 1 |
| Inkling 3 遍 | 4 | 1 |
| 產線模型(思考關閉) | 12 | 4 |
所以那個 1/20 量到的是設定,不是模型。公平的重考要關掉思考,或另外把上限加大當成一個變因。我沒跑,速度差這麼多,常駐那張卡本來就不會換。
工具呼叫回成文字:記「不可測」,不算 0 分
其他幾類要用工具:兩題程式修補、七題事故重播、兩題規則檔精簡,走一個有 read 和 bash 工具的 coding agent。工具冒煙測試有過,read 和 bash 各呼叫一次,12.6 秒。
長題就出事了。跑了 3 到 30 次工具之後,最後的回覆變成一段沒執行的工具呼叫字串。vLLM 沒報錯,agent 看到的是正常的 stop。一題規則檔在 9 次工具之後只回了這個:
bash"}}
另一題在 11 次之後回了這個(本機路徑我縮成 <bank>):
bash"name":"bash","args":{"command":"find <bank>/runs/inkling-p3/C2 -name \"*size*inventory*\" ..."}}
服務旗標是 --enable-auto-tool-choice --tool-call-parser inkling --reasoning-parser inkling,取樣用模型預設的 temperature 1.0。我分不出是解析器漏認了正確格式,還是模型吐出壞掉的格式,所以這些題的能力記「不可測」,不算 0 分。唯一的例外是下面的事故重播:那組照實際交出來的答案打分,卡住的那幾題在那裡記 0 分。
七題事故重播有四題完整跑完。和 MiniCPM-V 4.7 匿名盲評,根因給 0–2 分、安全的處理方式給 0–1 分,整組 10/21 對 9/21。Inkling 有兩題拿滿分,MiniCPM-V 4.7 一題都沒有。
評測台的兩個 bug:都在我這邊,不在 Inkling
- 工具逾時只殺父 shell。 agent 的
bash工具逾時時只殺掉父 shell,find | grep | head繼續跑,把 stdout 卡住。現在改成殺整個 process group,拿 1 秒的探針測,1,007–1,011 ms 結束,沒有殘留。 - 沙箱讀得到答案。 一題規則檔第一次跑時,
find摸到那一題的歷史答案檔,讀了兩行。那次作廢,擋掉候選模型自己 workspace 以外的所有路徑,開新 session 重跑,只算重跑那次。
量測附註
- 5090 開了
--enforce-eager:沒有 CUDA graphs,也沒有 torch.compile。這是這組設定的數字,不是框架的上限。 - 吐字速度 = (completion tokens − 1) ÷ 第一個到最後一個內容 chunk 的時間,含推理 token。單路 9 發取中位數(中文、英文、程式各 3 發)。
- 時間用逐題秒數加總(141 / 272 / 390 分)。1 遍那組整組實際跑的總時間,在續跑時少算了 488.7 秒,而且三組的路數不一樣(1 遍開 4 路,3 遍和 5 遍開 2 路),所以整組總時間不能比。
- 三組都答對的 35 題:平均輸出 3,288 / 2,472 / 3,028 token,平均時間 48 / 81 / 153 秒(1 / 3 / 5 遍)。
- 2080 Ti 的軟體:llama.cpp master
afe77e18,sm_75,Release。這個版本已經包含 PR #32704(GitHub 比對:比合併點新 13 個 commit、沒有落後)。這份 GGUF 也沒有 NVFP4 張量,同樣那 18 題兩張卡都對 14 題,表示輸出正常。 - 2080 Ti 3 遍開四路,每路吐字 12.9 / 15.2 / 21.7 / 19.9 tok/s。有一次四路測速,其中 3 路產生了 512 token 卻沒有可見內容,原因沒查。
常見問題
- Inkling 的迴圈是什麼?解決什麼問題?
- Inkling 2 Mini 實體上只有 24 層,前 6 層和後 6 層各跑一次,中間 12 層用同一份權重連跑 3 次,每個 token 一共跑 48 層。要更深的模型不必多存一倍權重,檔案約 20 GB,32 GB 的卡就放得下;省的是權重,不是計算,權重共用本身不會讓它變快。研究版 TML-d24-varloop-research 還能在啟動時改成 1 到 5 遍。
- TML-d24-varloop-research 的迴圈遍數要怎麼改?
- vLLM 啟動時用 --hf-overrides 把 text_config 裡的 loop_num_passes 設成 3;llama.cpp 用 --override-kv inkling2_loop.loop.count=int:3。研究版訓練時跑過 1 到 5 遍,post-training 用 3 遍;正式版 Inkling 2 Mini 固定 3 遍。
- Inkling 跑 3 遍值不值得?
- 我在 RTX 5090 上跑 60 題競賽數學與推理,1 遍答對 39、3 遍 46、5 遍還是 46,單路吐字從 76.7 掉到 31.6 再掉到 19.9 tok/s。3 遍多對 7 題,總時間大約翻倍;5 遍分數沒變,只多花 43% 的時間。拿來跟常駐在 2080 Ti 上的 MiniCPM-V 4.7 比,3 遍難題多對 7 題,速度只有它三分之一,所以那張要快的卡沒換,要難題能力時再開 Inkling。
- 換更小的量化,2080 Ti 跑 Inkling 會變快嗎?
- 我推估不會快多少,更小的檔我沒跑。從 1 遍到 3 遍,每個 token 用到的參數是 1.6 倍、要跑的層數是 2 倍,2080 Ti 吐字實測慢了 2.13 倍,比較接近層數的倍數。更小的量化縮的是權重,不是層數;3 遍要追上 MiniCPM-V 4.7 得快 2.8 倍,我推估只換量化達不到,沒有實測。
接著讀
- 2026-11-17[Benchmark] RTX 5090 單卡用 QEngine 跑 Qwen3.8-27B:寫程式 359 tok/s,2080 Ti 編不出來
QEngine 是專為 Qwen3.8 寫的 CUDA 推論引擎,作者只在 Linux 加 3090 測過。我在 Windows 的 RTX 5090 用 WSL2 單卡跑 Qwen3.8-27B:寫程式 358.5、英文 225.1、中文 109.1 tok/s,同卡 llama.cpp 不開草稿 69、開草稿寫程式 155。附安裝步驟、VRAM 用量,還有 2080 Ti 為什麼編不過。
- 2026-10-19[Dev Workflow] 一張 2080 Ti 撐起每天所有新聞短片的配音:VoxCPM2 GGUF Q4,一句兩秒
用一張 RTX 2080 Ti 跑 4-bit 的 VoxCPM2 GGUF,複製自己的聲音,幫每天好幾支中英雙語新聞短片配音,一句不到兩秒。從編 llama.cpp-omni、接成常駐服務、念錯專名怎麼標,到怎麼讓 whisper 當關卡又不冤枉人,一次講完。
- 2026-08-18[洋垃圾跑大模型 #5] 一張 22G 老卡跑 Qwen3.8-27B:30 tok/s,還能一次寫出會動的 3D 場景
unsloth 的 Qwen3.8-27B-UD-Q4_K_XL 在一張改裝 2080 Ti 22G 上跑得動:16.7 GiB 權重、開到 128K context 還剩 1.7 GB、實測 30-31 tok/s。附一個它一次生成的體素庭園,可以直接開來玩。
- 2026-11-22[Benchmark] llama.cpp 升級要自己帶上 chunked prefill 補丁:2080 Ti 混跑短題 5.4 秒
一張 2080 Ti 22G 的 MiniCPM-V 4.7 從 llama.cpp b11588 升到 b12595,每條吐字快 3–10%,但上游沒有 chunked prefill,長短混跑時短題從 7.3 秒變 16.8 秒。補丁移植過去之後短題 5.4 秒,每條比舊版快 5–12%。附 35 行補丁與測試腳本。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。