[影像生成] 同一個人換 8 套衣服臉都不跑:Qwen-Image 2.1 在 RTX 5090 實測
❯ cat --toc
TL;DR
Qwen-Image 2.1 是 Qwen 團隊 9 月放出權重的生圖模型。我拿一張自己生的人物照當參考圖,提示詞寫「同一個人,只換衣服」,換了 8 套衣服,臉、左眼下的痣、木髮簪都沒跑;固定衣服換 8 個場景、衣服場景一起換也一樣。招牌繁中八個字全對、能直接出透明背景 PNG。錯了兩處:英文海報 NIGHT 的 N 被 101 擋住,菜單「衣索比亞」的亞變成簡體。
短片版:同一個人換衣服、換場景的定格快切
前言
要讓同一個角色出現在一系列圖裡,以前我的做法是先訓練一顆角色 LoRA(LoRA 是一個外掛的小檔案,專門教模型認得某一張臉):準備素材、訓練、再一張張試。不練的話,換一套衣服,生出來常常就是另一個人。
Qwen-Image 2.1 讓我想換掉這套流程。它是 Qwen 團隊 9 月 20 日放出的生圖模型,權重可以下載,授權是研究用途,商用要另外跟 Qwen 申請。它可以吃參考圖:丟一張人物照進去,跟它說「同一個人,只換衣服」,臉就不會換成別人。這篇在 RTX 5090 上測它最好用的兩件事:同一個人在同一個場景換 8 套衣服,以及同一套衣服換 8 個場景。順便測了圖裡的中英文字和透明背景,寫錯的地方也一起列出來。
同一個人換 8 套衣服:臉、痣、髮簪都沒跑
先看結果。左上是基準圖,其他八張都是拿它當參考圖改出來的,提示詞只換「她現在穿什麼」那一句。人站的位置和大小也沒動,這是改過一次做法的結果,做法下一節講:
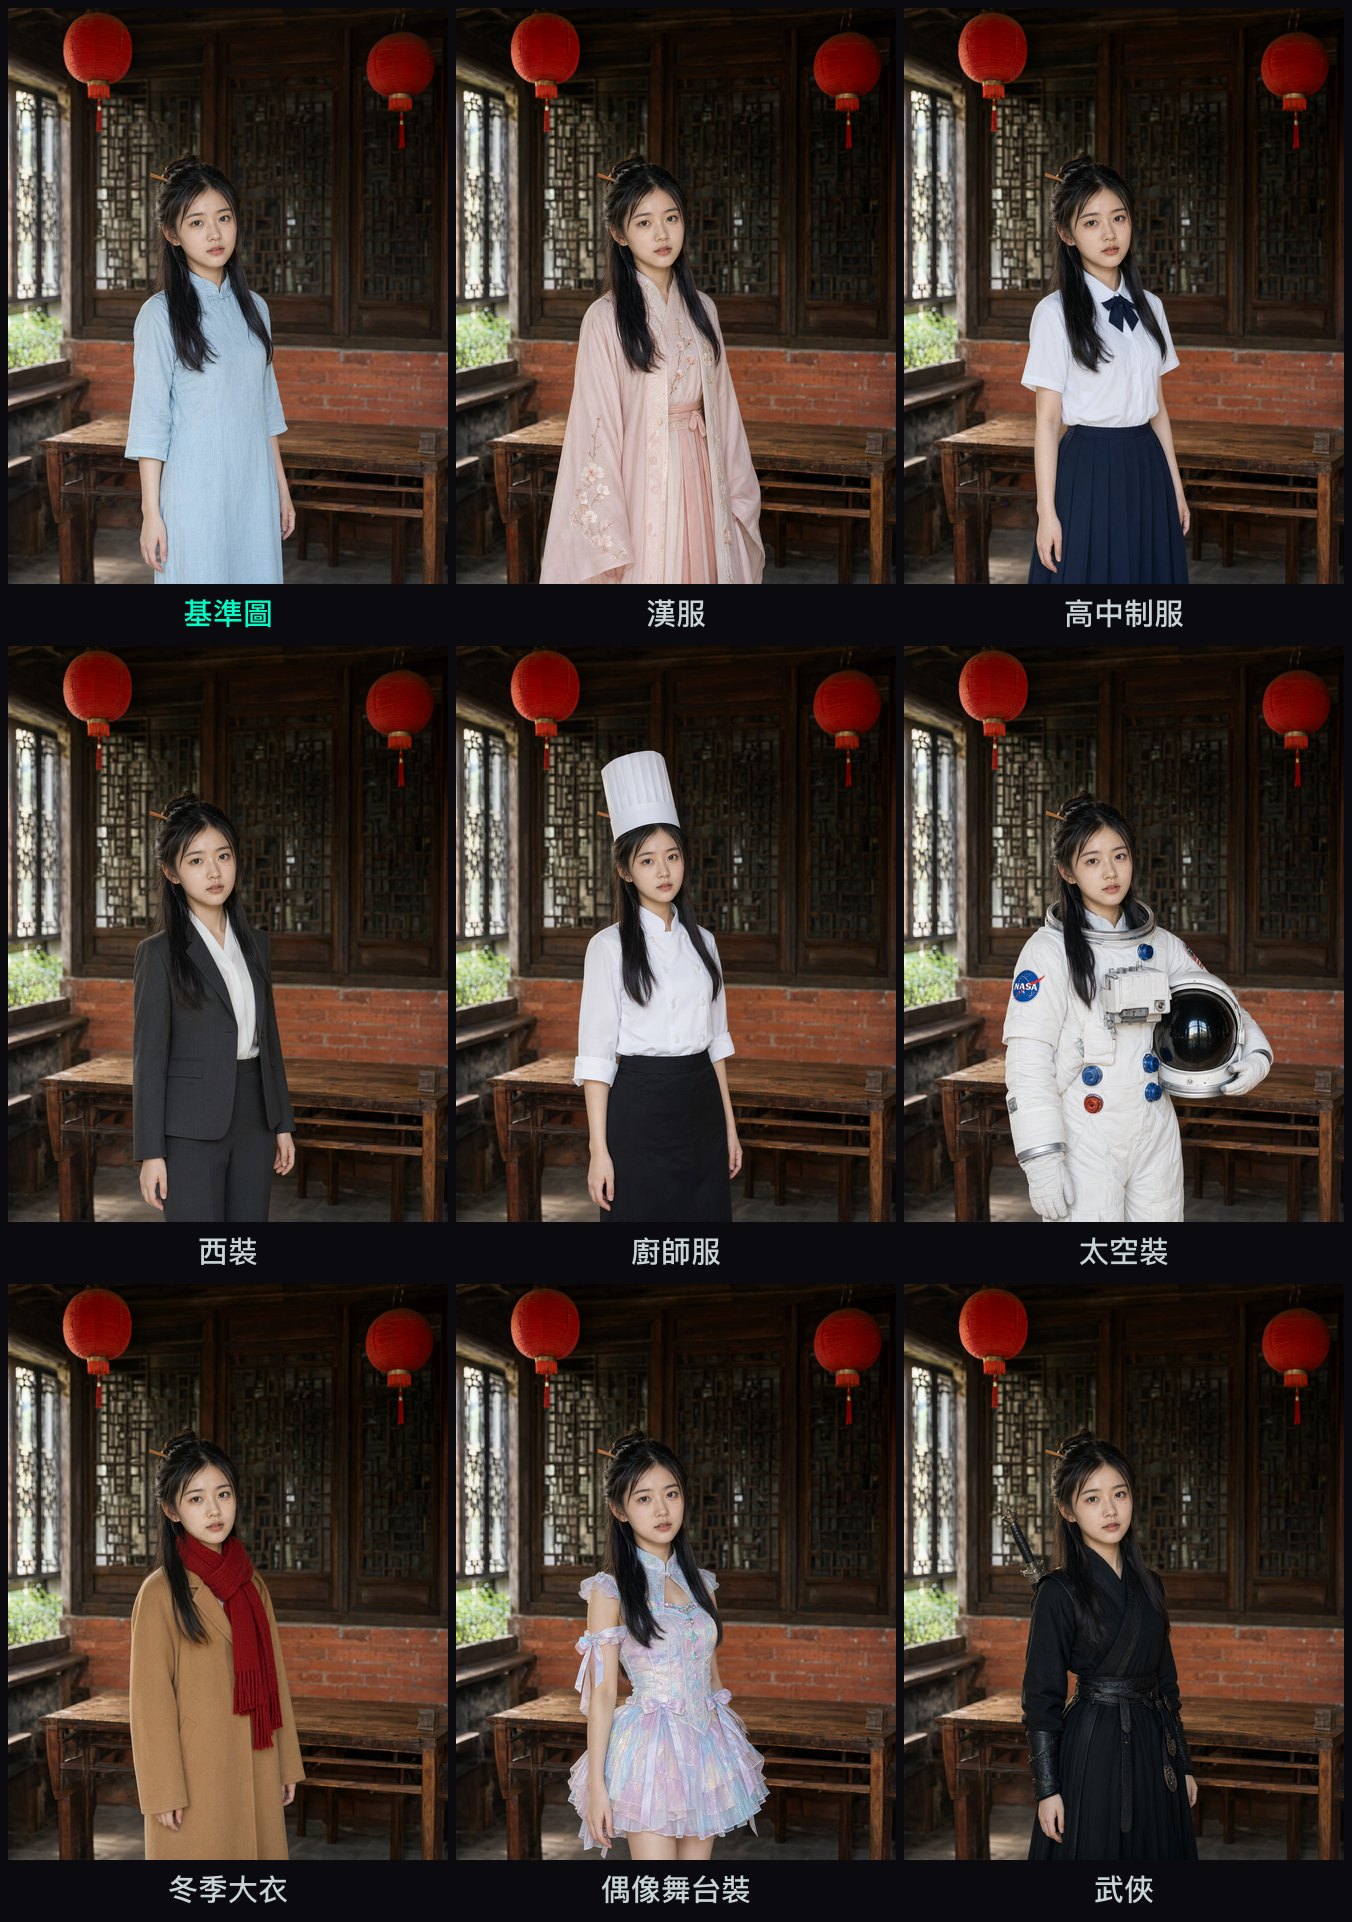
背景的紅燈籠、窗格、磚牆和茶桌八張都在原位。衣服細節也照提示詞長出來:漢服上有繡梅花、太空裝把頭盔夾在左手臂下、武俠裝背上背著劍。
臉要放大看才準。下面把九張的臉裁在一起:
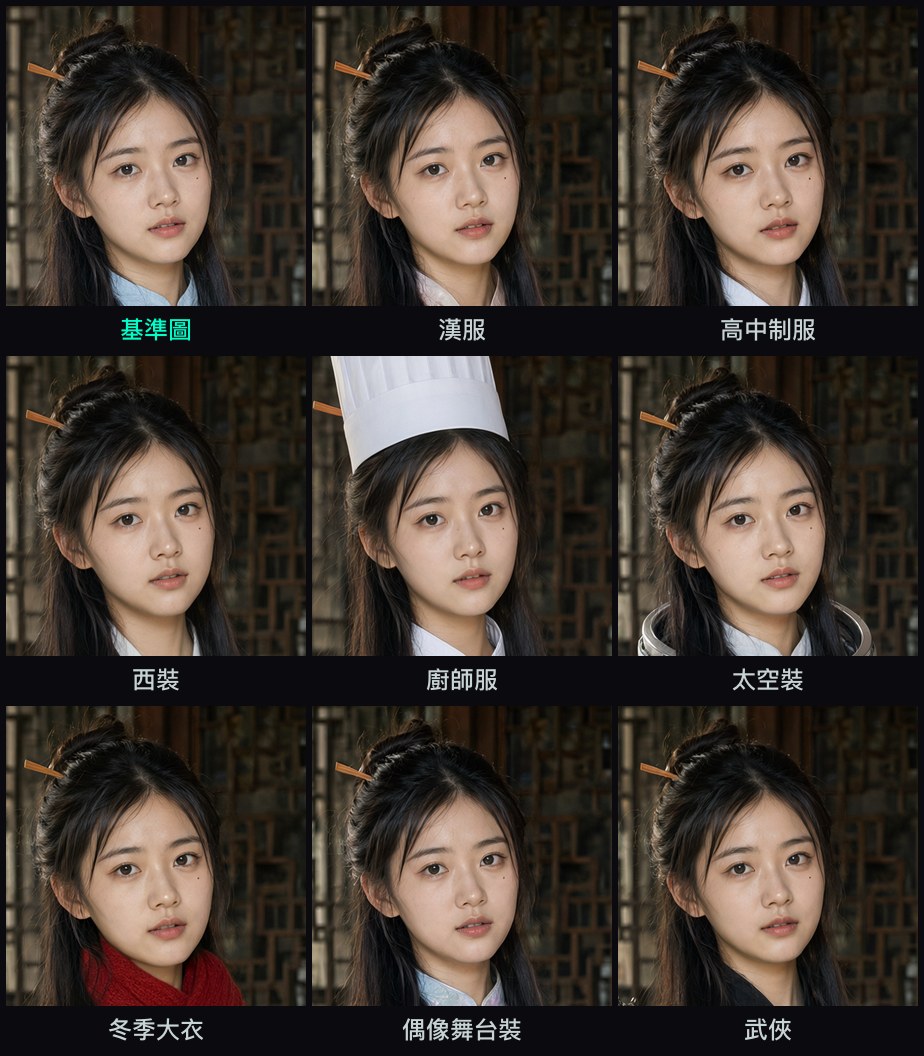
左眼下那顆痣九張都在。戴廚師帽那張,木髮簪從帽子旁邊戳出來。
做法:一張參考圖加一句「只換衣服」
流程只有三步:準備一張基準圖、把它交給模型當參考、寫提示詞。這節是給想在自己電腦上做一次的人,下面會出現檔名和設定;只想看它做得到什麼,可以直接跳到下一節。
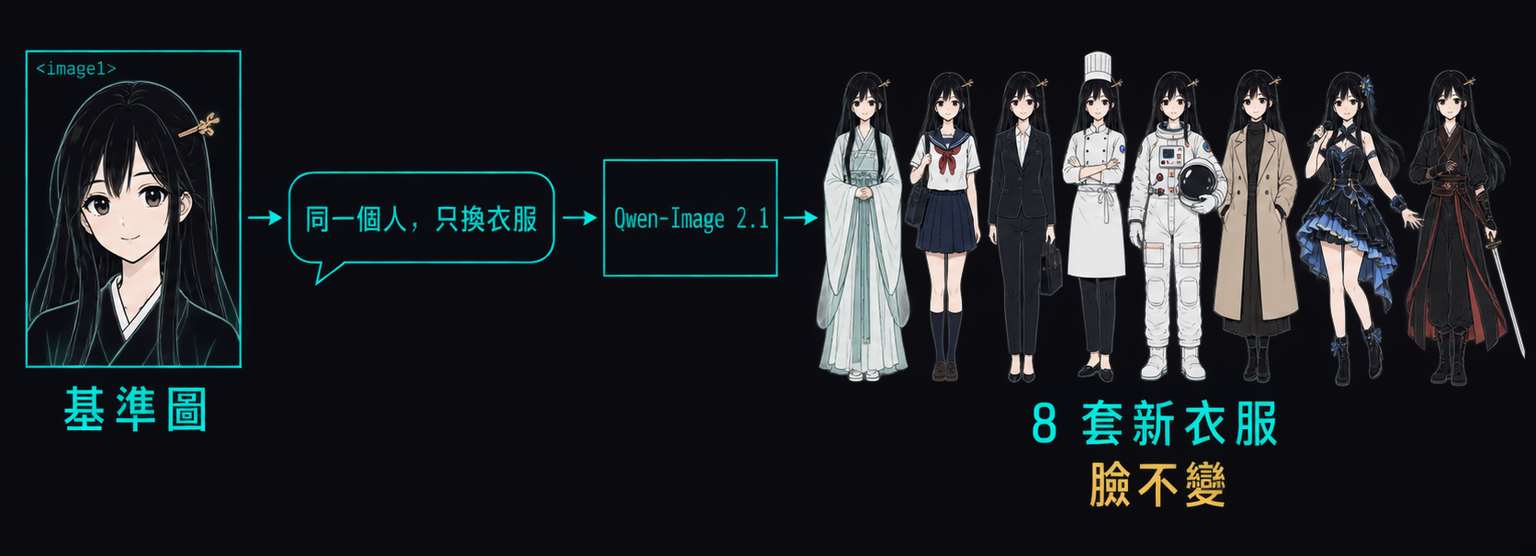
我用的工具是 ComfyUI,一套免費的本機生圖軟體:畫面上是一個個功能方塊,用線接起來就是一條生圖流程。你不用自己接,官方已經做好 Qwen-Image 2.1 的範本,打開來換圖、改字就能跑。
1. 裝好 ComfyUI,下載三個模型檔。 ComfyUI 要更新到範本清單裡有 Qwen-Image 2.1 的版本,我用的是 0.37.0。模型檔從 Comfy-Org/Qwen-Image-2.1 下載,放進 ComfyUI 的 models 底下對應的資料夾:
| 放哪個資料夾 | 檔案 | 大小 | 它負責什麼 |
|---|---|---|---|
diffusion_models | qwen_image_2.1_int8_convrot.safetensors | 6.76 GiB | 畫圖的主模型 |
text_encoders | qwen3vl_8b_w4a8.safetensors | 5.88 GiB | 讀懂你的提示詞和參考圖 |
vae | qwen_image_2.1_vae_bf16.safetensors | 0.63 GiB | 把結果轉成看得到的圖 |
主模型有原版(bf16)和壓縮版(int8)兩種,int8 是 Comfy-Org 壓好的版本,我自己拿同一段提示詞比過,畫質跟原版很接近,檔案只有一半,32 GB 的 5090 放得很輕鬆。
2. 打開編輯範本,放進基準圖。 在 ComfyUI 的範本清單選「Qwen Image 2.1 Image Edit」。範本預設的文字編碼器是另一個檔名(qwen3vl_8b_int8_convrot),在載入它的方塊裡改選剛下載的 qwen3vl_8b_w4a8 就好;範本裡另一條「自動改寫提示詞」的支線保持關閉。
接著把基準圖拖進載入圖片的方塊,它會接到 Text Encode Qwen Image 2.1 的 image_1,提示詞裡就能用 <image1> 叫它。官方範本最多接 10 張參考圖,這篇只用一張。
範本裡有一個 custom_size 開關,保持關閉(預設就是關)。關著的時候,取樣用的畫布是 Text Encode Qwen Image 2.1 的 latent 輸出(latent 可以想成模型作畫用的空白畫布),尺寸跟縮放後的參考圖一樣;打開就改用你自己填的寬高。我第一批圖就是自己指定 1536×2048 的畫布,跟參考圖縮放後的 1344×1760 不一樣,人在畫面裡的位置和大小就飄掉了,細節在進階那節。我把 resolution 設成 1536,參考圖會縮成 1344×1760,生出來的圖也是這個大小。
我的基準圖也是 Qwen-Image 2.1 生的:同一段描述用三個 seed(亂數種子,換一個數字就是另一張圖)各跑一張,挑了其中一張。你用自己拍的照片也行。
3. 寫提示詞。 我的寫法是先把要保留的東西一條條講清楚,再加一句鎖住構圖,最後才講要改什麼:
The same woman from <image1>, with exactly the same face, the same small mole
under her left eye, the same hairstyle with the wooden hairpin, the same standing
pose, in exactly the same tea house background with the same red lanterns,
windows, brick wall, tea table and lighting. Keep exactly the same framing, crop
and camera distance as <image1>. Only change her clothing: she now wears a
tailored charcoal-grey business suit jacket and trousers with a white blouse.
Keep everything else unchanged. Photorealistic.
中間那句「Keep exactly the same framing…」是後來補的。沒有它的時候,西裝和大衣那兩張會自己把鏡頭拉遠,變成連鞋子都入鏡的全身照。衣服描述裡也別提鞋子,提到高跟鞋、靴子,它就會想把腳畫進來。
八張圖的提示詞前半段一樣,只換冒號後面那句衣服。不用照抄,把「哪些不准動、只改哪一樣」講清楚就好。
4. 生一張看一眼。 大部分一次就成。那臉的位置跑掉怎麼辦?我的做法是同一句提示詞多跑 3 個 seed,挑臉最接近原圖位置的那張;這篇 23 張改出來的圖裡,有 7 張是這樣挑的。
取樣設定我用 40 步、euler、simple、cfg 1.0。官方範本預設 25 步,官方 pipeline 建議 40 到 50 步,我取 40 步,細節多一點。
換 8 個場景也一樣:同一套旗袍走遍夜市到沙漠
反過來做:衣服和姿勢固定,只換背景和光線。提示詞改成保留臉、痣、髮簪、淺藍旗袍和站姿,一樣加上鎖構圖那句,「Only change the background and lighting」後面接新場景:
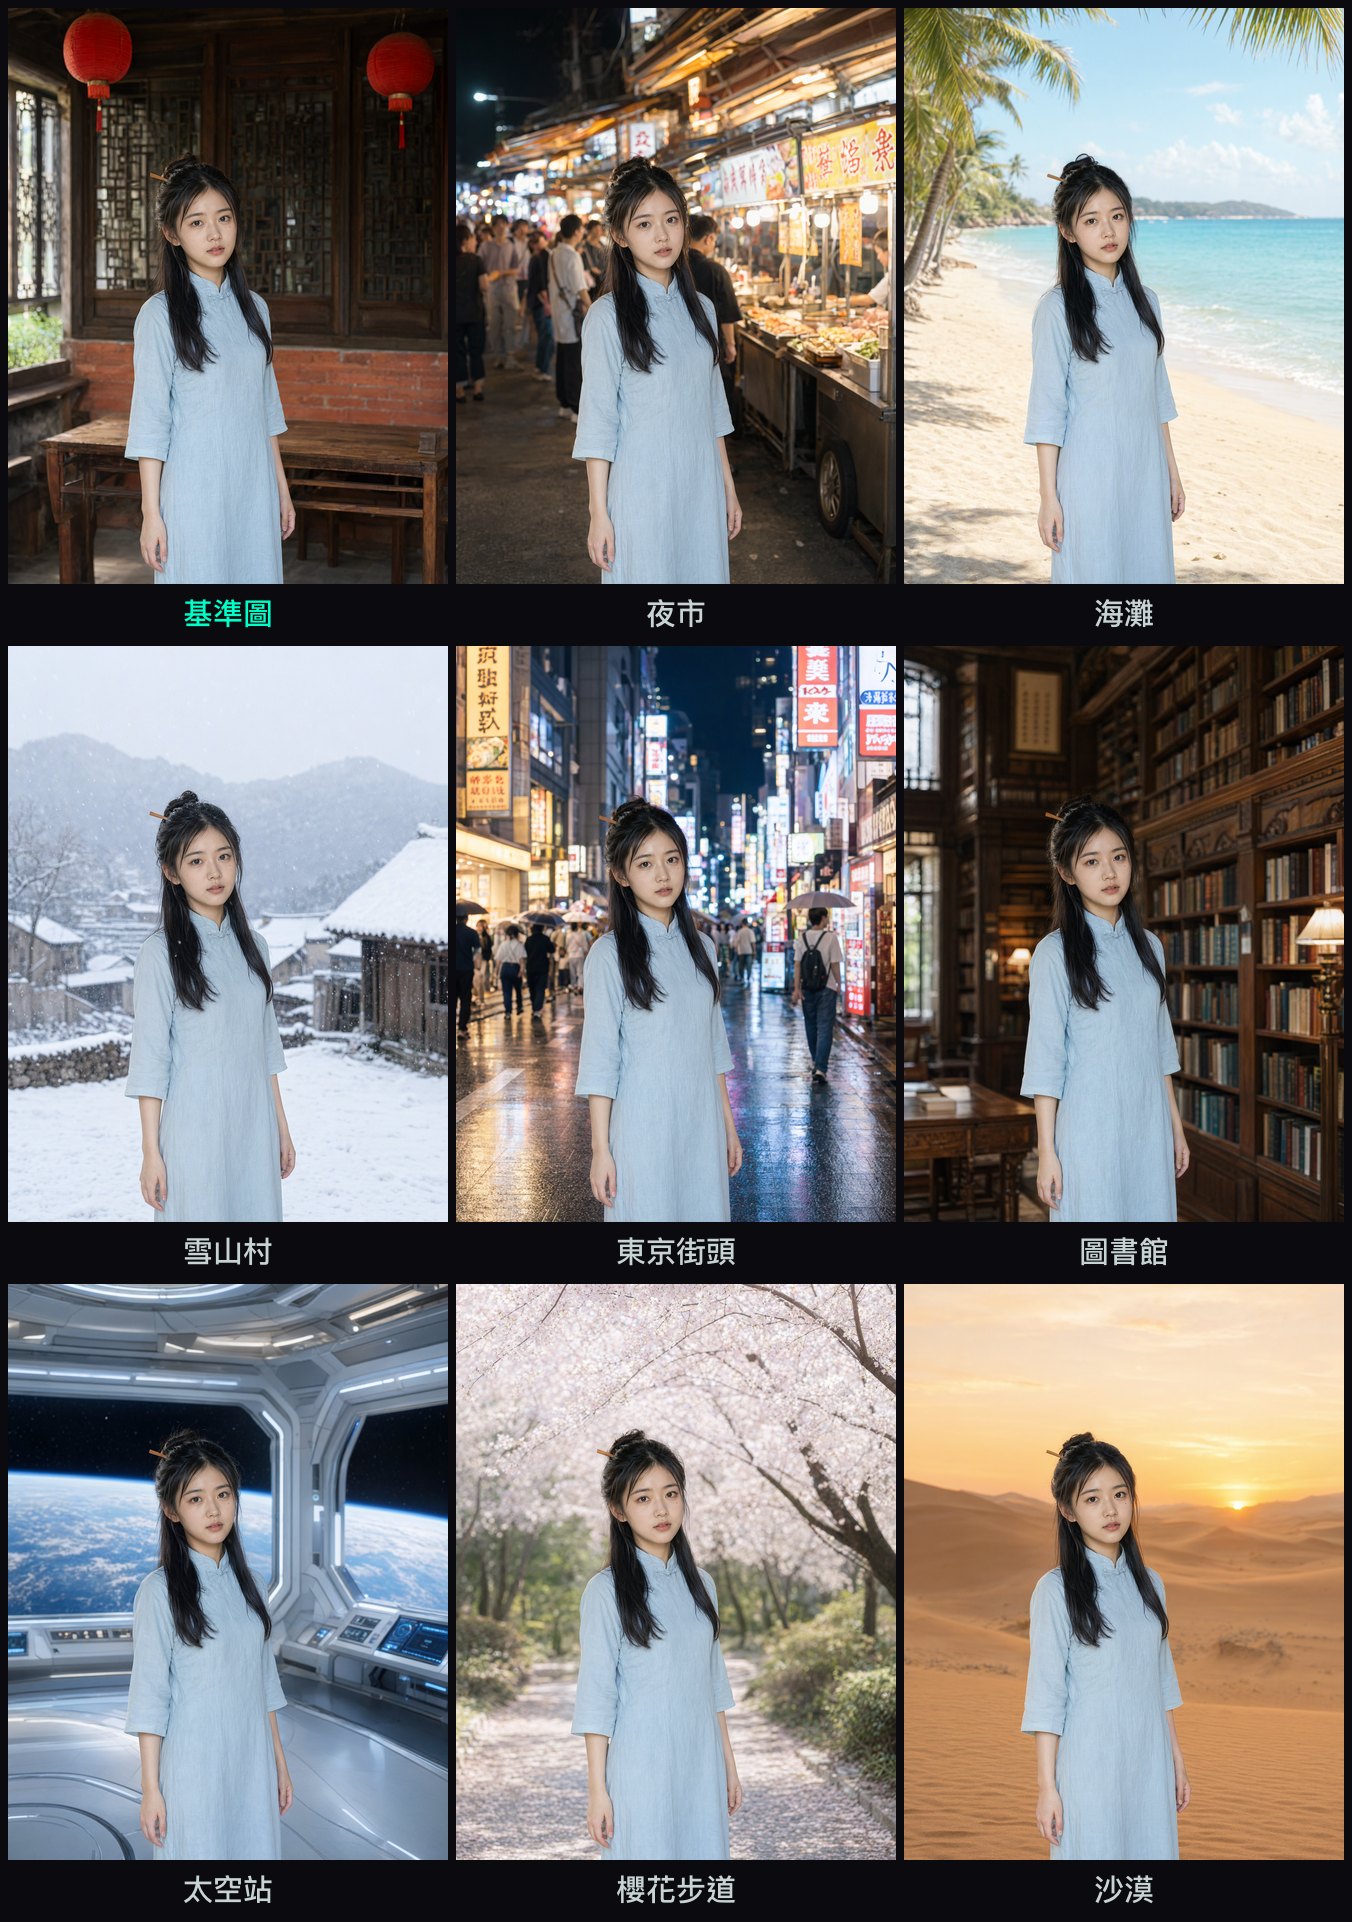
光線有跟著場景變:東京街頭的濕地面映出霓虹,沙漠那張臉上帶一點夕陽的暖色。人還是同一個人,髮簪也都在。
衣服和場景一起換:分兩次做
想要「穿漢服站在櫻花樹下」,我沒有一句提示詞同時改兩樣,而是分兩次:先換衣服,再拿換好衣服的那張當參考圖換背景。第二次的提示詞更短,因為衣服已經在參考圖裡了:
The same woman from <image1>, with exactly the same face, hairstyle, clothing and
standing pose. Keep exactly the same framing, crop and camera distance as <image1>.
Only change the background and lighting: she now stands in a park path under
full-bloom cherry blossom trees. Photorealistic, natural light matching the new scene.
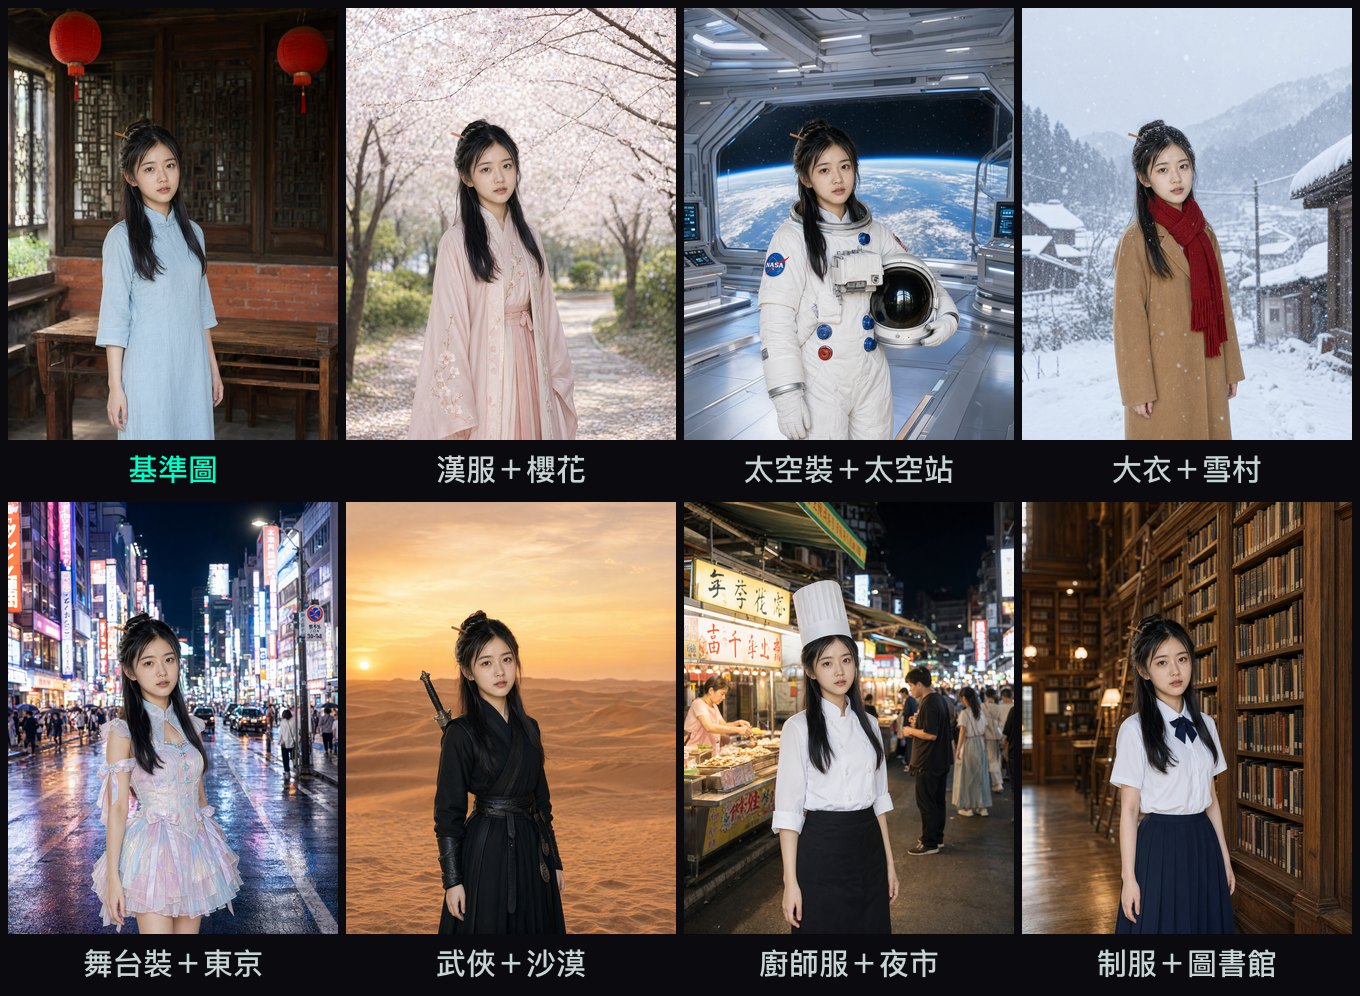
七張都是同一張臉、同一個站位,跟前面換裝和換場景的 16 張放在一起,可以剪成定格快切的短片。
圖裡的字:繁中招牌全對,兩個地方寫錯
Qwen-Image 系列最有名的是會在圖裡寫字,這次我也測了三張。
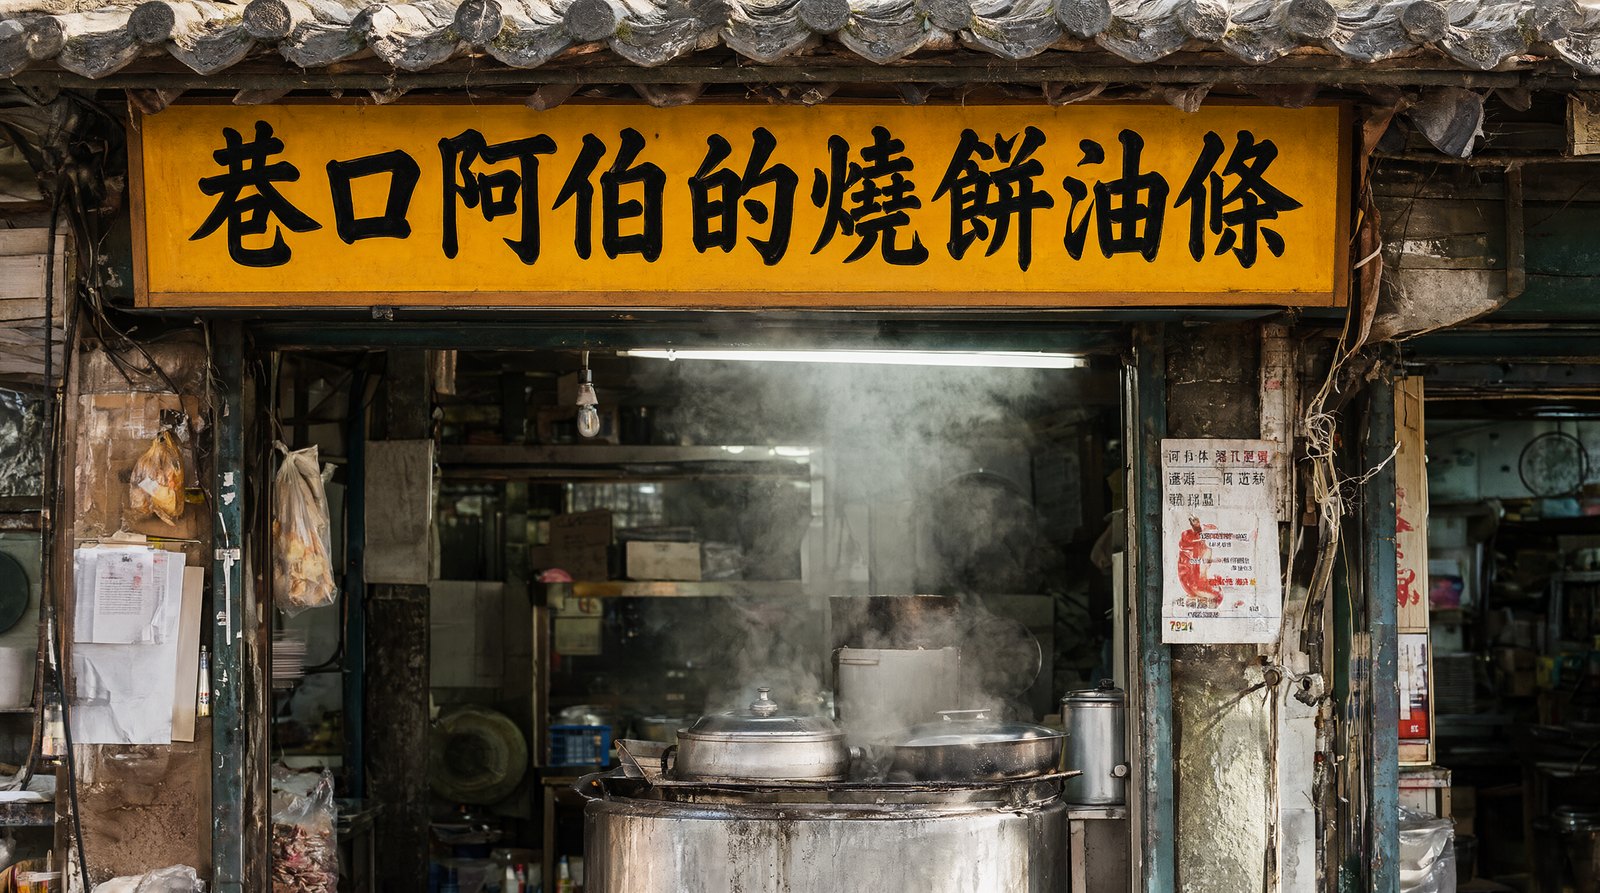
繁中招牌。 提示詞要求招牌寫「巷口阿伯的燒餅油條」,八個字全對,連「燒」「餅」「條」這些筆畫多的字都是繁體:
英文海報和中英菜單。 海報要求大標「VISIT TAIPEI AT NIGHT」、底下一行「Night markets · Hot springs · Bubble tea」;菜單要求中英品名加價錢。兩張的英文拼字和四個價錢全對,錯的是這兩處:
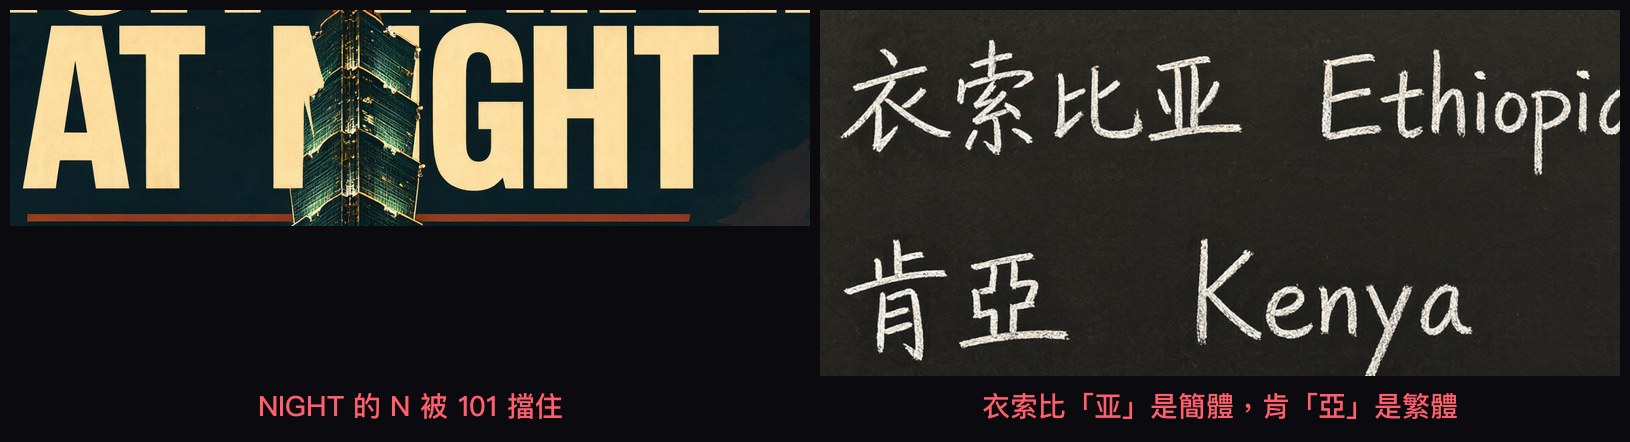
- 海報的 101 從標題中間穿過去,剛好把 NIGHT 的 N 擋住,只剩右邊一條。
- 菜單「衣索比亞」的亞寫成簡體「亚」,下一行「肯亞」的亞卻是繁體。
另外,提示詞沒指定的小字它會自己編。夜市那幾張,背景攤位招牌是一堆看起來像中文、其實不成字的筆畫。要放進正式作品的字,最好都寫進提示詞,密密麻麻的小字還是交給排版軟體。
直接生透明背景 PNG,不用另外去背
提示詞前後各加一句固定句型,輸出就是透明背景的 PNG:
This is an RGBA image with transparency. A cute chibi sticker of a cat barista
holding a cup of bubble tea, thick white sticker border, flat colors. The image
has alpha channel and the background is transparent.
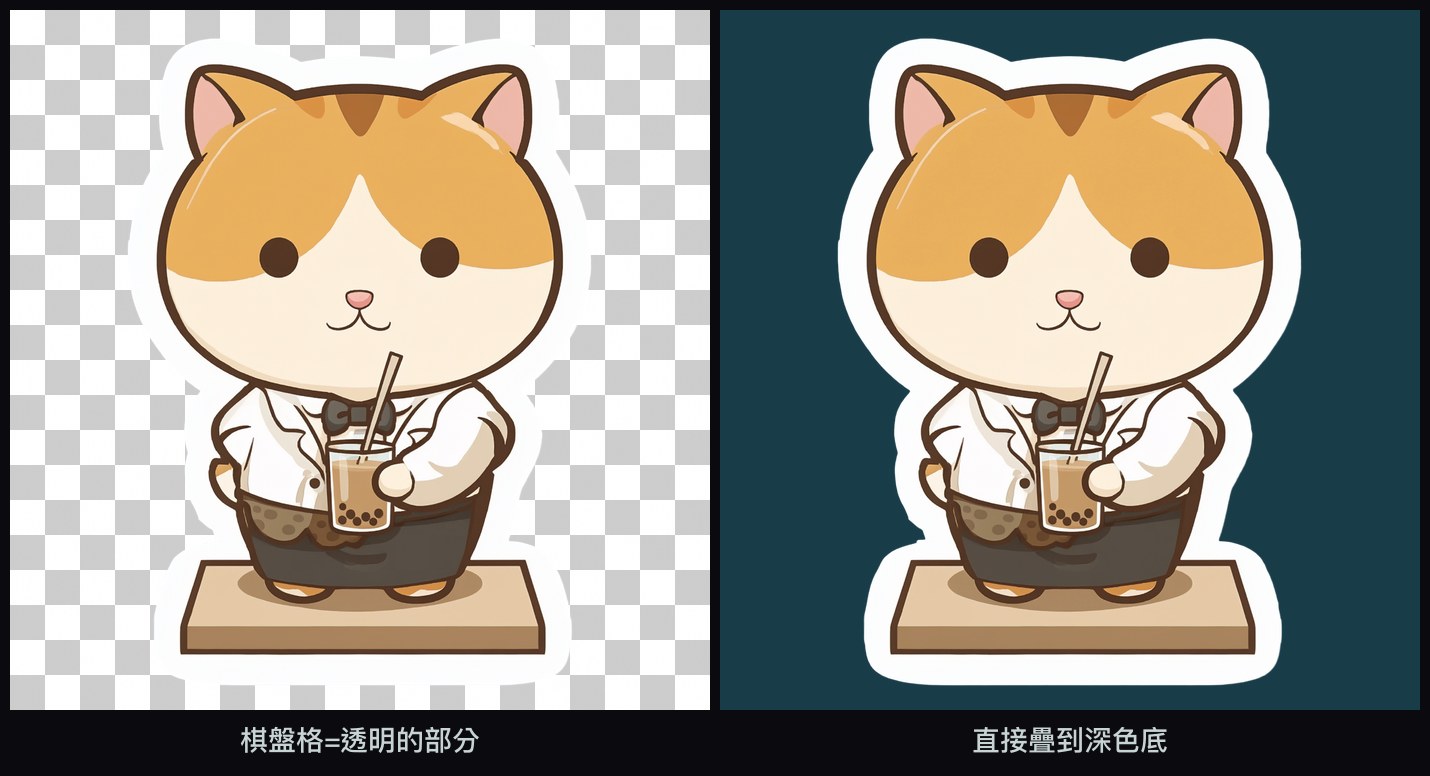
做貼紙、做簡報素材、疊到影片上都能直接用,省掉一道去背。
速度:5090 改一張約 5.5 秒,2080 Ti 約 11 秒
速度不是這篇的重點,只列「生一張、改一張要等多久」。兩台機器的設定不一樣,數字不能直接比:
| RTX 5090 | 改裝 2080 Ti 22G | |
|---|---|---|
| 權重與步數 | int8,40 步 | Viggle 加速版 v0.3 int8,6 步 |
| 生一張 1024×1024 | 約 6.4 秒(疊 4 步 LoRA 約 1.2 秒) | 約 7.5 秒 |
| 拿參考圖改一張 | 約 5.5 秒(768×1024) | 約 10.8 秒 |
數字都是熱機後的秒數,每組跑三次。這篇的基準圖是 1536×2048,在 5090 上生一張約 22.5 秒。
2080 Ti 那欄是我家裡日常用的設定,跑在這張改裝 22G 的 2080 Ti 上;它沒有 bf16,要先讓 ComfyUI 改用 fp16 算才快得起來,細節在下面進階那節。
進階:完整設定、提示詞與踩到的坑
不讀這節不影響使用。這裡是給想重現、或想把整篇丟給 AI 參考的人看的。
這篇所有圖的生成設定
- 機器:RTX 5090 32 GB,ComfyUI 0.37.0,torch 2.13.0+cu130,comfy-kitchen 0.2.35。
- 主模型:
qwen_image_2.1_int8_convrot.safetensors(6.76 GiB)。 - 文字編碼器:
qwen3vl_8b_w4a8的社群改版(heretic,改成不會拒答)。官方版對某些提示詞會拒答,所以我日常固定用這顆;這篇的提示詞沒有任何會被拒的內容。 - VAE:
qwen_image_2.1_vae_bf16.safetensors。 - 取樣:40 步、
euler、simple、cfg 1.0,沒有疊加速 LoRA。 - 解析度:基準圖 1536×2048;換裝、換場景、衣服場景一起換都是
resolution1536,輸出 1344×1760;招牌 2752×1536,海報 1536×2048,菜單和貼紙 2048×2048。 - 取樣起點:
Text Encode Qwen Image 2.1的latent輸出,不接EmptyLatentImage。 - 基準圖:同一段描述跑 seed 202001–202003 三張,選 202002。
- 換裝:漢服、制服、廚師服、太空裝、舞台裝、武俠裝各跑一次(seed 303000、303001、303003、303004、303006、303007);西裝和大衣改過提示詞後各跑 3 個 seed,選 707000、707003。
- 換場景:seed 808000–808007 各一次,圖書館那張位置偏了,另跑 3 個 seed 選 909132。
- 衣服場景一起換:大衣雪村 809002、舞台裝東京 809003、制服圖書館 809006 一次就成;漢服櫻花、太空裝太空站、武俠沙漠、廚師夜市各跑 3 個 seed,選 909022、909033、909077、909099。
- 圖都是 2026-10-09 重新生成的。
基準圖與換場景的提示詞
基準圖(文生圖,沒有參考圖):
Full-body photograph of a young Chinese woman in her twenties standing in the exact
center of the frame, facing the camera, long black hair in a half-up bun with a simple
wooden hairpin, oval face, small mole under her left eye. She stands in an old Taiwanese
tea house: dark wooden lattice windows, two hanging red paper lanterns, a red brick wall
and a low wooden tea table behind her. She wears a pale-blue cotton qipao. Soft afternoon
window light from the left, photorealistic, 50mm lens, natural skin texture.
換場景(以夜市為例,其他七張只換冒號後面的地點):
The same woman from <image1>, with exactly the same face, the same small mole under her
left eye, the same hairstyle with the wooden hairpin, the same pale-blue qipao and the
same standing pose. Keep exactly the same framing, crop and camera distance as <image1>.
Only change the background and lighting: she now stands in a busy Taiwanese night market
at night with glowing food stalls. Photorealistic, natural light matching the new scene.
換裝八句衣服描述:粉色宋制漢服、台灣高中制服、炭灰色西裝外套加長褲、白色雙排扣廚師服加高帽、NASA 風格太空裝(頭盔夾在左臂下)、駝色長大衣加紅圍巾(這兩句原本有高跟鞋和皮靴,後來拿掉)、粉彩偶像舞台裝、黑色武俠裝背劍。換場景八個地點:夜市、熱帶海灘、雪山村、雨後的東京霓虹街、老圖書館、看得到地球的太空站、櫻花步道、日落沙漠。
第一批為什麼人會跑:畫布尺寸跟參考圖對不上
第一批換裝換場景,我在取樣前自己接了一個 1536×2048 的 EmptyLatentImage。Text Encode Qwen Image 2.1 在 resolution 1536 時會把參考圖縮成 1344×1760,兩邊尺寸不一樣。ComfyUI 原始碼裡這個節點的 latent 輸出說明寫的就是這件事:「Empty latent on the first reference image's size, to match with sampling as any other size shifts the edit.」那個 latent 是空的(全零),不帶原圖內容,它的作用是讓畫布跟參考圖一樣大。官方範本的 custom_size 開關打開時,走的就是我第一批那條路。
我用 YuNet 臉部偵測量兩批圖的兩眼中點和眼距,全部先縮到 1344×1760 再量:
| 張數 | 眼睛中點 x | 眼睛中點 y | 眼距 | |
|---|---|---|---|---|
| 第一批(自己指定 1536×2048) | 17 | 548–634 | 501–696 | 54.5–83.1(±18.9%) |
| 最終批(接節點的 latent) | 24 | 611–627 | 645–661 | 73.5–79.6(±3.9%) |
兩批都含基準圖本身(中點 618, 650、眼距 79.2)。第一批偏最多的是西裝和大衣(眼距 58.4、54.5,人被拉遠)和櫻花那張(x 偏到 548)。
西裝和大衣:換對畫布還是會拉遠
畫布尺寸改對之後,西裝和大衣那兩張還是自己拉成全身照。只換 seed 沒用:同一句提示詞各跑 3 個 seed,6 張的眼距都在 51.3–59.3(基準圖 79.2)。
第二輪我同時改了兩件事:加上 Keep exactly the same framing, crop and camera distance as <image1>. 這句,並把衣服描述裡的高跟鞋和皮靴拿掉。改完之後同樣各跑 3 個 seed,6 張眼距都在 77.7–79.5。兩件事是一起改的,我沒有分開測哪一個才是關鍵,所以正文兩個都照做。
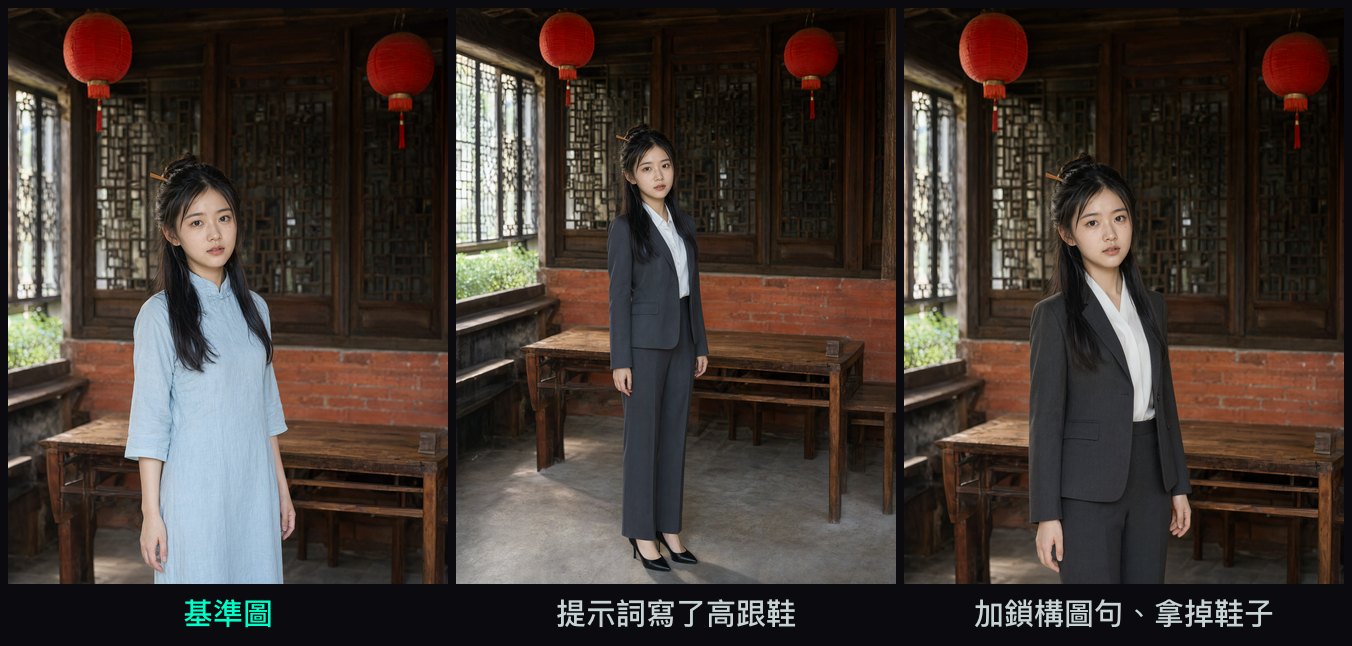
換裝那組也有小幅漂移
臉和背景穩,手和站姿會跟著衣服小幅調整。提示詞寫的是「the same standing pose」,但太空裝要用左手夾頭盔,手本來就得動。
ComfyUI 0.37.0 自己組 workflow 會遇到的兩個坑
- 0.37.0 的
TextEncodeQwenImage21有兩個必填欄位negative_prompt和resolution。自己組 workflow 漏掉其中一個,API 會回 HTTP 400required_input_missing。補上兩個欄位就好。 - 送一個跟上一次完全相同的 workflow,ComfyUI 會直接回快取:0.0 秒、同一個檔名。量速度或想要新圖,記得換 seed。
一般圖其實也帶透明度
Qwen-Image 2.1 輸出的 PNG 是 RGBA,就算沒要求透明,alpha 也不是全部 255,最低看過 251,肉眼看不出來。要疊到網頁或拿去合成前先轉成 RGB,不然邊緣可能有一點點透。
速度怎麼量的
每組在熱機狀態連跑三次,換 seed 避開快取,時間從送出到拿到圖。原始三次(秒):
| 機器 | 項目 | 三次 |
|---|---|---|
| 5090 | 1024² 生圖,4 步 LoRA | 2.26 / 1.22 / 1.20 |
| 5090 | 1024² 生圖,40 步 | 6.88 / 6.37 / 6.40 |
| 5090 | 768×1024 改圖,40 步 | 7.4 / 5.5 / 5.5 |
| 5090 | 1536×2048 生圖 / 改圖,40 步 | 約 22.5 / 約 32.7 |
| 2080 Ti | 1024² 生圖,Viggle 6 步 int8 | 8.9 / 7.5 / 7.6 |
| 2080 Ti | 1024 改圖,Viggle 6 步 int8 | 16.6 / 10.8 / 10.8 |
第一次比較慢,是載入模型和參考圖的時間,正文取後兩次。4 步 LoRA 是 Viggle/Qwen-Image-2.1-viggle-turbo 的 4step-lora-r64;作者在說明裡寫,要維持同一張臉、或提示詞限制很多的改圖,4 步版還是可能比原版差,臉會跑掉(identity drift)。這篇的換裝換場景剛好都要維持同一張臉,所以都沒用它。
2080 Ti 用的是同一個 repo 的 v0.3-6step-int8_convrot 合併版,6 步、cfg 1.0。Turing 架構沒有 bf16,ComfyUI 預設會退回 fp32 算,慢很多;我在 ComfyUI 的 QwenImage21.supported_inference_dtypes 加上 fp16,再換成 torch 2.9.1+cu130,同一顆 int8 40 步從 159 秒降到 42 秒,之後才改用 6 步加速版。
常見問題
- Qwen-Image 2.1 怎麼讓同一個人換衣服、臉不跑?
- 把人物照接到 ComfyUI 的 Text Encode Qwen Image 2.1 節點的 image_1,取樣的畫布用同一個節點的 latent 輸出(尺寸會跟參考圖一樣),提示詞用 <image1> 指名這個人,把要保留的臉、痣、髮型、姿勢、背景一條條寫出來,加一句「Keep exactly the same framing, crop and camera distance as <image1>.」,最後才寫「只換衣服」。我用這個寫法換了 8 套衣服、8 個場景,臉都沒有變成別人,連臉在畫面裡的位置都幾乎沒動。
- Qwen-Image 2.1 生得出正確的繁體中文字嗎?
- 大字可以。招牌「巷口阿伯的燒餅油條」八個字全對,中英黑板菜單的英文和價錢也全對。錯在一個字:「衣索比亞」的亞寫成簡體的亚,同一張菜單的「肯亞」卻是繁體。背景裡的小招牌字則是看起來像中文的亂碼。
- RTX 5090 跑 Qwen-Image 2.1 生一張圖要多久?
- 熱機後用 int8 權重:1024×1024 生圖 40 步約 6.4 秒,疊 4 步加速 LoRA 約 1.2 秒;拿參考圖改一張 768×1024 約 5.5 秒。1536×2048 的大圖生一張約 22.5 秒。
- Qwen-Image 2.1 可以直接生透明背景的 PNG 嗎?
- 可以。提示詞前面加「This is an RGBA image with transparency.」、後面加「The image has alpha channel and the background is transparent.」,輸出就是透明背景的 PNG,不用另外去背。
接著讀
- 2026-10-08[影片生成] FastH3 在 RTX 5090 實測:同一支 768p 有聲片不到一分鐘,比原版 H3 快 2.9 倍
FastH3 是 Hao AI Lab 從 MiniMax-H3 蒸餾出的 8 步版本。我在 RTX 5090 用 ComfyUI 官方範本實測:同一張首幀的 768p 有聲片 57.4–59.8 秒,原版 H3 20 步要 166.3–168.2 秒;480p 不到 20 秒,中文台詞清楚,2080 Ti 也跑得動。
- 2026-10-08[Benchmark] Kandinsky 6.0 Pro 對嘴實測:英文台詞一字不差,中文還差點意思(RTX 5090)
Kandinsky 6.0 Pro 一次生 5 秒影片加聲音,人物照台詞對嘴。我在 RTX 5090 實測:英文台詞 Whisper 逐字正確,中文聽得懂但有口音、錯幾個字;NVFP4 版一支片 141.5 秒。
- 2026-09-13[Benchmark] 先抽到好的再強化:詳解 NVIDIA 的 H3 + LTX-2.5 兩段式影片產線
NVIDIA Sol-H3 的兩段式做法搬到 RTX 5090:H3 只生 672×384 草稿(25.5 秒一支),挑中的那支才交給 LTX-2.5 三步精修。附可下載的 ComfyUI workflow。
- 2026-09-11[Benchmark] 同一句中文台詞,LTX-2.5 用 29 秒、MiniMax-H3 用 81 秒:一張 5090 的實測
同一張 RTX 5090、同一句簡體台詞、同一段雙人對白,兩個會講話的開源影片模型對打。LTX-2.5 出片 28.67 秒,H3 81.22 秒,ASR 逐字比對都是 CER 0%。兩邊峰值 VRAM 都落在 31,7xx MiB,只剩不到 900 MiB。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。