LLM Deep Dive · part 6
[LLM Deep Dive] 量化實驗室:什麼是量化、怎麼量化、為什麼會有損失
❯ cat --toc
TL;DR
做了一個可以點的量化實驗室:model.ai-muninn.com/zh-TW/quantization/。選格式、追一個權重走完四步,看它在哪一步壞掉。同一組 64 個權重從 128 bytes 壓到 36 bytes,代價是 INT4 下四個教學值裡有兩個直接變成 0。誤差有三個來源,其中兩個我做之前沒搞懂:刻度多粗由整組最大值決定,以及 scale 自己也是近似值。
前言
量化的算式短到可以寫在一行:除以 scale、取最近的刻度、乘回 scale。(ONNX 的規格還多一個 zero_point 位移項;本頁走對稱量化,那一項是 0,所以看不到它。)
我把這行字讀懂過很多次。但真要說「誤差是在哪一步生出來的」,我會說「取整數那邊吧」——然後就講不下去了。所以我做了一個可以點的東西:量化實驗室,選一個格式、追一個權重,看它在四步裡怎麼變形。
做完之後,我對「誤差從哪來」的答案從一個變成三個。
什麼是量化:用更少的位元裝同一組數字
模型的權重原本是浮點數,BF16 每個佔 16 bits。量化就是改用更少的位元存同一組數字——INT4 每個只佔 4 bits。
實驗室用 64 個權重當一組來算這筆帳:
| 儲存量 | |
|---|---|
| 64 個 BF16 權重 | 128 bytes |
| 64 個 INT4 權重 | 32 bytes |
| +1 個共用 scale(FP32) | 4 bytes |
| 合計 | 36 bytes |
省 71.9%。左邊那個立方體畫的就是這筆帳:切格式的時候 64 塊會散開、重新編碼、再組回去,體積跟著縮。
代價在哪?4 bits 只有 16 種組合,而這裡用的對稱範圍取 −7 到 7、共 15 格(捨掉 −8 換來正負對稱)。原本可以是任意浮點數的權重,現在只能落在這 15 格裡。落不上去的,就要挪到最近的那一格。
怎麼量化:四個步驟
進頁面預設是 BF16,什麼都還沒發生。點 INT8、FP8、INT4 或 FP4 其中一個,下面才會帶出四個步驟。
- 算 scale——找出整組 64 個權重裡的最大絕對值,除以格式的正整數上限。INT4 上限是 7。
- 換成刻度——把權重除以 scale,取最近的整數,超出範圍就壓到邊界。
- 儲存——存的是「一個共用 scale + 每個權重的整數代碼」。代碼 3 不是權重 3。
- 還原——代碼乘回 scale,跟原值比。
頁面上那四個數字按鈕(0.375、−0.875、4.25、−15.875)可以換追蹤對象。建議第一次選 INT4、追 0.375。
誤差在第二步生出來——但它有多大,是第一步決定的。
損失來源一就是這個取整數:落不到刻度上的權重,被挪到最近的一格。這個大家都知道。下面兩節是另外兩個,我做之前都沒想到。
損失來源二:刻度有多粗,由整組的最大值決定
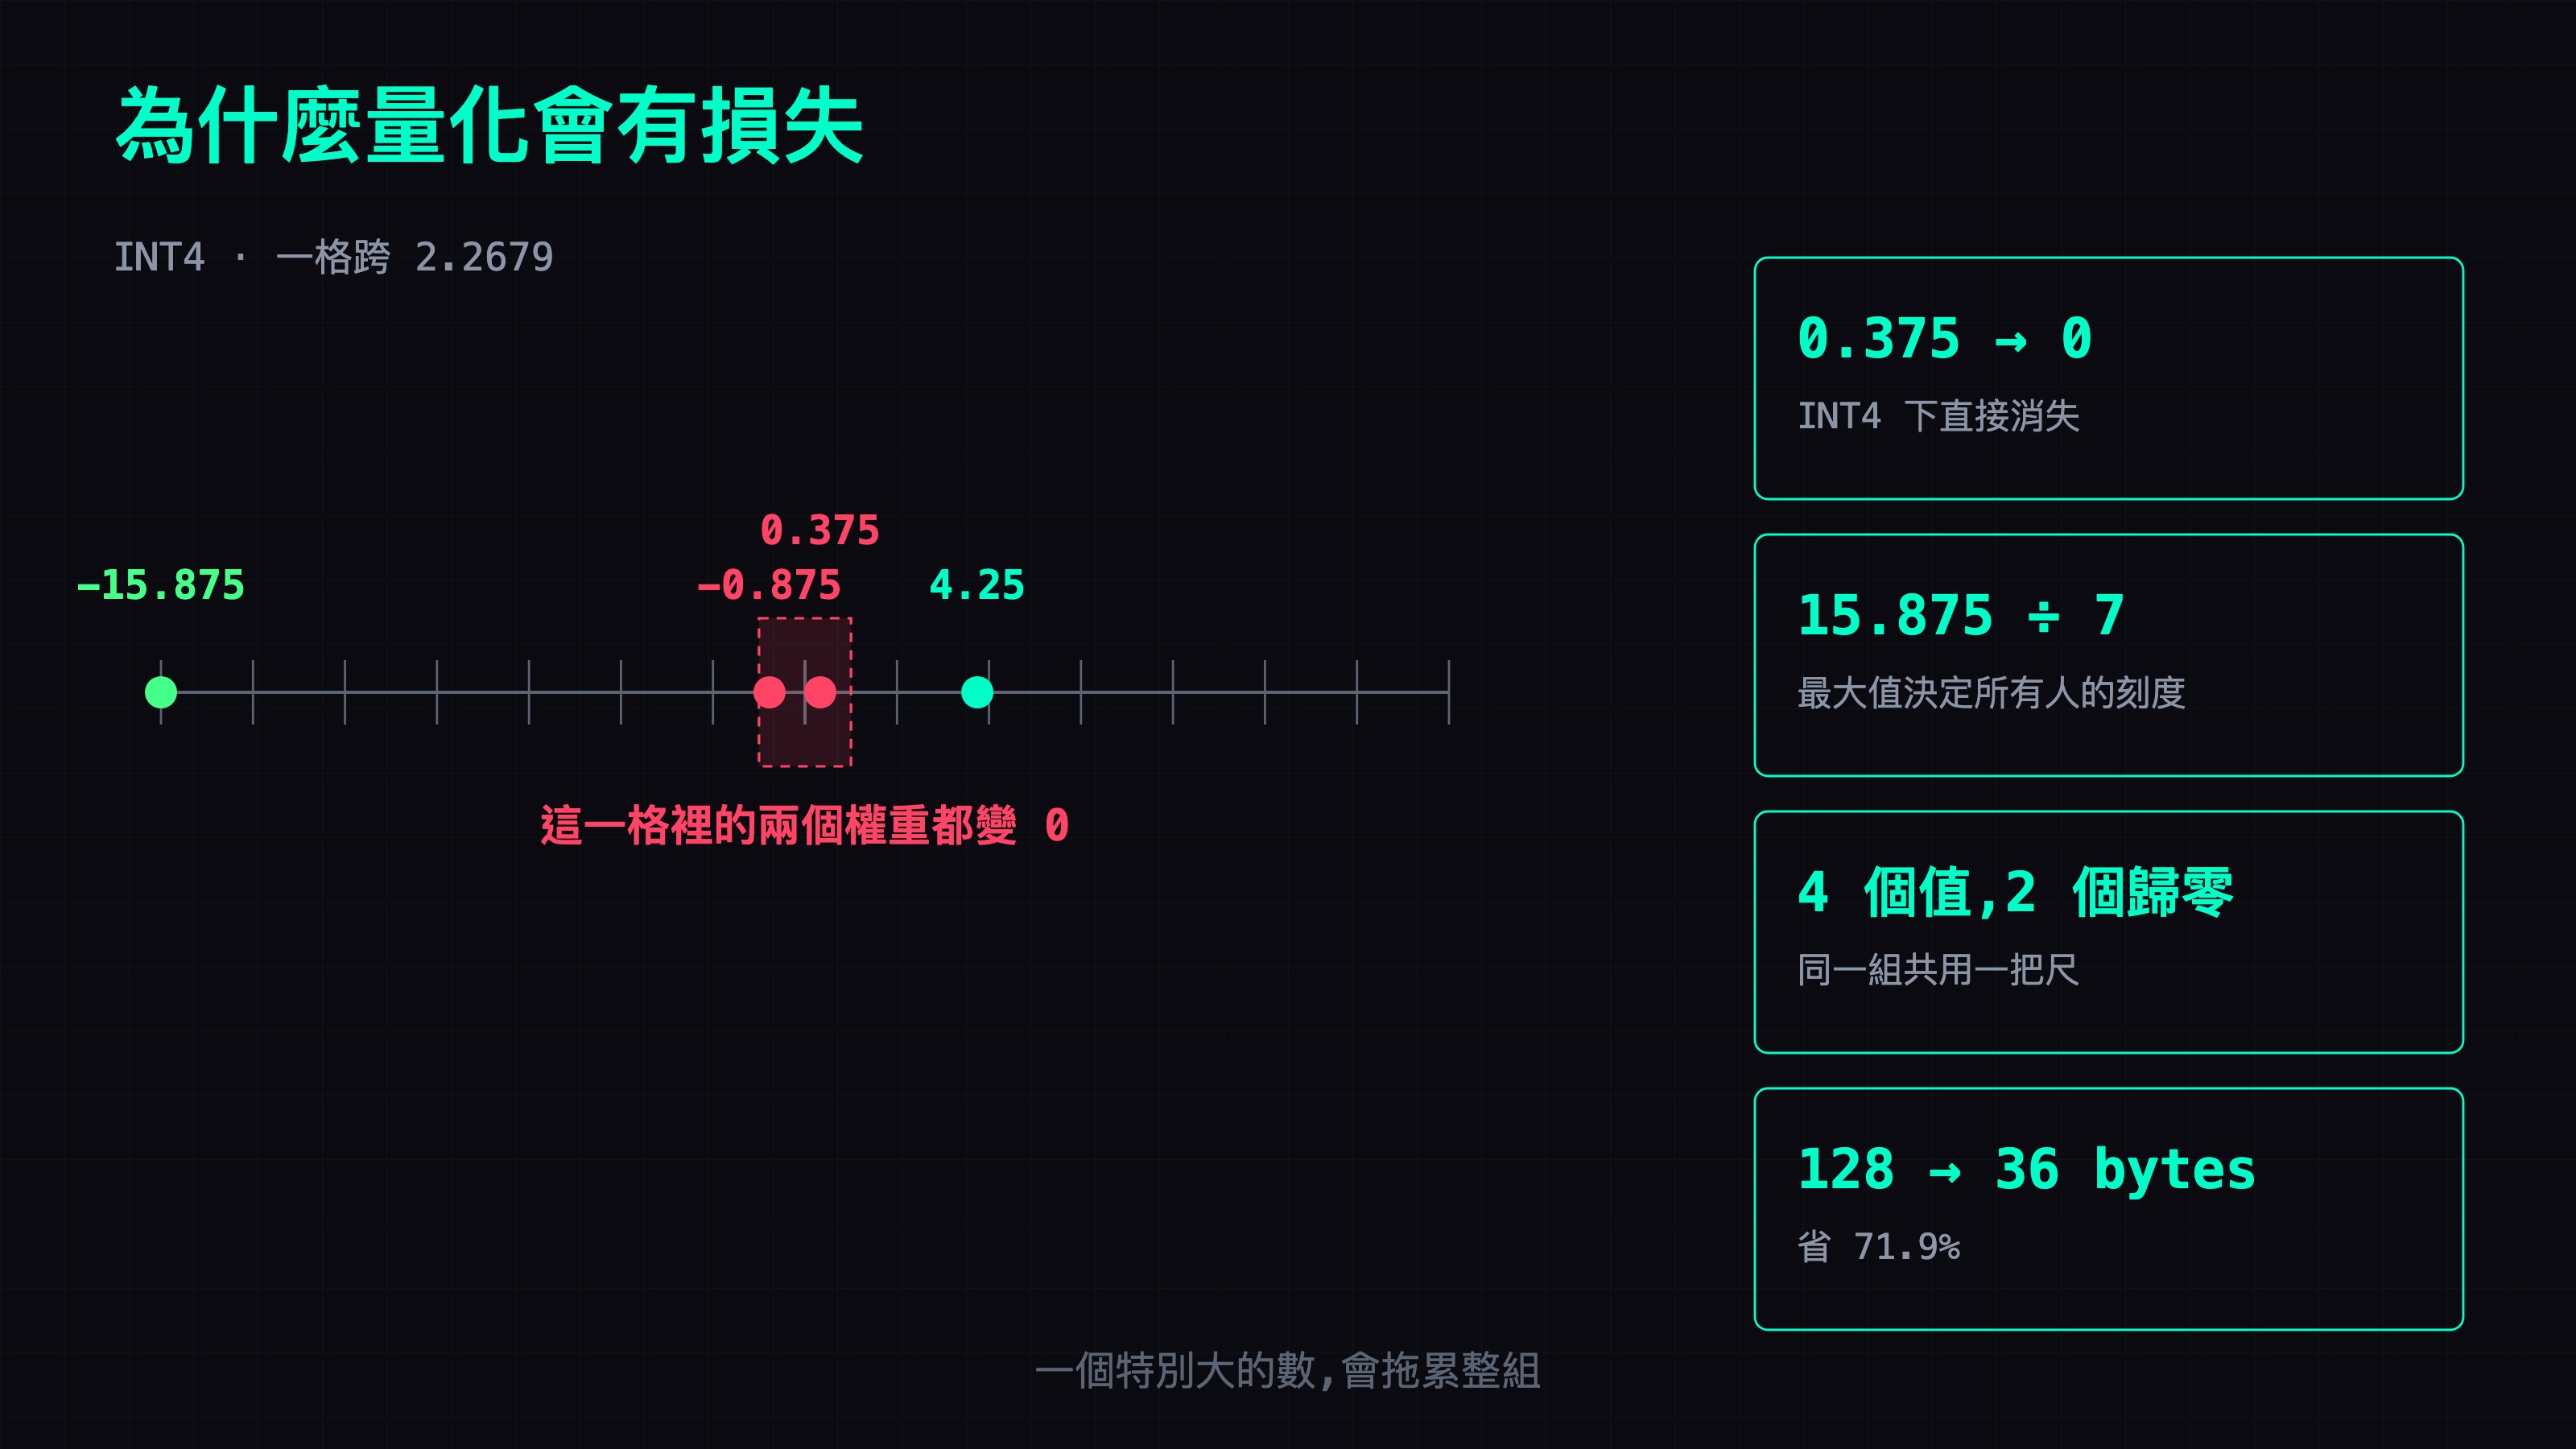
教學組只有四個值:−15.875、−0.875、0.375、4.25。第一個比其他三個大了一個量級。
INT4 兩邊各七格,scale 是 15.875 ÷ 7 ≈ 2.2679。一格就跨 2.2679。於是:
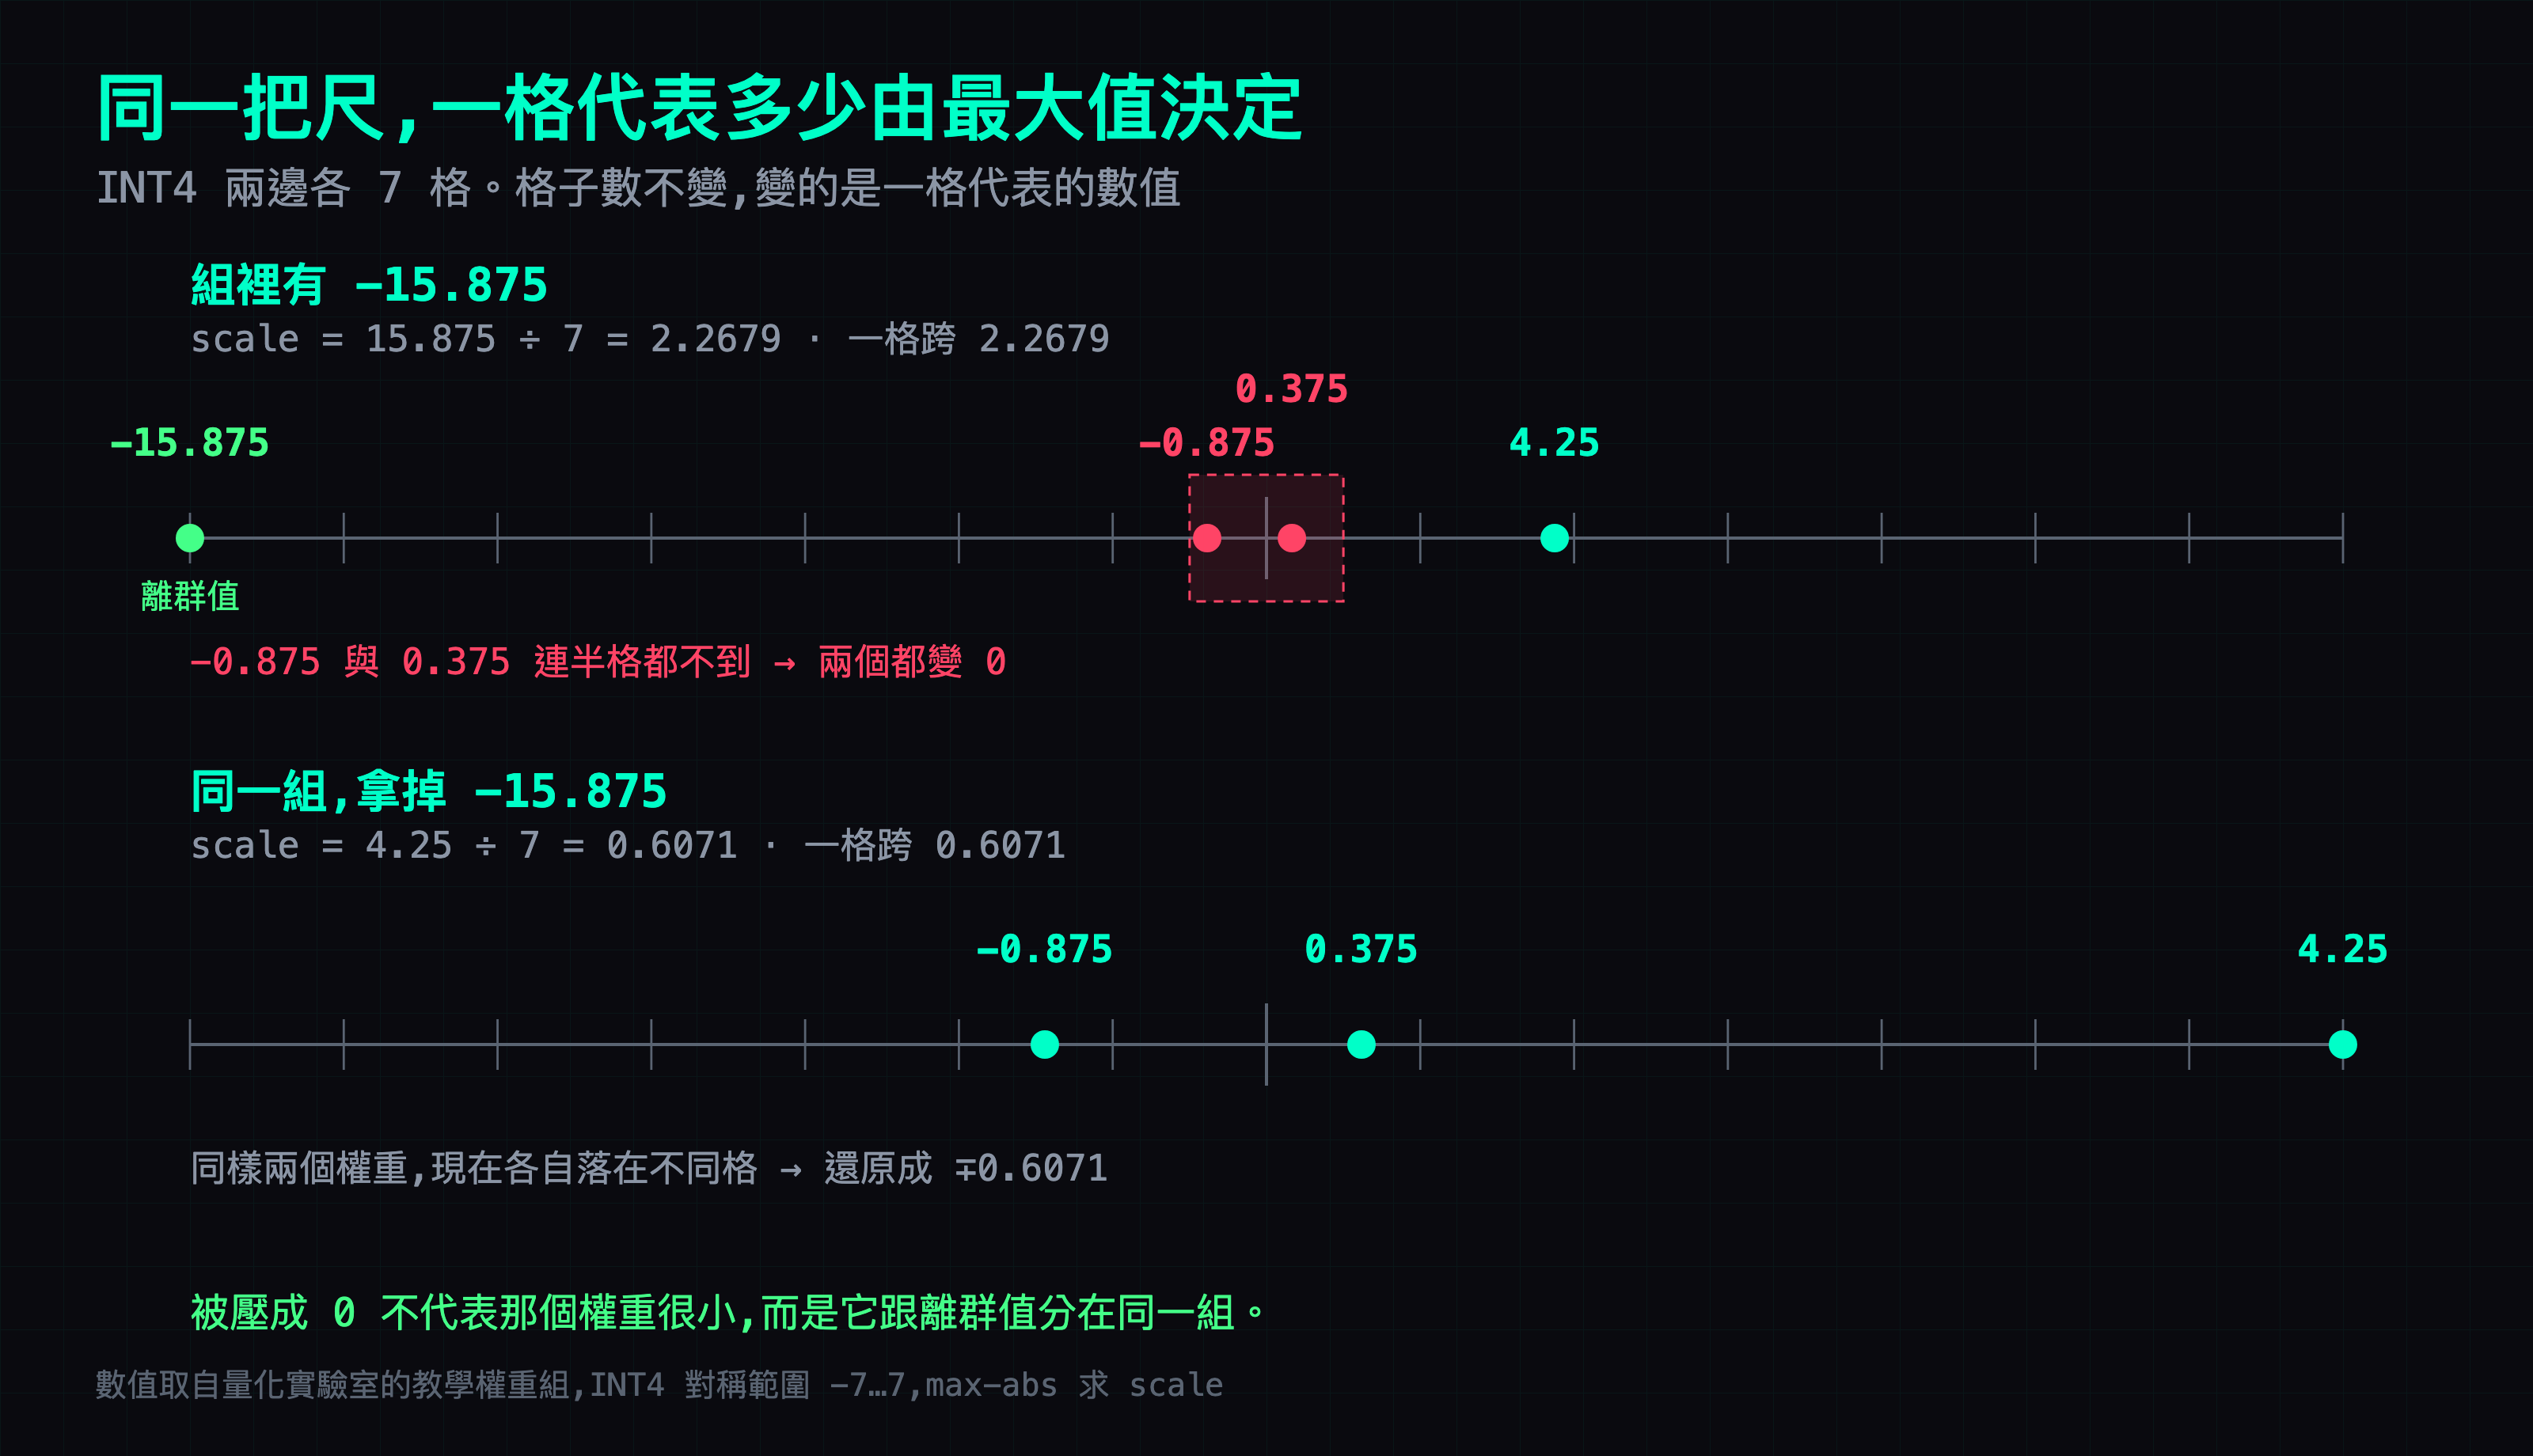
0.375 ÷ 2.2679 = 0.165,四捨五入是 0。−0.875 也是 0。四個值裡有兩個在 INT4 直接消失。
拿掉 −15.875,同組最大變成 4.25,scale 變 0.6071,0.375 就還原成 0.6071——仍然有誤差,但不是歸零。差別不在 0.375 本身,在它跟誰分在同一組。
這種明顯偏離同組其他數字的值叫離群值。它為什麼是量化演算法的頭號敵人、K-quant 的 super-block 與 TurboQuant 的旋轉各自怎麼對付它,Part 1 寫得比這裡完整,我不重講。實驗室能補的只有一件事:那些演算法在躲的東西,你可以點一下看它發生。
這也是為什麼要分組。 把 64 個權重切成幾小組、各組算各自的 scale,離群值的影響就被關在它那一組裡。代價是每組都要多存一個 scale。實驗室左側矩陣的「每組權重數」可以直接調來看這個取捨。
損失來源三:scale 自己也是近似值
這件事我做之前沒想過。
直覺上,落在刻度正上方的權重應該完美還原。組裡的最大值最該如此——它定義了 scale,代碼剛好是格式上限。
選 INT4、追 −15.875,還原值是:
-15.874999523162842
差了 4.77e-7。取整數那一步沒有誤差,−15.875 ÷ 2.267857… = −7 剛剛好。誤差在別的地方:15.875 ÷ 7 這個數在 FP32 裡存不下,實際存的是 2.267857074737549。乘回這個近似 scale,就回不到原來的位置。
同一個權重在 FP8 與 FP4 也是同樣的 4.77e-7。
這個差距小到不影響任何事,但它打破了「誤差只來自取整數」的直覺:還原用的那把尺,本身也是被量化過的。
那「還原」在推論時到底發生什麼?
第四步叫「還原」,我一開始被自己的設計誤導:如果每次用模型都要把權重還原成 BF16,那省下來的空間不是又吐回去了嗎?
不是。以只量化權重的做法來說,計算時確實要把權重換回浮點,但不是把整個模型還原成一份 BF16 再拿去算。反量化融合在矩陣乘法的 kernel 裡,一小塊一小塊做完就用掉,完整的 BF16 weight tensor 從頭到尾不會同時存在記憶體裡。所以省下的容量與記憶體頻寬在推論時仍然成立。
這條路徑在站上的效能文裡出現過,只是當時沒有特別把它抽出來講。NVFP4 那篇裡那行 NVFP4 weights → Marlin dequant → BF16 → BF16 GEMM 講的就是它:dequant 是 kernel 內的一站。
所以實驗室第四步的「還原」純粹是為了算誤差:把原值和還原值擺在一起才比得出差距,不是推論時每個 token 都要付的 overhead。
(本頁只量化權重,activation 全程保持浮點。activation 也一起量化是另一回事,之後再寫。)
哪些數字可以引用,哪些只是示意
想把實驗室的數字引用到別的地方,差別就在這裡。
可以引用的:scale、還原值、誤差、bytes。這些都是實際算出來的。
只是示意的:方塊大小不代表 tensor 真實維度、cache 格數不是實測、動畫速度跟真實速度無關、彩色路由連線是固定種子產生的。
另外,拿不到的數字會標成「未核對」而不是 0——0 看起來像一個測量結果。
進階:為什麼這些數字可以信
只想玩工具的話可以跳過這節。
node verify.cjs 現在跑 53 項,測的是資料一致性不是畫面:FP4 E2M1 的每一個有限編碼都要對、FP8 E4M3FN 的 subnormal 與 NaN 要對、ties-to-even 在 0 的兩側都要成立、scale 要用儲存後的 FP32 值而不是理論值去挑整數代碼。
最後那條就是上面 4.77e-7 的來源。如果測試偷懶用理論 scale,那個誤差就會消失——但它明明真的存在。
有一個教學組的巧合值得知道:INT8 在這四個值上誤差全是 0。因為 15.875 ÷ 127 = 0.125 剛好整除,而四個值都是 0.125 的整數倍。實驗室裡有標這是刻意挑的教學資料,不能解讀成 INT8 無損。
自己點一次
model.ai-muninn.com/zh-TW/quantization/,不用登入。
建議的順序:選 INT4、追 0.375,看它在第二步變成 0;再追 −15.875,看那個 4.77e-7 從哪裡來。兩個都看完,量化的誤差來源就不只是「取整數」了。
常見問題
- 什麼是量化?
- 用更少的位元表示同一組數字。原本每個權重佔 16 bits,改成 4 bits,同一組 64 個權重從 128 bytes 變成 36 bytes(含一個共用的 scale),省 71.9%。代價是這些數字只能落在少數幾個刻度上,落不上去的就要四捨五入。
- 量化怎麼做?
- 四步:先用整組的最大絕對值算出 scale,把每個權重除以 scale 後取最近的刻度,儲存「共用 scale + 每個權重的代碼」,要用的時候再乘回 scale。實驗室把這四步拆開,可以追著單一權重看。
- 量化完之後,每次推論都要把權重還原成 BF16 嗎?
- 以只量化權重的做法來說,計算時確實要把權重換回浮點,但不是把整個模型還原成一份 BF16 再拿去算。反量化融合在矩陣乘法的 kernel 裡,一塊一塊做完就用掉,完整的 BF16 weight tensor 不會同時存在記憶體裡,所以省下的容量與頻寬在推論時仍然成立。
- 一個權重剛好落在量化的刻度上,還原回來就會完全一樣嗎?
- 不一定。scale 本身也用有限的位元儲存。以實驗室的教學組為例,INT4 的 scale 是 15.875 ÷ 7,這個數在 FP32 裡存不下,所以連定義這個 scale 的 −15.875 都還原成 −15.874999523162842,差 4.77e-7。
- 為什麼同一組裡有一個很大的數,其他權重就會變不準?
- 因為 scale 由整組的最大絕對值決定。教學組裡有 −15.875,INT4 的 scale 就是 2.2679,一格跨 2.2679;0.375 和 −0.875 連半格都不到,四捨五入之後都變成 0。拿掉那個大數,scale 變 0.6071,兩個權重就各自落在不同格。
接著讀
- 2026-09-16[LLM Deep Dive] 一個可以點開的模型解剖室:Qwen3、Flash-Next、DeepSeek 內部長什麼樣
點開立方體、展開 48 層、進到單層看功能分區。四個真實模型的官方 config 釘死版本,資料流真的不一樣。這篇講這個網站給你看什麼、怎麼用它讀一個模型。
- 2026-08-28[Benchmark] 1770 億參數塞進三張二手 2080 Ti:改檔案快 3.5 倍,寫散文一點都沒快
Qwen3.8-Flash-Next(176.94B)跑在三張改裝 2080 Ti 上:128K context 拿到 23.14 tok/s,開 ngram 投機解碼後改檔案衝到 77.56。附三種量化在相同條件下的對照。
- 2026-08-20[趣味競賽 進階 #12] 為什麼你的 4-bit 模型在 2080 Ti 上快不起來?——拆開 .so 才發現這代卡只有兩種齒輪
為什麼 GGUF 量化後檔案變小,tok/s 卻沒變快?拆開 CUDA 後端 .so 才看懂:Turing(sm_75)的整數 tensor core 只有 s4×s4 跟 s8×s8 兩種同寬組合,4-bit 權重配 fp16 activation 這格在任何架構都不存在。GGUF、AWQ、Marlin 全靠反量化撐過去。
- 2026-08-06[趣味競賽 進階 #11] 什麼?2080 Ti 居然跑得動 MiniMax-H3,還生得出 1080p 有聲影片
四個檔案在磁碟上 38 GiB,而卡只有 22 GiB。一張 2018 年的改裝 2080 Ti 22G(sm_75)照樣跑出 15 秒 1080p 有聲片。完整配置、實測速度與畫質,最後才是一路怎麼試出來的。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。