LLM Deep Dive · part 5
[LLM Deep Dive] 一個可以點開的模型解剖室:Qwen3、Flash-Next、DeepSeek 內部長什麼樣
❯ cat --toc
TL;DR
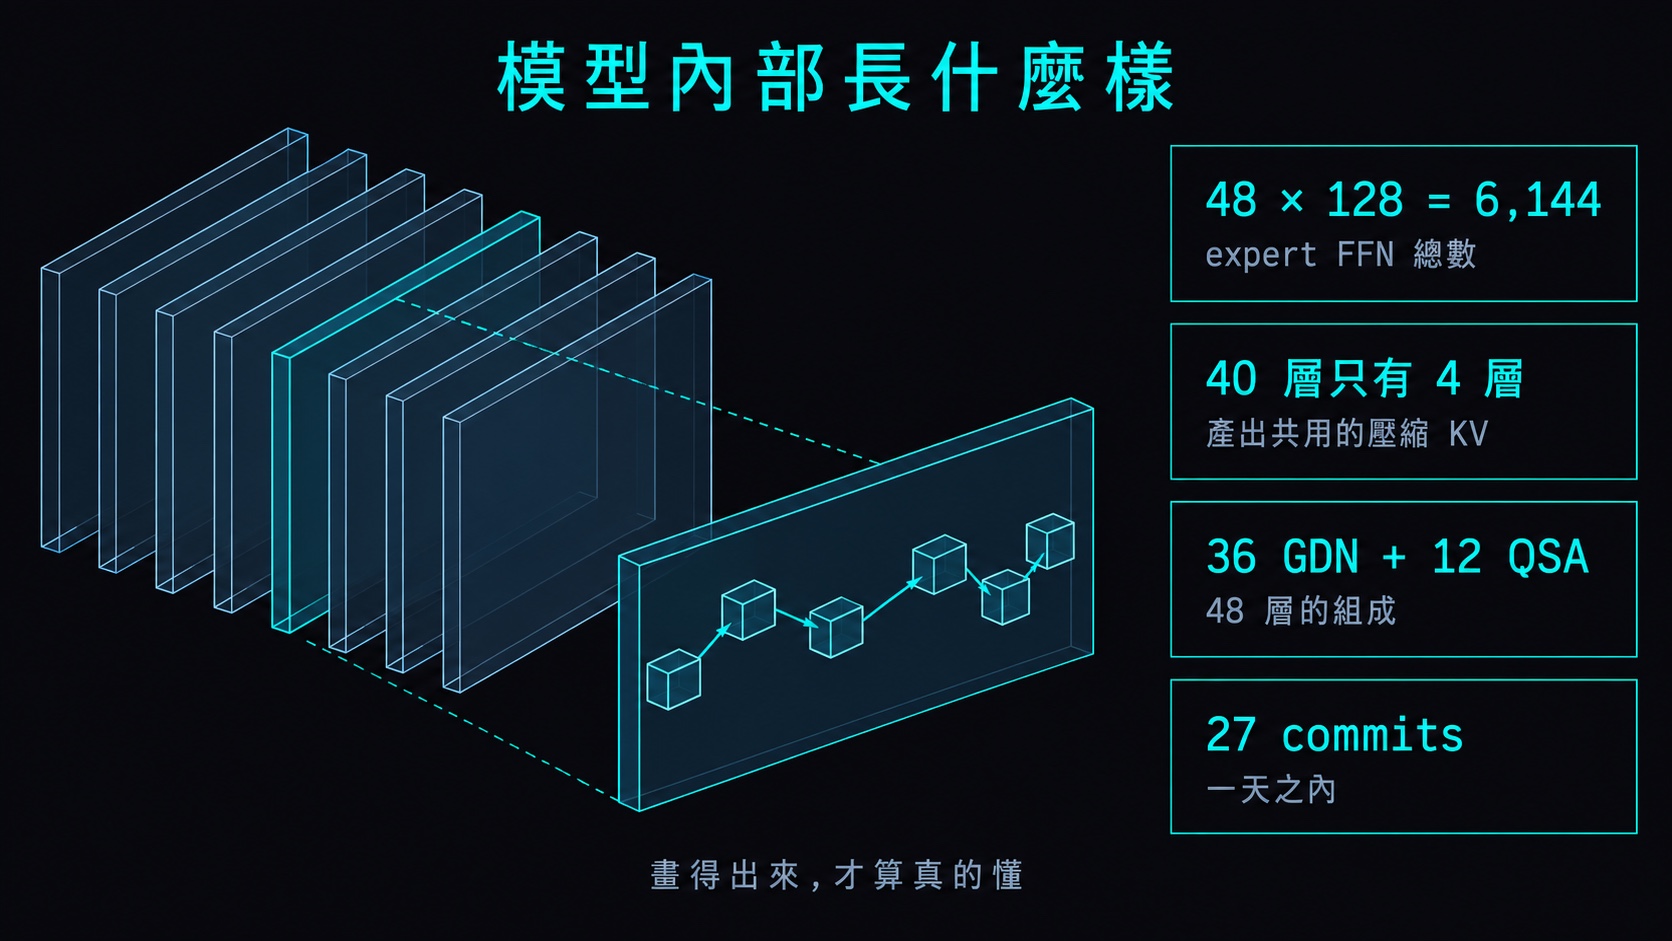
model.ai-muninn.com 是一個可以點開的模型解剖室:點立方體展開成完整的層堆疊,再進到單層看功能分區,選到哪一區就顯示那一區在做什麼、有多少參數。四個模型的官方 config 都釘死版本,所以資料流的差異是真的——DeepSeek-V4.1-Flash 的 40 層裡只有 4 層產出共用的壓縮 KV,Qwen3.8-Flash-Next 的 48 層是 36 個 GDN 混 12 個 QSA。這篇講它給你看什麼、怎麼看。
前言
看得懂一張圖,跟能自己畫出來,是兩件事。
Attention、FFN、residual,這些詞我都認得,連起來也講得出一串。但真要說「一層裡面,資料照什麼順序經過哪幾個東西」,我會在某個地方含糊過去——而且我不知道自己會卡在哪,直到有人問。
所以有了 model.ai-muninn.com:一個可以點開的模型解剖室。這篇講它給你看什麼、以及怎麼用它讀一個模型。不用登入,繁中和英文都有。
怎麼操作:選模型 → 展開層 → 點分區
三個動作就走完了。
左上角選模型。目前四個:Qwen3-30B-A3B(48 層 MoE)、Qwen3-8B(36 層 Dense)、Qwen3.8-Flash-Next(48 層混合)、DeepSeek-V4.1-Flash(40 層)。層數直接寫在選單上。
點畫面中央的立方體,它會展開成完整的層堆疊——薄片的數量就是 decoder 層數,48 層就是 48 片。
再點一次進到單層,看到的是那一層的功能分區。點任何一區,右側就逐字顯示那一區在做什麼、有多少參數、BF16 等效多大。要換層,就用模型旁邊的選層工具往前或往後翻。
建議先用 Qwen3-30B-A3B 把一層從頭點到尾。下面幾節是你在那裡會看到、但一般示意圖不會畫出來的東西。
一層裡面有六個步驟,不是三個
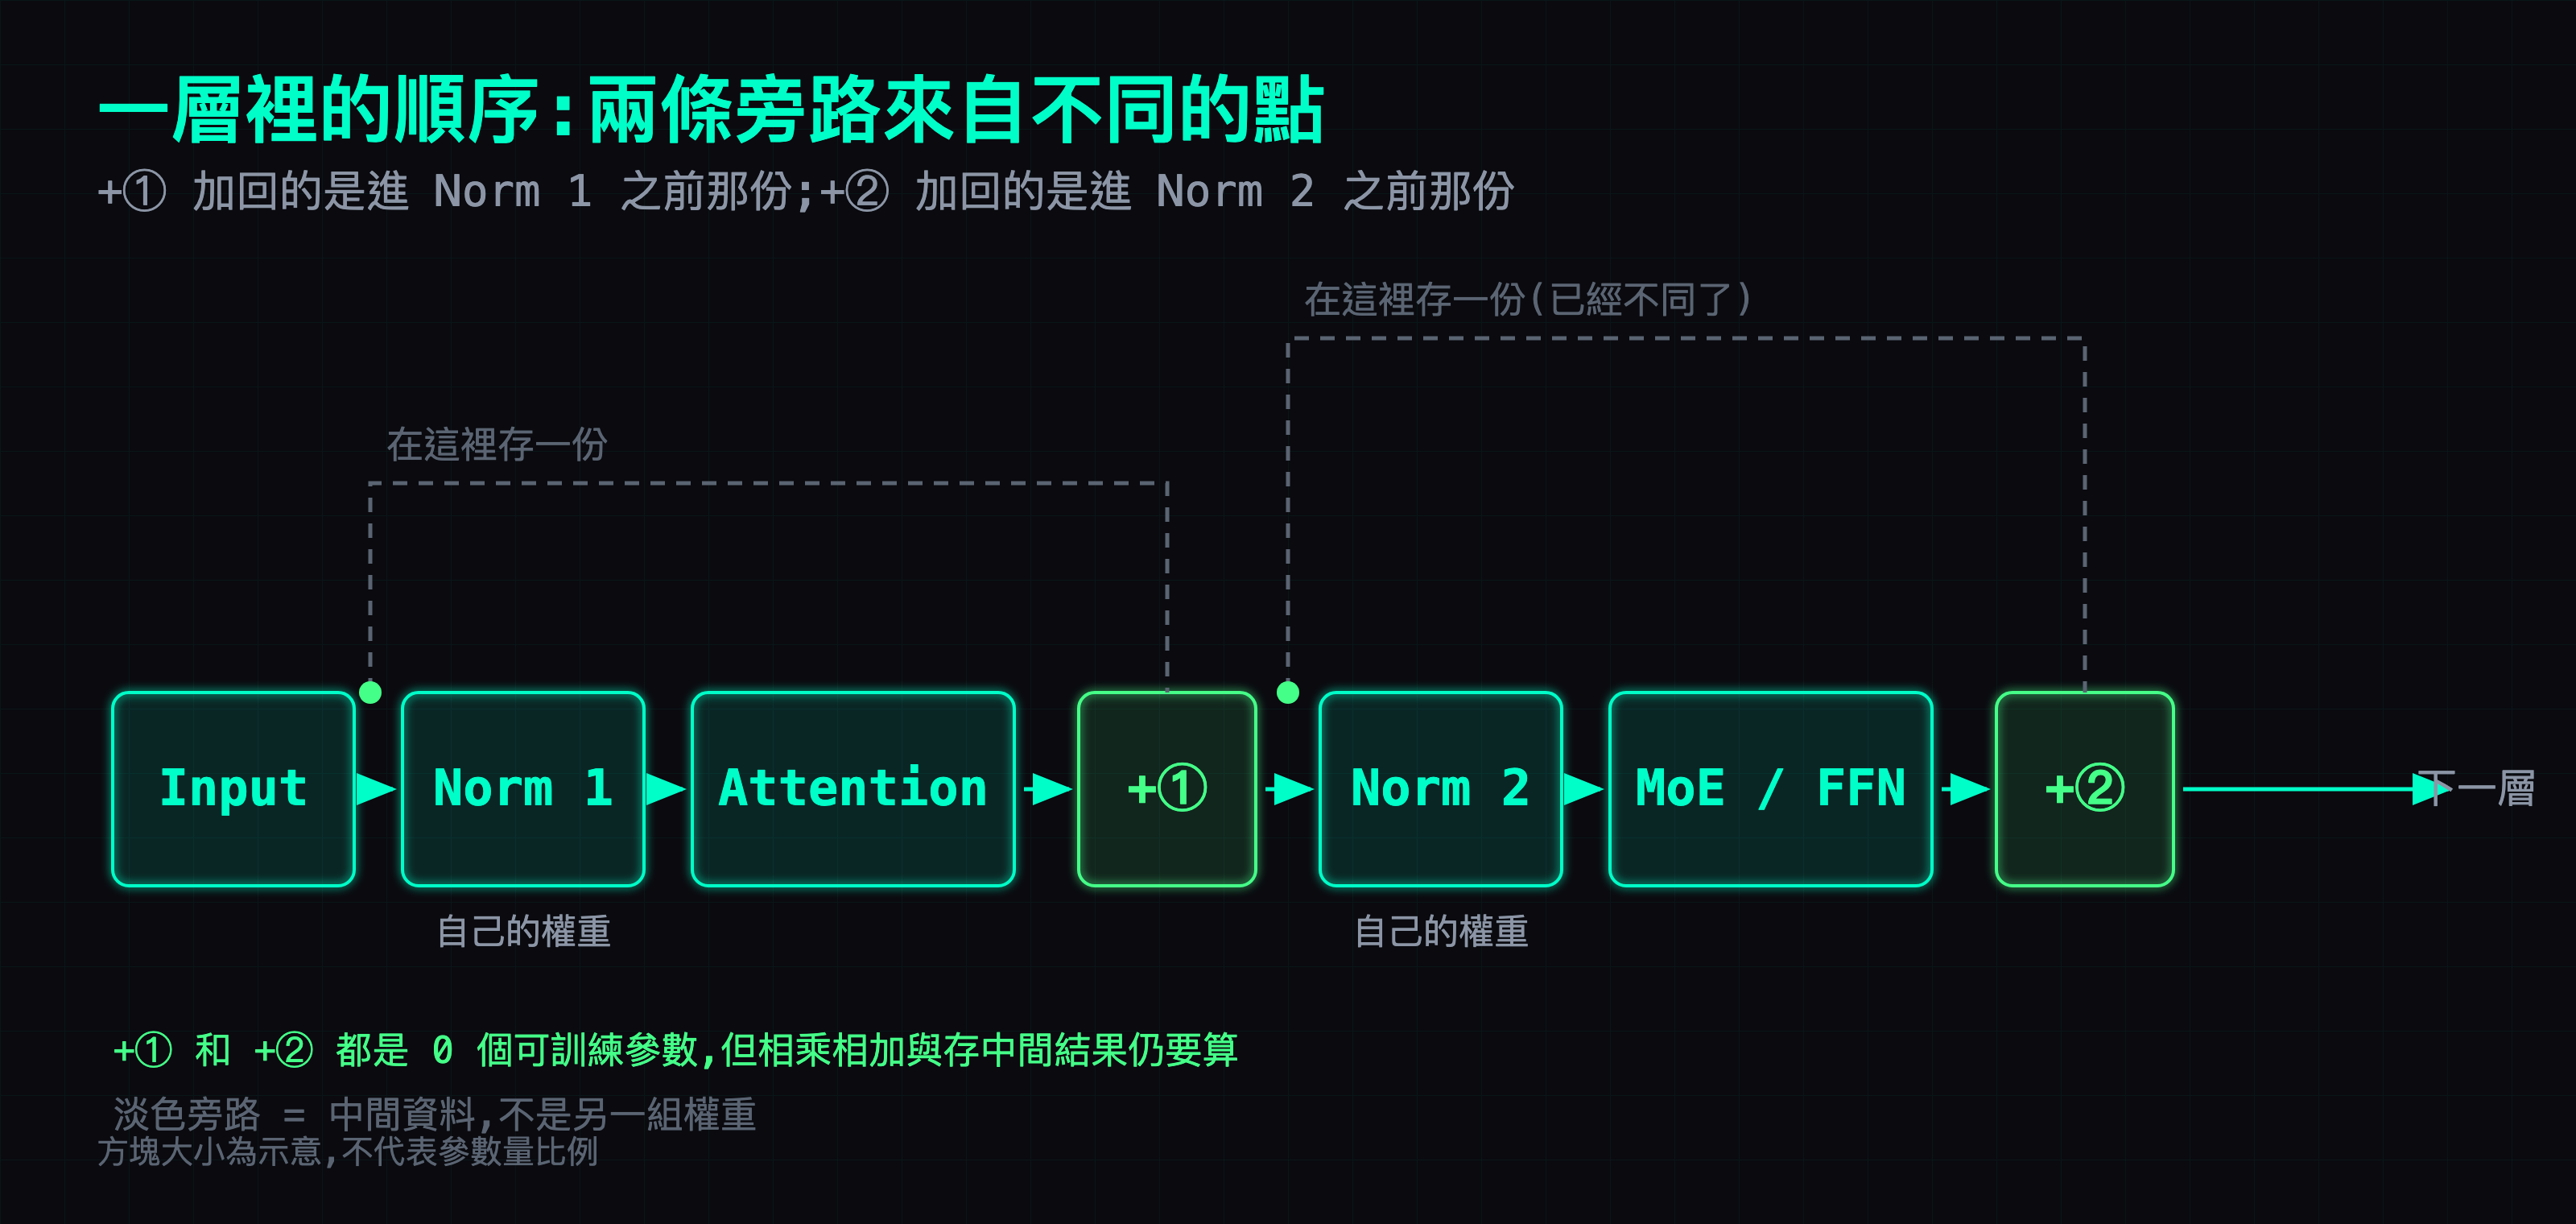
多數人腦中的單層是三個東西:Norm、Attention、FFN。網站上展開之後會看到六個:
Input → Norm 1 → Attention → +① → Norm 2 → MoE/FFN → +② → 下一層
兩個 + 是 residual 相加。+① 把 Attention 的輸出加回進入 Norm 1 之前保留的那份原始資料;+② 把 MoE 的輸出加回進入 Norm 2 之前保留的那份。這兩份被保留的資料不一樣,因為中間隔了 Attention。
圖上那兩條淡色旁路的起點在不同位置,就是在講這件事。點那兩個 + 節點,它會告訴你各自加回的是哪一份。
Norm 1 和 Norm 2 是兩個方塊,不是同一個
網站把這兩次 Norm 分開放,兩個都能點,點開就看得到各自的參數量。
這不是排版的選擇。Norm 1 和 Norm 2 是兩組獨立的 RMSNorm 權重,在 Qwen3-30B-A3B 裡各是 2,048 個參數,Dense 的 Qwen3-8B 裡各是 4,096 個。而且它們收到的資料本來就不同——Attention 和第一次相加夾在中間。
層外的 Final Norm 又是第三組,獨立計數。點它會看到它不在任何一層裡面。
點 Router 會看到:選 8 個,另外 120 個仍然占著記憶體
Qwen3-30B-A3B 每一層有 128 個 expert,每個 token 選 8 個。48 層各自擁有自己的 128 個,合計 6,144 個 expert FFN——全部都要載進記憶體。整個模型 30,532,122,624 個參數,BF16 是 61.06 GB,而這 61 GB 裡絕大部分是那些「這次沒被選中」的 expert。
網站上那個大格網不逐一對應 128 個 expert,8 個彩色標記只表示這一層的路由樣本。但參數的帳是實的:點 Experts 區看到的數字,是這一層 128 個 expert 的權重總和。
這裡很容易誤會:expert 不是預先分好科目的老師。沒有哪一個是「數學 expert」、哪一個是「翻譯 expert」。每個 expert 都是訓練出來的,Router 依當下的中間資料替它們評分,再選分數高的。
加權合併和 residual 相加是兩個節點
8 個 expert 各自算完之後,網站上會走過兩個獨立的節點:
- 加權合併:每個 expert 的輸出乘上 Router 給它的比例,8 份相加,得到一份新的中間資料。
+②residual 相加:把這份新資料,加回進入 Norm 2 之前保留的那份。
很多圖把它們畫成同一個節點,這樣就看不出比例是從哪來的。那個比例是這一次 Router 算出來的中間資料,不是合併節點自己學到的一組權重。
這兩個節點在網站上都標示 0 個可訓練參數。但 0 個參數不等於免費:相乘、相加、以及存放中間結果,都要算力也要記憶體。
切到 DeepSeek-V4.1-Flash:40 層裡只有 4 層產出共用的壓縮 KV
切模型之後最值得看的是這個。
DeepSeek-V4.1-Flash 的主幹是 40 層,20 個 causal encoder + 20 個 decoder。翻層的時候會看到同一個 Attention 區在不同層長得不一樣,因為這 40 層在「KV 和索引從哪來」這件事上分成四種:
| 層型 | 幾層 | 共用的壓縮 KV | 索引 |
|---|---|---|---|
| SWA | 2 | 不用,只讀本層 local window | 無 |
| Full | 4 | 自己產出 | 自己建 |
| Reindex | 4 | 沿用別層的 | 自己重算 |
| Reuse | 30 | 沿用別層的 | 一併沿用 |
先講一個容易誤讀的地方:每一層都有自己的 local window KV,那個不共用。這裡在分的是跨層共用的那份壓縮 KV——40 層裡只有 4 層產出它(從第一層往上數,分別是第 3、9、15、21 層)。讀它的有 34 層——30 層連索引一起沿用,4 層沿用 KV 但自己重算索引;剩下 2 層 SWA 完全不碰。
Reindex 那 4 層(第 25、29、33、37 層)特別有意思:它沿用別層的壓縮 KV,但重新算自己的索引——也就是說 KV 和索引有各自的生命週期,可以分開。翻到那幾層,圖上會少掉建 KV 的部件、只留重算索引的那個。
這個區別不在 config 的欄位名稱裡,要去讀官方固定版本的 inference/model.py,看 Attention.__init__、_compress_kv、_compress_topk_idxs 和 Indexer 實際怎麼決定取哪一份——判斷「要重算索引還是直接沿用」的邏輯就寫在 _compress_topk_idxs 裡。
切到 Qwen3.8-Flash-Next:48 層是 36 個 GDN 混 12 個 QSA
另一個混合架構,混的方式不一樣。
Qwen3.8-Flash-Next 的 48 層不是同一種 attention 重複 48 次,而是以 3 層 Gated DeltaNet + 1 層 QSA 為一組,循環 12 次:
1 GDN   2 GDN   3 GDN   4 QSA
5 GDN   6 GDN   7 GDN   8 QSA
...
合計 36 個 GDN、12 個 QSA。往前翻幾層就會看到 Attention 區整個換一張圖:GDN 是「舊狀態 → 更新 → 新狀態 → 讀出」,那個新狀態要留給下一個 token;QSA 是先用索引器挑出歷史 KV 裡的一小部分,只讀那些。
哪些數字可以引用,哪些只是示意
要拿網站上的數字寫報告,得先分清楚哪些能引用、哪些只是示意。
可以引用的:參數量、層數、expert 數量與 top-k、BF16 等效大小。這些都從釘死版本的官方 config 推導,兩個原始 Qwen3 模型的總量是精確還原的(每層 × 層數 + Embedding + Final Norm + Output)。
只是示意的:方塊大小不代表 tensor 真實維度或參數比例、cache 格數不是實測、動畫速度跟真實速度無關、路由連線是固定種子產生的教學示意。
最後那個特別要講:Router 每次實際選了哪 8 個 expert,網站畫不準,而且永遠畫不準。看 config 檔只能知道這一層有 128 個 expert、每次選 8 個;「這一次選了哪 8 個」取決於當下的中間資料,只有真的跑一次推論才知道。
還有一條:拿不到的數字,網站會顯示「未核對」,不填 0——填 0 會讓人以為真的測過。
進階:為什麼這些數字可以信
只想玩工具的話可以直接跳過這節。
四個模型的 config 都釘死 revision。Qwen3.8-Flash-Next 是 de4b8e4d43b917e7706784d8bb445c9af86a3540、DeepSeek-V4.1-Flash 是 dba1be0a40aa45a94ad051997016db3960a90277,兩個都在各自的 HuggingFace repo 底下。Flash-Next 的實作另外釘在 Transformers 的 commit bd15bc95a89e728bbc1224084eb3b5829428c353(那是一個 commit,不是 v4.51.3 這個 tag)。原始的兩個 Qwen3 走的是官方 config 加 Transformers v4.51.3 的 qwen3_moe 實作。
原因是模型的 config 會改。如果網站讀的是 main,某天上游改一個欄位,圖就會默默變成另一個樣子,而且沒有人會發現。
測試測的是資料一致性,不是畫面好看。node verify.cjs 現在跑 35 項:
- 兩個原始模型的參數總量要精確還原
- 每個可見區域在每個語言都要有說明,少一個就紅
- 逐層前進只能到下一層,最後一層才進 Output
- 合併節點和 residual 節點都不能被算進權重總量
最後那條是刻意的:參數欄位標 0,測試就擋住這個 0 被誤加進任何小計。
沒做到的:新模型的完整參數量目前是 unknown/partial。查表、視覺、MTP 這些分支的 tensor 沒有逐一核對,所以不敢用已知的小計冒充精確總量——介面顯示官方概數或「未核對」。BF16 等效大小也要特別注意:那是參數數量 × 2 bytes 的十進位 GB,不等於你下載的量化檔大小,也不等於跑起來的記憶體佔用(沒算 KV cache、activation、workspace)。
網站本身是請 Codex(gpt-6-astra)寫的,一天之內 27 個 commit 從 v1 做到 v16。
自己點一次
網站在 model.ai-muninn.com,不用登入。
建議的順序:先用 Qwen3-30B-A3B 把一層從頭點到尾,特別留意 +① 和 +② 加回的是不同的兩份資料;再切到 DeepSeek-V4.1-Flash,翻到第 3、9、15、21 層,那是唯一會產出共用壓縮 KV 的四層。
如果你跟我一樣,對模型結構的理解停在「每個詞都認得」那一層,花十分鐘把一層點完,你會知道自己卡在哪。
參考來源:Qwen3-30B-A3B 官方 config、Transformers v4.51.3 的 Qwen3 MoE 實作。
常見問題
- Norm 1 和 Norm 2 是同一個東西嗎?
- 不是。它們各有一組自己的 RMSNorm 權重,而且中間隔著 Attention 和第一次 residual 相加,所以 Norm 2 收到的資料跟 Norm 1 收到的不一樣。在 Qwen3-30B-A3B 裡兩組各是 2,048 個參數,Dense 版各是 4,096 個。很多示意圖把它們畫成同一個方塊重複兩次,那會讓人以為是同一個操作跑兩遍。
- MoE 的 Router 沒選中的 expert 會怎樣?
- 什麼都不會發生,但它們仍然占著記憶體。Qwen3-30B-A3B 每一層有 128 個 expert、每個 token 選 8 個,48 層合計 6,144 個 expert FFN 全部都要載進來。沒被選中只代表這次沒有參與計算,不代表它的權重不存在。
- 加權合併和 residual 相加差在哪?
- 是先後兩個步驟。加權合併是把 8 個 expert 的輸出各自乘上 Router 給的比例再相加,得到一份新的中間資料;residual 相加是再把這份結果加回進入 MoE 之前保留的那份資料。兩者都沒有自己的可訓練權重,但都要算。
- 從模型的 config 檔可以看出每次會選哪幾個 expert 嗎?
- 不行。config 只告訴你這一層有幾個 expert、每次選幾個。實際選中哪幾個由當下的中間資料決定,只有真的跑一次推論才知道。所以任何靜態的架構圖畫出來的路由都是示意,不是真實 trace。
- 這個網站上哪些數字可以引用,哪些只是示意?
- 參數量、層數、expert 數量、BF16 等效大小都從釘死版本的官方 config 推導,可以引用。方塊大小、cache 格數、路由連線、動畫速度都是示意,介面上有標。拿不到的數字顯示「未核對」而不是 0。
接著讀
- 2026-04-08[LLM 101 #2] Dense、MoE、PLE、SSM — 四種 AI 模型架構,一次搞懂
Dense 是全員出動,MoE 是專家輪班,PLE 是每層樓有自己的櫃台,SSM 是速讀高手。用零技術門檻解釋四種主流 AI 模型架構的差別,幫你看懂規格表。
- 2026-08-28[DGX Spark] 1770 億參數 + 262K context 一起開:Spark 上不用二選一
Qwen3.8-Flash-Next 在單台 DGX Spark 上跑 UD-Q4_K_XL,原生 262,144 context 全開,改檔案 76.65 tok/s。完整設定、四格速度、記憶體怎麼分配。
- 2026-08-28[Benchmark] 1770 億參數塞進三張二手 2080 Ti:改檔案快 3.5 倍,寫散文一點都沒快
Qwen3.8-Flash-Next(176.94B)跑在三張改裝 2080 Ti 上:128K context 拿到 23.14 tok/s,開 ngram 投機解碼後改檔案衝到 77.56。附三種量化在相同條件下的對照。
- 2026-08-02[洋垃圾跑大模型 #4] 把前沿級開源模型搬進自己家:一張 22G 老卡跑 DeepSeek-V4-Flash-0731
DeepSeek 官方 0731 正式版,在好幾個 agentic 評測上跟閉源旗艦同級。這篇從下載 91GB 的 GGUF、設定成開機自動跑,一路寫到怎麼算你那張卡該搬幾層專家上 VRAM。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。