DGX Spark · part 48
[DGX Spark] 兩次整機斷電的受控復現:指紋、修法,以及我們最後為什麼把修法關掉
❯ cat --toc
TL;DR
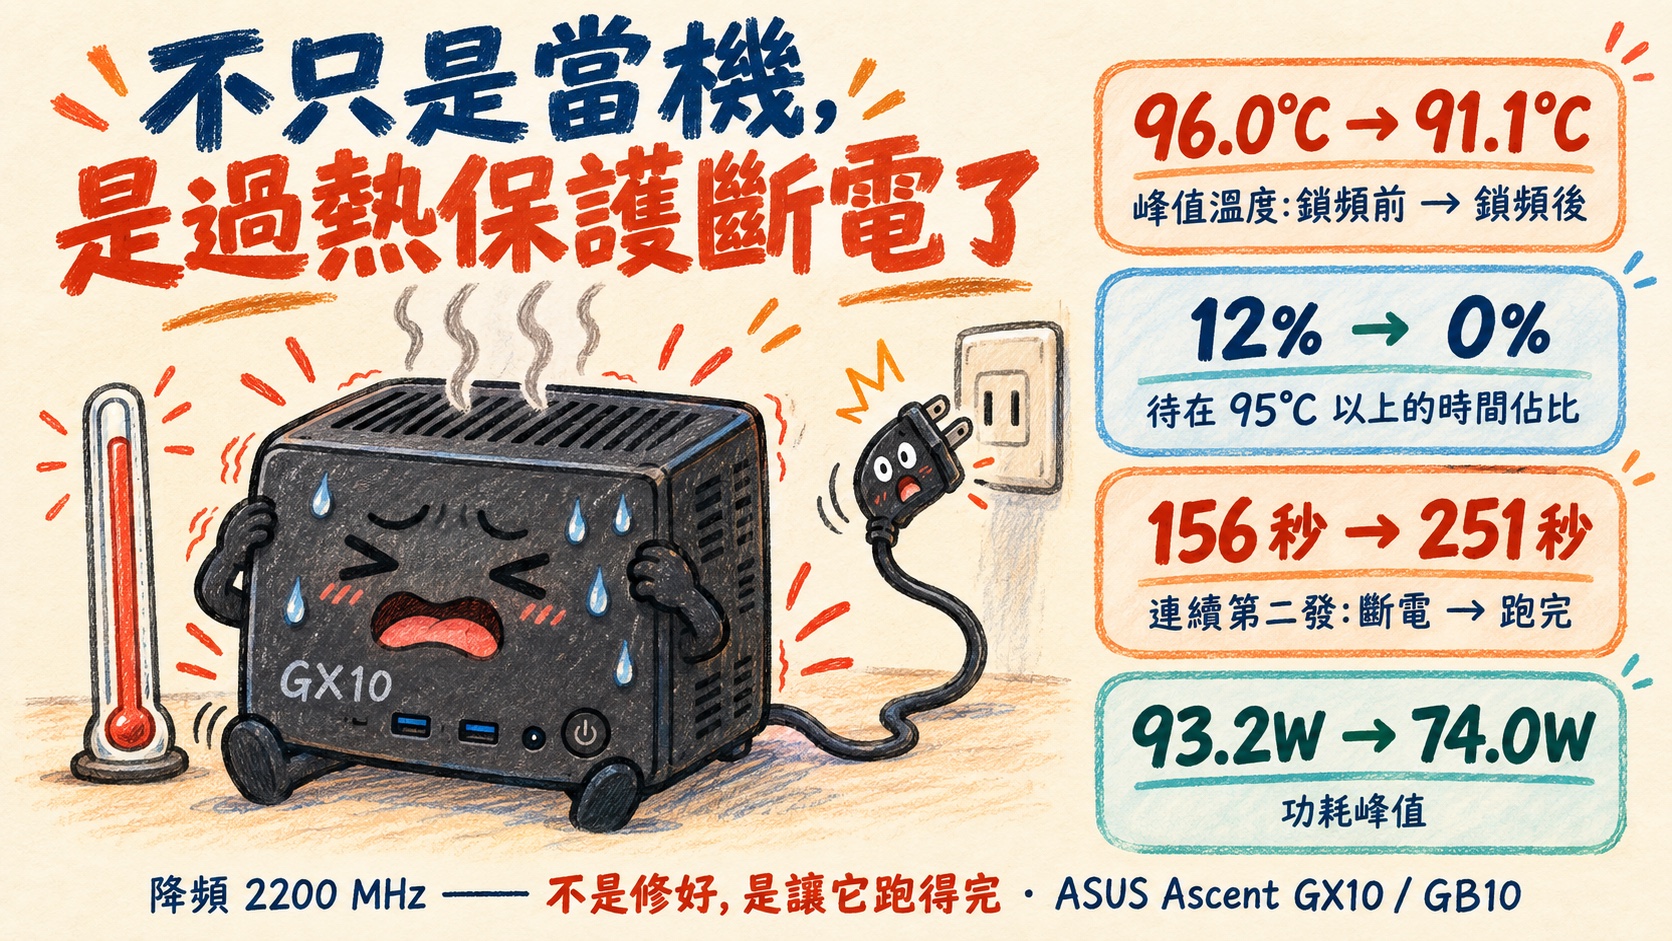
跑 MiniMax-H3 影片生成時,我這台 GX10(GB10,與 DGX Spark 同晶片)一天內兩次整台斷電,連 log 都寫不完。第三次是我們故意重現的,儀器串到機器外面所以拿到了死亡前最後一秒。把 GPU 鎖在 2200 MHz,同樣的連續兩發從「第二發 156 秒暴斃」變成「兩發都跑完」,≥95°C 的時間佔比從 12% 降到 0%,代價約 +9%。但代價依工作量形狀而定,我們後來把鎖頻關掉了。
前言
電腦當機的時候會留下遺言。藍屏、kernel panic、oops 訊息——那些都是作業系統在倒下之前最後做的一件事。
這台一個字都沒留。不只是當機——是過熱保護搶在作業系統前面,直接把電切了。
(先說清楚機器:我這台是 ASUS Ascent GX10,跟 NVIDIA 自家的 DGX Spark 同一顆 GB10 晶片,但是不同廠出的機器。下面講「這台」的時候指的都是 GX10。)
我們在跑什麼,以及它怎麼死的
在跑影片生成的量測:MiniMax-H3 原生輸出 1344×768,一發約 200 秒,GPU 全程滿載。這是上一篇在做的事的對照組。
一天之內斷兩次,第二次的時間序最乾淨,因為兩發在同一個 ComfyUI process 裡:
15:41:31  原生第 1 發開始
15:45:20  ✅ 201.852 秒完成,機器活著      ← 整整 201 秒不間斷滿載
15:45:20  第 2 發立刻接上                  ← GPU 一秒都沒喘
15:46:50  💀 斷電
第二發跑了 90 秒。要人走到機器旁邊按電源鍵才會回來。
開機之後我去找遺言,五個地方都是空的:
journalctl -b -1戛然而止在一行正常的紀錄中間——最後一筆是例行的 tailscaled session 關閉/sys/fs/pstore/空的- SBSA 硬體 watchdog(
RuntimeWatchdogSec=10s)一次都沒觸發,兩次開機之間也沒有自動重開 - 對端從直連的 ConnectX-7 看到兩個 mlx5 埠在同一秒 Link down,零 AER、零 driver reset
- RJ45 顯示
Link detected: yes,但打了約 740 個 WoL magic packet 完全叫不醒
這五件事看起來像五個不同的毛病。它們跟同一個解釋一致:機器在寫完 log 之前就沒電了。 供電一斷,journald 就停在半行、pstore 寫不進去、watchdog 連重開都做不到、網卡在同一瞬間失去 carrier。
⚠️ 用詞要小心:這是與觀測一致,不是被觀測證明。watchdog 沒重開也可能是別的原因(例如 systemd 還在餵它),而網卡失去 link 本來就不一定會產生 PCIe AER 事件——我只能說沒看到 AER,不能說「來不及發」。真正指向斷電的是要人走過去按電源鍵這件事本身。
怎麼重現:致命組合是「連續兩發」
兩次事故的形狀完全一樣,所以致命組合是明確的:原生 1344×768,連續兩發,中間不留間隔。 第一發會活,第二發約 90 秒死。
重現之前先解決一個問題:前兩次都沒有曲線。 硬斷電會吃掉機器自己硬碟上還沒 flush 的那幾秒,而那幾秒正是我要看的。
所以儀器不放在機器裡。每 2 秒取樣一次,透過 ssh 即時串流到 MacBook:
# 注意是 thermal_zone,不是 nvidia-smi
cat /sys/class/thermal/thermal_zone*/temp
nvidia-smi --query-gpu=clocks.current.sm,power.draw,utilization.gpu --format=csv,noheader
⚠️ 用 nvidia-smi 的溫度會讓你誤判。 我這台上,它報 75-84°C 的時候,thermal_zone 監看到的那個區已經在 92-98°C——差 8 到 15 度。(這是我這台的觀測值,不是 GB10 的通則;論壇 379195 也記到 GPU 84°C 對最熱 ACPI 區 93.1°C 的落差。另外 thermal_zone* 是一組感測器不是單一的封裝溫度,要看是哪一個 zone。)我本來就是打算盯 nvidia-smi 的,那會看到八十幾度然後下結論說「不熱啊」。
四發對照,同一台機器、同一組 workflow、同一天:
| 未鎖頻 | 鎖頻 2200 | |
|---|---|---|
| 負載中的實測時脈 | 2450 → 自己降到 1475 | 全程 2164–2184 |
| RUN 1 冷發 acpitz 峰值 | 95.5 °C | 88.7 °C |
| RUN 2 熱發 acpitz 峰值 | 96.0 °C | 91.1 °C |
| RUN 2 ≥95 °C 的時間佔比 | 12 % | 0 % |
| 功耗峰值 | 93.2 W | 74.0 W(−21 %) |
| RUN 1 | ✅ 226 秒 | ✅ 246.627 秒 |
| RUN 2(就是那個殺手) | 💀 156 秒硬斷電 | ✅ 251.302 秒跑完 |
死亡前最後一筆是這樣:
10:34:54 acpitz=92.2 GPU=84 util=96% 77.5W clk=2385
然後就沒有了。
怎麼處理:降頻。不是修好,是讓它跑得完
sudo nvidia-smi -pm 1 && sudo nvidia-smi -lgc 300,2200
預設 boost 大約 2418。鎖在 2200 之後,同樣的連續兩發都跑得完。
差別看溫度最清楚:峰值從 96.0 °C 降到 91.1 °C,而待在 95 °C 以上的時間佔比從 12% 變成 0%。那個殺死機器的第二發,未鎖時 156 秒斷電,鎖了之後跑完 251.302 秒。功耗峰值同時從 93.2 W 掉到 74.0 W。
但這是繞過去,不是修好。 缺陷還在那台機器裡:NVIDIA 論壇上有一串的標題就是「韌體全部更新完之後仍然發生」,另一串是 fieldiag 直接 FAIL、RMA 核准。降頻只是讓熱進得比較慢,不讓它撞到那個保護。所以它換來的是「跑得完」,不是「修好了」。
(代價大概 9%:同一輪裡未鎖的第一發是 226 秒,鎖頻之後 246.6 秒。這個數字要對你自己的工作量量,別直接搬——後面有一節專講為什麼。)
⚠️ 不要看 Applications Clocks 或 Max Clocks 來判斷鎖有沒有生效。 它們仍然報 2418 與 3003,因為那兩欄講的是別的東西(應用時脈設定與設計上限),不是你剛鎖的那個天花板。要看的是負載中的目前時脈——nvidia-smi -q -d CLOCK 裡的 Graphics/SM current 欄也看得到,或 --query-gpu=clocks.current.sm。我差一點就拿那兩個沒變的數字下結論說鎖沒生效。
然後我們把它關掉了
鎖頻的代價不是一個固定數字,它取決於你的工作量長什麼形狀:
| 工作量 | 未鎖頻 | 鎖 2200 | 代價 |
|---|---|---|---|
| 原生 H3 1344×768 四步 | 226 秒 | 246.6 秒 | 9 % |
| 兩段式(熱機) | 66.1 秒 | 70.4 秒 | 6 % |
原生是一口氣 200 秒不間斷撞在頻率上限;兩段式中間有 VAE 解碼、交接、重新編碼這些比較輕的階段,被鎖到的時間本來就少。同一個差別也解釋了為什麼兩次斷電都發生在原生——兩段式在同一台機器上跑了四發全活,而且記憶體峰值 104 GiB 比出事時的 74 GiB 還高。
解鎖之後跑一發兩段式熱機:66.1 秒,峰值溫度 74 °C,離出事時的 95 度以上差得很遠。
所以我們把鎖頻停掉了,因為這台機器接下來不會再拿去跑原生大影片。unit 檔留在 /etc/systemd/system/,要回來一行就好:
sudo systemctl enable --now gb10-clock-cap.service
如果你會跑那種一口氣兩三百秒不停的工作量,就把它鎖起來。 如果你的管線本來就有中斷,你可能根本碰不到這個問題,也不用付那 9%。
進階:排除掉的東西,與那條一直在眼前的線索
不讀這節不影響使用。上面那條路照著做就會動。
不是記憶體
同一台機器上:
| 跑什麼 | 最長連續滿載 | 記憶體峰值 | 結果 |
|---|---|---|---|
| 兩段式 冷發 | 約 110 秒 | — | ✅ |
| 兩段式 熱發 | 約 67 秒 | 104 / 121 GiB | ✅ |
| 原生 單發 | 201.8 秒 | 74 / 121 | ✅ 勉強 |
| 原生 連續第二發 | 無間隔再來 | 74 / 121 | 💀 |
104 GiB 撐得住,74 GiB 卻掛了。 變因不是用掉多少記憶體。
不是晶片沒在自保
未鎖的時候,晶片其實早就自己降頻了——而且降得比我們鎖的還低:
| 未鎖 RUN 1 | 未鎖 RUN 2 | 鎖頻(兩發相同) | |
|---|---|---|---|
| 時脈 min / 中位 | 1735 / 2340 | 1475 / 2288 | 2164 / 2171 |
| 低於 2200 的取樣佔比 | 13 % | 26 % | — |
它降到 1475 了,比 2200 低得多,然後還是掛了。而且第二發降得比第一發兇(13 % → 26 %)。
差別在時機。動態降頻是「熱了才降」,等它反應過來,熱已經灌進板子裡;靜態鎖頻是從第一秒就不產生那些熱。我能從資料講的只有這麼多:夠熱、夠久,就會斷電。 至於是哪一個瞬間跨過了哪一條線,曲線看不出來——死亡當下是 92.2 °C,而它在 89 到 96 度這個平台上待了好幾分鐘,RUN 1 也摸到過 95.5 °C 卻活著。
🔑 順帶一提,鎖頻之後沒有降頻:冷發與熱發的時脈分佈四個統計量(min / p5 / 中位 / max)完全相同。如果是熱造成的節流,比較熱的那一發一定會坐得更低。2164–2184 落在 2200 底下是時脈分檔,不是節流。
我走錯的兩個方向
先怪 kernel。 查了版本(6.17.0-1032-nvidia + 驅動 580.173.02)發現是現行的 known-good,而且第二台同樣的 kernel 沒事。但那個推論有洞:第二台當時是閒置的,證明不了它在滿載下沒事。
差點用錯溫度計。 上面講過了,nvidia-smi 會低報 8 到 15 度。
不是我們漏更新韌體
SBIOS  GX10DGX.0105.2026.0505.1153   ← ASUS 的釋出順序 0105 晚於 0104
EC     fwupdmgr 回報已最新
機型   ASUSTeK GX10(ASUS Ascent GX10),不是 NVIDIA FE ⇒ 保固走 ASUS
韌體這條的證據是分歧的,我原本只看了一半。378315 的標題本身就是負面結果——更新完整韌體之後硬斷電仍然發生。但 377365 的後續相反:更新 EC 與 SoC 韌體之後,他那台就不再硬斷電了,PowerStress 跑得完,只是改成 thermal/sensor FAIL。
⇒ 所以「韌體更新沒用」不是定論,兩份一手報告的結果相反。 我這台更新到 0105 之後仍然斷電,那是我這台的事實,不是通則。
這不是新問題,而且線索一直在我手上
社群裡的紀錄比我早:
- 379195 — 同一個驅動版本
580.173.02、同樣跑 MiniMax-H3 推論,溫度在約兩分鐘內升到他記錄的水準,接著整機凍結(是凍結不是斷電,跟我這台的失效型態不同) - 377365 — acpitz 從 88 爬到 97.8 °C 只花 5 秒
- 372145 — fieldiag FAIL,RMA 核准
而修法也早就有人寫好了:tonyd2wild/dgx-spark-hard-poweroff-fix。
這件事對我來說比較難堪的是:那個作者就是我們 TP=2 配方的來源。他的 repo 兩個月來一直躺在我們機器上的 ~/src/tonyd2wild-nvfp4/。更直接的是,我們第二台機器上的 systemd unit 描述,從一開始就寫著:
Description=GB10 GPU clock cap (2200 MHz)
            — mitigates the EC hard power-off under sustained load
第二台因此從來沒掛過。我是在第一台掛了兩次之後,才去看那行字。
所以這篇不是「我們發現了一個新問題」,是我們獨立復現了一個已知缺陷,並且做了一組鎖頻前後的對照。
⚠️ 連「把儀器放到機器外面」都不是新的——377365 那串就寫明他用了機外 1 Hz 的溫度取樣器,還貼了斷電前的時間戳讀數。我原本想說的是「我補上了大家都缺的那條曲線」,查證之後發現那句話不成立,所以刪掉。這篇剩下的價值是那組對照:同一台、同一個 workflow、同一天,只差鎖頻。
這台機器的執行環境
機型      ASUS Ascent GX10(GB10),121 GiB 統一記憶體
系統      DGX OS,kernel 6.17.0-1032-nvidia,驅動 580.173.02
SBIOS     GX10DGX.0105.2026.0505.1153
取樣      每 2 秒,thermal_zone + clocks.current.sm + power.draw,ssh 串流到機器外
原始資料   RUN-native-CRASHED(527 筆)· RUN-capped2200-SURVIVED
這個系列的其他文章:用 MiniMax H3 Super Acceleration,DGX Spark 生片冷機快 2 倍、熱機 3.14 倍 · 過熱、100W 功耗上限、30W 安全模式 — 完整診斷指南
常見問題
- DGX Spark 在持續負載下整台斷電是什麼原因?
- EC(嵌入式控制器)在偵測到熱或過流時直接硬斷電,比 Linux 來得及寫 log 還快。所以你會看到 journal 斷在正常行中間、pstore 是空的、硬體 watchdog 一次都沒觸發——不是當機,是沒電。把 GPU 時脈鎖在 2200 MHz 可以讓同樣的負載跑得完。
- 怎麼知道是熱不是記憶體?
- 同一台機器上,記憶體峰值 104 GiB 的兩段式流程跑四發全活,記憶體只用到 74 GiB 的原生流程卻掛掉。變因不是用了多少記憶體,是連續滿載撐了多久。
- 鎖頻 2200 MHz 要付多少代價?
- 不多,而且看工作量的形狀。同一輪裡原生從 226 秒變 246.6 秒,慢 9%;中間有 VAE 解碼、交接這些較輕階段的兩段式流程只慢 6%。⚠️ 兩個數字要各自量,不要拿其中一個按比例推另一個。
- 量 DGX Spark 的溫度要看哪裡?
- `/sys/class/thermal/thermal_zone*/temp`,不是 `nvidia-smi`。兩者差 8 到 15 度:`nvidia-smi` 報 75-84°C 的時候,封裝熱區已經在 92-98°C。用錯溫度計會讓你以為機器不熱。
接著讀
- 2026-09-14[影片生成] 用 MiniMax H3 Super Acceleration,DGX Spark 生片冷機快 2 倍、熱機 3.14 倍
MiniMax-H3 只畫 672×384 草稿、LTX-2.5 精修到 1344×768,在 DGX Spark 上 118.8 秒,原生直出要 237.7 秒。附完整設定步驟、必要的版本組合,以及為什麼這台機器吃得到這個好處。
- 2026-08-07[Benchmark] 在 DGX Spark 上跑 MiniMax-H3!可惜現在沒辦法用 NVIDIA VSR 放大
從零把 33B 影音同步模型跑在 GB10 上。哪些參數非設不可、時間到底花在哪、為什麼 NVIDIA 自家的放大器在這台裝不上,以及換成 4.3 MB 的開源 SPAN 之後省了 22%。
- 2026-04-02[DGX Spark] 過熱、100W 功耗上限、30W 安全模式 — 完整診斷指南
DGX Spark 的供電和過熱問題在 Carmack 批評後引爆社群。這篇整理三種不同症狀的診斷方法:30W PD controller 缺陷(需 RMA)、100W 功耗上限(散熱降頻)、5W driver bug(可修)。一個指令 30 秒確認。
- 2026-09-06[Benchmark] Qwen3.8-Flash-Next NVFP4 在 DGX Spark 跑 41.7 tok/s:RAM 給流量,硬碟給字典
NVIDIA 官方 NVFP4 checkpoint + vLLM nightly + 九個 overlay 檔,一台 DGX Spark 上 40 題中位 41.7 tok/s、散文 27.4、程式 45,比同機 llama.cpp 快 78%。六張圖講模型結構,與 47.68 GiB n-gram 表為何放硬碟。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。