DGX Spark · part 47
[影片生成] 用 MiniMax H3 Super Acceleration,DGX Spark 生片冷機快 2 倍、熱機 3.14 倍
❯ cat --toc
- 前言
- 118.8 秒對 237.7 秒,熱機拉開到 3.14 倍
- NVIDIA 在同一台機器上報 56.17 秒,我量到 73.3 秒
- 怎麼設定
- 一、先拿到權重(模型檔案)的存取權
- 二、權重
- 三、節點包(兩個,少一個圖就載不起來)
- 四、Workflow
- 五、兩個要自己確認的設定
- 版本對不上的話,精修會無聲地吐垃圾
- 為什麼比原生快:差別在 53.6 GiB 塞不塞得下
- 常駐對兩段式省 38.3%,對原生只省 3.2%
- 順便踩到的坑:這台機器長時間滿載會整台斷電
- 進階:量測方法與三個要交代的差異
- 這篇的數字全部重新量過一次
- 每個數字都是 ComfyUI `/history` 的起訖時間差
- 那 18 個被重用的節點,我逐一查過
- 三個跟上一篇不一樣的地方
- 這台機器的執行環境
TL;DR
MiniMax-H3 只畫 672×384 草稿、LTX-2.5 三步精修到 1344×768,在 DGX Spark 上 118.8 秒,原生直出要 237.7 秒——快 2.00 倍。模型都還留在記憶體裡再各跑一次,差距拉到 73.3 對 230.1 秒,3.14 倍。同一套流程在 RTX 5090 上只快 1.28 倍,因為兩段模型合計 53.6 GiB,而這張卡只有 31.84 GiB,每跑一次都得換模型。但絕對值上 Spark 仍比 5090 慢 2.4 到 5.5 倍(兩段式 118.8 對 40.3 秒)。⚠️ 這套流程需要 ComfyUI 0.34.0 以上,低於這個版本精修會無聲地吐出垃圾畫面。
🔊 開聲音。672×384 四步草稿,LTX-2.5 三步精修到 1344×768,音訊全程走 H3。這支就是表裡熱機那格 73.3 秒的產物——本文所有秒數都是用這句提示詞、這個 seed 跑出來的。
前言
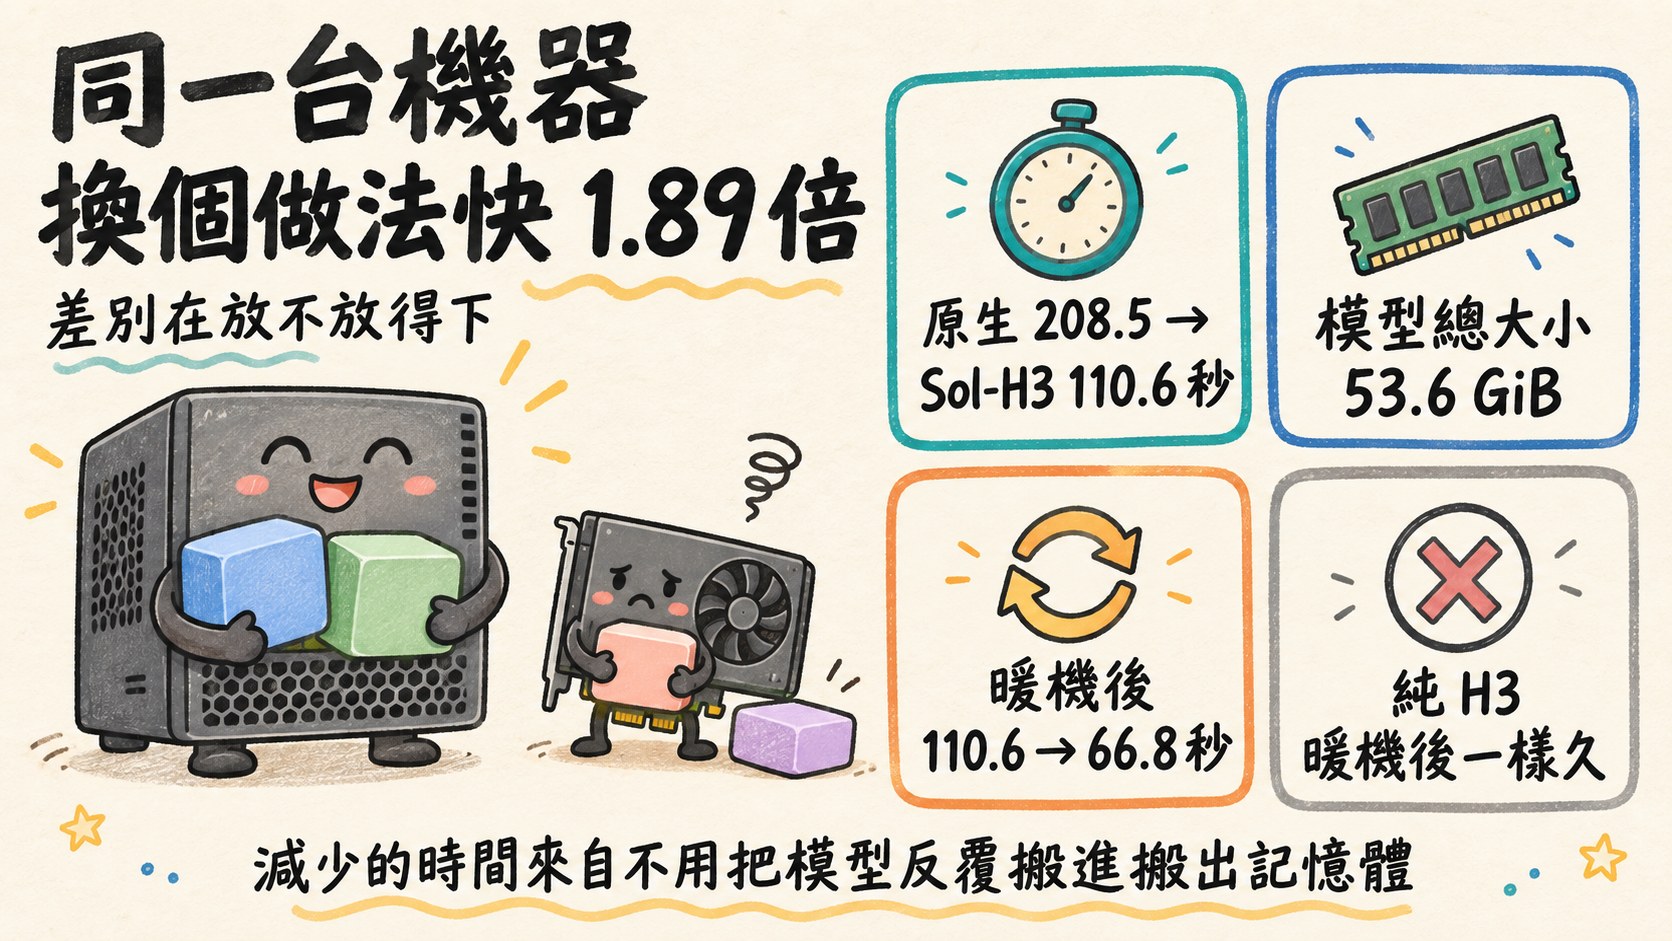
搬家的時候如果只借得到一台小貨車,真正花時間的不是開車,是每趟回來重新裝箱。換一台大車,同樣的東西同樣的路,時間卻少一半——不是車開得比較快,是你不用再拆裝。
上一篇我把這套兩段式做法搬到 RTX 5090 上:MiniMax-H3 只畫 672×384 的草稿,放大到 1344×768 那段交給 LTX-2.5 跑三步精修。結論誠實但有點掃興——單發比下來只快 1.28 倍,跟原生直出幾乎打平。
先把名字講清楚,因為這幾個詞很容易混。NVIDIA 給這個方法的名字是 MiniMax H3 Super Acceleration,發表在 Sol Engine(全名 Sol Video Inference Engine)這個加速框架底下;搬到 DGX Spark 的那個版本,他們自己叫 Sol-H3-Spark。四個詞不是同一層的東西:
| 名字 | 實際上是什麼 |
|---|---|
| MiniMax H3 Super Acceleration | 方法本身——H3 畫小草稿,LTX-2.5 精修 |
| Sol Engine | NVIDIA 的加速框架,這個方法發表在它底下 |
| Sol-H3-Spark | 同一個方法在 DGX Spark 上的官方版本,也就是本文這條 |
| Sol-Attn | 精修那一段裡可以用的一個注意力 kernel |
下面統一寫「兩段式」,因為講的是流程不是某個版本。
還有一件事值得先講,因為它跟一般人的直覺相反:我用的 672×384 草稿就是 NVIDIA 在 Spark 上的官方設定,不是我自己挑的。 896×512 是他們在 GB200 那條線上的草稿尺寸,兩條線的草稿不一樣大。而且 672×384 這個數字不是隨便挑的:兩條線的輸出都是 1344×768,而 Spark 這條用的 LTXVLatentUpsampler 配的是 x2 那顆放大器——672×384 乘二剛好就是 1344×768。GB200 那條從 896×512 上去是 1.5 倍,走的不是同一顆。所以上一篇掃出來的 sigma 0.78 對得上這條線;要是你照 GB200 那版跑 896×512,那個值要重新確認。
順帶給個座標:NVIDIA 在單張 GB200 上報 6.852 秒出 5 秒 1344×768。⚠️ 那個數字是兩段分別量測後相加、而且不含模型載入與暖機,跟本文「整條 workflow 從送出到完成」的算法不是同一種,不要直接跟表裡的秒數相比。
那篇留了一個沒回答的問題。兩段式要同時用到兩套模型,而 5090 塞不下,所以每跑一發都得把上一段換出去。省下來的算力,是不是都被換模型吃掉了?
要回答這題需要一台放得下的機器。我有一台 DGX Spark,統一記憶體 121 GiB。
118.8 秒對 237.7 秒,熱機拉開到 3.14 倍
四種跑法,同一句提示詞、同一個 seed、同樣 5 秒 1344×768 帶音訊。
下面會一直出現「冷機」跟「熱機」,先定義清楚——這兩個詞跟溫度無關,講的是模型在不在記憶體裡:冷機=剛清空,這一發要從硬碟把模型讀進來;熱機=上一發剛跑完、模型還躺在記憶體裡,這一發直接用。
表裡每個秒數都是整條 workflow 從送出到完成的時間——草稿取樣、交接、放大、精修取樣、VAE 解碼、出檔,全部含在內,不是只算模型跑了多久。所以熱機省下來的 45.5 秒不是算力省下來的,而是不用反覆把模型搬進搬出記憶體:第二發的草稿和精修都是重新算的,省掉的是那一次搬運。這件事我在進階那節逐一查過被重用的節點,因為它是整篇最值得懷疑的一格。
| DGX Spark | RTX 5090 | |
|---|---|---|
| 原生 1344×768 直出(冷機) | 237.7 秒 | 51.5 秒 |
| 原生(熱機) | 230.1 秒 | 41.5 秒 |
| 兩段式(冷機) | 118.8 秒 | 40.3 秒 |
| 兩段式(熱機,模型還在記憶體) | 73.3 秒 | 30.6 秒 |
這些倍數都是同一台機器內部比,兩段式對原生,不是跟另一台比:
- Spark:冷機 237.7 對 118.8,兩段式快 2.00 倍;熱機 230.1 對 73.3,快 3.14 倍
- 5090:冷機 51.5 對 40.3 快 1.28 倍;熱機 41.5 對 30.6 快 1.36 倍
672×384 的草稿原樣。第一段只做到這裡,精修拿到的就是它。
原生 1344×768 四步,237.7 秒。同一句提示詞、同一個 seed——但牠不是同一隻狗。兩條路的取樣軌跡本來就會岔開,這不是誰畫錯了。
Spark 這四格全部是在 GPU 鎖頻 2200 MHz 下量的。 不鎖的話跑原生連續第二發會整台斷電,量不到那一格——這件事下一篇專門寫。鎖頻讓每一發慢約 20%,但四格都在同一個限制底下,所以相除是乾淨的。
先講清楚一件事:Spark 每一格都比 5090 慢 2.4 到 5.5 倍。 兩段式在 Spark 上 118.8 秒,5090 上 40.3 秒。快的是方法在這台機器上的加成,不是機器本身。
NVIDIA 在同一台機器上報 56.17 秒,我量到 73.3 秒
Sol-H3-Spark 那頁報的是單台 DGX Spark 56.17 秒,而且他們寫得很清楚:「from prompt arrival, including fresh Qwen encoding, to a completed MP4 with audio」,熱機。那跟我表裡的秒數是同一種量——從送出到檔案落地,含 Qwen 編碼、含音訊混流。草稿 672×384/124 幀/四步、精修三步、輸出 1344×768/121 幀,連組態都一樣。
所以這是可以直接比的:他們 56.17,我 73.3,我慢 1.30 倍。 兩個原因我都追過了,一個補得起來,一個補不了。
一、Sol-Attn 我原本沒裝,補上之後拿回 4%。 workflow 裡寫的是 auto_sol_attn_conservative_exp,但 GX10 上沒有 ComfyUI-SolAttn_triton,所以它安靜地落回 dense——那條路徑在原始碼裡叫 dense_fallback_sol_attn_not_loaded,不報錯。裝上跟 5090 同一個 commit 之後重跑:熱機 73.294 → 70.386 秒,同一個 seed,畫面逐幀看起來沒變。
只有 4%,不是那頁宣稱的 3.1 倍——因為那個倍數講的是 kernel 本身,而一整發裡符合條件的呼叫沒那麼多。log 講得很清楚:
[sol_attn] sparse (1, 16128, 32, 128) tau=1.0 bf16 pointer
[sol_attn] dense  (1, 16128, 32, 128): cross-attention (kept dense)
[sol_attn] dense  (1, 126, 32, 64): head_dim 64 != 128
只有 head_dim 128 的自注意力走得進稀疏路徑,cross-attention 是設計上就保持 dense,head_dim 64 的根本不符條件。
二、鎖頻讓這條流程慢 6%。 我把鎖頻解開再跑一發熱機:66.134 秒,對上鎖頻的 70.386 秒。
(這個 6% 要對兩段式自己量。原生在同一輪裡是 226 秒對 246.6 秒,慢 9% —— 兩個工作量的形狀不同,被鎖到的時間本來就不一樣,不能拿其中一個按比例推另一個。)
| 熱機 | |
|---|---|
| 鎖 2200 MHz,沒裝 Sol-Attn | 73.294 秒 |
| 鎖 2200 MHz,裝了 Sol-Attn | 70.386 秒 |
| 解開鎖頻,裝了 Sol-Attn | 66.134 秒 |
| NVIDIA 官方(單台 Spark) | 56.17 秒 |
⇒ 66.1 對 56.17,還差 1.18 倍,我沒追出來。 兩個能指認的因素加起來只解釋了一部分,剩下的我不知道,就寫到這裡。
⚠️ 下面主表那四格是沒裝 Sol-Attn 時量的,因為那才是照這篇裝完的預設狀態。要那 4% 就自己補裝:
git clone https://github.com/kijai/ComfyUI-SolAttn_triton \
  ComfyUI/custom_nodes/ComfyUI-SolAttn_triton
git -C ComfyUI/custom_nodes/ComfyUI-SolAttn_triton checkout 26d816e
T8 那包是用原始碼的 AST 雜湊在認 Sol-Attn 實作的,所以換一個來源的同名套件它不一定收——這也是為什麼上面要釘 commit。
怎麼設定
不用自己寫程式,裝 T8star 的節點包就能在 ComfyUI 裡跑這套流程。
H3 這一側要的東西我全部放在同一個 repo 了——兩顆 transformer、文字編碼器、兩顆 VAE、turbo LoRA、conditioning 快取、自製節點、還有 workflow 本身,而且目錄是照 ComfyUI 的 models/ 樹排好的,所以一行 hf download 下去就位,不用自己對資料夾:
huggingface.co/coolthor/MiniMax-H3-pruned-NVFP4
只有 LTX-2.5 要另外抓,因為它的授權跟 H3 不同,我選擇用連結而不是鏡像。
下面的指令都在 Spark 的終端機裡跑,前提是你已經有一套會動的 ComfyUI。如果還沒有,先把 ComfyUI 裝起來再回來。
一、先拿到權重(模型檔案)的存取權
兩個 repo 都是 gated —— 要先在網頁上按同意條款,帳號才拿得到下載權。沒先處理這一步,下面的 hf download 會直接回 401。
先用瀏覽器開 coolthor/MiniMax-H3-pruned-NVFP4 和 Lightricks/LTX-2.5,各按一次同意條款,然後:
hf auth login
⚠️ H3 那個 repo 的 gating 是刻意的——MiniMax-H3 的社群授權排除歐盟、英國、南韓與美國,那個限制跟著權重走。
二、權重
# H3 那一側:transformer、文字編碼器、兩顆 VAE、turbo LoRA 都在同一個 repo
hf download coolthor/MiniMax-H3-pruned-NVFP4 --local-dir ComfyUI/models \
  --include "diffusion_models/minimax_h3_fl2va*" "text_encoders/*" "vae/*" \
            "loras/minimax_h3_fl2v*" "conditioning_cache/*" "custom_nodes/*"

# LTX 那一側(授權不同,另外抓)
hf download Lightricks/LTX-2.5 --local-dir ComfyUI/models \
  --include "diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors" \
            "vae/ltx-2.5-*" "latent_upscale_models/*"
上面那串會把 custom_nodes/ 放到 ComfyUI/models/ 底下,位置不對,搬一次:
mv ComfyUI/models/custom_nodes/ComfyUI-CondCache ComfyUI/custom_nodes/
三、節點包(兩個,少一個圖就載不起來)
git clone https://github.com/T8mars/comfyui-minimax-h3-audio-T8 \
  ComfyUI/custom_nodes/comfyui-minimax-h3-audio-T8

git clone https://github.com/xmarre/ComfyUI-Spectrum-MiniMax-H3 \
  ComfyUI/custom_nodes/ComfyUI-Spectrum-MiniMax-H3
git -C ComfyUI/custom_nodes/ComfyUI-Spectrum-MiniMax-H3 checkout 4783a22
⚠️ Spectrum 那包要釘在 4783a22。 太舊的版本在 ComfyUI 0.34.0 上會直接拋
native MiniMax H3 module is missing required helpers: time_shift_slope,整張圖停在草稿那一格。這個錯誤至少會明講,比下一節那個好對付。
T8 那包提供交接用的兩個節點:MiniMaxH3SolEngineDraftToLTXT8Advanced(把草稿交給 LTX 之前裁幀、裁比例)與 MiniMaxH3SolEngineLTXIdentityRefinerSetupT8Advanced(設定精修怎麼跑)。
第二包提供 SpectrumApplyMiniMaxH3,workflow 的節點 7 會用到。少裝這包的症狀是整張圖載不進來,不會告訴你少了哪個節點。
LTXVLatentUpsampler 是 ComfyUI 核心內建的,不用另外裝。
四、Workflow
不用自己接。這就是我實際跑出本文所有數字的那張,32 個節點,已經重新編號、沒有任何內部路徑:
⬇︎ minimax-h3-ltx-hybrid-refine-nogemma.json
拖進 ComfyUI 就會展開。同一張也在 HF repo 的 workflows/ 底下,跟權重一起抓比較省事;上面這個直連是給還沒申請權重、想先看圖長什麼樣的人。
在 DGX Spark 上一定要用 -nogemma 那張,不要用含 Gemma 的版本。 那版在這台機器上直接報錯,詳細原因在後面進階那節。
五、兩個要自己確認的設定
精修起跑 sigma 壓到 0.78。 sigma 是精修那一段「要從多亂的狀態開始重畫」的刻度——數字越大,LTX 把草稿打得越散、重畫得越徹底。workflow 裡已經設好 0.78, 0.643, 0.546, 0。官方常數是 0.909375(下面都寫 0.909),打太散就會連臉一起重畫成另一個人——上一篇有六格對照。
啟動後檢查節點有沒有載進去。 LoadConditioningT 是自製節點不在任何 registry,載不到的話 workflow 會在讀 conditioning 那一格失敗,而錯誤訊息長得像「節點不存在」不是「檔案不見」,很容易往錯的方向查:
curl -s http://<your-spark-ip>:8188/object_info \
  | python3 -c "import sys,json;d=json.load(sys.stdin);print([n for n in ('LoadConditioningT','MiniMaxH3SolEngineDraftToLTXT8Advanced','SpectrumApplyMiniMaxH3') if n in d])"
三個名字都印出來才算好了。
版本對不上的話,精修會無聲地吐垃圾
這節放在這裡,是因為它比上面任何一步都更可能吃掉你一天。
單段的 H3 在 ComfyUI 0.30.x 上跑得好好的。兩段式不行,而且它不會告訴你。
我在 0.30.0 上跑精修,ComfyUI 回報 status: success、exit code 0、日誌零錯誤,產出是規格完全正確的 1344×768 h264+aac、121 幀——每一幀都是垃圾。第一天是整整五秒全黑,隔天用同一張圖重跑變成彩色雜訊。
餵進去的東西我一格一格驗過都是好的:H3 的草稿解碼出來畫面乾淨,進精修之前那個放大完的 latent 解碼出來也乾淨。精修出來的 latent 零個 NaN、標準差 0.80,數值上健康得很。那還能壞在哪?它只是跟自己的輸入只剩 0.235 的相關性——同一份輸入加上雜訊都還有 0.74。
同一批權重、同一張圖、同一個 seed,在一台早就跑 0.34.0 的 RTX 5090 上產出正常。把 Spark 對齊過去就好了,torch 從頭到尾沒動過。
| 產出正確 | 無聲垃圾 | |
|---|---|---|
| ComfyUI | 0.34.0 | 0.30.0 |
| comfy-kitchen | 0.2.31 | 0.2.26 |
| ComfyUI-Spectrum-MiniMax-H3 | 4783a22(2026-08-18) | fcf2332(2026-08-05) |
| torch | 2.13.0+cu130 | 2.13.0+cu130 |
把那一欄當成一個整體。 這三個不能分開挑:ComfyUI 0.34.0 配 comfy-kitchen 0.2.26 連 import 都過不了,會拋 module 'comfy_kitchen' has no attribute 'int8_attention_is_available'。也就是說不存在「只換一個」的組態,沒有哪一顆套件可以被單獨定罪,也沒必要去找。
⚠️ 不要用 pip install -r requirements.txt --upgrade 去對齊。 ComfyUI 的 requirements.txt 沒有釘 torch 的版本,--upgrade 可能連帶把 PyTorch 與 CUDA runtime 那幾個套件一起換掉。裝那幾個有釘版本的就好:
pip install comfy-kitchen==0.2.31 comfy-aimdo==0.4.15 \
            comfyui-frontend-package==1.49.6 \
            comfyui-workflow-templates==0.11.48 \
            comfyui-embedded-docs==0.5.10
相信一個數字之前先看一眼畫面。 那些壞掉的跑法,用程式做的檢查全部過關:exit code、串流結構、解析度、幀數、長度,甚至在失效模式從全黑變成雜訊之後,連黑幀偵測都過了。你要量這條管線的速度,就解一幀出來看,不然量到的是一條什麼都沒產出的管線。
為什麼比原生快:差別在 53.6 GiB 塞不塞得下
兩段式要同時用到的東西,一項一項加起來(GiB 是記憶體容量單位,比硬碟廠商標的 GB 略大一點,這裡的數字都是模型實際佔的量):
Stage 1(MiniMax-H3)
  minimax_h3_fl2va_pruned_nvfp4          11.67 GiB
  qwen3vl_32b_heretic_minimax_h3_nvfp4   14.61 GiB
  minimax_h3_video_vae_fp16               4.85 GiB
  minimax_h3_audio_vae_fp32               0.56 GiB
  minimax_h3_fl2v_turbo_4step             1.82 GiB

Stage 2(LTX-2.5)
  ltx-2.5-22b-distilled-transformer      17.44 GiB
  ltx-2.5-video-vae-conv-bf16             1.35 GiB
  ltx-2.5-audio-vae-bf16                  0.34 GiB
  ltx-2.5-latent-spatial-upscaler-x2      0.93 GiB
                                        ─────────
                                        約 53.6 GiB
加上工作空間,實測峰值 104 / 121 GiB。
我這張 5090 回報 31.84 GiB 可用,連 Stage 1 自己的 33.5 GiB 都塞不進去。(31.84 與下面的 121 都是我這兩台實測回報的可用量,不是規格書上的 32 GB / 128 GB。)所以 5090 上每跑一發的實際順序是:載入 H3、畫草稿、把 H3 整個換出去、載入 LTX、精修、換出去。下一發從頭再來。
Spark 這邊兩段一起躺在記憶體裡,第二發開始不用再載。冷機到熱機省下 45.5 秒(118.815 減 73.294),絕大部分是那個載入時間。
常駐對兩段式省 38.3%,對原生只省 3.2%
兩段式的第二發省下 45.5 秒,原生的第二發只省下 7.6 秒。 這是整篇的核心:常駐幫得上的是兩段式,不是這台機器。
| 冷機 | 熱機 | 變化 | 第二發重用的節點 | |
|---|---|---|---|---|
| 原生 | 237.7 秒 | 230.1 秒 | −3.2% | 10 |
| 兩段式 | 118.8 秒 | 73.3 秒 | −38.3% | 18 |
兩邊都有節點被重用,所以不是「原生沒東西可以留」那麼簡單。那為什麼差了十二倍?差別在要載多少,以及載入在整發裡佔多大比重。兩段式要同時留住 53.6 GiB,原生只要 33.5 GiB;而原生那 230 幾秒幾乎全被 1344×768 的四步取樣吃掉,省下來的 7.6 秒載入時間在裡面只佔 3%。兩段式的取樣便宜——672×384 的草稿加三步精修——載入就成了大頭。
所以那 121 GiB 對原生幾乎沒有用,不是因為它沒東西可留,是因為它要留的東西本來就少,而且它的時間不是花在載入上。
順便踩到的坑:這台機器長時間滿載會整台斷電
實驗跑到一半,機器整台沒電了。
不是當機,是斷電——要人走到現場按電源。而且同一天發生兩次,兩次都在跑原生 1344×768 的連續第二發:第一發整整 202 秒滿載跑完還活著,第二發沒有間隔直接接上去,90 秒後斷電。
兩段式在同一台機器上跑了四發全部活著,而且記憶體峰值 104 GiB 比出事時的 74 GiB 還高。
差別是連續滿載的時間長度。原生是一口氣 200 秒不間斷;兩段式最長的一段只有 110 秒,中間還有 VAE 解碼、交接、重新編碼這些相對輕的階段。
這不是這個流程造成的,而且有解:把 GPU 鎖在 2200 MHz,同樣的連續兩發就都跑得完,代價是每一發慢約 20%。NVIDIA 開發者論壇上有一筆症狀相似的回報,驅動版本和推論模型都跟我這台一樣。怎麼查出來的、鎖頻為什麼有效,下一篇專門寫。
不過話講回來,鎖頻之後原生也跑得完了。兩段式撐得住這件事是真的,但鎖頻是更簡單的解法——對這篇來說,值得用兩段式的理由還是那 2.00 倍。
進階:量測方法與三個要交代的差異
不讀這節不影響使用。上面那條路照著接就會動。
這篇的數字全部重新量過一次
這篇 2026-09-14 先發過一版,數字是 110.6 / 208.5 / 66.8 秒、1.89 倍。那些兩段式的跑法都在 ComfyUI 0.30.0 上,產出是壞的——就是上面那節講的無聲垃圾。數字本身量得沒錯,但拿一條沒有產出畫面的管線去跟一條有產出的比快慢,那個比較不成立,所以整篇下架重做。
現在表裡每一發都在 0.34.0 上重跑過,而且每一發的畫面我都解出來看過。舊的那四個數字不再有效,別引用。
每個數字都是 ComfyUI /history 的起訖時間差
execution_success 減 execution_start 除以 1000。每一發都記 execution_cached.nodes 的長度——空的是冷機,有數字的是熱機,而那個數字本身就是證據。
冷機發之前先清:
curl -X POST http://<your-spark-ip>:8188/free \
  -H 'Content-Type: application/json' \
  -d '{"unload_models":true,"free_memory":true}'
熱機發不清,而且要換 seed。我第一次跑的時候兩發同一個 seed,第二發回來 0.006 秒、cached=31——整張圖都被快取了,那不是熱機是快取命中。換 seed 之後才是 18。
那 18 個被重用的節點,我逐一查過
這是整篇最需要驗證的一格:73.3 秒到底是「模型不用重新載入」還是「草稿沒有重畫」。如果是後者,那個數字就沒有意義。
被快取的 18 個:4 個 VAELoader、2 個 UNETLoader、1 個 CLIPLoader、1 個 LoraLoaderModelOnly、1 個 LatentUpscaleModelLoader——九個載入器。剩下是 BasicGuider ×2、KSamplerSelect、BasicScheduler、SpectrumApplyMiniMaxH3、IdentityRefinerSetup、LTXVConditioning、LoadConditioningT,全是設定,加上一個提示詞節點。
沒被快取、真的重跑的 14 個裡面包含兩顆 SamplerCustomAdvanced——H3 的草稿取樣和 LTX 的精修取樣都重算了,加上 VAEEncode、VAEDecode ×2、VAEDecodeAudio、DraftToLTX 交接、LatentUpsampler,以及換了 seed 的 RandomNoise。
草稿是重畫的,所以省下的 45.5 秒不可能是算力省下來的。我把它歸給模型載入,但那是推論不是直接量到的——execution_cached 報的是節點輸出被重用,不等於直接量到磁碟 I/O 或 GPU 常駐。要確認得另外量配置與讀取時間。
三個跟上一篇不一樣的地方
LTX 用 nvfp4,上一篇是 int8-convrot。 同一天我在 5090 上把兩者各跑三發熱機,中位數 30.574 對 30.819 秒,差 0.245 秒,而同一組自己最快最慢就差 6 秒——速度上分不出高下,選 nvfp4 純粹因為它小 2.6 GiB。
兩段式跑的是不載 Gemma 的版本。 LTX 精修那段的提示詞是固定的一句,所以可以算一次存起來,之後直接讀檔,不用把 14.32 GiB 的文字編碼器載進來。這台機器上更是非做不可——含 Gemma 的那版在這裡直接報錯:
ValueError: not enough values to unpack (expected 4, got 1)
  sd1_clip.py:266
sd1_clip.py:266 在 forward 裡,它把 process_tokens(同檔 172 行)的回傳解成四個值,而這台機器上拿到一個。看起來是我這套 ComfyUI 跟那條路徑的版本對不上,但我沒有驗到那一層——**我沒有查到這是所有 Spark 都會遇到的,只能說我這台會。**換成讀快取的版本剛好繞過那一格,而且語意等價:快取就是用同一句提示詞算出來的,我比對過逐字相同。
主表四格全部鎖頻 2200 MHz。 這不是選擇題:不鎖的話原生連續第二發會把機器弄斷電,那一格根本量不到。兩次嘗試都是這樣——第一次跑到一半沒電,第二次在同一個 ComfyUI process 裡連跑兩發原生,第二發 90 秒後沒電。鎖頻讓每一發慢約 20%,但四格都在同一個限制底下,相除是乾淨的。
兩段式冷機那一格跑了兩發:118.316 秒與 118.815 秒,差 0.5 秒。表裡用的是後者。
這台機器的執行環境
機型                   ASUS Ascent GX10(GB10),121 GiB 統一記憶體
系統                   DGX OS,kernel 6.17.0-1032-nvidia,驅動 580.173.02
GPU 時脈上限            2200 MHz(nvidia-smi -lgc 300,2200)
ComfyUI                0.34.0
comfy-kitchen          0.2.31
comfy-aimdo            0.4.15
Spectrum 節點包         ComfyUI-Spectrum-MiniMax-H3 @ 4783a22
torch                  2.13.0+cu130
LTX transformer        ltx-2.5-22b-distilled-transformer-nvfp4      17.44 GiB
H3 transformer         minimax_h3_fl2va_pruned_nvfp4                11.67 GiB
文字編碼器              qwen3vl_32b_heretic_minimax_h3_nvfp4         14.61 GiB
精修起跑 sigma          0.78, 0.643, 0.546, 0
草稿步數 / 精修步數      4 / 3
輸出                   1344×768,124 幀,24 fps,含音訊
sigma 那組值跟上一篇一樣,理由也一樣——官方的 0.909375 在這條路上會把臉重畫成另一個人。六格對照在上一篇。
這個系列的其他文章:H3 只畫草稿,LTX-2.5 收尾:RTX 5090 上的兩段式影片產線
常見問題
- 兩段式影片生成在 DGX Spark 上比原生快多少?
- 冷機對冷機是 118.8 秒對 237.7 秒,快 2.00 倍;模型都還在記憶體裡的熱機對熱機是 73.3 秒對 230.1 秒,快 3.14 倍。常駐對兩段式省下 38.3%,對原生只省 3.2%。同一套流程在 RTX 5090 上冷機快 1.28 倍、熱機快 1.36 倍。所有 Spark 數字都在 GPU 鎖頻 2200 MHz 下量的。
- 為什麼同一個方法在 DGX Spark 上的效果比 RTX 5090 好?
- 兩段式要同時用到 MiniMax-H3 與 LTX-2.5 兩套模型,合計約 53.6 GiB。RTX 5090 只有 31.84 GiB,每跑一次都得把上一段換出去,省下的算力被載入吃掉。DGX Spark 的 121 GiB 統一記憶體放得下兩段,省下的才真的落袋。
- DGX Spark 跑影片生成比 RTX 5090 快嗎?
- 不快。每一種跑法 DGX Spark 都慢 2.4 到 5.5 倍,兩段式 118.8 秒對 5090 的 40.3 秒。快的是方法在這台機器上的加成,不是機器本身。
- 在 DGX Spark 上跑這個流程需要注意什麼?
- 三件事。第一,ComfyUI 要 0.34.0 以上——0.30.x 跑得完、回報成功、檔案規格全對,但精修出來的每一幀都是垃圾。第二,LTX 精修那段不要載 Gemma 文字編碼器,改讀預先算好的 conditioning 快取,含 Gemma 的版本在 DGX OS 的 ComfyUI 上會直接報錯。第三,這台機器在長時間滿載下會整台斷電,把 GPU 鎖在 2200 MHz 就不會了,代價是每一發慢約 20%,下一篇專門寫。
接著讀
- 2026-08-07[Benchmark] 在 DGX Spark 上跑 MiniMax-H3!可惜現在沒辦法用 NVIDIA VSR 放大
從零把 33B 影音同步模型跑在 GB10 上。哪些參數非設不可、時間到底花在哪、為什麼 NVIDIA 自家的放大器在這台裝不上,以及換成 4.3 MB 的開源 SPAN 之後省了 22%。
- 2026-06-01[Benchmark] NVFP4 把影片模型砍小三分之一,速度卻一點沒快——因為 diffusion 是 compute-bound
NVFP4 把蒸餾版 Sulphur 2(LTX-2.3)影片模型從 29 砍到 19.5 GB,在 GB10 DGX Spark 上畫質速度都沒掉。影片 diffusion 是 compute-bound,跟 LLM decode 剛好相反。
- 2026-09-14[DGX Spark] 兩次整機斷電的受控復現:指紋、修法,以及我們最後為什麼把修法關掉
跑 MiniMax-H3 影片生成時,DGX Spark 兩次整台斷電,連 log 都來不及寫。這篇是儀器就位之後怎麼重現它、鎖頻 2200 MHz 怎麼修好、以及為什麼我們後來又把鎖頻關掉。
- 2026-09-06[Benchmark] Qwen3.8-Flash-Next NVFP4 在 DGX Spark 跑 41.7 tok/s:RAM 給流量,硬碟給字典
NVIDIA 官方 NVFP4 checkpoint + vLLM nightly + 九個 overlay 檔,一台 DGX Spark 上 40 題中位 41.7 tok/s、散文 27.4、程式 45,比同機 llama.cpp 快 78%。六張圖講模型結構,與 47.68 GiB n-gram 表為何放硬碟。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。