DGX Spark · part 49
[DGX Spark] 兩台 DGX Spark 跑 Qwen3.8-Flash-Next 從 51.9 到 72.0 tok/s:幅度最大的是補上自己常用的中文詞表
❯ cat --toc
- 前言
- 同一套 40 題:51.9 → 72.0 tok/s,評分沒掉
- 這十六天改了五件事
- 中文為什麼卡在 27.6:草稿詞表裡沒有中文
- 怎麼補:收集自己常用的中文,用 build_draft_vocab.py 產生清單
- 效果:常用主題那題快 60%,其他日常題也快 23–27%
- 多輪對話第二輪:prefix cache 為什麼沒命中
- 代價:KV 池縮了七成,GDN 改 FP8 會動到措辭
- 進階:除錯與實驗紀錄
- decode 已經貼著頻寬牆:lm_head 87%、GDN QKVZ 80%
- 解鎖時脈 +15%,decode 一動不動
- 自己寫的窄 GEMM:單一 kernel 快 2–6%,整體不到 1%
- prefill 還有 2.3 秒 GPU 空轉,NCCL 只跑到 link 頻寬的 29%
- 否決清單
- 那張差點被否決的詞表
- 重開機會踩的坑(還沒修)
- 量法
TL;DR
兩台 DGX Spark 跑 Qwen3.8-Flash-Next NVFP4(vLLM TP=2),用 #46 同一套 40 題重測:中位 51.9 → 72.0 tok/s,評分 0.843 → 0.876。這輪幅度最大的一項,是拿自己常用的中文補進 MTP 草稿詞表:原本那張只收英文和程式,抽樣的中文 token 82% 不在表內;補進 5,606 個後,常用主題快 60%(每步猜中 0.11 → 0.98 個),其他日常題也快 23–27%,只改一行 mount。多輪對話另外修好 prefix cache,第二輪 3.30 秒變 0.23 秒。代價是 KV 池縮到 67 萬 token。
前言
小時候量身高,都是靠同一面門框、拿同一把尺,在上面畫一條線寫日期。換一面牆量,多出來的那幾公分就說不清楚是長高了還是地板不平。
#46 那篇把 Qwen3.8-Flash-Next 攤到兩台 DGX Spark 上,用 tonyd2wild 配方附的 40 題 harness 量到中位 51.9 tok/s。之後這組機器換了 stack、調了好幾輪,每一輪各自用不同的探針量,數字沒辦法直接拿來比。
這篇回到那面門框:同一支 harness、同一支探針、同樣三發取中位,在現在的組態上重新量一次,再把這十六天改過的東西一件件對上去。
同一套 40 題:51.9 → 72.0 tok/s,評分沒掉
看第一列就好,其他四列是拆開看各類題目。
| 量測(三發中位) | #46(09-12) | 現在(09-28) | 變化 |
|---|---|---|---|
| 40 題 harness 中位 decode | 51.9 | 72.0 | +38.7% |
程式探針(decode_probe3.py) | 61.79 | 86.82 | +40.5% |
| 英文散文探針 | 37.87 | 44.99 | +18.8% |
| 繁中散文探針 | 33.16 | 45.89 | +38.4% |
| 40 題自動評分 | 0.843 | 0.876 | 沒掉 |
三發原始值:#46 是 56.6 / 51.7 / 51.9,現在是 77.9 / 71.2 / 72.0。兩次三發的最大最小差都在 9% 上下,中位數之間的差距遠大於這個。40 題裡八類全部變快,寫程式那類 58.1 → 82.9,散文類最少也有 38.0 → 48.6。
評分那一列是 harness 內建的自動評分,程式題會真的執行模型寫的 Python。散文類從 0.4 變 0.6,其他類大多持平。它不是完整的品質評測,但至少沒有變差。
這十六天改了五件事
| 日期 | 改了什麼 | 為什麼 |
|---|---|---|
| 09-22 | 換成 MiaAI 雙 Spark 配方的 vLLM | 舊 stack 開 prefix caching 跨請求命中是 0 |
| 09-22 | MTP 4 格自適應 + 47,149 詞的草稿詞表 | MiaAI 已經量過能加速,程式題直接變快 |
| 09-24 | gpu-memory-utilization 0.835 → 0.68 | 記憶體餘裕不夠,earlyoom 連鎖停擺了 17 分鐘 |
| 09-28 | 修 prefix cache 的切段對齊 + GDN 權重改讀 FP8 | 多輪對話第二輪沒命中;decode 卡在讀權重 |
| 09-28 | 草稿詞表補中文 token | 中文每步只猜中 0.11 個 |
中間那幾輪用的是另一支探針,而且不同時段量的,我只拿來看方向。有一個方向值得講:#46 時繁中探針是 33.16,到 09-27 晚上量變成 27.6,**中文在沒人注意的時候變慢了。**原因就在 09-22 那張草稿詞表。
中文為什麼卡在 27.6:草稿詞表裡沒有中文
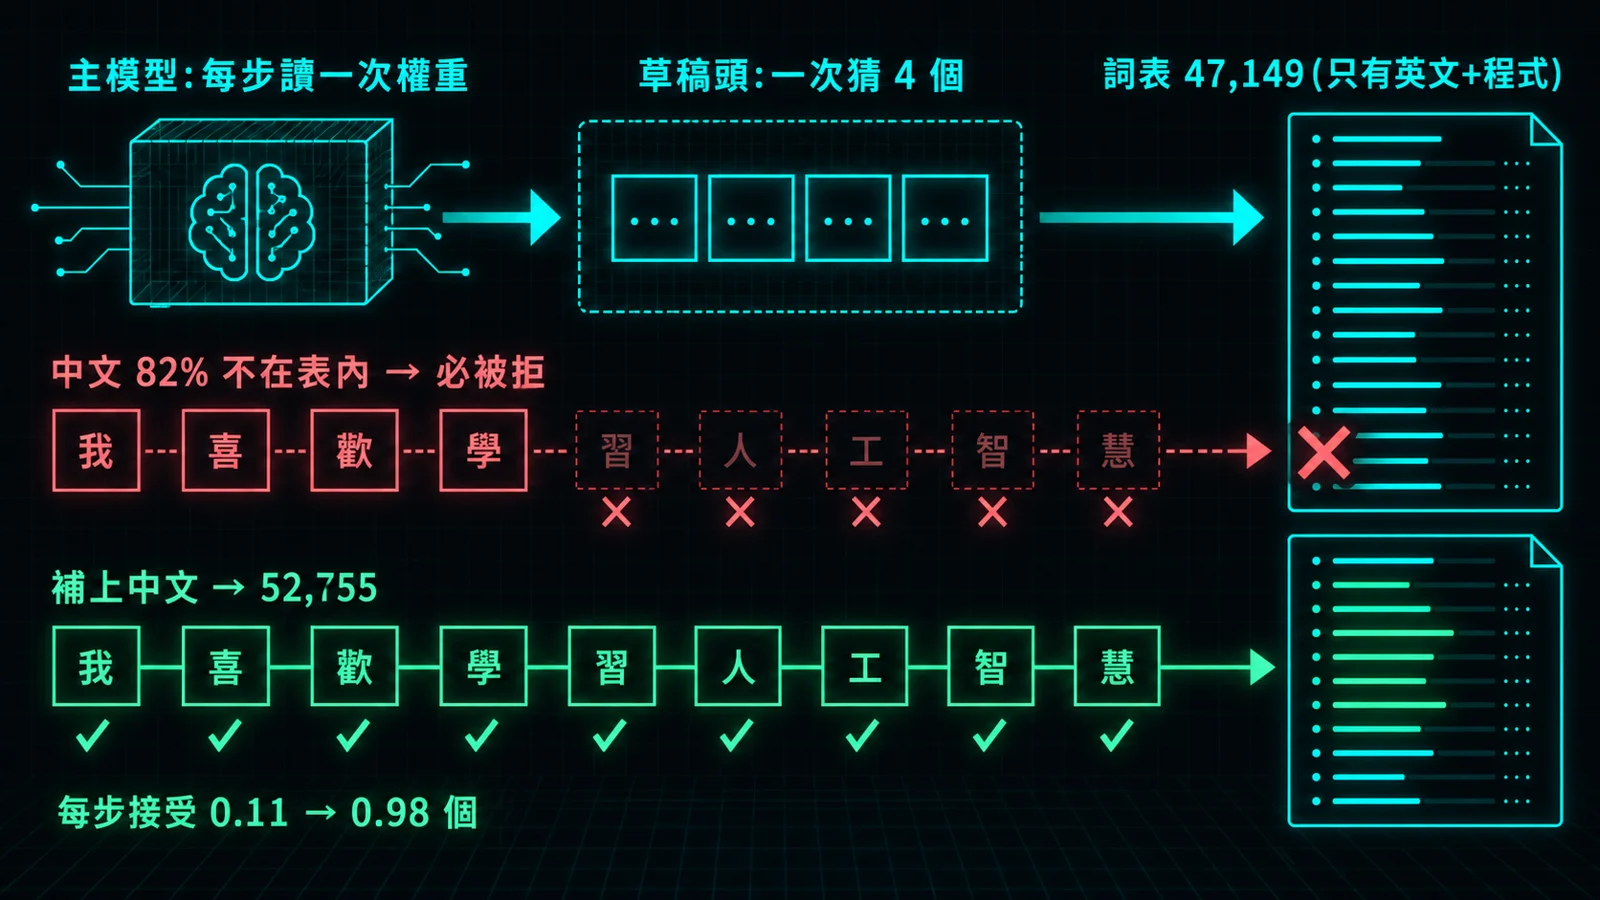
先講 MTP(multi-token prediction)。Qwen3.8-Flash-Next 自己帶了一個小的預測頭,每一步先猜接下來幾個 token,主模型讀一次權重,就把這幾個位置一起驗完,猜中的全收。decode 被記憶體頻寬卡住的機器最吃這招:讀一次權重的時間固定,猜中越多,那一趟換到的字就越多。
MiaAI 的配方再多做了一件事:把草稿頭能猜的範圍,從完整詞表(tokenizer 有 248,077 個 id)縮到一張 47,149 詞的清單,每一步少算一大截。問題是那張清單(draft_vocab_en_code_47k.txt)是拿英文和程式碼統計出來的。
我把正在跑的組態按語言分開,量了一次每步接受幾個 token:
| 題目 | 每步接受 | 第一格猜中率 |
|---|---|---|
| 程式 | 3.154 | 97.4% |
| 英文 | 1.226 | 59.4% |
| 中文 | 0.114 | 11.4% |
再拿四段繁簡中文(技術說明、操作步驟、產品回覆、教學)去 tokenize,82.26% 的 token 不在那張清單裡。草稿頭根本沒辦法猜出那些字,主模型等於每一步只吐一個字。
怎麼補:收集自己常用的中文,用 build_draft_vocab.py 產生清單
MiaAI 的 repo 裡就有產生這張清單的工具 files/build_draft_vocab.py。它讀一份語料,統計出現過的 token,輸出一份 id 清單。做法是拿中文語料產生第二份清單,再跟原本那份取聯集,原本的英文和程式 token 一個都不丟。
重點在語料:用你自己平常在用的內容。我用的是這台機器上的中文文件、三段模型寫的中文(主題跟我平常問的差不多),再加上它們的簡體轉換,總共 174,490 個 token。服務有留 log 的話,拿實際的 prompt 和回覆來建會更貼近。在容器裡跑(要用容器裡同一份 tokenizer):
docker cp zh_corpus_both.txt vllm_qwen38fn_miaai:/tmp/
docker cp build_draft_vocab.py vllm_qwen38fn_miaai:/tmp/

# 1. 從中文語料產生候選清單
docker exec vllm_qwen38fn_miaai python3 /tmp/build_draft_vocab.py \
  /tmp/zh_corpus_both.txt --out /tmp/zh_candidates_both.txt --size 65536

# 2. 跟目前的清單取聯集
docker exec vllm_qwen38fn_miaai python3 -c "
a={int(x) for x in open('/etc/vllm-draft-vocab.txt')}
b={int(x) for x in open('/tmp/zh_candidates_both.txt')}
open('/tmp/draft_vocab_en_code_zh_both.txt','w').writelines(f'{x}\n' for x in sorted(a|b))
print(len(a), len(b), len(b-a), len(a|b))"
# 47149 9749 5606 52755
新清單 52,755 詞,比原本多 5,606 個。啟動器只改一行 bind mount,另外兩個環境變數原本就有:
  -v /home/coolthor/qwen38fn-tuning/hunt-20260927/zhvocab-compile/draft_vocab_en_code_zh_both.txt:/etc/vllm-draft-vocab.txt:ro \
  -e VLLM_MTP_DRAFT_VOCAB=/etc/vllm-draft-vocab.txt \
  -e VLLM_MTP_DRAFT_VOCAB_BALANCE=1 \
VLLM_MTP_DRAFT_VOCAB_BALANCE=1 會把清單平均切給 TP=2 的兩張卡。這個旗標來自 MiaAI 還沒合併的 PR #45,我掛的是那一版的 overlay;只用 main 分支的話沒有它,拿掉這行就好。52,755 是奇數也沒關係,兩台啟動 log 都印 balanced=True。
會不會改到輸出?不會。工具自己的說明寫得很清楚:不在清單裡的 token 只會變成被拒的草稿,不會變成錯的輸出。實測 temperature 0 跑三題,換詞表前後逐字相同。
效果:常用主題那題快 60%,其他日常題也快 23–27%
這是這輪幅度最大的改動,只改一行 bind mount,測的三題輸出逐字相同。速度要看題目跟語料有多接近:
| 題目(temperature 0、400 token、各 3 發中位) | 舊清單 | 新清單 | 變化 |
|---|---|---|---|
| 繁中探針(頻寬與張量並行) | 27.64 | 44.31 | +60% |
| 繁中:三杯雞做法 | 30.0 | 36.9 | +23% |
| 繁中:合歡山看日出 | 29.8 | 37.3 | +25% |
| 簡中:幫老人挑手機 | 31.7 | 40.3 | +27% |
第一列是原本的測試題,主題就是我平常在問的東西,跟建清單的語料同一類,每步接受數從 0.114 變 0.978(8.6 倍)。後三題是我事後另外寫的日常主題,語料裡沒有,每步接受 0.13–0.22 → 0.36–0.64(2.6–3 倍)。從這四題看得出來:詞表越貼近你實際在用的內容,快得越多;沒收進去的主題也還有 23–27%。
英文每步接受數從 1.226 掉到 1.103,但英文速度沒變(44.74 → 44.98)。程式題從 83.27 到 82.32,在三發的波動範圍內。
多輪對話第二輪:prefix cache 為什麼沒命中
多輪對話也有明顯的改善。coding agent 每一輪都把前面整段對話重送一次,理論上前面那段應該直接從 prefix cache 撈回來。實測卻是這樣:
| 第二輪(同一段前綴 + 一句追問) | 修之前 | 修之後 |
|---|---|---|
| 9.5k 前綴:TTFT / 命中 token | 3.30 s / 0 | 0.23 s / 9,464 |
| 30k 前綴:TTFT / 命中 token | 4.73 s / 16,960 | 0.25 s / 29,992 |
9.5k 的第二輪一個 token 都沒命中,跟第一次問一樣慢。
原因出在這顆模型是混合架構:一部分層是 GDN(類似 Mamba 的遞迴層),它不像 attention 可以從任何位置接著算,只能從「有存下狀態的位置」繼續。這個版本的 cache 區塊是 848 token,狀態只在 prefill 切段的停點、而且剛好落在區塊邊界時才會存。排程器的切段停點卻是用設定值 8 在對齊,最後那一段的狀態沒落在能重用的邊界上,第二輪只好整段重算。
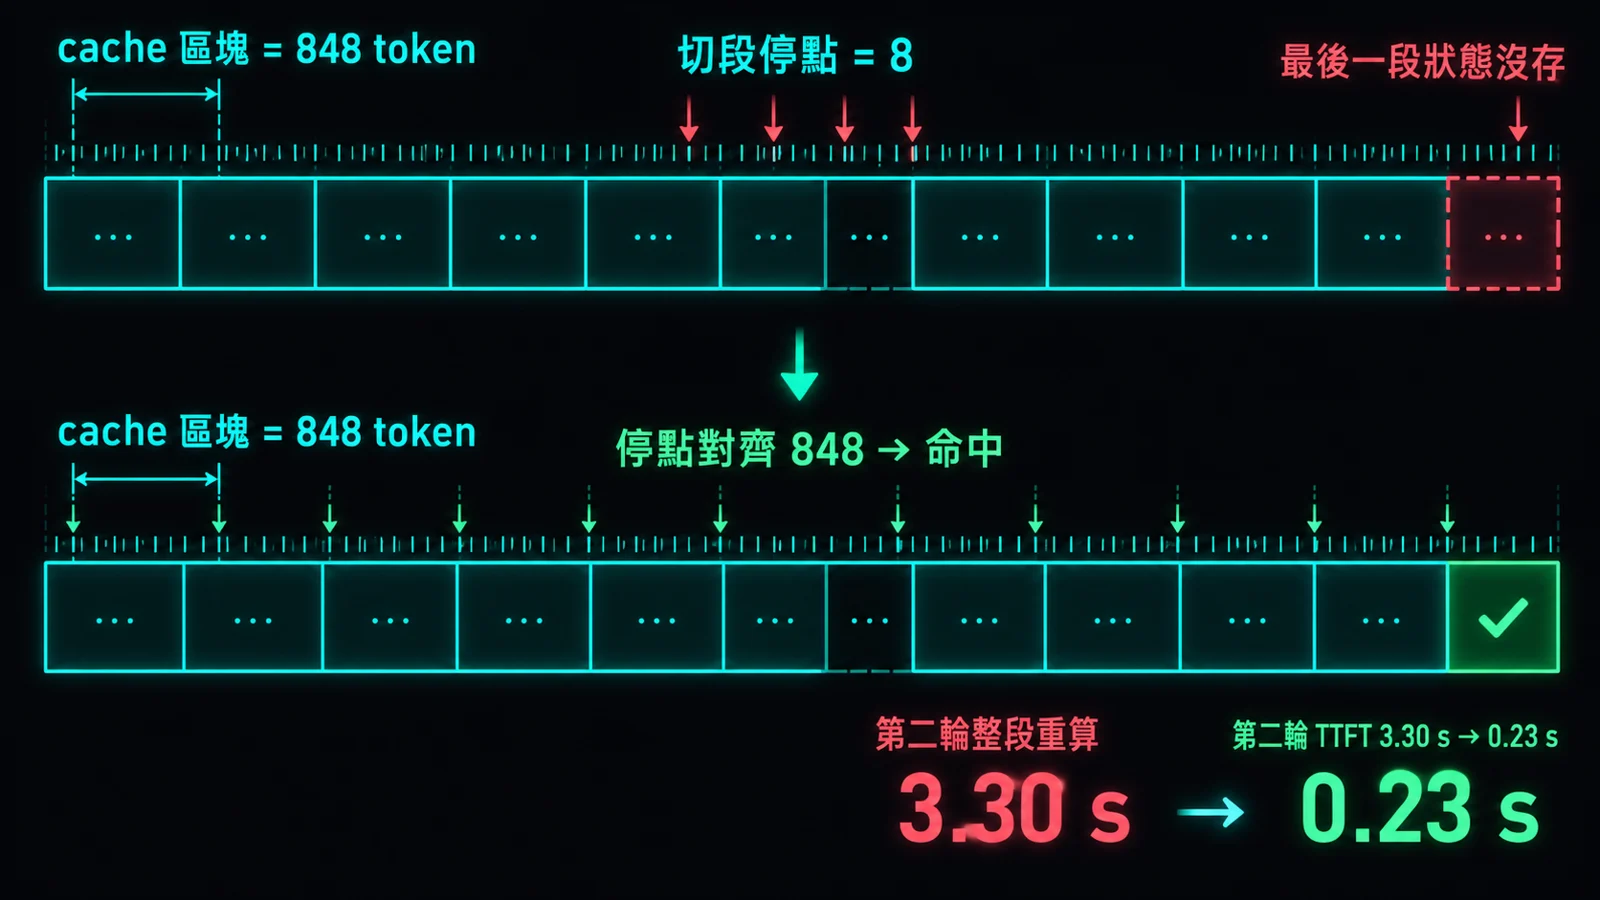
我改了兩個地方:先把切段停點對齊到 848;再參考上游 vLLM #57180 放寬尾段比對的範圍,並扣掉 MTP 會重填的 3 個 token(這一點是我們自己追出來的,不在那個 PR 裡),不然邊界還是差一點對不上。改的是排程器和 cache 管理的三個檔案,我用 overlay 掛進 MiaAI 的 image,光改設定做不到。#57180 在我寫這篇時還沒合併。
代價:KV 池縮了七成,GDN 改 FP8 會動到措辭
兩件事要一起講清楚。
**KV 池從 2,128,927 縮到 665,924 token。**這跟加速無關,是 09-24 把 gpu-memory-utilization 從 0.835 降到 0.68 的結果。DGX Spark 是 CPU 和 GPU 共用記憶體,0.835 時 earlyoom 連砍、整個推論服務停了 17 分鐘,降到 0.78 之後 head 那台的可用記憶體還是掉到過 1.8 GiB。以每個請求 262K token 算,現在的池子還有 2.54 份的容量,排隊一直是 0。
**GDN 權重改成執行時轉 FP8。**這塊權重每一步都要讀,讀取量減半之後程式、中文、英文各快 5–7%。它會改到主模型的數值:程式題輸出逐字相同,中文和英文的措辭有變、意思一樣。中文風格、工具呼叫、28k 大海撈針三項檢查都過,40 題評分也沒掉。如果你需要輸出逐字不變,這一項可以單獨拿掉。
進階:除錯與實驗紀錄
不讀這節不影響使用。這裡是整輪試過的東西、否決的理由和量法,寫給要在自己機器上重現的人,或把整篇丟給 AI 參考的人。
decode 已經貼著頻寬牆:lm_head 87%、GDN QKVZ 80%
用 PyTorch profiler 單獨抓一發程式題的 decode:每個 MTP 步 51 ms,GPU 忙 95–96%,其中 dense GEMM 占 60–62%、MoE GEMM 22%、NCCL 8–10%。能確定權重形狀的兩個 kernel,拿「權重位元組 ÷ kernel 時間」算實際頻寬:
| kernel(TP=2 每張卡的權重) | 每次讀 | 耗時(head) | 實際頻寬 |
|---|---|---|---|
| GDN QKVZ,8192×2560 BF16 | 41.9 MB | 191 μs | 219 GB/s(273 的 80%) |
| lm_head,124160×2560 BF16 | 635.7 MB | 2,677 μs | 237 GB/s(87%) |
GB10 的記憶體頻寬規格是 273 GB/s。這兩個已經貼著牆,換 kernel 能擠的空間很小,所以 GDN 那塊改走「少讀一半」的 FP8。E4M3 FP8 的 microbench 在 M=5 時 179 → 97 μs,含輸入量化。
解鎖時脈 +15%,decode 一動不動
worker 那台之前為了 GB10 長時間滿載會整台斷電的缺陷(#48)鎖在 2,200 MHz。解鎖後負載時脈 2,177 → 2,502 MHz,程式題 5 發中位 81.3 對 82.0 tok/s。
自己寫的窄 GEMM:單一 kernel 快 2–6%,整體不到 1%
MTP 驗證時矩陣只有 1–5 列,我試了三個形狀的自寫 kernel:GDN 176.4 → 165.8 μs(−6.0%)、HC 28.3 → 27.8 μs、output 71.5 → 65.0 μs。換算回整個 51 ms 的步都不到 1%,沒上線。
prefill 還有 2.3 秒 GPU 空轉,NCCL 只跑到 link 頻寬的 29%
12.5k token 的 prefill,head 那台 forward 5.578 秒裡 GPU kernel 只占 3.278 秒。對齊 CPU 端之後,大於 10 ms 的空窗主要落在 QSA indexer 的主機端處理(約 0.99 秒)、aten::mul(0.48 秒)、MoE shared(0.37 秒),還有一次 172 ms 的 cudaMalloc。
NCCL 在這段 trace 裡有 71 次 BF16 (12520, 2560) 的 all-reduce(每次 64.1 MB),再加一次 32 MB 的 int8,合計約 4.58 GB。head 累計 683.6 ms,算出來有效 6.70 GB/s = 53.6 Gb/s,是 #46 量到的 185 Gb/s 的 29%。獨立兩機 64.1 MB all-reduce 是 6.18 ms,約 83 Gb/s。所以這段不是 link 頻寬不夠,是卡在延遲與排程。NCCL_PROTO=Simple 在 64 MB 和 25.6 KB 兩種大小都更慢,否決。
否決清單
| 試過的 | 結果 |
|---|---|
max_num_batched_tokens 32,768 | 起不來:GMU 0.68 下 KV 放不下 262K |
max_num_batched_tokens 24,576 | 12.5k 冷 TTFT 慢 23% |
MiaAI #66 disable_eagle_block_drop | Qwen 這條路徑沒有 eagle 群組,開了等於沒開,命中數一個都沒變 |
mamba_cache_mode=all | 命中不變:只要不是 align,hash 粒度會退回區塊大小 |
| torch.compile(mode 3) | 沒跑。MiaAI PR #45 的紀錄是雙 GB10 編了 103 分鐘沒編完,RPC 逾時退出 |
| IRQ 移到大核、chunk 8192、GDN FlashInfer prefill | 09-24 就否決了(最後一個在四個請求同時跑時整體慢 8.8%) |
那張差點被否決的詞表
中文詞表第一次 A/B 被我自己訂的關卡擋下:12.5k 冷 TTFT 慢了 3.67%,超過「其他項退步不超過 3%」。回到舊組態再量三發,同一個量法是 6.35 / 4.14 / 6.10 秒。冷 TTFT 在那個時段自己就會晃到 50%,而換草稿詞表只影響 MTP 那一步能猜哪些字,prefill 根本不經過它。
那條關卡本來要問的是「這個改動有沒有讓別的東西變差」,我寫成「別的數字不准動超過 3%」,在雜訊比 3% 大的量測上它一定會誤擋。後來先確認改動會經過哪一段、再把量測本身的波動算進去,詞表才上線。
重開機會踩的坑(還沒修)
worker 那台 enabled 的是舊 stack 的 qwen38fn-tp2-worker.service,正在用的 qwen38fn-miaai-worker.service 反而是 disabled。兩台重開機後不會自己回到現在這套組態。
量法
- 40 題 harness:
cd ~/src/tonyd2wild-nvfp4/single-spark-vllm-tp1 && python3 tools/bench_categories.py http://127.0.0.1:8000 qwen38-flash-next <lane> --thinking off --concurrency 1 --tag runN,三發取中位,在 GX10 上跑(程式題會實際執行)。 - 三題探針:
python3 ~/patches/decode_probe3.py qwen38-flash-next <code|prose_en|prose_zh> 0,每發前確認vllm:num_requests_running是 0。 - 每步接受數:每發前後讀
/metrics的spec_decode_num_drafts_total與spec_decode_num_accepted_tokens_total差值,前後request_success_total差 1 才收,混到別人請求的那發丟掉。 - 第二輪命中:第一輪送冷的前綴,第二輪同前綴加一句追問,看
prefix_cache_hits_total的增量。
同系列:#46 Qwen3.8-Flash-Next TP=2 雙機 51.9 tok/s · #45 單機 NVFP4 配方 41.7 tok/s
常見問題
- Qwen3.8-Flash-Next 開了 MTP,為什麼中文比英文慢那麼多?
- 如果你用的是 MiaAI 雙 Spark 配方的縮小草稿詞表(draft_vocab_en_code_47k.txt),那張表只從英文和程式碼統計出來。我們拿四段繁簡中文測,82% 的 token 不在表內,草稿頭根本猜不到,每步只接受 0.11 個。用同一個 repo 的 build_draft_vocab.py 補進中文 token 後變 0.98 個,中文測試題從 27.6 到 44.3 tok/s。
- 在 MTP 草稿詞表裡加中文 token,會改變模型的輸出嗎?
- 不會。草稿只負責猜,最後收哪個字是主模型決定的;猜不到的字只會被拒絕,不會變成錯字。我們用 temperature 0 跑三題,換詞表前後輸出逐字相同。
- vLLM 跑混合架構模型(Mamba/GDN + attention),為什麼同一段對話第二輪的 prefix cache 沒命中?
- 混合模型只能從「有存狀態的位置」接著算。我們這個版本 cache 區塊是 848 token,但 prefill 的切段停點用的是設定值 8,最後一段的狀態沒存到能重用的邊界上。9.5k 前綴的第二輪命中 0 個 token。把停點對齊 848、再扣掉 MTP 會重填的 3 個 token 之後,第二輪從 3.30 秒變 0.23 秒。上游 vLLM PR #57180 處理的是同一類問題(Mamba 尾段在 MTP 下的重用)。
- DGX Spark 跑 LLM 把 GPU 時脈拉高會變快嗎?
- 在我們這個負載下不會。worker 的負載時脈從 2,177 拉到 2,502 MHz(+15%),程式題 decode 81.3 對 82.0 tok/s,沒有差。decode 卡在記憶體頻寬:lm_head 讀取已經用到 273 GB/s 的 87%。
接著讀
- 2026-05-06火箭起飛:Gemma 4 在 DGX Spark 跑出 670 tok/s 總吞吐(單流 108 tok/s)
Google 2026-05-05 發 Multi-Token Prediction drafter,vLLM PR 同日開、官方 preview docker 同日有。DGX Spark 上實測 Gemma 4 26B-A4B-it FP8 + MTP γ=4:單流 108 tok/s(2.66× baseline)、8 路並行 674 tok/s 總吞吐。一個沒寫進文件的雷:drafter 不能配 base model,要配 -it。
- 2026-09-12[vLLM] 兩台 DGX Spark 跑 Qwen3.8-Flash-Next TP=2:51.9 tok/s(單機 41.7)
兩台 DGX Spark 用 QSFP 直連跑 vLLM 跨節點 TP=2,Qwen3.8-Flash-Next NVFP4 從單機 41.7 tok/s 到 51.9,KV 池翻倍。完整接線、起服務順序與驗證步驟。
- 2026-09-06[Benchmark] Qwen3.8-Flash-Next NVFP4 在 DGX Spark 跑 41.7 tok/s:RAM 給流量,硬碟給字典
NVIDIA 官方 NVFP4 checkpoint + vLLM nightly + 九個 overlay 檔,一台 DGX Spark 上 40 題中位 41.7 tok/s、散文 27.4、程式 45,比同機 llama.cpp 快 78%。六張圖講模型結構,與 47.68 GiB n-gram 表為何放硬碟。
- 2026-08-23[Benchmark] DGX Spark 跑 Qwen3.8-27B 到 65 tok/s:無投機只有 12.3,差別全在草稿預算
GB10 的頻寬 273 GB/s、語言主幹 18.77 GB,每個 token 都要整份讀過,上限 14.54 tok/s。實測無投機 12.32,吃掉 85%,換 kernel 撈不回來。投機解碼把它拉到 5.28 倍,而關鍵不是換方法,是把草稿預算從 8 調到 12。
不想錯過新文章?
訂閱我確保不漏接!
隨時一鍵退訂。